
La complexité de la mise à disposition des applications modernes n’a plus rien à voir avec ce qu’elle était il y a dix ans. Nous nous appuyions autrefois sur des stratégies statiques d’équilibrage de charge, qui répartissaient des flux de trafic prévisibles entre une poignée de serveurs. Aujourd’hui, nous devons composer avec des environnements multicloud dynamiques, des microservices qui démarrent ou s’arrêtent à la volée et des bases d’utilisateurs qui peuvent passer de mille à un million du jour au lendemain. L’équilibrage de charge traditionnel, fondé sur des règles, ne parvient pas toujours à suivre le rythme.
C’est là que l’apprentissage par renforcement (RL) entre en jeu. En observant continuellement son environnement et en prenant des décisions qui maximisent les performances globales, un agent RL peut potentiellement mieux s’adapter aux changements en temps réel que n’importe quel script préprogrammé. C’est toute la différence entre suivre une recette à la lettre et cuisiner à l’instinct : la première approche s’adapte aux conditions connues, tandis que la seconde évolue dynamiquement en fonction de la situation.
Thèse : À mesure que les infrastructures applicatives gagnent en complexité, nous devons abandonner l’équilibrage de charge statique ou fondé sur des heuristiques au profit de systèmes adaptatifs pilotés par l’apprentissage par renforcement, afin de préserver la résilience, d’optimiser les performances et de préparer nos réseaux aux enjeux futurs.
L’IA ne manque pas de susciter l’engouement, mais l’apprentissage par renforcement est l’un des domaines où la recherche universitaire comme les projets pilotes en conditions réelles commencent à donner des résultats concrets et prometteurs. Il ne s’agit pas d’une éventualité lointaine : les techniques d’apprentissage par renforcement produisent déjà des résultats positifs dans des environnements de simulation et certains environnements de production.
Introduction à l’apprentissage par renforcement : pourquoi cette approche est pertinente
Avant d’aller plus loin, expliquons l’apprentissage par renforcement en termes plus simples. Imaginez un agent — le « cerveau » du système — chargé de recueillir des données, de prendre des décisions et d’adapter sa stratégie à l’évolution des conditions. Cet agent évolue dans un environnement dynamique (tel qu’un système multicloud), où il reçoit une « récompense » lorsque les résultats sont positifs — par exemple, lorsque la latence diminue ou que le débit augmente. Au fil du temps, il affine sa stratégie afin d’obtenir plus souvent des récompenses plus importantes.
- Adaptatif et continu : Contrairement à un algorithme statique limité à un ensemble de règles précis, l’apprentissage par renforcement continue d’apprendre à partir des nouveaux schémas de trafic.
- Logique évolutive : Les frameworks d’apprentissage par renforcement peuvent coordonner des milliers de variables, telles que l’utilisation du processeur, la consommation de mémoire ou la disponibilité des nœuds, et les optimiser simultanément.
- Résilience face aux chocs : Les changements soudains, comme un pic de trafic sur un site d’e-commerce pendant les fêtes de fin d’année, peuvent être corrigés automatiquement sans attendre qu’une personne ajuste les seuils.
Controverse : l’apprentissage par renforcement est-il excessif ?
Certains ingénieurs considèrent l’apprentissage par renforcement (RL) comme une complexité inutile. « Pourquoi réparer ce qui n’est pas cassé ? » est une question qui revient souvent. Pourtant, chez F5, nous avons observé de nouveaux cas d’usage chez nos clients — tels que des microservices distribués à l’échelle mondiale ou des déploiements en périphérie mutualisés — dans lesquels les règles statiques sont non seulement sous-optimales, mais parfois même dangereuses. Une politique parfaitement adaptée au trimestre précédent peut échouer de manière spectaculaire dans de nouvelles conditions. Dans de tels scénarios, la capacité du RL à s’adapter malgré l’incertitude peut s’avérer salvatrice.
Dans les coulisses de F5 : aperçu d’expériences en conditions réelles
Chez F5, nous avons mené des expériences d’apprentissage par renforcement à petite échelle dans des environnements de simulation modélisés à partir du trafic réel de nos clients. En voici un exemple :
- La configuration : Nous avons créé un scénario synthétique de « marathon du shopping » : imaginez de grands événements commerciaux lancés simultanément sur différents continents. Le trafic augmentait de manière imprévisible, avec des pics de requêtes gourmandes en mémoire à des heures inhabituelles.
- L’agent d’apprentissage par renforcement : Déployé dans un environnement conteneurisé, l’agent d’apprentissage par renforcement déterminait quels microservices lancer en fonction des habitudes d’utilisation. Il a appris à acheminer les tâches gourmandes en ressources processeur vers des nœuds dotés de matériel spécialisé, tout en transférant les processus moins exigeants vers des instances cloud moins coûteuses.
- Les résultats : Par rapport à une approche classique de répartition à tour de rôle avec une certaine mise à l’échelle automatique, la méthode pilotée par l’apprentissage par renforcement a réduit les temps de réponse moyens de 12 à 15 %. Surtout, elle a également permis de maintenir des taux d’erreur plus stables lors de pics de trafic extrêmes.
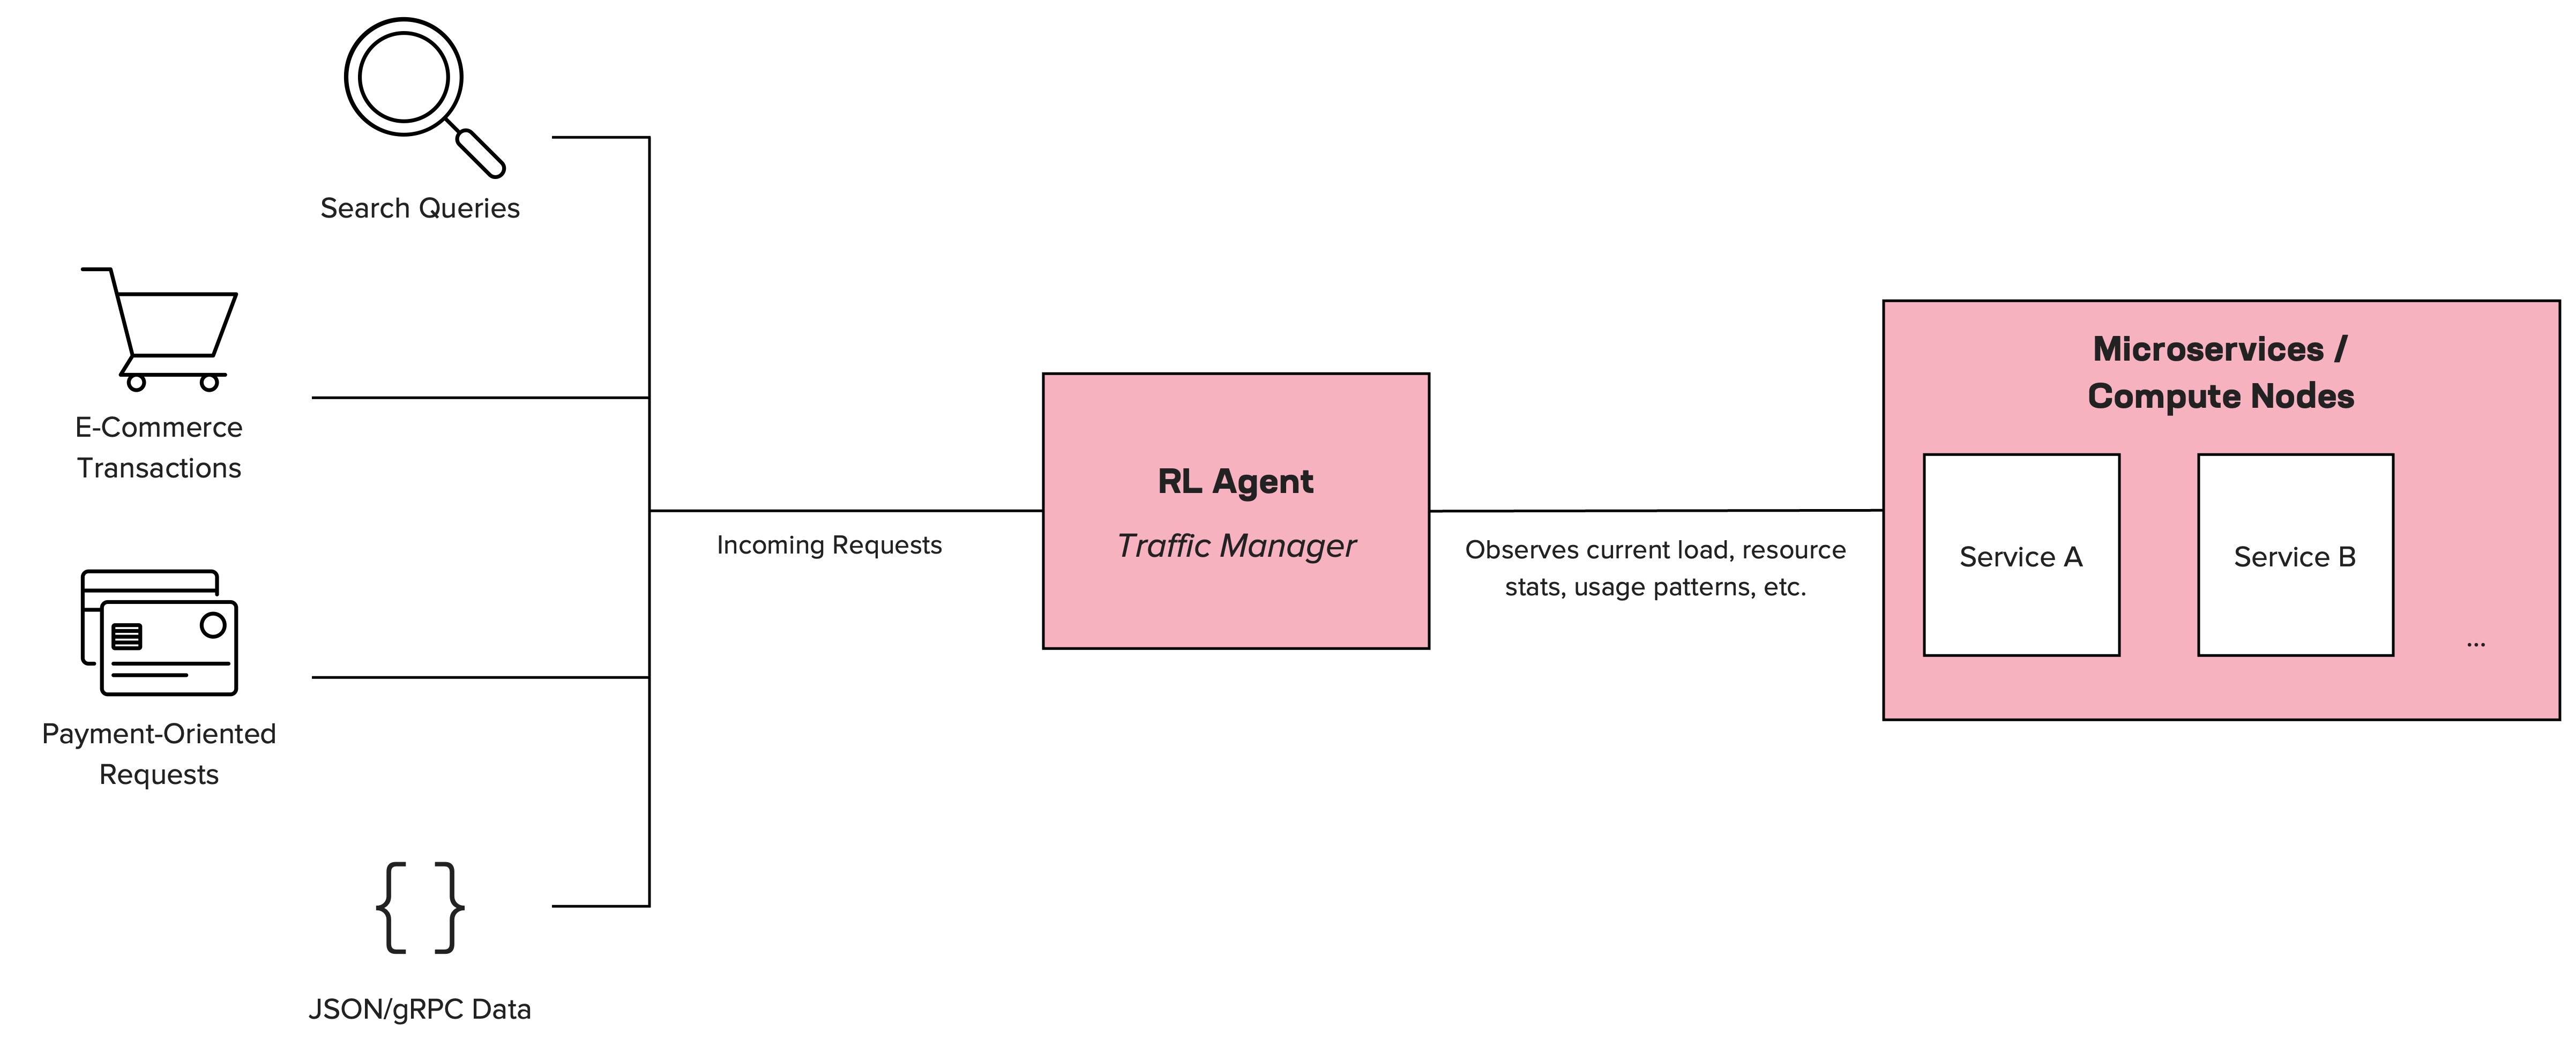
Ce schéma conceptuel montre comment l’agent d’apprentissage par renforcement remplace un équilibreur de charge classique (ou fonctionne à ses côtés).
- Requêtes entrantes : Les utilisateurs ou les applications clientes envoient des requêtes.
- Agent d’apprentissage par renforcement : agit comme le cerveau de la gestion du trafic. Il surveille les métriques en temps réel (utilisation du processeur, mémoire, taux d’erreur) et prend des décisions de routage ou de mise à l’échelle.
- Microservices / Nœuds : L’agent d’apprentissage par renforcement lance les microservices appropriés ou achemine le trafic vers des nœuds spécifiques, en fonction des résultats de l’apprentissage.
Cet exemple montre que l’apprentissage par renforcement peut surpasser l’équilibrage de charge traditionnel dans de nombreux scénarios.
Pièges potentiels : ne vous laissez pas encore gagner par l’enthousiasme ambiant
Bien sûr, l’apprentissage par renforcement n’est pas une solution miracle. Les temps d’entraînement peuvent être longs, et nous avons dû investir dans une surveillance rigoureuse afin de nous assurer que l’agent d’apprentissage par renforcement ne « détournait » pas le signal de récompense en prenant des décisions à court terme préjudiciables à l’objectif global. Malgré tout, lorsqu’il fonctionne, l’apprentissage par renforcement peut nettement surpasser les heuristiques traditionnelles. Voici quelques autres éléments à prendre en compte :
1. Complexité ou fiabilité
- Problème : L’apprentissage par renforcement ajoute une nouvelle couche de complexité à des systèmes qui le sont déjà. S’il n’est pas géré avec soin, un agent peut rester bloqué dans des optima locaux ou poursuivre des objectifs contradictoires (débit, coût ou latence).
- Atténuation : Approches hybrides dans lesquelles l’apprentissage par renforcement prend en charge les décisions de haut niveau, tandis que des heuristiques éprouvées assurent les mécanismes de sécurité.
2. Qualité des données et conception de la fonction de récompense
- Problème : L’apprentissage par renforcement repose sur des signaux de récompense. Si vos indicateurs sont inadéquats ou si vous encouragez les mauvais comportements, l’agent risque d’exploiter des particularités de l’environnement qui ne se traduisent pas par une réelle valeur ajoutée pour l’entreprise.
- Mesure d’atténuation : Investissez dans une surveillance robuste, la conception d’indicateurs pertinents et des tests hors ligne approfondis.
3. Préoccupations éthiques et réglementaires
- Problème : Si un agent d’apprentissage par renforcement discrimine involontairement certaines régions ou certains profils d’utilisation dans un souci de rentabilité, il risque de franchir des limites éthiques ou juridiques.
- Mesure d’atténuation : Les équipes chargées de la mise en œuvre doivent définir en amont les actions autorisées et auditer régulièrement les décisions prises par les systèmes d’apprentissage automatique.
Tendances générales d’adoption dans le secteur en 2025
Au-delà de nos expérimentations internes, l’apprentissage par renforcement suscite un vif intérêt dans le secteur. En voici quelques faits marquants :
- Articles de conférence : De prestigieuses conférences sur l’IA, comme NeurIPS ‘24, consacrent des sessions entières à l’apprentissage par renforcement distribué pour l’optimisation des réseaux.
- Fournisseurs de services cloud : Les principaux fournisseurs de services cloud proposent désormais des boîtes à outils spécialisées pour l’auto-scaling et le routage du trafic basés sur l’apprentissage par renforcement, comblant ainsi le fossé entre la recherche universitaire et les outils pratiques.
- Déploiements en périphérie : Avec l’émergence de la 5G et des réseaux en périphérie, il devient urgent d’orchestrer les ressources entre de nombreux petits centres de données. La capacité d’adaptation de l’apprentissage par renforcement convient parfaitement à ces architectures évolutives et géographiquement distribuées.
Néanmoins, l’adoption de l’apprentissage par renforcement (RL) par les entreprises pour la gestion du trafic n’en est encore qu’à ses débuts. De nombreuses entreprises restent réticentes en raison de préoccupations liées à son imprévisibilité ou des difficultés à expliquer les décisions du RL aux équipes chargées de la conformité ou aux organismes de réglementation. Cela souligne l’importance de l’IA explicable (XAI) — un domaine de recherche actif qui vise à mieux comprendre comment les modèles de ML prennent leurs décisions.
Une vision pour 2030
Selon moi, au cours des cinq prochaines années, la gestion du trafic basée sur l’apprentissage par renforcement passera d’expérimentations de niche à une adoption plus généralisée par les entreprises tournées vers l’avenir. D’ici 2030, je prévois :
- Orchestration multicloud dynamique : L’apprentissage par renforcement deviendra la norme pour orchestrer les charges de travail entre plusieurs clouds publics et privés, en optimisant les coûts et les performances bien plus efficacement que les réglages manuels actuels.
- Intégration renforcée à l’observabilité de l’IA : Les outils qui consignent, visualisent et interprètent de manière fluide les décisions des agents d’apprentissage par renforcement apaiseront les préoccupations en matière de conformité et simplifieront le débogage.
- Agents collaboratifs : Nous verrons plusieurs agents d’apprentissage par renforcement collaborer au sein d’un même environnement, chacun étant chargé de tâches spécialisées, à la manière d’une équipe d’experts : certains s’occuperont de l’allocation des ressources, tandis que d’autres se concentreront sur les contraintes de sécurité ou de qualité de service.
Si certains sceptiques doutent que l’apprentissage par renforcement (RL) tienne ses promesses, j’y vois pour ma part une voie particulièrement prometteuse pour surmonter les défis inévitables qu’entraînera cette complexité croissante. D’après mon expérience, la dynamique est déjà bien engagée, et je suis convaincu que le RL continuera de façonner l’avenir de la gestion du trafic à mesure que les entreprises rechercheront des solutions plus adaptatives et intelligentes.
Vos prochaines étapes
Alors, est-il temps de vous débarrasser de vos répartiteurs de charge qui ont fait leurs preuves ? Pas encore — mais il est grand temps de commencer à expérimenter des approches fondées sur l’apprentissage par renforcement (RL), si ce n’est pas déjà fait. Testez-les dans des environnements à moindre risque, mesurez les gains de performance et collaborez avec des équipes pluridisciplinaires. Vous pourrez ainsi élaborer une feuille de route pragmatique qui concilie le potentiel du RL avec les contraintes du monde réel.
À propos de l’auteur
Articles de blog associés

Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.