Nota do editor – Esta série de artigos em sete partes está concluída:
- Introdução aos microsserviços
- Criando microsserviços: usando um gateway de API
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços (este artigo)
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Escolhendo uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre a implementação de microsserviços usando o NGINX Plus, no formato de e-book – Microsserviços: do design à implantação. Confira também a nova página de soluções de microsserviços.
Este é o terceiro artigo da nossa série sobre a criação de aplicações com uma arquitetura de microsserviços. O primeiro artigo apresenta o padrão de arquitetura de microsserviços, compara esse padrão com o padrão de arquitetura monolítica e discute as vantagens e desvantagens do uso de microsserviços. O segundo artigo descreve como os clientes de uma aplicação se comunicam com os microsserviços por meio de um intermediário conhecido como API Gateway. Neste artigo, analisamos como os serviços de um sistema se comunicam entre si. O quarto artigo explora o problema intimamente relacionado da descoberta de serviços.
Introdução
Em uma aplicação monolítica, os componentes invocam uns aos outros por meio de chamadas de métodos ou funções da própria linguagem. Em contrapartida, uma aplicação baseada em microsserviços é um sistema distribuído executado em várias máquinas. Cada instância de serviço é, normalmente, um processo. Consequentemente, como mostra o diagrama a seguir, os serviços devem interagir usando um mecanismo de comunicação entre processos (IPC).
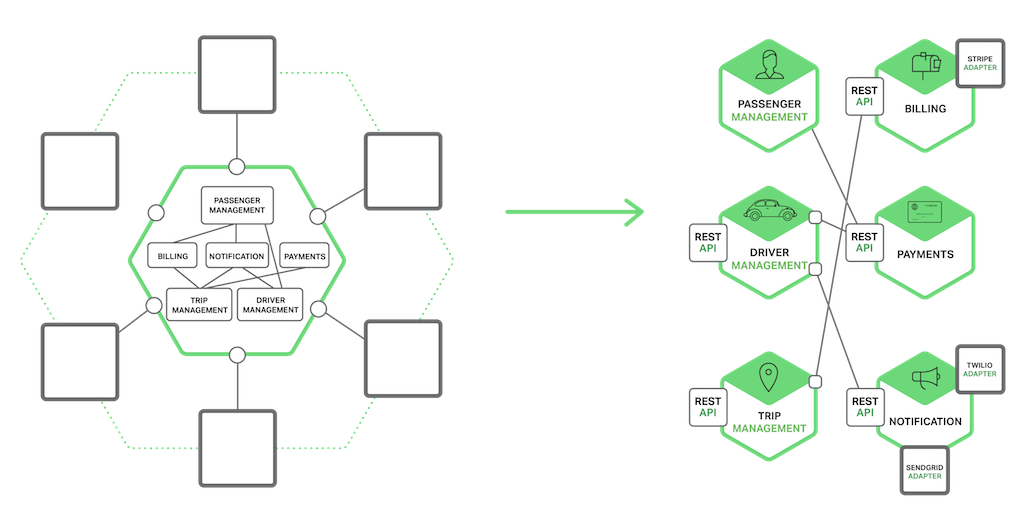
Mais adiante, veremos tecnologias específicas de IPC, mas primeiro vamos explorar várias questões de projeto.
Estilos de interação
Ao selecionar um mecanismo de IPC para um serviço, é útil pensar primeiro em como os serviços interagem. Há vários estilos de interação cliente⇔serviço. Eles podem ser classificados em duas dimensões. A primeira dimensão é se a interação é de um para um ou de um para muitos:
- Um para um – Cada solicitação do cliente é processada por exatamente uma instância do serviço.
- Um para muitos – Cada solicitação é processada por várias instâncias de serviço.
A segunda dimensão é se a interação é síncrona ou assíncrona:
- Síncrona – O cliente espera uma resposta rápida do serviço e pode até ficar bloqueado enquanto aguarda.
- Assíncrono – O cliente não fica bloqueado enquanto aguarda uma resposta, e a resposta, se houver, não é necessariamente enviada de imediato.
A tabela a seguir mostra os vários estilos de interação.
| Um para um | Um para muitos | |
|---|---|---|
| Síncrono | Solicitação/resposta | — |
| Assíncrono | Notificação | Publicação/assinatura |
| Solicitação/resposta assíncrona | Publicação/respostas assíncronas |
Existem os seguintes tipos de interações um para um:
- Requisição/resposta – Um cliente faz uma requisição a um serviço e aguarda uma resposta. O cliente espera que a resposta chegue em tempo hábil. Em uma aplicação baseada em threads, a thread que faz a requisição pode até ficar bloqueada enquanto aguarda.
- Notificação (também conhecida como solicitação unidirecional) – Um cliente envia uma solicitação a um serviço, mas nenhuma resposta é esperada ou enviada.
- Requisição/resposta assíncrona – Um cliente envia uma requisição a um serviço, que responde de forma assíncrona. O cliente não fica bloqueado enquanto aguarda e é projetado considerando que a resposta pode demorar a chegar.
Existem os seguintes tipos de interações de um para muitos:
- Publicação/assinatura – Um cliente publica uma mensagem de notificação, que é consumida por zero ou mais serviços interessados.
- Publicação/respostas assíncronas – Um cliente publica uma mensagem de solicitação e, em seguida, aguarda por um determinado período as respostas dos serviços interessados.
Cada serviço normalmente usa uma combinação desses estilos de interação. Para alguns serviços, um único mecanismo de IPC é suficiente. Outros serviços podem precisar usar uma combinação de mecanismos de IPC. O diagrama a seguir mostra como os serviços de um aplicativo de chamada de táxi podem interagir quando o usuário solicita uma corrida.
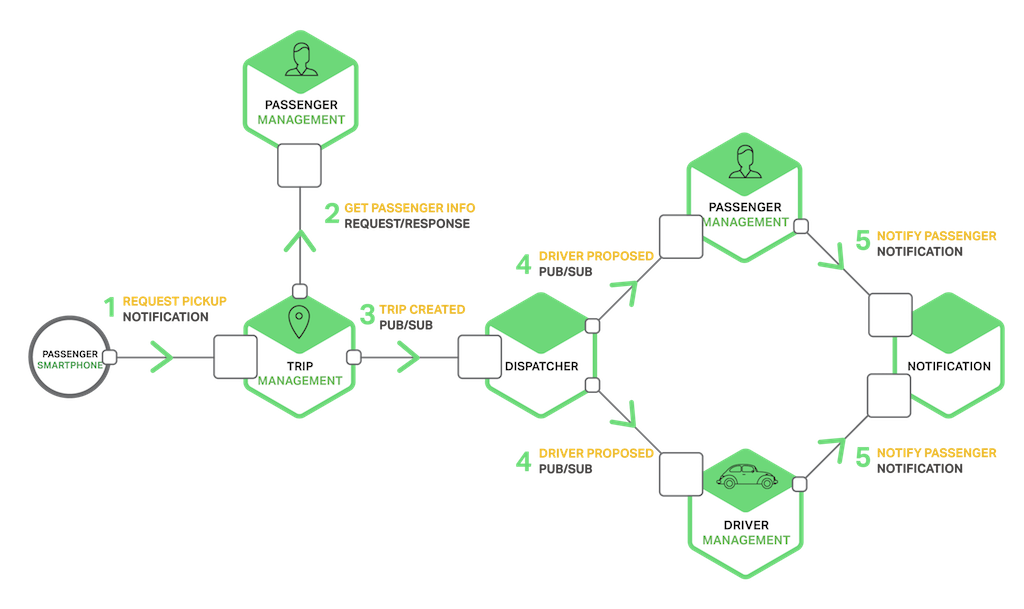
Os serviços usam uma combinação de notificações, requisição/resposta e publicação/assinatura. Por exemplo, o smartphone do passageiro envia uma notificação ao serviço de Gerenciamento de Viagens para solicitar um embarque. O serviço de Gerenciamento de Viagens verifica se a conta do passageiro está ativa usando requisição/resposta para chamar o Serviço de Passageiros. Em seguida, o serviço de Gerenciamento de Viagens cria a viagem e usa publicação/assinatura para notificar outros serviços, incluindo o Despachante, que localiza um motorista disponível.
Agora que já vimos os estilos de interação, vamos ver como definir APIs.
Definindo APIs
A API de um serviço é um contrato entre o serviço e seus clientes. Independentemente do mecanismo de IPC escolhido, é importante definir com precisão a API de um serviço usando algum tipo de linguagem de definição de interface (IDL). Há até bons argumentos a favor do uso de uma abordagem API-first para definir serviços. Você começa o desenvolvimento de um serviço escrevendo a definição da interface e revisando-a com os desenvolvedores dos clientes. Somente após refinar a definição da API de forma iterativa é que você implementa o serviço. Fazer esse trabalho de projeto antecipadamente aumenta suas chances de criar um serviço que atenda às necessidades de seus clientes.
Como você verá mais adiante neste artigo, a natureza da definição da API depende do mecanismo de IPC que você está usando. Se você estiver usando mensageria, a API será composta pelos canais e tipos de mensagens. Se estiver usando HTTP, a API será composta pelas URLs e pelos formatos de requisição e resposta. Mais adiante, descreveremos algumas IDLs com mais detalhes.
Evolução das APIs
A API de um serviço invariavelmente muda ao longo do tempo. Em uma aplicação monolítica, geralmente é simples alterar a API e atualizar todos os seus consumidores. Em uma aplicação baseada em microsserviços, isso é muito mais difícil, mesmo que todos os consumidores da sua API sejam outros serviços da mesma aplicação. Geralmente, não é possível obrigar todos os clientes a se atualizarem ao mesmo tempo que o serviço. Além disso, você provavelmente vai implantar novas versões de um serviço de forma incremental de modo que as versões antigas e novas do serviço sejam executadas simultaneamente. É importante ter uma estratégia para lidar com essas questões.
A forma como você lida com uma alteração na API depende da dimensão dessa alteração. Algumas alterações são pequenas e mantêm a compatibilidade com a versão anterior. Você pode, por exemplo, adicionar atributos às requisições ou respostas. Faz sentido projetar clientes e serviços de modo que sigam o princípio da robustez. Os clientes que usam uma API mais antiga devem continuar funcionando com a nova versão do serviço. O serviço fornece valores padrão para os atributos ausentes nas requisições, e os clientes ignoram quaisquer atributos extras nas respostas. É importante usar um mecanismo de IPC e um formato de mensagens que permitam evoluir suas APIs com facilidade..
Às vezes, porém, é necessário fazer alterações significativas e incompatíveis em uma API. Como não é possível forçar os clientes a atualizar imediatamente, um serviço deve oferecer suporte a versões anteriores da API por algum tempo. Se você estiver usando um mecanismo baseado em HTTP, como REST, uma abordagem é incluir o número da versão na URL. Cada instância do serviço pode lidar com várias versões simultaneamente. Como alternativa, você pode implantar instâncias diferentes, cada uma responsável por uma versão específica.
Como lidar com falhas parciais
Considere, por exemplo, o cenário de detalhes do produto daquele artigo. Vamos imaginar que o Serviço de Recomendação não esteja respondendo. Uma implementação ingênua de um cliente poderia ficar bloqueada indefinidamente à espera de uma resposta. Isso não apenas resultaria em uma experiência ruim para o usuário, mas também, em muitas aplicações, consumiria um recurso precioso, como uma thread. Com o tempo, o ambiente de execução ficaria sem threads disponíveis e deixaria de responder, como mostra a figura a seguir.
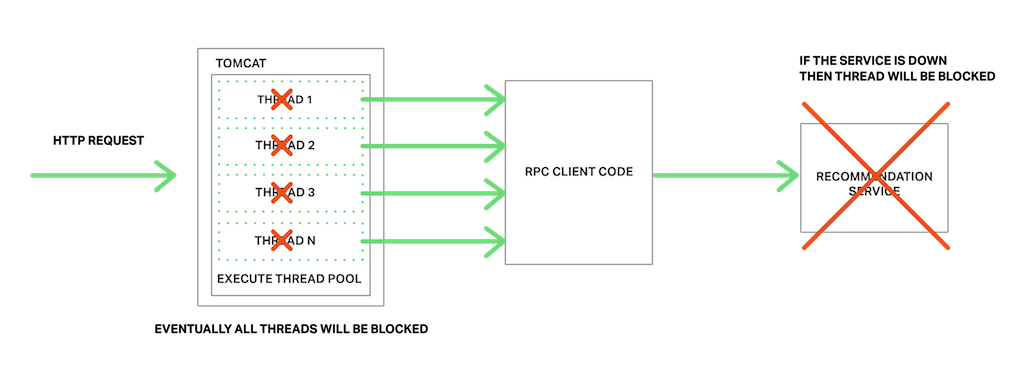
Para evitar esse problema, é essencial que você projete seus serviços para lidar com falhas parciais.
Uma boa abordagem a seguir é a descrita pela Netflix. As estratégias para lidar com falhas parciais incluem:
- Tempos limite de rede – Nunca bloqueie indefinidamente e sempre defina tempos limite ao aguardar uma resposta. O uso de tempos limite garante que os recursos nunca fiquem ocupados indefinidamente.
- Limitação do número de solicitações pendentes – Defina um limite máximo para o número de solicitações pendentes que um cliente pode ter em um determinado serviço. Se o limite for atingido, provavelmente não fará sentido enviar mais solicitações, e essas tentativas deverão falhar imediatamente.
- Padrão Circuit Breaker – Monitore o número de solicitações bem-sucedidas e com falha. Se a taxa de erros exceder um limite configurado, abra o circuito para que as próximas tentativas falhem imediatamente. Se um grande número de solicitações estiver falhando, isso indica que o serviço está indisponível e que não adianta enviar solicitações. Após um período de espera, o cliente deve tentar novamente e, se a tentativa for bem-sucedida, fechar o circuito.
- Ofereça alternativas – Execute uma lógica alternativa quando uma solicitação falhar. Por exemplo, retorne dados em cache ou um valor padrão, como um conjunto vazio de recomendações.
Netflix Hystrix é uma biblioteca de código aberto que implementa esses e outros padrões. Se você usa a JVM, deve considerar seriamente o uso do Hystrix. E, se estiver em um ambiente sem JVM, deve usar uma biblioteca equivalente.
Tecnologias de IPC
Há muitas tecnologias de IPC diferentes para escolher. Os serviços podem usar mecanismos de comunicação síncronos baseados em requisição/resposta, como REST sobre HTTP ou Thrift. Como alternativa, podem usar mecanismos de comunicação assíncronos baseados em mensagens, como AMQP ou STOMP. Também há uma variedade de formatos de mensagem. Os serviços podem usar formatos de texto legíveis por humanos, como JSON ou XML. Como alternativa, podem usar um formato binário (que é mais eficiente), como Avro ou Protocol Buffers. Mais adiante, veremos os mecanismos de IPC síncronos, mas primeiro vamos discutir os mecanismos de IPC assíncronos.
Comunicação assíncrona baseada em mensagens
Ao usar mensageria, os processos se comunicam por meio da troca assíncrona de mensagens. Um cliente faz uma solicitação a um serviço enviando uma mensagem a ele. Se uma resposta do serviço for esperada, ele a envia ao cliente em uma mensagem separada. Como a comunicação é assíncrona, o cliente não fica bloqueado aguardando uma resposta. Em vez disso, o cliente é implementado considerando que a resposta não será recebida imediatamente.
Uma mensagem consiste em cabeçalhos (metadados, como o remetente) e um corpo de mensagem. As mensagens são trocadas por meio de canais. Qualquer número de produtores pode enviar mensagens para um canal. Da mesma forma, qualquer número de consumidores pode receber mensagens de um canal. Existem dois tipos de canais: ponto a ponto e publicação e assinatura. Um canal ponto a ponto entrega uma mensagem a exatamente um dos consumidores que estão lendo desse canal. Os serviços usam canais ponto a ponto para os estilos de interação um para um descritos anteriormente. Um canal de publicação e assinatura entrega cada mensagem a todos os consumidores conectados a ele. Os serviços usam canais de publicação e assinatura para os estilos de interação um para muitos descritos acima.
O diagrama a seguir mostra como o aplicativo de solicitação de táxis poderia usar canais de publicação e assinatura.
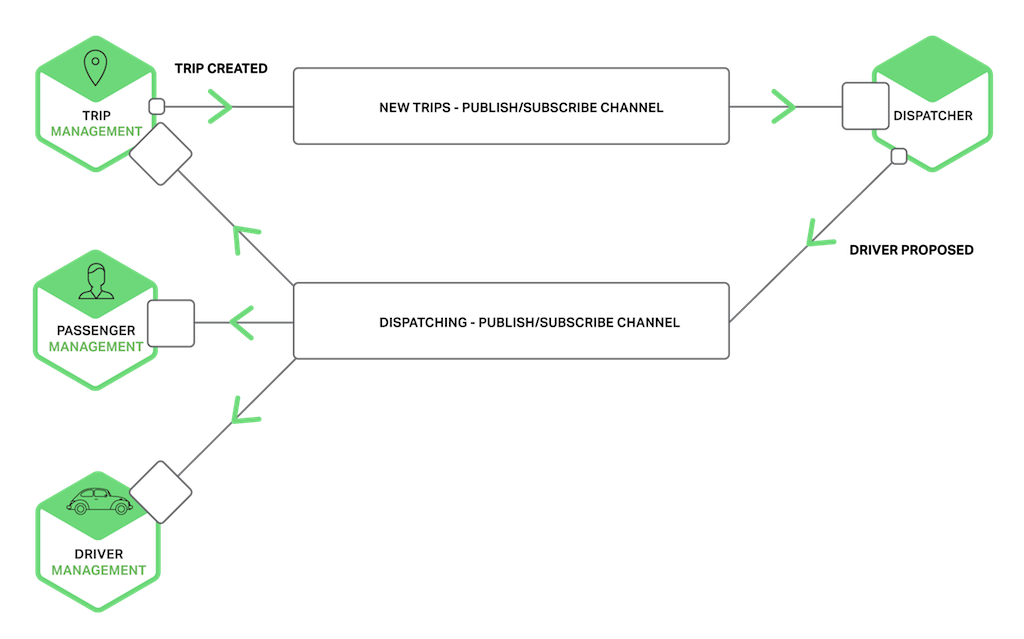
O serviço de Gerenciamento de Viagens notifica os serviços interessados, como o Despachante, sobre uma nova viagem publicando uma mensagem de Viagem Criada em um canal de publicação/assinatura. O Despachante encontra um motorista disponível e notifica os outros serviços publicando uma mensagem de Motorista Proposto em um canal de publicação/assinatura.
Existem muitos sistemas de mensageria para escolher. Você deve optar por um que ofereça suporte a diversas linguagens de programação. Alguns sistemas de mensageria oferecem suporte a protocolos padrão, como AMQP e STOMP. Outros têm protocolos proprietários, mas documentados. Há um grande número de sistemas de mensageria de código aberto disponíveis, incluindo RabbitMQ, Apache Kafka, Apache ActiveMQ e NSQ. De modo geral, todos oferecem suporte a alguma forma de mensagens e canais. Todos buscam ser confiáveis, escaláveis e oferecer alto desempenho. No entanto, há diferenças significativas nos detalhes do modelo de mensageria de cada broker.
Há muitas vantagens em usar mensageria:
- Desacopla o cliente do serviço – Um cliente faz uma solicitação simplesmente enviando uma mensagem para o canal apropriado. O cliente não tem conhecimento das instâncias do serviço. Ele não precisa usar um mecanismo de descoberta para determinar a localização de uma instância do serviço.
- Armazenamento de mensagens em buffer – Com um protocolo síncrono de requisição/resposta, como o HTTP, tanto o cliente quanto o serviço precisam estar disponíveis durante toda a troca de mensagens. Em contrapartida, um broker de mensagens coloca em fila as mensagens enviadas a um canal até que possam ser processadas pelo consumidor. Isso significa, por exemplo, que uma loja virtual pode aceitar pedidos de clientes mesmo quando o sistema de processamento de pedidos está lento ou indisponível. As mensagens dos pedidos simplesmente ficam na fila.
- Interações flexíveis entre cliente e serviço – A troca de mensagens oferece suporte a todos os estilos de interação descritos anteriormente.
- Comunicação explícita entre processos – Os mecanismos baseados em RPC tentam fazer com que invocar um serviço remoto pareça o mesmo que chamar um serviço local. No entanto, devido às leis da física e à possibilidade de falhas parciais, essas operações são, na verdade, bastante diferentes. A troca de mensagens torna essas diferenças muito explícitas, evitando que os desenvolvedores sejam levados a uma falsa sensação de segurança.
No entanto, há algumas desvantagens no uso de mensageria:
- Complexidade operacional adicional – O sistema de mensageria é mais um componente do sistema que precisa ser instalado, configurado e operado. É essencial que o broker de mensagens tenha alta disponibilidade; caso contrário, a confiabilidade do sistema será comprometida.
- Complexidade de implementação da interação baseada em requisição/resposta – A interação no estilo requisição/resposta exige algum esforço de implementação. Cada mensagem de requisição deve conter um identificador do canal de resposta e um identificador de correlação. O serviço grava no canal de resposta uma mensagem de resposta contendo o ID de correlação. O cliente usa o ID de correlação para associar a resposta à requisição. Muitas vezes, é mais fácil usar um mecanismo de IPC que ofereça suporte direto a requisição/resposta.
Agora que vimos o uso de IPC baseado em mensagens, vamos examinar o IPC baseado em requisição/resposta.
IPC síncrona baseada em solicitação/resposta
Ao usar um mecanismo de IPC síncrono baseado em requisição/resposta, um cliente envia uma requisição a um serviço. O serviço processa a requisição e envia uma resposta. Em muitos clientes, a thread que faz a requisição fica bloqueada enquanto aguarda uma resposta. Outros clientes podem usar código assíncrono, orientado a eventos, possivelmente encapsulado em Futures ou Observables do Rx. No entanto, diferentemente do que ocorre ao usar mensageria, o cliente pressupõe que a resposta chegará em tempo hábil. Há diversos protocolos disponíveis. Dois protocolos populares são REST e Thrift. Vamos primeiro dar uma olhada no REST.
REST
Hoje em dia, está na moda desenvolver APIs no estilo RESTful. REST é um mecanismo de IPC que (quase sempre) usa HTTP. Um conceito fundamental em REST é o de recurso, que normalmente representa um objeto de negócio, como um Cliente ou Produto, ou uma coleção de objetos de negócio. REST usa os verbos HTTP para manipular recursos, que são referenciados por uma URL. Por exemplo, uma requisição GET retorna a representação de um recurso, que pode estar na forma de um documento XML ou de um objeto JSON. Uma requisição POST cria um novo recurso e uma requisição PUT atualiza um recurso. Nas palavras de Roy Fielding, o criador do REST:
“O REST fornece um conjunto de restrições arquiteturais que, quando aplicadas em conjunto, enfatizam a escalabilidade das interações entre componentes, a generalidade das interfaces, a implantação independente de componentes e o uso de componentes intermediários para reduzir a latência das interações, garantir a segurança e encapsular sistemas legados.”
O diagrama a seguir mostra uma das maneiras pelas quais o aplicativo de solicitação de táxi pode usar REST.
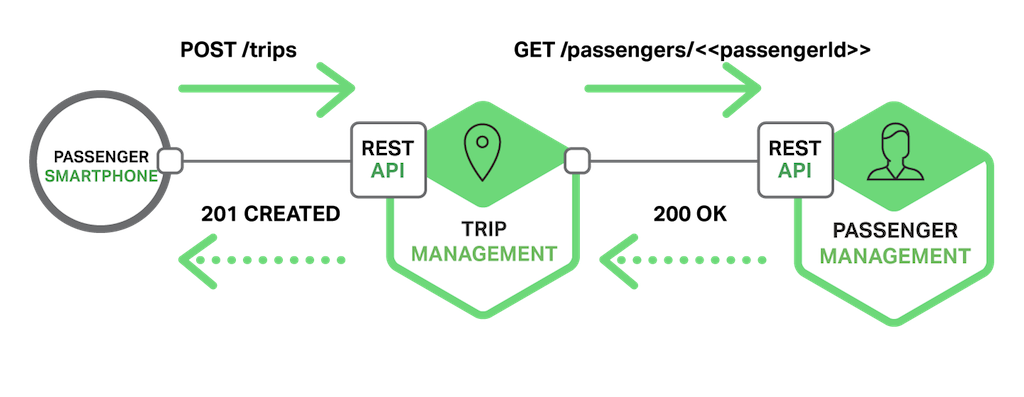
O smartphone do passageiro solicita uma viagem fazendo uma requisição POST ao recurso /trips do serviço de Gerenciamento de Viagens. Esse serviço processa a requisição enviando uma requisição GET ao serviço de Gerenciamento de Passageiros para obter informações sobre o passageiro. Após verificar se o passageiro está autorizado a criar uma viagem, o serviço de Gerenciamento de Viagens cria a viagem e retorna uma resposta 201 ao smartphone.
Muitos desenvolvedores afirmam que suas APIs baseadas em HTTP são RESTful. No entanto, como Fielding descreve nesta publicação no blog, nem todas realmente são. Leonard Richardson (sem parentesco com o autor) define um modelo de maturidade para REST muito útil, que consiste nos níveis a seguir.
- Nível 0 – Os clientes de uma API de nível 0 invocam o serviço fazendo requisições HTTP
POSTao seu único endpoint de URL. Cada requisição especifica a ação a ser executada, o alvo da ação (por exemplo, o objeto de negócio) e quaisquer parâmetros. - Nível 1 – Uma API de nível 1 adota o conceito de recursos. Para executar uma ação em um recurso, o cliente faz uma requisição
POSTque especifica a ação a ser executada e os parâmetros necessários. - Nível 2 – Uma API de nível 2 usa verbos HTTP para executar ações:
GETpara recuperar,POSTpara criar ePUTpara atualizar. Os parâmetros de consulta e o corpo da requisição, se houver, especificam os parâmetros da ação. Isso permite que os serviços aproveitem a infraestrutura da Web, como o armazenamento em cache para requisiçõesGET. - Nível 3 – O projeto de uma API de nível 3 se baseia no princípio de nome nada feliz HATEOAS (Hipertexto como Motor do Estado da Aplicação). A ideia básica é que a representação de um recurso retornada por uma requisição
GETcontém links para executar as ações permitidas nesse recurso. Por exemplo, um cliente pode cancelar um pedido usando um link na representação do pedido retornada em resposta à requisiçãoGETenviada para recuperar o pedido. Os benefícios do HATEOAS incluem não precisar mais fixar URLs no código do cliente. Outro benefício é que, como a representação de um recurso contém links para as ações permitidas, o cliente não precisa adivinhar quais ações podem ser executadas em um recurso no estado em que ele se encontra.
Há inúmeros benefícios em usar um protocolo baseado em HTTP:
- O HTTP é simples e familiar.
- Você pode testar uma API HTTP no navegador usando uma extensão como o Postman ou pela linha de comando usando o
curl(supondo que seja usado JSON ou algum outro formato de texto). - Ele oferece suporte direto à comunicação no modelo de requisição/resposta.
- O HTTP é, naturalmente, compatível com firewalls.
- Não exige um broker intermediário, o que simplifica a arquitetura do sistema.
Há algumas desvantagens no uso de HTTP:
- Ele oferece suporte direto apenas ao modelo de interação de requisição/resposta. Você pode usar HTTP para notificações, mas o servidor deve sempre enviar uma resposta HTTP.
- Como o cliente e o serviço se comunicam diretamente (sem um intermediário para armazenar temporariamente as mensagens), ambos devem estar em execução durante toda a troca de mensagens.
- O cliente precisa saber a localização (ou seja, a URL) de cada instância de serviço. Conforme descrito no artigo anterior sobre o API Gateway, esse não é um problema trivial em uma aplicação moderna. Os clientes precisam usar um mecanismo de descoberta de serviços para localizar as instâncias de serviço.
A comunidade de desenvolvedores redescobriu recentemente o valor de uma linguagem de definição de interface para APIs RESTful. Existem algumas opções, incluindo RAML e Swagger. Algumas IDLs, como o Swagger, permitem definir o formato das mensagens de solicitação e resposta. Outras, como o RAML, exigem o uso de uma especificação separada, como o JSON Schema. Além de descrever APIs, as IDLs geralmente contam com ferramentas que geram stubs de cliente e esqueletos de servidor a partir de uma definição de interface.
Thrift
Apache Thrift é uma alternativa interessante ao REST. É um framework para desenvolver clientes e servidores RPC em diferentes linguagens. O Thrift oferece uma IDL no estilo C para definir suas APIs. Você usa o compilador do Thrift para gerar stubs do lado do cliente e esqueletos do lado do servidor. O compilador gera código para diversas linguagens, incluindo C++, Java, Python, PHP, Ruby, Erlang e Node.js.
Uma interface Thrift consiste em um ou mais serviços. A definição de um serviço é análoga a uma interface Java. Trata-se de um conjunto de métodos fortemente tipados. Os métodos Thrift podem retornar um valor (possivelmente void) ou ser definidos como unidirecionais. Os métodos que retornam um valor implementam o estilo de interação de requisição/resposta. O cliente aguarda uma resposta e pode lançar uma exceção. Os métodos unidirecionais correspondem ao estilo de interação por notificação. O servidor não envia uma resposta.
O Thrift oferece suporte a vários formatos de mensagem: JSON, binário e binário compacto. O formato binário é mais eficiente que o JSON porque sua decodificação é mais rápida. E, como o nome sugere, o binário compacto é um formato que ocupa pouco espaço. O JSON, é claro, é fácil de ler por pessoas e de processar por navegadores. O Thrift também permite escolher entre protocolos de transporte, incluindo TCP puro e HTTP. O TCP puro tende a ser mais eficiente que o HTTP. No entanto, o HTTP funciona bem com firewalls e navegadores e é fácil de usar por pessoas.
Formatos de mensagem
Agora que já analisamos o HTTP e o Thrift, vamos examinar a questão dos formatos de mensagem. Se você usa um sistema de mensageria ou REST, pode escolher o formato das suas mensagens. Outros mecanismos de IPC, como o Thrift, podem oferecer suporte a apenas alguns formatos de mensagem, talvez a um só. Em qualquer caso, é importante usar um formato de mensagem compatível com diferentes linguagens. Mesmo que hoje você esteja desenvolvendo seus microsserviços em uma única linguagem, é provável que use outras linguagens no futuro.
Existem dois tipos principais de formatos de mensagem: texto e binário. Exemplos de formatos baseados em texto incluem JSON e XML. Uma vantagem desses formatos é que, além de serem legíveis por humanos, são autodescritivos. Em JSON, os atributos de um objeto são representados por um conjunto de pares nome-valor. Da mesma forma, em XML, os atributos são representados por elementos nomeados e valores. Isso permite que o consumidor de uma mensagem selecione os valores que lhe interessam e ignore os demais. Consequentemente, pequenas alterações no formato da mensagem podem facilmente manter a compatibilidade com versões anteriores.
A estrutura dos documentos XML é especificada por um esquema XML. Com o tempo, a comunidade de desenvolvedores percebeu que o JSON também precisa de um mecanismo semelhante. Uma opção é usar o JSON Schema, de forma independente ou como parte de uma IDL, como o Swagger.
Uma desvantagem de usar um formato de mensagem baseado em texto é que as mensagens tendem a ser verbosas, especialmente em XML. Como as mensagens são autodescritivas, cada uma contém os nomes dos atributos, além de seus valores. Outra desvantagem é o custo computacional da análise do texto. Por isso, vale a pena considerar o uso de um formato binário.
Há vários formatos binários à sua escolha. Se você estiver usando Thrift RPC, poderá usar o formato binário do Thrift. Se puder escolher o formato das mensagens, algumas opções populares são Protocol Buffers e Apache Avro. Ambos os formatos oferecem uma IDL tipada para definir a estrutura das suas mensagens. Uma diferença, porém, é que o Protocol Buffers usa campos identificados por tags, enquanto um consumidor Avro precisa conhecer o esquema para interpretar as mensagens. Por isso, é mais fácil evoluir uma API com Protocol Buffers do que com Avro. Esta postagem no blog apresenta uma excelente comparação entre Thrift, Protocol Buffers e Avro.
Resumo
Os microsserviços precisam se comunicar usando um mecanismo de comunicação entre processos. Ao projetar como seus serviços se comunicarão, você precisa considerar várias questões: como os serviços interagem, como especificar a API de cada serviço, como evoluir as APIs e como lidar com falhas parciais. Há dois tipos de mecanismos de comunicação entre processos (IPC) que os microsserviços podem usar: mensagens assíncronas e requisição/resposta síncrona. No próximo artigo da série, abordaremos o problema da descoberta de serviços em uma arquitetura de microsserviços.
Editor – Esta série de artigos em sete partes agora está completa:
- Introdução aos microsserviços
- Criando microsserviços: usando um API Gateway
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços (este artigo)
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Como escolher uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, em formato de e-book – Microsserviços: do design à implantação.
O blogueiro convidado Chris Richardson é o fundador da versão original do CloudFoundry.com, uma das primeiras PaaS (plataforma como serviço) Java para o Amazon EC2. Atualmente, ele presta consultoria a organizações para aprimorar a forma como desenvolvem e implantam aplicações. Ele também publica regularmente sobre microsserviços em seu blog em http://microservices.io.
Sobre o autor
Publicações relacionadas no blog
Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.
Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.
Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.
Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.