Editor – Esta série de sete artigos está agora completa:
- Introdução aos microsserviços
- Criando microsserviços: usando um gateway de API
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Como escolher uma estratégia de implantação de microsserviços (este artigo)
- Refatoração de um monólito em microsserviços
Você também pode baixar o conjunto completo de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação. Confira também nossa série sobre a Arquitetura de referência de microsserviços e a página de soluções para microsserviços.
Este é o sexto artigo de uma série sobre o desenvolvimento de aplicações com microsserviços. O primeiro artigo apresenta o padrão de arquitetura de microsserviços e discute as vantagens e desvantagens do uso de microsserviços. Os artigos seguintes abordam diferentes aspectos da arquitetura de microsserviços: uso de um API Gateway, comunicação entre processos, descoberta de serviços e gerenciamento de dados orientado a eventos. Neste artigo, analisamos estratégias para implantar microsserviços.
Motivações
Implantar uma aplicação monolítica significa executar várias cópias idênticas de uma única aplicação, geralmente de grande porte. Normalmente, você provisiona N servidores (físicos ou virtuais) e executa M instâncias da aplicação em cada um deles. A implantação de uma aplicação monolítica nem sempre é totalmente simples, mas é muito mais simples do que implantar uma aplicação de microsserviços.
Uma aplicação de microsserviços consiste em dezenas ou até centenas de serviços. Os serviços são escritos em diversas linguagens e frameworks. Cada um deles é uma miniaplicação com requisitos específicos de implantação, recursos, escalabilidade e monitoramento. Por exemplo, é necessário executar um determinado número de instâncias de cada serviço com base na demanda por esse serviço. Além disso, cada instância de serviço deve contar com os recursos adequados de CPU, memória e E/S. O que torna tudo ainda mais desafiador é que, apesar dessa complexidade, a implantação dos serviços deve ser rápida, confiável e econômica.
Existem alguns padrões diferentes de implantação de microsserviços. Vamos analisar primeiro o padrão de múltiplas instâncias de serviço por host.
Padrão de múltiplas instâncias de serviço por host
Uma forma de implantar seus microsserviços é usar o padrão Várias instâncias de serviço por host. Ao usar esse padrão, você provisiona um ou mais hosts físicos ou virtuais e executa várias instâncias de serviço em cada um deles. Em muitos aspectos, essa é a abordagem tradicional para a implantação de aplicações. Cada instância de serviço é executada em uma porta conhecida em um ou mais hosts. As máquinas host geralmente são tratadas como animais de estimação.
O diagrama a seguir mostra a estrutura desse padrão.
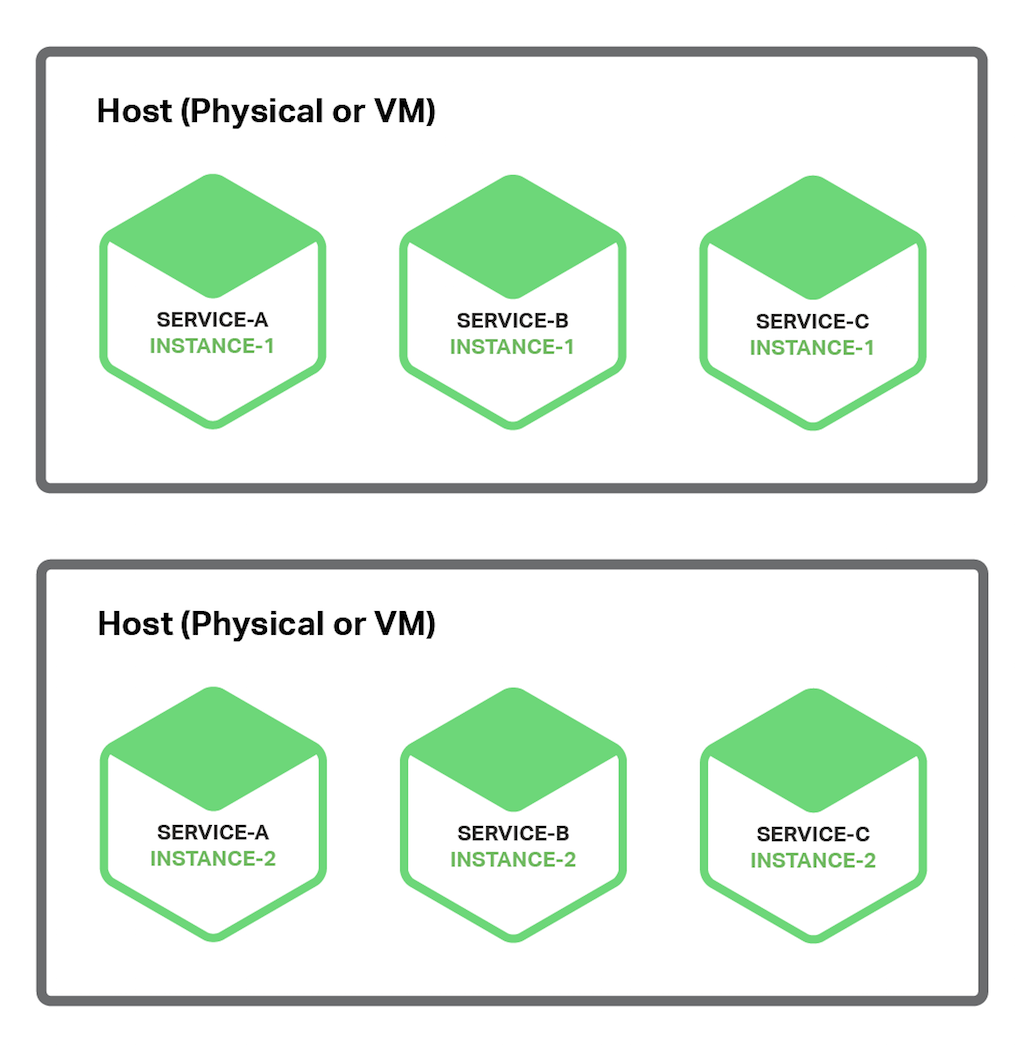
Há algumas variações desse padrão. Em uma delas, cada instância de serviço é um processo ou um grupo de processos. Por exemplo, você pode implantar uma instância de serviço Java como uma aplicação web em um servidor Apache Tomcat. Uma instância de serviço Node.js pode consistir em um processo pai e um ou mais processos filhos.
A outra variante desse padrão consiste em executar várias instâncias de serviço no mesmo processo ou grupo de processos. Por exemplo, você pode implantar várias aplicações web Java no mesmo servidor Apache Tomcat ou executar vários bundles OSGI no mesmo contêiner OSGI.
O padrão Múltiplas Instâncias de Serviço por Host apresenta vantagens e desvantagens. Uma das principais vantagens é o uso relativamente eficiente dos recursos. Várias instâncias de serviço compartilham o servidor e seu sistema operacional. A eficiência é ainda maior quando um processo ou grupo de processos executa várias instâncias de serviço, como no caso de várias aplicações web que compartilham o mesmo servidor Apache Tomcat e a mesma JVM.
Outro benefício desse padrão é que a implantação de uma instância de serviço é relativamente rápida. Basta copiar o serviço para um host e iniciá-lo. Se o serviço tiver sido escrito em Java, você copia um arquivo JAR ou WAR. Para outras linguagens, como Node.js ou Ruby, você copia o código-fonte. Em ambos os casos, a quantidade de bytes copiados pela rede é relativamente pequena.
Além disso, devido à ausência de sobrecarga, a inicialização de um serviço costuma ser muito rápida. Se o serviço tiver seu próprio processo, basta iniciá-lo. Caso contrário, se o serviço for uma das várias instâncias em execução no mesmo processo de contêiner ou grupo de processos, você poderá implantá-lo dinamicamente no contêiner ou reiniciar o contêiner.
Apesar de ser atraente, o padrão Várias Instâncias de Serviço por Host apresenta algumas desvantagens significativas. Uma das principais é que há pouco ou nenhum isolamento entre as instâncias de serviço, a menos que cada uma seja executada em um processo separado. Embora seja possível monitorar com precisão a utilização de recursos de cada instância de serviço, não é possível limitar os recursos usados por cada uma delas. Uma instância de serviço com comportamento inadequado pode consumir toda a memória ou CPU do host.
Não há nenhum isolamento quando várias instâncias de serviço são executadas no mesmo processo. Por exemplo, todas as instâncias podem compartilhar o mesmo heap da JVM. Uma instância de serviço com comportamento inadequado poderia facilmente comprometer os outros serviços executados no mesmo processo. Além disso, não há como monitorar os recursos usados por cada instância de serviço.
Outro problema significativo dessa abordagem é que a equipe de operações responsável por implantar um serviço precisa conhecer os detalhes específicos de como fazer isso. Os serviços podem ser escritos em diversas linguagens e frameworks, portanto, há muitos detalhes que a equipe de desenvolvimento precisa compartilhar com a equipe de operações. Essa complexidade aumenta o risco de erros durante a implantação.
Como você pode ver, apesar de ser bastante conhecido, o padrão Múltiplas Instâncias de Serviço por Host apresenta algumas desvantagens significativas. Vejamos agora outras formas de implantar microsserviços que evitem esses problemas.
Padrão de instância de serviço por host
Outra maneira de implantar seus microsserviços é usar o padrão Instância de serviço por host. Ao usar esse padrão, você executa cada instância de serviço de forma isolada em seu próprio host. Há duas especializações diferentes desse padrão: Instância de serviço por máquina virtual e Instância de serviço por contêiner.
Padrão de instância de serviço por máquina virtual
Ao usar o padrão Instância de serviço por máquina virtual, você empacota cada serviço como uma imagem de máquina virtual (VM), como uma AMI do Amazon EC2. Cada instância de serviço é uma VM (por exemplo, uma instância do EC2) iniciada usando essa imagem de VM. O diagrama a seguir mostra a estrutura desse padrão:
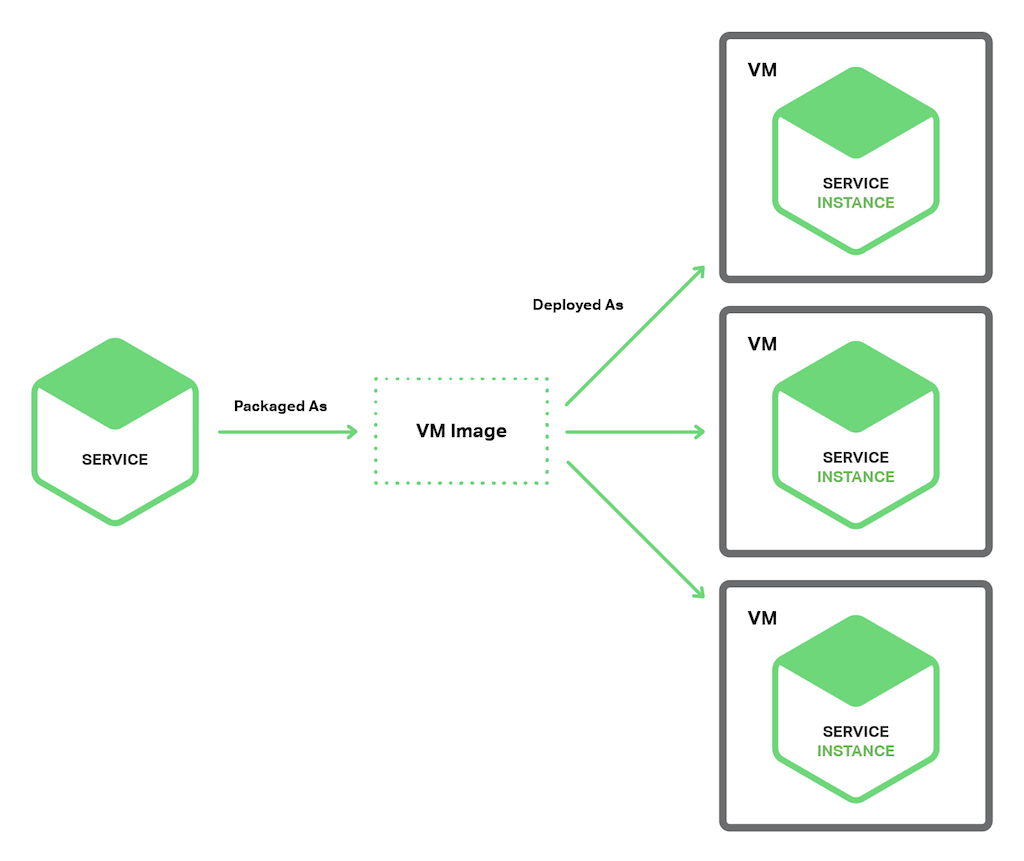
Essa é a principal abordagem usada pela Netflix para implantar seu serviço de streaming de vídeo. A Netflix empacota cada um de seus serviços como uma AMI do EC2 usando o Aminator. Cada instância de serviço em execução é uma instância do EC2.
Há diversas ferramentas que você pode usar para criar suas próprias VMs. Você pode configurar seu servidor de integração contínua (CI) (por exemplo, Jenkins) para executar o Aminator e empacotar seus serviços como uma AMI do EC2. Packer.io é outra opção para a criação automatizada de imagens de VM. Ao contrário do Aminator, ele oferece suporte a diversas tecnologias de virtualização, incluindo EC2, DigitalOcean, VirtualBox e VMware.
A empresa Boxfuse oferece uma maneira interessante de criar imagens de VM, que supera as desvantagens das VMs descritas abaixo. A Boxfuse empacota seu aplicativo Java como uma imagem mínima de VM. Essas imagens são rápidas de criar e inicializar, além de serem mais seguras, pois apresentam uma superfície de ataque limitada.
A empresa CloudNative oferece o Bakery, uma solução SaaS para a criação de AMIs do EC2. Você pode configurar seu servidor de CI para acionar o Bakery após os testes do seu microsserviço serem aprovados. Em seguida, o Bakery empacota seu serviço como uma AMI. Usar uma solução SaaS como o Bakery significa que você não precisa desperdiçar um tempo valioso configurando a infraestrutura de criação de AMIs.
O padrão Instância de Serviço por Máquina Virtual oferece vários benefícios. Uma das principais vantagens das VMs é que cada instância de serviço é executada de forma totalmente isolada. Ela dispõe de uma quantidade fixa de CPU e memória e não pode consumir recursos de outros serviços.
Outro benefício de implantar seus microsserviços como VMs é poder aproveitar uma infraestrutura de nuvem consolidada. Provedores de nuvem como a AWS oferecem recursos úteis, como balanceamento de carga e escalabilidade automática.
Outro grande benefício de implantar seu serviço como uma máquina virtual é que ela encapsula a tecnologia usada na implementação do serviço. Depois que um serviço é empacotado como uma máquina virtual, ele se torna uma caixa-preta. A API de gerenciamento da máquina virtual passa a ser a API usada para implantar o serviço. A implantação se torna muito mais simples e confiável.
No entanto, o padrão de uma instância de serviço por máquina virtual apresenta algumas desvantagens. Uma delas é a utilização menos eficiente dos recursos. Cada instância de serviço tem a sobrecarga de uma VM inteira, incluindo o sistema operacional. Além disso, em uma IaaS pública típica, as VMs são oferecidas em tamanhos fixos, e é possível que a VM seja subutilizada.
Além disso, uma IaaS pública normalmente cobra pelas VMs, independentemente de estarem em uso ou ociosas. Uma IaaS como a AWS oferece escalabilidade automática, mas é difícil reagir rapidamente às mudanças na demanda. Consequentemente, muitas vezes é necessário provisionar VMs em excesso, o que aumenta o custo da implantação.
Outra desvantagem dessa abordagem é que a implantação de uma nova versão de um serviço costuma ser lenta. Normalmente, as imagens de VM demoram para ser criadas devido ao seu tamanho. Além disso, as VMs geralmente demoram para ser instanciadas, também por causa de seu tamanho. Um sistema operacional também costuma levar algum tempo para inicializar. No entanto, vale observar que isso não é uma regra universal, pois existem VMs leves, como as criadas pelo Boxfuse.
Outra desvantagem do padrão Instância de Serviço por Máquina Virtual é que, geralmente, você (ou outra pessoa da sua organização) fica responsável por grande parte do trabalho operacional indiferenciado. A menos que você use uma ferramenta como o Boxfuse, que cuida da sobrecarga de criar e gerenciar as VMs, essa responsabilidade será sua. Essa atividade necessária, mas demorada, desvia a atenção do seu negócio principal.
Agora, vamos analisar uma forma alternativa de implantar microsserviços que é mais leve, mas ainda oferece muitos dos benefícios das VMs.
Padrão de instância de serviço por contêiner
Ao usar o padrão Instância de serviço por contêiner, cada instância de serviço é executada em seu próprio contêiner. Os contêineres são um mecanismo de virtualização no nível do sistema operacional. Um contêiner consiste em um ou mais processos executados em um ambiente isolado. Do ponto de vista dos processos, eles têm seu próprio namespace de portas e sistema de arquivos raiz. É possível limitar os recursos de memória e CPU de um contêiner. Algumas implementações de contêineres também permitem limitar a taxa de E/S. Exemplos de tecnologias de contêiner incluem Docker e Solaris Zones.
O diagrama a seguir mostra a estrutura desse padrão:
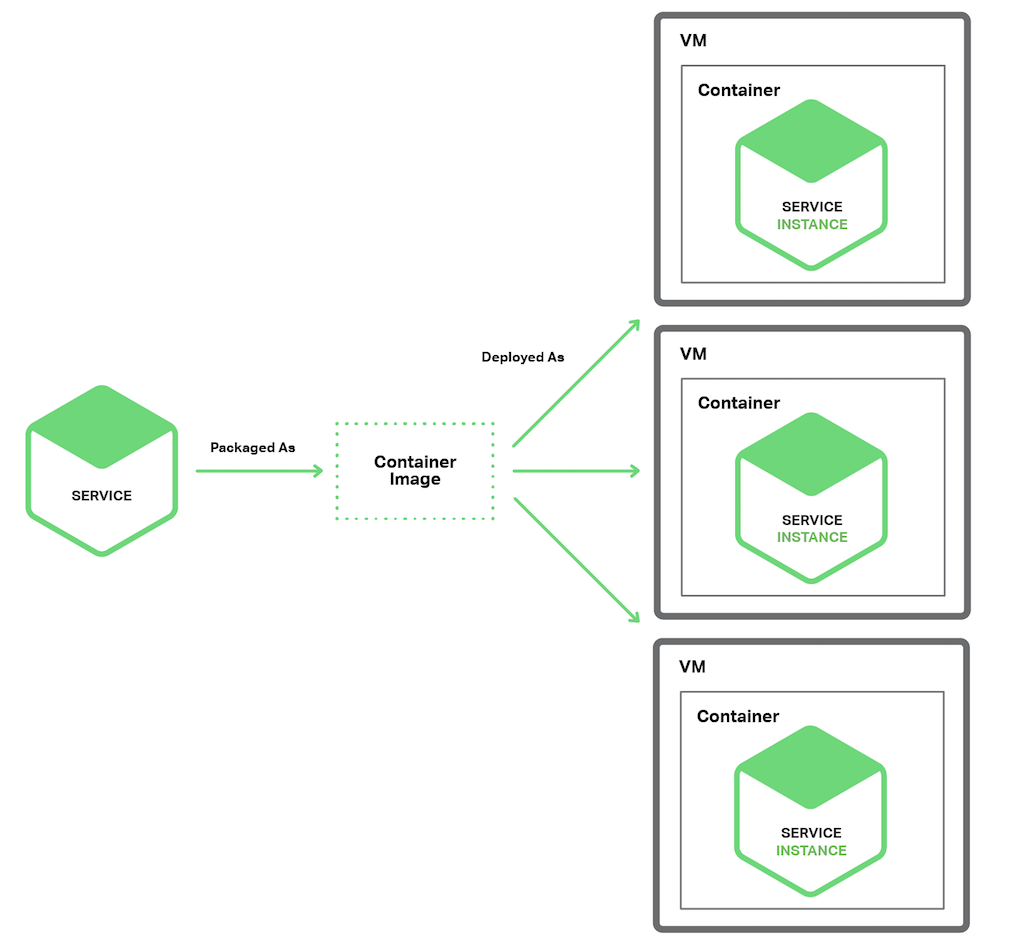
Para usar esse padrão, empacote seu serviço como uma imagem de contêiner. Uma imagem de contêiner é uma imagem do sistema de arquivos que contém os aplicativos e as bibliotecas necessários para executar o serviço. Algumas imagens de contêiner incluem um sistema de arquivos raiz completo do Linux. Outras são mais leves. Para implantar um serviço Java, por exemplo, crie uma imagem de contêiner que contenha o ambiente de execução Java, possivelmente um servidor Apache Tomcat, e seu aplicativo Java compilado.
Depois de empacotar seu serviço como uma imagem de contêiner, você inicia um ou mais contêineres. Normalmente, vários contêineres são executados em cada host físico ou virtual. Você pode usar um gerenciador de cluster, como o Kubernetes ou o Marathon, para gerenciar seus contêineres. Um gerenciador de cluster trata os hosts como um pool de recursos. Ele decide onde alocar cada contêiner com base nos recursos exigidos pelo contêiner e nos recursos disponíveis em cada host.
O padrão Instância de Serviço por Contêiner apresenta vantagens e desvantagens. As vantagens dos contêineres são semelhantes às das máquinas virtuais. Eles isolam as instâncias de serviço umas das outras. É possível monitorar facilmente os recursos consumidos por cada contêiner. Além disso, assim como as máquinas virtuais, os contêineres encapsulam a tecnologia usada para implementar seus serviços. A API de gerenciamento de contêineres também funciona como a API de gerenciamento dos seus serviços.
No entanto, ao contrário das VMs, os contêineres são uma tecnologia leve. Normalmente, as imagens de contêiner são criadas muito rapidamente. Por exemplo, no meu laptop, são necessários apenas 5 segundos para empacotar uma aplicação Spring Boot como um contêiner Docker. Os contêineres também são iniciados muito rapidamente, pois não há um processo demorado de inicialização do sistema operacional. Quando um contêiner é iniciado, o serviço é executado.
O uso de contêineres apresenta algumas desvantagens. Embora a infraestrutura de contêineres esteja amadurecendo rapidamente, ela ainda não é tão madura quanto a infraestrutura de máquinas virtuais. Além disso, os contêineres não são tão seguros quanto as máquinas virtuais, pois compartilham entre si o kernel do sistema operacional do host.
Outra desvantagem dos contêineres é que você fica responsável pelo trabalho pesado e indiferenciado de administrar as imagens de contêiner. Além disso, a menos que você use uma solução de contêiner hospedada, como o Google Container Engine ou o Amazon EC2 Container Service (ECS), será necessário administrar a infraestrutura de contêineres e, possivelmente, a infraestrutura de máquinas virtuais na qual ela é executada.
Além disso, os contêineres costumam ser implantados em uma infraestrutura com cobrança por VM. Consequentemente, como descrito anteriormente, você provavelmente terá o custo adicional de superdimensionar as VMs para lidar com picos de carga.
Curiosamente, a distinção entre contêineres e VMs provavelmente ficará menos nítida. Como mencionado anteriormente, as VMs do Boxfuse são rápidas de criar e iniciar. O projeto Clear Containers visa criar VMs leves. [Editor – Conforme anunciado em dezembro de 2017, o desenvolvimento do Clear Containers agora continua no projeto de código aberto Kata Containers.] Também há um interesse crescente em unikernels. Recentemente, a Docker, Inc. adquiriu a Unikernel Systems.
Há também o conceito mais recente e cada vez mais popular de implantação sem servidor, uma abordagem que evita a necessidade de escolher entre implantar serviços em contêineres ou em máquinas virtuais. Veremos isso a seguir.
Implantação sem servidor
AWS Lambda é um exemplo de tecnologia de implantação sem servidor. Ele oferece suporte a serviços em Java, Node.js e Python. Para implantar um microsserviço, você o empacota como um arquivo ZIP e o envia para o AWS Lambda. Você também fornece metadados que, entre outras coisas, especificam o nome da função invocada para processar uma solicitação (também conhecida como evento). O AWS Lambda executa automaticamente instâncias suficientes do seu microsserviço para processar as solicitações. Você paga por cada solicitação com base no tempo de execução e na memória consumida. É claro que os detalhes fazem toda a diferença, e em breve você verá que o AWS Lambda tem limitações. Ainda assim, é extremamente atraente a ideia de que nem você, como pessoa desenvolvedora, nem qualquer outra pessoa da sua organização precise se preocupar com nenhum aspecto relacionado a servidores, máquinas virtuais ou contêineres.
Uma função Lambda é um serviço sem estado. Normalmente, ela processa solicitações invocando serviços da AWS. Por exemplo, uma função Lambda invocada quando uma imagem é carregada em um bucket do S3 poderia inserir um item em uma tabela de imagens do DynamoDB e publicar uma mensagem em um fluxo do Kinesis para acionar o processamento da imagem. Uma função Lambda também pode invocar serviços web de terceiros.
Há quatro maneiras de invocar uma função Lambda:
- Diretamente, usando uma solicitação de serviço web
- Automaticamente, em resposta a um evento gerado por um serviço da AWS, como S3, DynamoDB, Kinesis ou Simple Email Service
- Automaticamente, por meio de um AWS API Gateway, para processar solicitações HTTP dos clientes da aplicação
- Periodicamente, de acordo com um agendamento semelhante ao
cron‑like schedule
Como você pode ver, o AWS Lambda é uma maneira prática de implantar microsserviços. A cobrança baseada em solicitações significa que você paga apenas pelo trabalho que seus serviços realmente realizam. Além disso, como você não é responsável pela infraestrutura de TI, pode se concentrar no desenvolvimento da sua aplicação.
No entanto, há algumas limitações significativas. O AWS Lambda não foi projetado para implantar serviços de longa duração, como um serviço que consome mensagens de um broker de mensagens de terceiros. As solicitações devem ser concluídas em até 300 segundos. Os serviços devem ser sem estado, pois, em teoria, o AWS Lambda pode executar uma instância separada para cada solicitação. Eles devem ser escritos em uma das linguagens compatíveis. Os serviços também devem ser iniciados rapidamente; caso contrário, poderão exceder o tempo limite e ser encerrados.
Resumo
Implantar uma aplicação de microsserviços é um desafio. Há dezenas ou até centenas de serviços escritos em diversas linguagens e frameworks. Cada um deles é uma miniaplicação com requisitos específicos de implantação, recursos, escalabilidade e monitoramento. Existem vários padrões de implantação de microsserviços, incluindo Instância de Serviço por Máquina Virtual e Instância de Serviço por Contêiner. Outra opção interessante para implantar microsserviços é o AWS Lambda, uma abordagem sem servidor. Na próxima e última parte desta série, veremos como migrar uma aplicação monolítica para uma arquitetura de microsserviços.
Editor – Esta série de artigos em sete partes está concluída:
- Introdução aos microsserviços
- Criando microsserviços: usando um gateway de API
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Como escolher uma estratégia de implantação de microsserviços (este artigo)
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação. Confira também nossa série sobre a Arquitetura de referência de microsserviços e a página de soluções para microsserviços.
O blogueiro convidado Chris Richardson é o fundador da plataforma original CloudFoundry.com, uma das primeiras PaaS (Plataforma como Serviço) Java para o Amazon EC2. Atualmente, ele presta consultoria a organizações para aprimorar a forma como desenvolvem e implantam aplicações. Ele também publica regularmente sobre microsserviços em https://microservices.io.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.