As inscrições para o Microservices March 2023 já estão abertas. Confira a programação e inscreva-se aqui.
Editor – Esta série de artigos em sete partes está concluída:
- Introdução aos microsserviços (este artigo)
- Criando microsserviços: usando um gateway de API
- Construindo microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Escolhendo uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação.
Confira também nossa página de soluções de microsserviços.
Atualmente, os microsserviços estão recebendo muita atenção em artigos, blogs, discussões nas redes sociais e apresentações em conferências. Eles estão avançando rapidamente em direção ao pico das expectativas infladas no Ciclo de Hype do Gartner. Ao mesmo tempo, há céticos na comunidade de software que consideram que os microsserviços não trazem nada de novo. Os críticos afirmam que a ideia é apenas uma reformulação da SOA. No entanto, apesar de todo o entusiasmo e ceticismo, o padrão de arquitetura de microsserviços oferece benefícios significativos, especialmente por viabilizar o desenvolvimento ágil e a entrega de aplicações empresariais complexas.
Esta publicação é a primeira de uma série de sete partes sobre como projetar, criar e implantar microsserviços. Você conhecerá essa abordagem e verá como ela se compara ao modelo mais tradicional de Arquitetura Monolítica. Esta série descreverá os diversos elementos de uma arquitetura de microsserviços. Você conhecerá as vantagens e desvantagens do padrão de Arquitetura de Microsserviços, saberá se ele é adequado para o seu projeto e como aplicá-lo.
Primeiro, vamos analisar por que você deve considerar o uso de microsserviços.
Desenvolvendo aplicações monolíticas
Imagine que você estivesse começando a desenvolver um aplicativo de chamada de táxis totalmente novo, destinado a concorrer com a Uber e a Hailo. Após algumas reuniões preliminares e o levantamento de requisitos, você criaria um novo projeto manualmente ou usando um gerador fornecido pelo Rails, Spring Boot, Play ou Maven. Esse novo aplicativo teria uma arquitetura hexagonal modular, como no diagrama a seguir:
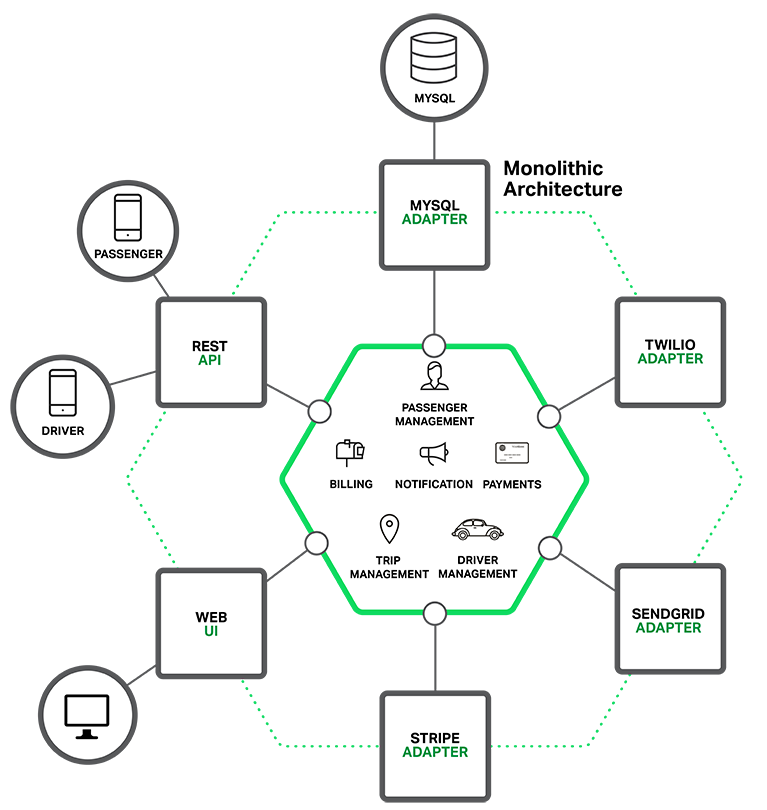
No núcleo da aplicação está a lógica de negócios, implementada por módulos que definem serviços, objetos de domínio e eventos. Ao redor do núcleo, há adaptadores que fazem a interface com o mundo externo. Alguns exemplos de adaptadores são componentes de acesso a bancos de dados, componentes de mensageria que produzem e consomem mensagens e componentes web que expõem APIs ou implementam uma interface de usuário.
Apesar de ter uma arquitetura logicamente modular, a aplicação é empacotada e implantada como um monólito. O formato específico depende da linguagem e do framework da aplicação. Por exemplo, muitas aplicações Java são empacotadas como arquivos WAR e implantadas em servidores de aplicações, como Tomcat ou Jetty. Outras aplicações Java são empacotadas como arquivos JAR executáveis e autossuficientes. Da mesma forma, aplicações Rails e Node.js são empacotadas como uma hierarquia de diretórios.
Aplicações desenvolvidas nesse estilo são extremamente comuns. Elas são simples de desenvolver, pois nossas IDEs e outras ferramentas são voltadas para a criação de uma única aplicação. Esses tipos de aplicação também são simples de testar. Você pode implementar testes de ponta a ponta simplesmente iniciando a aplicação e testando a interface do usuário com o Selenium. Aplicações monolíticas também são simples de implantar. Basta copiar a aplicação empacotada para um servidor. Também é possível escalar a aplicação executando várias cópias por trás de um balanceador de carga. Nos estágios iniciais do projeto, essa abordagem funciona bem.
Rumo ao Inferno Monolítico
Infelizmente, essa abordagem simples tem uma enorme limitação. Aplicações bem-sucedidas tendem a crescer com o tempo e, por fim, tornam-se gigantescas. Durante cada sprint, sua equipe de desenvolvimento implementa mais algumas histórias, o que, naturalmente, significa adicionar muitas linhas de código. Depois de alguns anos, sua aplicação pequena e simples terá se transformado em um monólito monstruoso. Para dar um exemplo extremo, conversei recentemente com um desenvolvedor que estava criando uma ferramenta para analisar as dependências entre os milhares de JARs de uma aplicação com vários milhões de linhas de código (LOC). Tenho certeza de que foi necessário o esforço conjunto de um grande número de desenvolvedores ao longo de muitos anos para criar uma fera dessas.
Quando sua aplicação se transforma em um monólito grande e complexo, sua organização de desenvolvimento provavelmente passa a enfrentar enormes dificuldades. Qualquer tentativa de adotar desenvolvimento e entrega ágeis estará fadada ao fracasso. Um dos principais problemas é a complexidade esmagadora da aplicação. Ela é simplesmente grande demais para que um único desenvolvedor consiga compreendê-la por completo. Consequentemente, corrigir bugs e implementar novos recursos de forma adequada torna-se difícil e demorado. Além disso, isso tende a gerar uma espiral descendente. Se a base de código for difícil de entender, as alterações não serão feitas corretamente. No fim, você terá uma monstruosa e incompreensível grande bola de lama.
O tamanho da aplicação, por si só, também tornará o desenvolvimento mais lento. Quanto maior a aplicação, maior será o tempo de inicialização. Por exemplo, em uma pesquisa recente, alguns desenvolvedores relataram tempos de inicialização de até 12 minutos. Também ouvi relatos de aplicações que levam até 40 minutos para iniciar. Se os desenvolvedores precisarem reiniciar o servidor da aplicação com frequência, passarão grande parte do dia esperando, e sua produtividade será prejudicada.
Outro problema de uma aplicação monolítica grande e complexa é que ela representa um obstáculo à implantação contínua. Hoje, o estado da arte para aplicações SaaS é colocar alterações em produção várias vezes ao dia. Isso é extremamente difícil de fazer com um monólito complexo, pois é necessário reimplantar toda a aplicação para atualizar qualquer parte dela. Os longos tempos de inicialização que mencionei anteriormente também não ajudam. Além disso, como o impacto de uma alteração geralmente não é muito bem compreendido, é provável que seja necessário realizar testes manuais extensivos. Consequentemente, a implantação contínua torna-se praticamente impossível.
Aplicações monolíticas também podem ser difíceis de escalar quando diferentes módulos têm requisitos de recursos conflitantes. Por exemplo, um módulo pode implementar uma lógica de processamento de imagens que exige uso intensivo da CPU e, idealmente, seria implantado em instâncias EC2 otimizadas para computação. Outro módulo pode ser um banco de dados em memória, mais adequado para instâncias EC2 otimizadas para memória. No entanto, como esses módulos são implantados juntos, é preciso fazer concessões na escolha do hardware.
Outro problema das aplicações monolíticas é a confiabilidade. Como todos os módulos são executados no mesmo processo, um bug em qualquer módulo, como um vazamento de memória, pode derrubar todo o processo. Além disso, como todas as instâncias da aplicação são idênticas, esse bug afetará a disponibilidade de toda a aplicação.
Por último, mas não menos importante, as aplicações monolíticas tornam extremamente difícil adotar novos frameworks e linguagens. Por exemplo, imagine que você tenha 2 milhões de linhas de código escritas usando o framework XYZ. Seria extremamente caro (tanto em termos de tempo quanto de custo) reescrever toda a aplicação para usar o framework ABC, mais recente, mesmo que ele fosse consideravelmente melhor. Como resultado, há uma enorme barreira à adoção de novas tecnologias. Você fica preso às escolhas tecnológicas feitas no início do projeto.
Em resumo: você tem uma aplicação bem-sucedida e essencial para os negócios que se transformou em um monólito gigantesco, compreendido por pouquíssimos desenvolvedores, se é que algum o compreende. Ela foi escrita com uma tecnologia obsoleta e improdutiva, o que dificulta a contratação de desenvolvedores talentosos. A aplicação é difícil de escalar e não é confiável. Como resultado, o desenvolvimento ágil e a entrega de aplicações são impossíveis.
Então, o que você pode fazer a respeito?
Microsserviços – Enfrentando a complexidade
Muitas organizações, como Amazon, eBay e Netflix, resolveram esse problema adotando o que hoje é conhecido como padrão de arquitetura de microsserviços. Em vez de criar uma única aplicação monolítica gigantesca, a ideia é dividi-la em um conjunto de serviços menores e interconectados.
Um serviço normalmente implementa um conjunto de recursos ou funcionalidades distintas, como gerenciamento de pedidos, gerenciamento de clientes etc. Cada microsserviço é uma miniaplicação com sua própria arquitetura hexagonal, composta pela lógica de negócios e por diversos adaptadores. Alguns microsserviços expõem uma API que é consumida por outros microsserviços ou pelos clientes da aplicação. Outros microsserviços podem implementar uma interface web. Em tempo de execução, cada instância geralmente é uma máquina virtual na nuvem ou um contêiner Docker.
Por exemplo, uma possível decomposição do sistema descrito anteriormente é apresentada no diagrama a seguir:
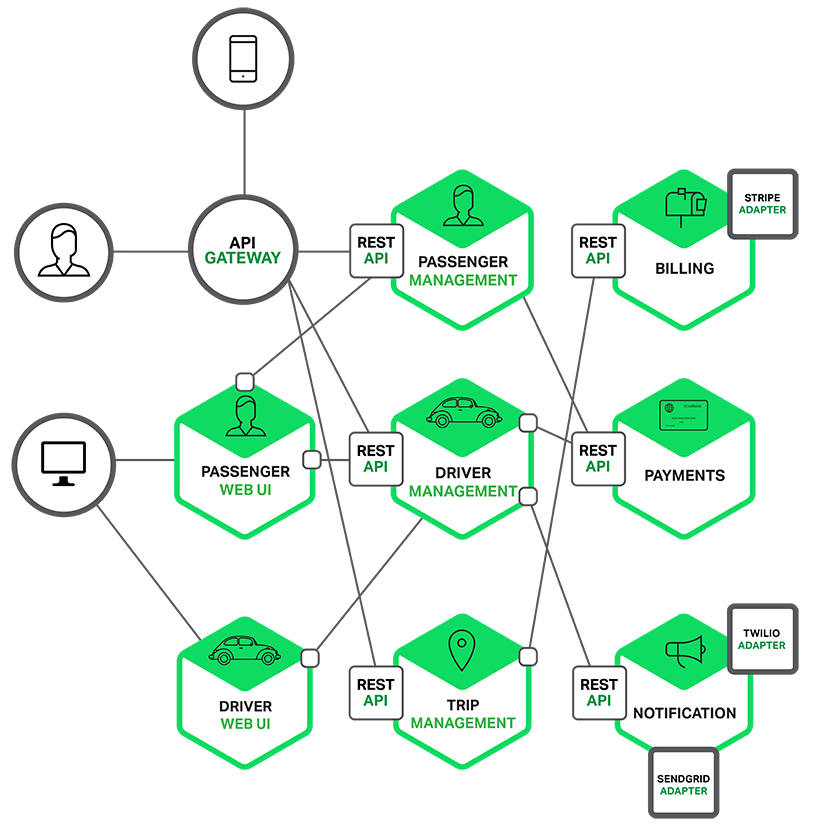
Cada área funcional da aplicação agora é implementada por seu próprio microsserviço. Além disso, a aplicação web é dividida em um conjunto de aplicações web mais simples (como uma para passageiros e outra para motoristas, em nosso exemplo de aplicativo de transporte por táxi). Isso facilita a implantação de experiências distintas para usuários, dispositivos ou casos de uso especializados específicos.
Cada serviço de backend expõe uma API REST, e a maioria dos serviços consome APIs fornecidas por outros serviços. Por exemplo, o Gerenciamento de Motoristas usa o servidor de Notificações para avisar um motorista disponível sobre uma possível corrida. Os serviços de interface do usuário invocam os demais serviços para renderizar páginas web. Os serviços também podem usar comunicação assíncrona baseada em mensagens. A comunicação entre serviços será abordada em mais detalhes posteriormente nesta série.
Algumas APIs REST também são disponibilizadas aos aplicativos móveis usados por motoristas e passageiros. No entanto, os aplicativos não têm acesso direto aos serviços de backend. Em vez disso, a comunicação é intermediada por um componente conhecido como Gateway de API. O Gateway de API é responsável por tarefas como balanceamento de carga, armazenamento em cache, controle de acesso, medição do uso da API e monitoramento, e pode ser implementado de forma eficiente usando o NGINX. Artigos posteriores desta série abordarão o gateway de API.
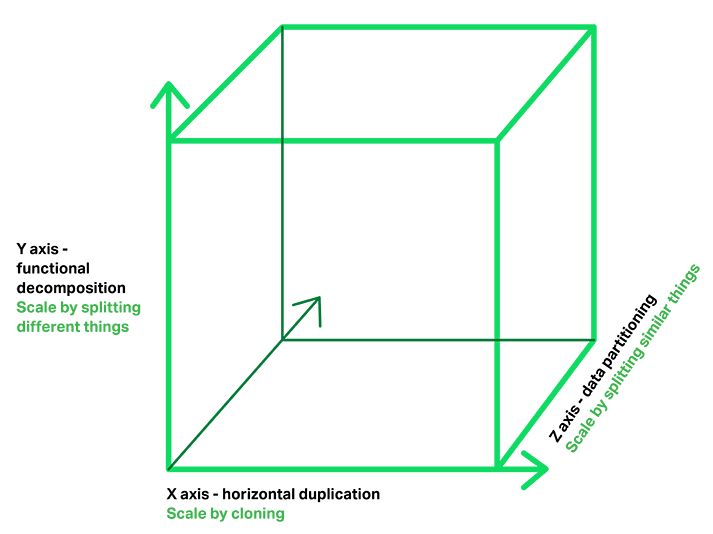
O padrão de Arquitetura de Microsserviços corresponde ao dimensionamento no eixo Y do Cubo de Escalabilidade, um modelo 3D de escalabilidade apresentado no excelente livro A Arte da Escalabilidade. Os outros dois eixos de dimensionamento são o eixo X, que consiste em executar várias cópias idênticas da aplicação por trás de um balanceador de carga, e o eixo Z (ou particionamento de dados), no qual um atributo da solicitação (por exemplo, a chave primária de uma linha ou a identidade de um cliente) é usado para encaminhar a solicitação a um servidor específico.
Normalmente, as aplicações usam os três tipos de escalabilidade em conjunto. A escalabilidade no eixo Y decompõe a aplicação em microsserviços, conforme mostrado acima na primeira figura desta seção. Em tempo de execução, a escalabilidade no eixo X executa várias instâncias de cada serviço por trás de um balanceador de carga para garantir a capacidade de processamento e a disponibilidade. Algumas aplicações também podem usar a escalabilidade no eixo Z para particionar os serviços. O diagrama a seguir mostra como o serviço de gerenciamento de viagens pode ser implantado com o Docker em execução no Amazon EC2.
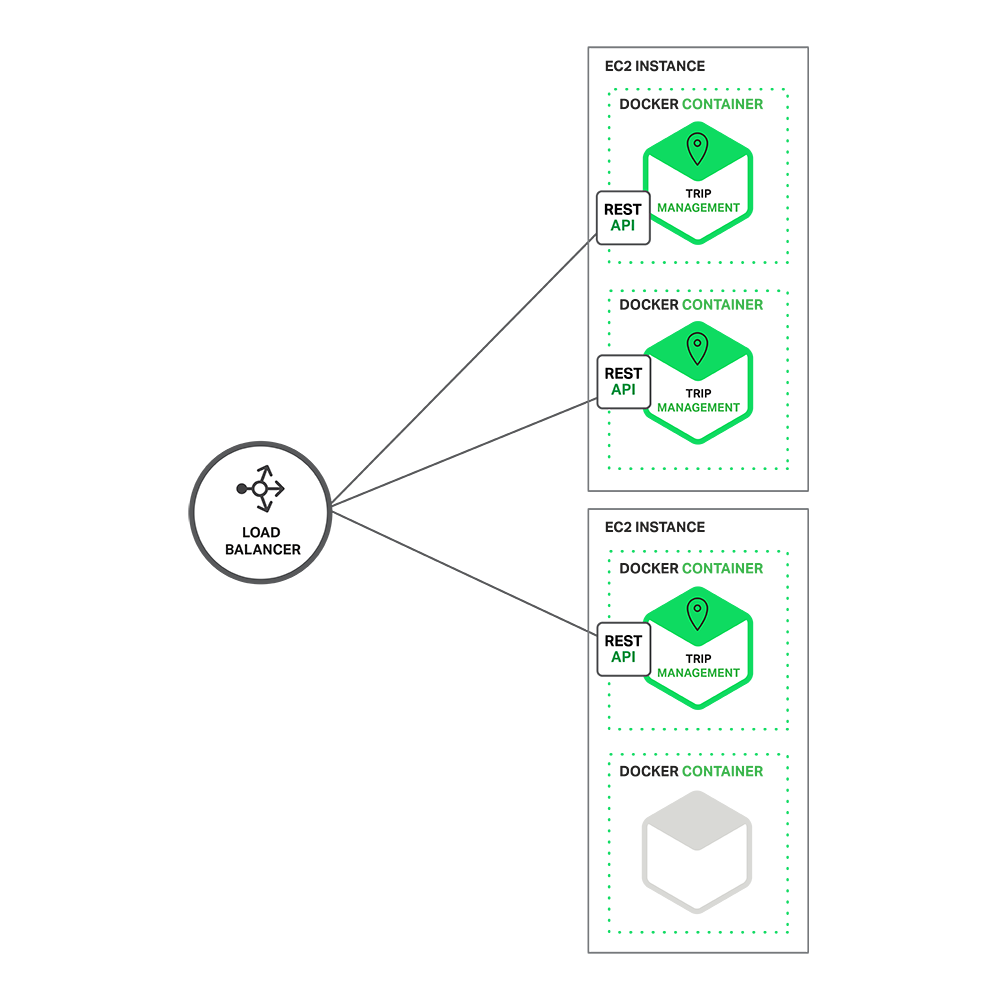
Em tempo de execução, o serviço de Gerenciamento de Viagens consiste em várias instâncias de serviço. Cada instância de serviço é um contêiner Docker. Para garantir alta disponibilidade, os contêineres são executados em várias VMs na nuvem. À frente das instâncias de serviço, há um balanceador de carga, como o NGINX que distribui as solicitações entre as instâncias. O balanceador de carga também pode cuidar de outros aspectos, como armazenamento em cache, controle de acesso, medição de uso da API, e monitoramento.
O padrão de Arquitetura de Microsserviços afeta significativamente a relação entre a aplicação e o banco de dados. Em vez de compartilhar um único esquema de banco de dados com outros serviços, cada serviço tem seu próprio esquema. Por um lado, essa abordagem contraria a ideia de um modelo de dados para toda a empresa. Além disso, ela frequentemente resulta na duplicação de alguns dados. No entanto, ter um esquema de banco de dados por serviço é essencial para aproveitar os benefícios dos microsserviços, pois isso garante um baixo acoplamento. O diagrama a seguir mostra a arquitetura de banco de dados da aplicação de exemplo.
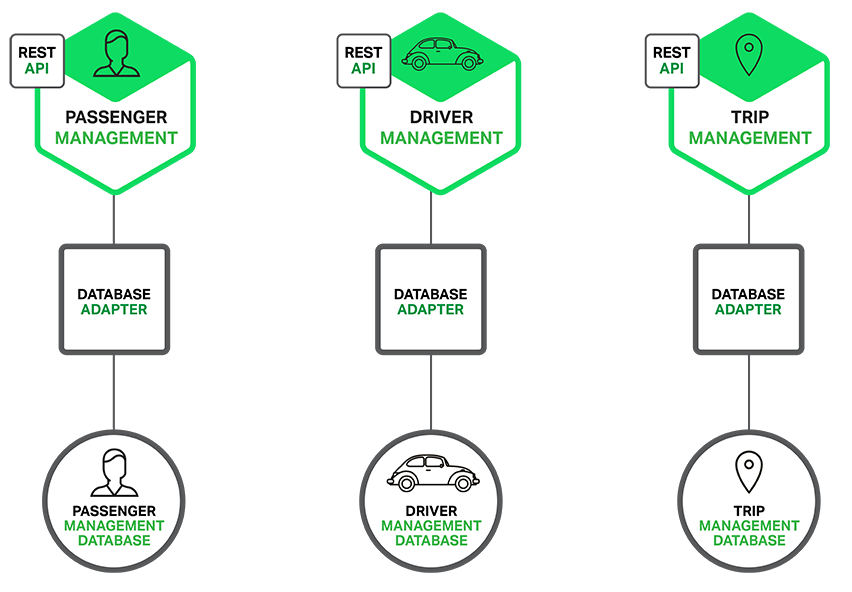
Cada um dos serviços tem seu próprio banco de dados. Além disso, um serviço pode usar o tipo de banco de dados mais adequado às suas necessidades, na chamada arquitetura de persistência poliglota. Por exemplo, o Gerenciamento de Motoristas, que localiza motoristas próximos a um possível passageiro, deve usar um banco de dados que ofereça suporte a consultas geográficas eficientes.
À primeira vista, o padrão de Arquitetura de Microsserviços é semelhante à SOA. Em ambas as abordagens, a arquitetura consiste em um conjunto de serviços. No entanto, uma forma de entender o padrão de Arquitetura de Microsserviços é considerá-lo uma SOA sem a comercialização e a carga negativa associada às especificações de serviços web (WS‑*) e a um Barramento de Serviços Corporativos (ESB). As aplicações baseadas em microsserviços priorizam protocolos mais simples e leves, como REST, em vez de WS‑*. Elas também evitam ao máximo o uso de ESBs e, em vez disso, implementam funcionalidades semelhantes às de um ESB nos próprios microsserviços. O padrão de Arquitetura de Microsserviços também rejeita outros aspectos da SOA, como o conceito de esquema canônico.
Os benefícios dos microsserviços
O padrão de Arquitetura de Microsserviços oferece vários benefícios importantes. Primeiro, ele aborda o problema da complexidade. Ele decompõe o que, de outra forma, seria uma aplicação monolítica gigantesca em um conjunto de serviços. Embora a quantidade total de funcionalidades permaneça inalterada, a aplicação é dividida em partes ou serviços gerenciáveis. Cada serviço tem um limite bem definido na forma de uma API orientada a RPC ou a mensagens. O padrão de Arquitetura de Microsserviços impõe um nível de modularidade que, na prática, é extremamente difícil de alcançar com uma base de código monolítica. Consequentemente, os serviços individuais são muito mais rápidos de desenvolver e muito mais fáceis de entender e manter.
Em segundo lugar, essa arquitetura permite que cada serviço seja desenvolvido de forma independente por uma equipe dedicada a ele. Os desenvolvedores têm liberdade para escolher as tecnologias que fizerem mais sentido, desde que o serviço respeite o contrato da API. É claro que a maioria das organizações deseja evitar uma anarquia completa e limitar as opções tecnológicas. No entanto, essa liberdade significa que os desenvolvedores não são mais obrigados a usar tecnologias possivelmente obsoletas que existiam no início de um novo projeto. Ao desenvolver um novo serviço, eles podem optar por usar tecnologias atuais. Além disso, como os serviços são relativamente pequenos, torna-se viável reescrever um serviço antigo usando tecnologias atuais.
Terceiro, o padrão de Arquitetura de Microsserviços permite que cada microsserviço seja implantado de forma independente. Os desenvolvedores nunca precisam coordenar a implantação de alterações restritas ao seu serviço. Esses tipos de alteração podem ser implantados assim que forem testados. A equipe de UI pode, por exemplo, realizar testes A/B e iterar rapidamente nas alterações da interface. O padrão de Arquitetura de Microsserviços viabiliza a implantação contínua.
Por fim, o padrão de Arquitetura de Microsserviços permite que cada serviço seja escalado de forma independente. Você pode implantar apenas a quantidade de instâncias de cada serviço necessária para atender às suas restrições de capacidade e disponibilidade. Além disso, pode usar o hardware que melhor corresponda aos requisitos de recursos de cada serviço. Por exemplo, você pode implantar um serviço de processamento de imagens com uso intensivo de CPU em instâncias EC2 Compute Optimized e um serviço de banco de dados em memória em instâncias EC2 Memory Optimized.
As desvantagens dos microsserviços
Como Fred Brooks escreveu há quase 30 anos, não existem soluções mágicas. Como qualquer outra tecnologia, a arquitetura de microsserviços tem desvantagens. Uma delas é o próprio nome. O termo microsserviço dá ênfase excessiva ao tamanho do serviço. Na verdade, alguns desenvolvedores defendem a criação de serviços extremamente granulares, com 10 a 100 linhas de código. Embora serviços pequenos sejam preferíveis, é importante lembrar que eles são um meio para atingir um fim, e não o objetivo principal. O objetivo dos microsserviços é decompor suficientemente a aplicação para facilitar o desenvolvimento e a implantação ágeis.
Outra grande desvantagem dos microsserviços é a complexidade decorrente do fato de que uma aplicação de microsserviços é um sistema distribuído. Os desenvolvedores precisam escolher e implementar um mecanismo de comunicação entre processos baseado em mensagens ou RPC. Além disso, também precisam escrever código para lidar com falhas parciais, pois o destino de uma solicitação pode estar lento ou indisponível. Embora nada disso seja extremamente difícil, é muito mais complexo do que em uma aplicação monolítica, na qual os módulos invocam uns aos outros por meio de chamadas de métodos/procedimentos no nível da linguagem.
Outro desafio dos microsserviços é a arquitetura de banco de dados particionada. Transações de negócios que atualizam várias entidades de negócios são bastante comuns. Esses tipos de transação são triviais de implementar em uma aplicação monolítica, pois há um único banco de dados. No entanto, em uma aplicação baseada em microsserviços, é necessário atualizar vários bancos de dados pertencentes a diferentes serviços. O uso de transações distribuídas geralmente não é uma opção, e não apenas por causa do teorema CAP. Muitos dos bancos de dados NoSQL e agentes de mensagens altamente escaláveis atuais simplesmente não oferecem suporte a elas. Assim, é necessário adotar uma abordagem baseada em consistência eventual, o que representa um desafio maior para os desenvolvedores.
Testar uma aplicação de microsserviços também é muito mais complexo. Por exemplo, com um framework moderno como o Spring Boot, é muito simples escrever uma classe de teste que inicialize uma aplicação web monolítica e teste sua API REST. Em contrapartida, uma classe de teste semelhante para um serviço precisaria iniciar esse serviço e todos os serviços dos quais ele depende (ou, pelo menos, configurar stubs para esses serviços). Mais uma vez, isso não é nenhum bicho de sete cabeças, mas é importante não subestimar a complexidade dessa tarefa.
Outro grande desafio do padrão de Arquitetura de Microsserviços é implementar mudanças que abrangem vários serviços. Por exemplo, imagine que você esteja implementando uma história que exija alterações nos serviços A, B e C, em que A depende de B e B depende de C. Em uma aplicação monolítica, bastaria alterar os módulos correspondentes, integrar as mudanças e implantá-las de uma só vez. Por outro lado, no padrão de Arquitetura de Microsserviços, é necessário planejar e coordenar cuidadosamente a implantação das mudanças em cada um dos serviços. Por exemplo, seria preciso atualizar o serviço C, depois o serviço B e, por fim, o serviço A. Felizmente, a maioria das mudanças costuma afetar apenas um serviço, e mudanças em vários serviços que exigem coordenação são relativamente raras.
A implantação de uma aplicação baseada em microsserviços também é muito mais complexa. Uma aplicação monolítica é simplesmente implantada em um conjunto de servidores idênticos por trás de um balanceador de carga tradicional. Cada instância da aplicação é configurada com os endereços (host e portas) dos serviços de infraestrutura, como o banco de dados e um broker de mensagens. Em contrapartida, uma aplicação de microsserviços normalmente consiste em um grande número de serviços. Por exemplo, a Hailo tem 160 serviços diferentes, e a Netflix tem mais de 600, segundo Adrian Cockcroft [Nota do editor – A Hailo foi adquirida pela MyTaxi.]. Cada serviço terá várias instâncias em execução. Isso representa muito mais componentes que precisam ser configurados, implantados, escalados e monitorados. Além disso, também será necessário implementar um mecanismo de descoberta de serviços (abordado em uma publicação posterior), que permita a um serviço descobrir os endereços (hosts e portas) de quaisquer outros serviços com os quais precise se comunicar. As abordagens operacionais tradicionais, manuais e baseadas em chamados de suporte, não conseguem acompanhar esse nível de complexidade. Portanto, a implantação bem-sucedida de uma aplicação de microsserviços exige que os desenvolvedores tenham maior controle sobre os métodos de implantação, além de um alto nível de automação.
Uma abordagem para a automação é usar uma PaaS pronta para uso, como o Cloud Foundry. Uma PaaS oferece aos desenvolvedores uma maneira fácil de implantar e gerenciar seus microsserviços. Ela os poupa de preocupações como a aquisição e a configuração de recursos de TI. Ao mesmo tempo, os profissionais de sistemas e redes que configuram a PaaS podem garantir a conformidade com as práticas recomendadas e as políticas da empresa. Outra maneira de automatizar a implantação de microsserviços é desenvolver o que seria, essencialmente, sua própria PaaS. Um ponto de partida comum é usar uma solução de clusterização, como o Kubernetes, em conjunto com uma tecnologia como o Docker. Mais adiante nesta série, veremos como abordagens de entrega de aplicações baseada em software, como o NGINX Plus, que gerencia facilmente cache, controle de acesso, medição de uso de APIs e monitoramento no nível dos microsserviços, podem ajudar a resolver esse problema.
Resumo
Desenvolver aplicações complexas é inerentemente difícil. Uma arquitetura monolítica só faz sentido para aplicações simples e leves. Você enfrentará uma série de problemas se usá-la em aplicações complexas. O padrão de arquitetura de microsserviços é a melhor opção para aplicações complexas e em constante evolução, apesar das desvantagens e dos desafios de implementação.
Em posts futuros do blog, vou me aprofundar nos detalhes de vários aspectos do padrão de Arquitetura de Microsserviços e abordar temas como descoberta de serviços, opções de implantação de serviços e estratégias para refatorar uma aplicação monolítica e transformá-la em serviços.
Fique ligado…
Editor – Esta série de artigos em sete partes está agora completa:
- Introdução aos microsserviços (este artigo)
- Criando microsserviços: usando um gateway de API
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços
- Como escolher uma estratégia de implantação de microsserviços
- Refatoração de um monólito em microsserviços
Você também pode baixar o conjunto completo de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação.
O blogueiro convidado Chris Richardson é o fundador da versão original do CloudFoundry.com, uma das primeiras PaaS (plataformas como serviço) Java para o Amazon EC2. Atualmente, ele presta consultoria a organizações para aprimorar a forma como desenvolvem e implantam aplicações.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.