Editor – Esta série de artigos em sete partes está agora completa:
- Introdução aos microsserviços
- Construindo microsserviços: usando um gateway de API
- Construindo microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços (este artigo)
- Escolhendo uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, em formato de e-book – Microsserviços: do design à implantação. Confira também nossa série sobre a arquitetura de referência de microsserviços e a página de soluções de microsserviços.
Este é o quinto artigo de uma série sobre o desenvolvimento de aplicações com microsserviços. O primeiro artigo apresenta o padrão de arquitetura de microsserviços e discute as vantagens e desvantagens do uso de microsserviços. O segundo<.htmla> e o terceiro artigos da série descrevem diferentes aspectos da comunicação em uma arquitetura de microsserviços. O quarto artigo explora o problema da descoberta de serviços, que está intimamente relacionado ao tema. Neste artigo, mudamos o foco e analisamos os problemas de gerenciamento de dados distribuídos que surgem em uma arquitetura de microsserviços.
Microsserviços e o problema do gerenciamento de dados distribuídos
Uma aplicação monolítica normalmente tem um único banco de dados relacional. Uma das principais vantagens de usar um banco de dados relacional é que sua aplicação pode usar transações ACID, que oferecem algumas garantias importantes:
- Atomicidade – As alterações são realizadas de forma atômica
- Consistência – O estado do banco de dados é sempre consistente
- Isolamento – Embora as transações sejam executadas simultaneamente, elas parecem ser executadas sequencialmente
- Durabilidade – Uma vez que uma transação é confirmada, ela não é desfeita
Assim, sua aplicação pode simplesmente iniciar uma transação, alterar (inserir, atualizar e excluir) várias linhas e confirmar a transação.
Outra grande vantagem de usar um banco de dados relacional é que ele oferece SQL, uma linguagem de consulta rica, declarativa e padronizada. Você pode escrever facilmente uma consulta que combine dados de várias tabelas. O planejador de consultas do SGBDR determina, então, a maneira mais eficiente de executar a consulta. Você não precisa se preocupar com detalhes de baixo nível, como a forma de acessar o banco de dados. Além disso, como todos os dados da sua aplicação estão em um único banco de dados, é fácil consultá-los.
Infelizmente, o acesso aos dados se torna muito mais complexo quando migramos para uma arquitetura de microsserviços. Isso ocorre porque os dados pertencentes a cada microsserviço são privados desse microsserviço e só podem ser acessados por meio de sua API. O encapsulamento dos dados garante que os microsserviços tenham baixo acoplamento e possam evoluir de forma independente uns dos outros. Se vários serviços acessarem os mesmos dados, as atualizações de esquema exigirão atualizações coordenadas e demoradas em todos os serviços.
Para piorar a situação, diferentes microsserviços costumam usar diferentes tipos de bancos de dados. As aplicações modernas armazenam e processam diversos tipos de dados, e um banco de dados relacional nem sempre é a melhor escolha. Para alguns casos de uso, um determinado banco de dados NoSQL pode ter um modelo de dados mais adequado e oferecer desempenho e escalabilidade muito melhores. Por exemplo, faz sentido que um serviço que armazena e consulta textos use um mecanismo de busca textual como o Elasticsearch. Da mesma forma, um serviço que armazena dados de grafos sociais provavelmente deve usar um banco de dados de grafos, como o Neo4j. Por isso, as aplicações baseadas em microsserviços costumam usar uma combinação de bancos de dados SQL e NoSQL, uma abordagem conhecida como persistência poliglota.
Uma arquitetura particionada com persistência poliglota para armazenamento de dados oferece muitos benefícios, incluindo serviços com baixo acoplamento e melhor desempenho e escalabilidade. No entanto, ela também apresenta alguns desafios de gerenciamento de dados distribuídos.
O primeiro desafio é como implementar transações de negócio que mantenham a consistência entre vários serviços. Para entender por que isso é um problema, vejamos o exemplo de uma loja virtual B2B. O Serviço de Clientes mantém informações sobre os clientes, incluindo suas linhas de crédito. O Serviço de Pedidos gerencia os pedidos e deve verificar se um novo pedido não excede o limite de crédito do cliente. Na versão monolítica dessa aplicação, o Serviço de Pedidos pode simplesmente usar uma transação ACID para verificar o crédito disponível e criar o pedido.
Em contrapartida, em uma arquitetura de microsserviços, as tabelas ORDER e CUSTOMER são privadas de seus respectivos serviços, conforme mostrado no diagrama a seguir.
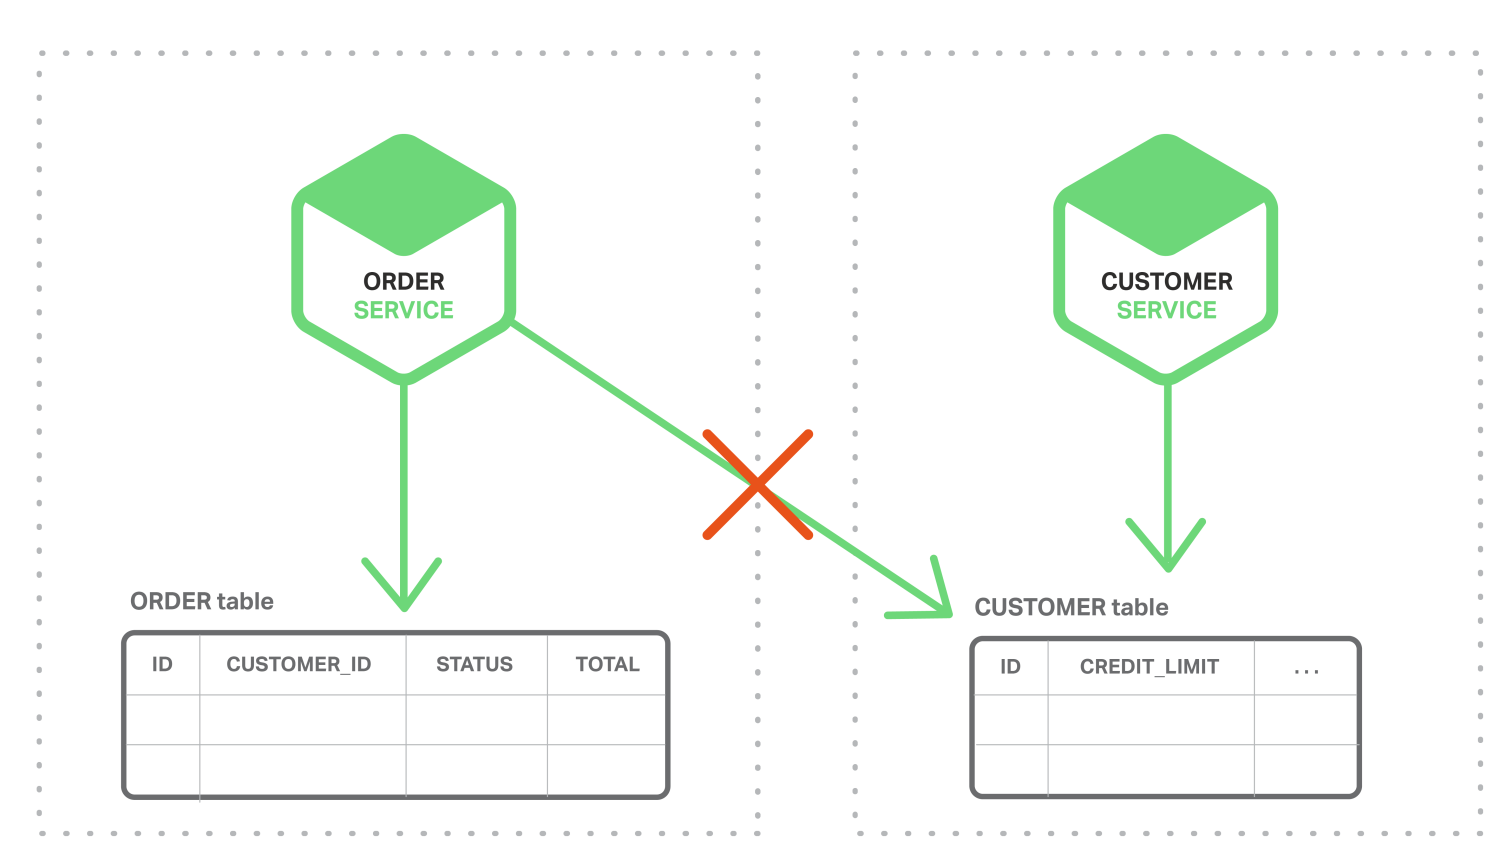
O Serviço de Pedidos não pode acessar a tabela CUSTOMER diretamente. Ele só pode usar a API fornecida pelo Serviço de Clientes. O Serviço de Pedidos poderia usar transações distribuídas, também conhecidas como commit em duas fases (2PC). No entanto, o 2PC geralmente não é uma opção viável em aplicações modernas. O teorema CAP exige que você escolha entre disponibilidade e consistência no modelo ACID, e a disponibilidade geralmente é a melhor escolha. Além disso, muitas tecnologias modernas, como a maioria dos bancos de dados NoSQL, não oferecem suporte ao 2PC. Manter a consistência dos dados entre serviços e bancos de dados é essencial, então precisamos de outra solução.
O segundo desafio é como implementar consultas que recuperem dados de vários serviços. Por exemplo, vamos imaginar que a aplicação precise exibir um cliente e seus pedidos recentes. Se o Serviço de Pedidos fornecer uma API para recuperar os pedidos de um cliente, você poderá recuperar esses dados usando uma junção no lado da aplicação. A aplicação recupera o cliente do Serviço de Clientes e os pedidos desse cliente do Serviço de Pedidos. Suponha, porém, que o Serviço de Pedidos só permita buscar pedidos pela chave primária (talvez ele use um banco de dados NoSQL que só permita buscas por chave primária). Nessa situação, não há uma maneira óbvia de recuperar os dados necessários.
Arquitetura orientada a eventos
Para muitas aplicações, a solução é usar uma arquitetura orientada a eventos. Nessa arquitetura, um microsserviço publica um evento quando algo relevante acontece, como ao atualizar uma entidade de negócio. Outros microsserviços se inscrevem nesses eventos. Quando um microsserviço recebe um evento, ele pode atualizar suas próprias entidades de negócio, o que pode levar à publicação de mais eventos.
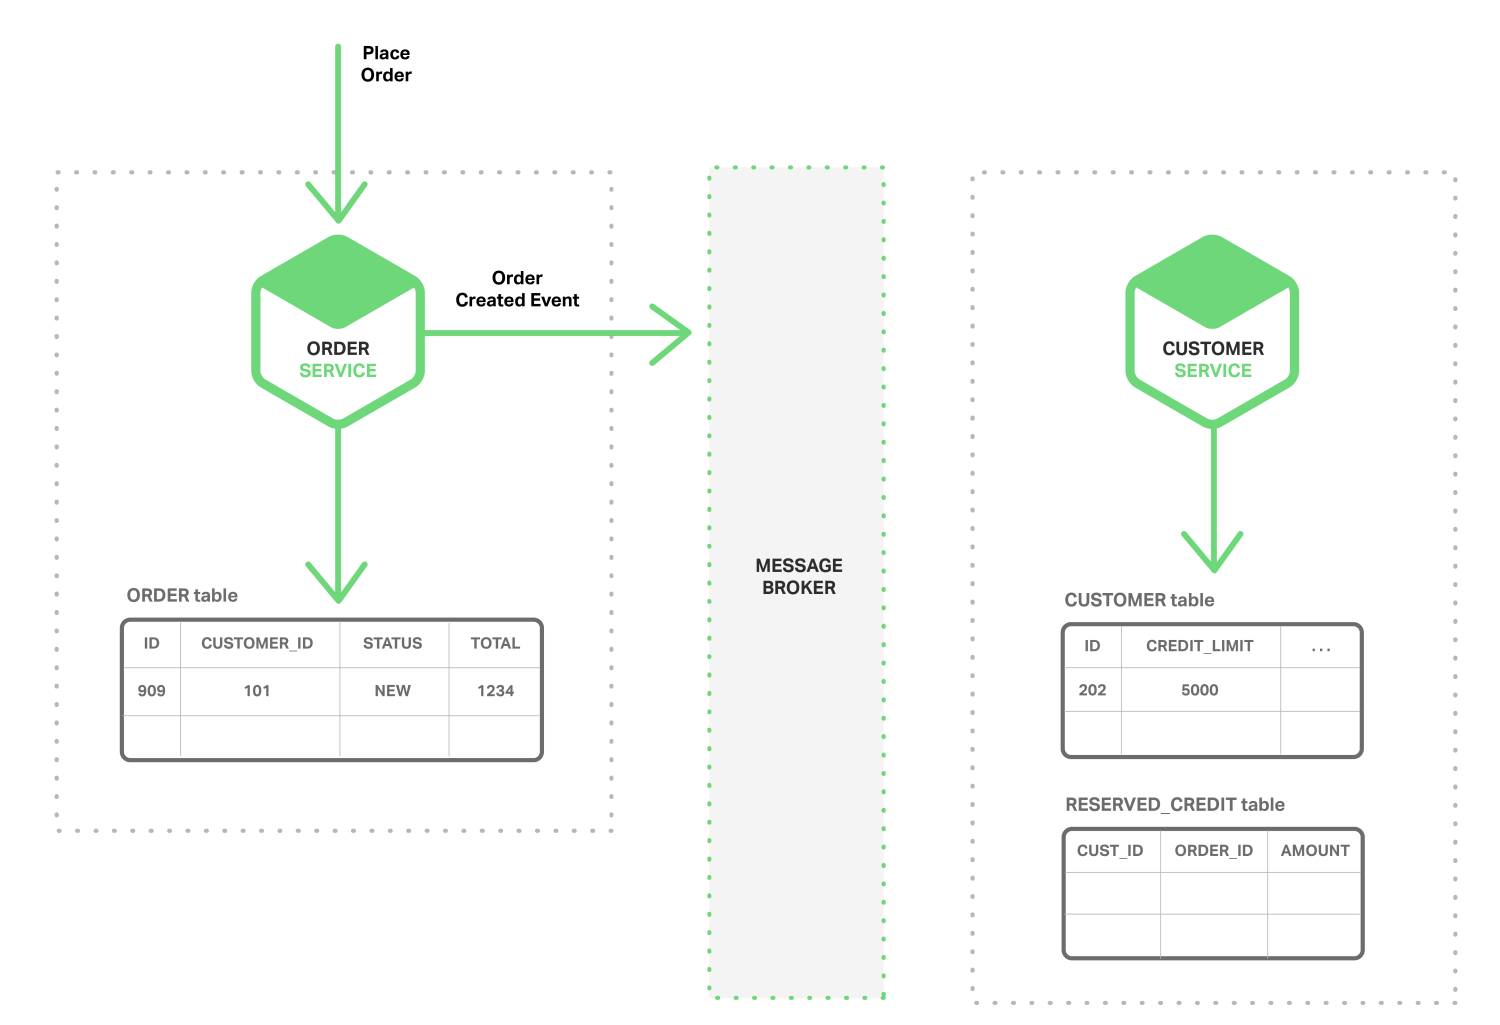
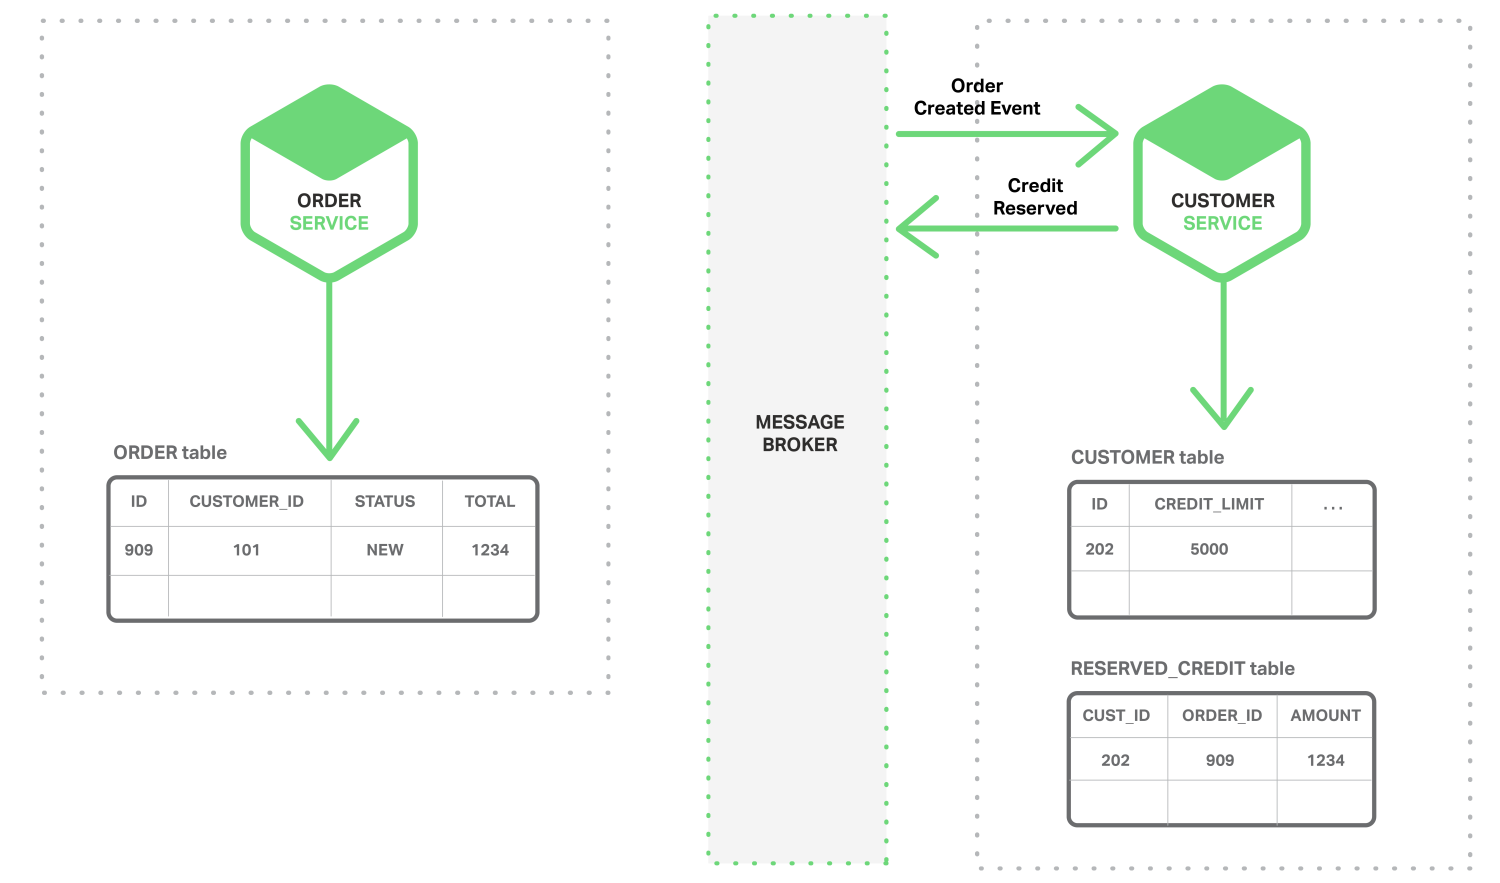
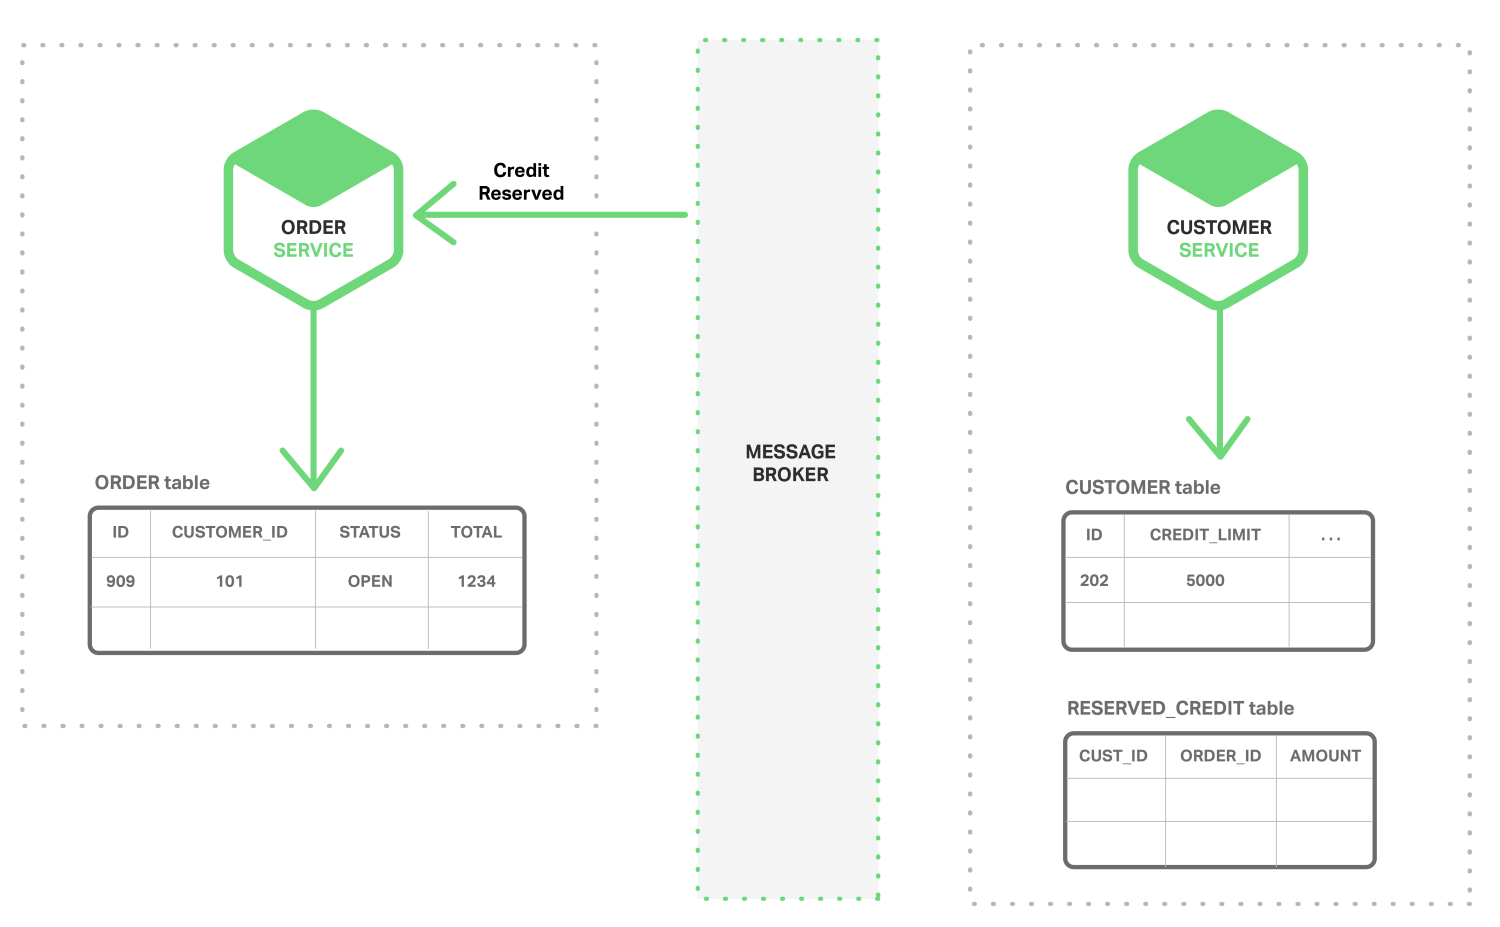
Você pode usar eventos para implementar transações de negócios que abrangem vários serviços. Uma transação consiste em uma série de etapas. Em cada etapa, um microsserviço atualiza uma entidade de negócio e publica um evento que aciona a próxima etapa. A sequência de diagramas a seguir mostra como você pode usar uma abordagem orientada a eventos para verificar o crédito disponível ao criar um pedido. Os microsserviços trocam eventos por meio de um broker de mensagens.
- O Serviço de Pedidos cria um pedido com o status NOVO e publica um evento de Pedido Criado.
- O Serviço de Clientes consome o evento Pedido Criado, reserva crédito para o pedido e publica um evento Crédito Reservado.
- O Serviço de Pedidos consome o evento Crédito Reservado e altera o status do pedido para ABERTO.
Um cenário mais complexo poderia envolver etapas adicionais, como reservar o estoque ao mesmo tempo em que o crédito do cliente é verificado.
Desde que (a) cada serviço atualize o banco de dados e publique um evento de forma atômica — falaremos mais sobre isso adiante — e (b) o broker de mensagens garanta que os eventos sejam entregues pelo menos uma vez, é possível implementar transações de negócios que envolvam vários serviços. É importante observar que essas não são transações ACID. Elas oferecem garantias muito mais fracas, como a consistência eventual. Esse modelo de transação é conhecido como modelo BASE.
Você também pode usar eventos para manter visões materializadas que combinam previamente dados pertencentes a vários microsserviços. O serviço que mantém a visão se inscreve nos eventos relevantes e atualiza a visão. Por exemplo, o Serviço de Atualização da Visão de Pedidos do Cliente, que mantém uma visão de Pedidos do Cliente, se inscreve nos eventos publicados pelo Serviço de Clientes e pelo Serviço de Pedidos.
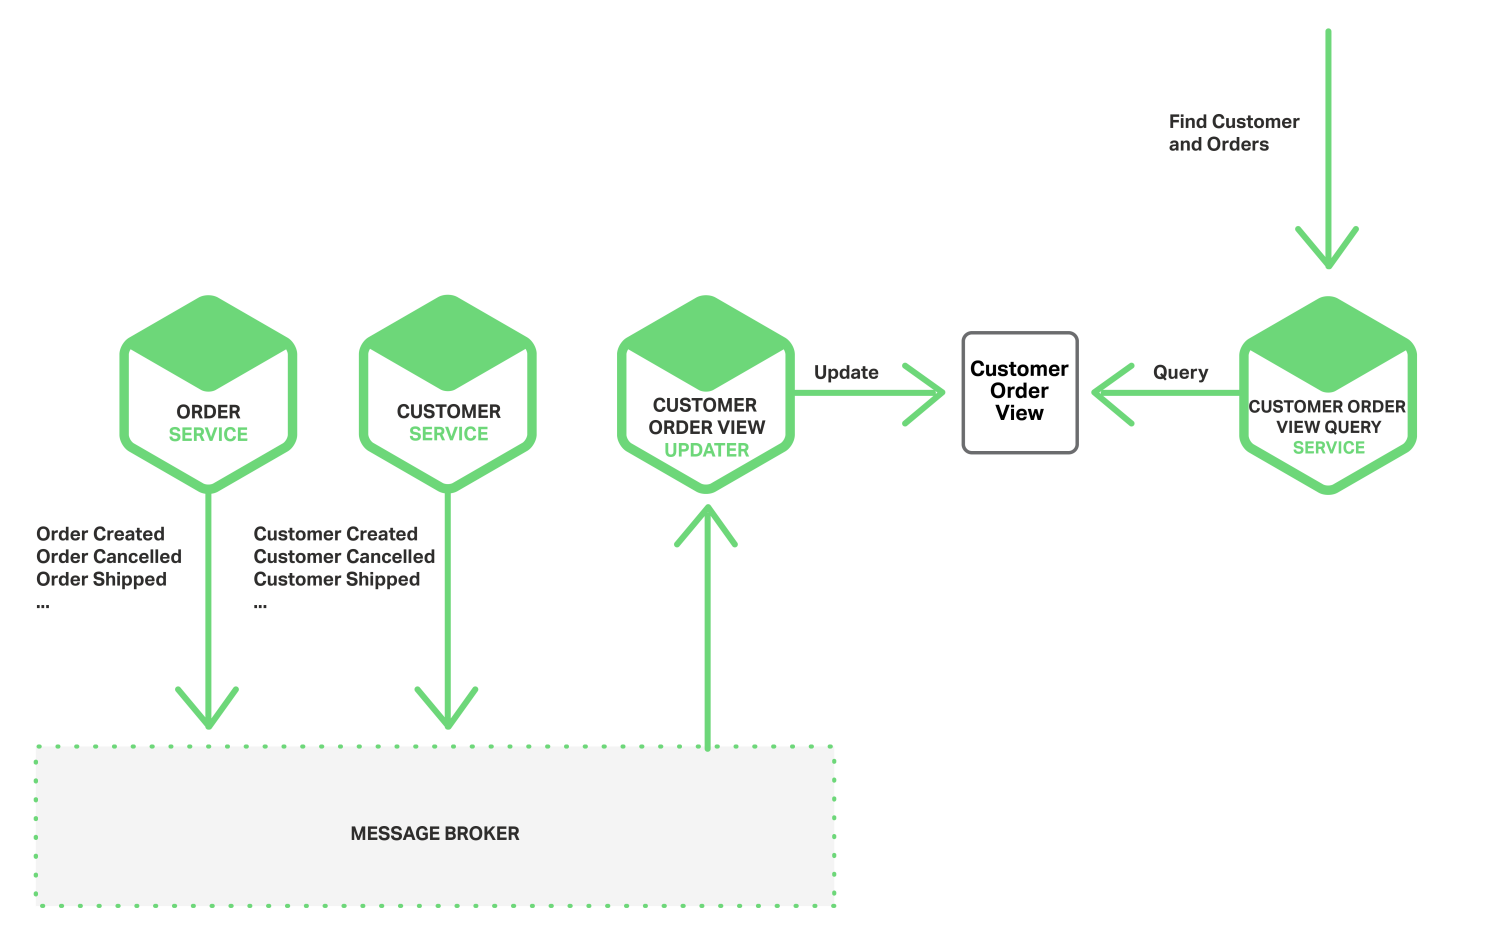
Quando o Serviço de Atualização da Visão de Pedidos do Cliente recebe um evento de Cliente ou Pedido, ele atualiza o repositório de dados da Visão de Pedidos do Cliente. Você pode implementar a Visão de Pedidos do Cliente usando um banco de dados de documentos, como o MongoDB, e armazenar um documento para cada Cliente. O Serviço de Consulta da Visão de Pedidos do Cliente processa solicitações de dados de um cliente e seus pedidos recentes consultando o repositório de dados da Visão de Pedidos do Cliente.
Uma arquitetura orientada a eventos tem várias vantagens e desvantagens. Ela permite implementar transações que abrangem vários serviços e oferecem consistência eventual. Outra vantagem é permitir que uma aplicação mantenha visões materializadas. Uma desvantagem é que o modelo de programação é mais complexo do que ao usar transações ACID. Muitas vezes, é necessário implementar transações compensatórias para se recuperar de falhas no nível da aplicação; por exemplo, é preciso cancelar um pedido se a análise de crédito não for aprovada. Além disso, as aplicações precisam lidar com dados inconsistentes. Isso ocorre porque as alterações feitas por transações em andamento ficam visíveis. A aplicação também pode encontrar inconsistências ao ler uma visão materializada que ainda não foi atualizada. Outra desvantagem é que os assinantes precisam detectar e ignorar eventos duplicados.
Garantindo a atomicidade
Em uma arquitetura orientada a eventos, há também o problema de atualizar o banco de dados e publicar um evento de forma atômica. Por exemplo, o Serviço de Pedidos deve inserir uma linha na tabela ORDER e publicar um evento de Pedido Criado. É essencial que essas duas operações sejam realizadas de forma atômica. Se o serviço falhar após atualizar o banco de dados, mas antes de publicar o evento, o sistema ficará inconsistente. A maneira padrão de garantir a atomicidade é usar uma transação distribuída envolvendo o banco de dados e o broker de mensagens. No entanto, pelos motivos descritos acima, como o teorema CAP, é exatamente isso que não queremos fazer.
Publicação de eventos usando transações locais
Uma maneira de garantir a atomicidade é fazer com que a aplicação publique eventos usando um processo de várias etapas que envolve apenas transações locais. O segredo é ter uma tabela EVENT, que funciona como uma fila de mensagens, no banco de dados que armazena o estado das entidades de negócio. A aplicação inicia uma transação (local) no banco de dados, atualiza o estado das entidades de negócio, insere um evento na tabela EVENT e confirma a transação. Uma thread ou um processo separado da aplicação consulta a tabela EVENT, publica os eventos no broker de mensagens e, em seguida, usa uma transação local para marcar os eventos como publicados. O diagrama a seguir mostra essa arquitetura.
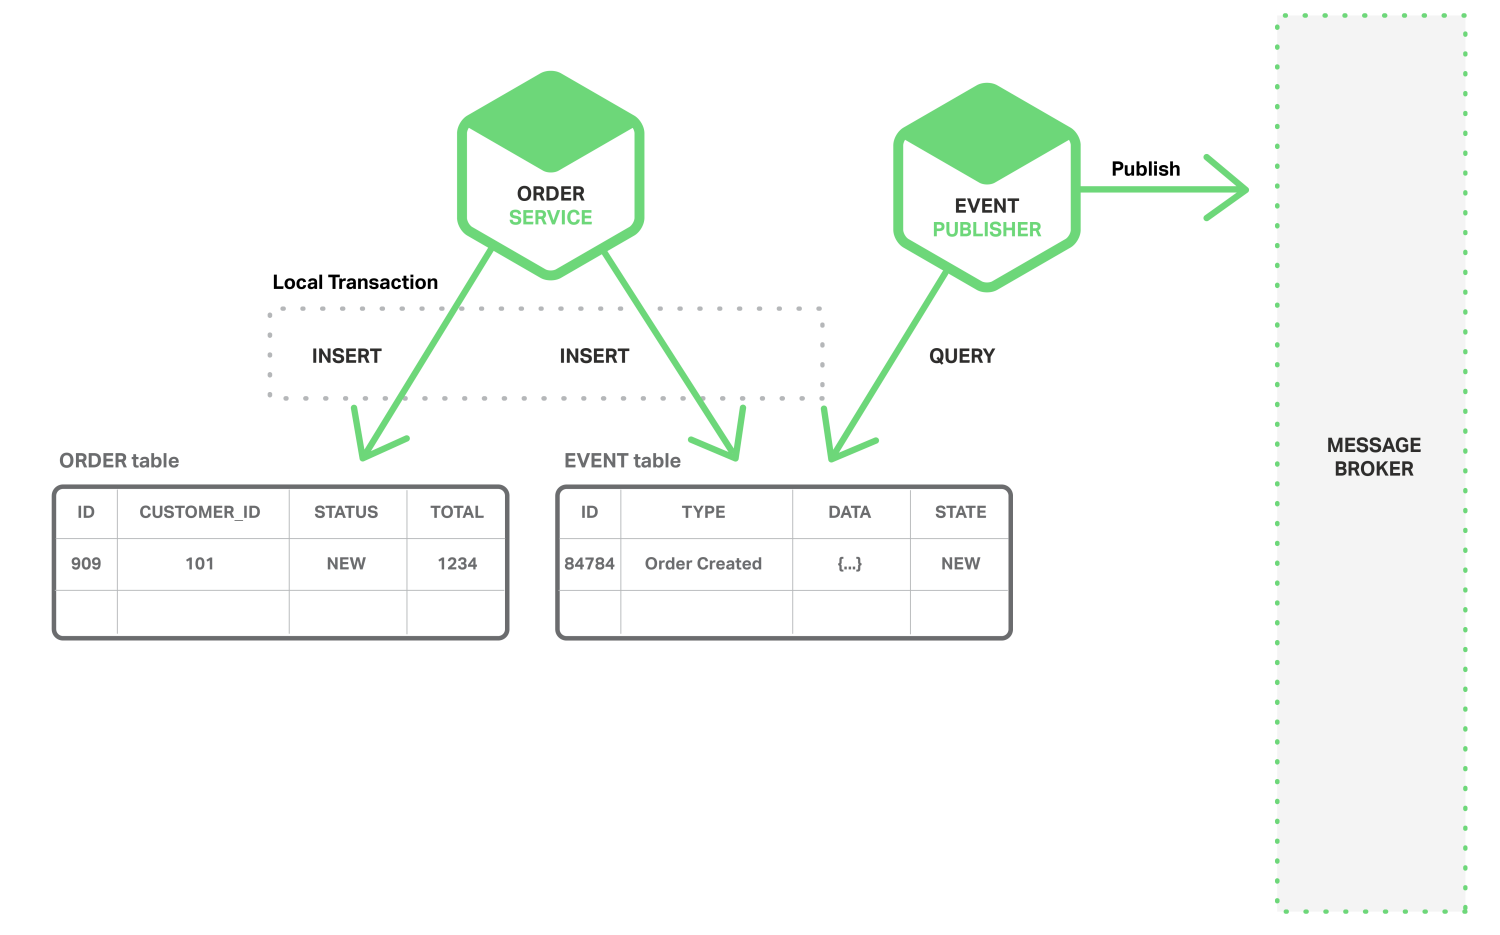
O Serviço de Pedidos insere uma linha na tabela ORDER e um evento de Pedido Criado na tabela EVENT. A thread ou o processo do Publicador de Eventos consulta a tabela EVENT em busca de eventos não publicados, publica esses eventos e, em seguida, atualiza a tabela EVENT para marcá-los como publicados.
Essa abordagem tem várias vantagens e desvantagens. Uma das vantagens é garantir a publicação de um evento para cada atualização sem depender de 2PC. Além disso, a aplicação publica eventos de negócio, o que elimina a necessidade de inferi-los. Uma das desvantagens dessa abordagem é que ela está sujeita a erros, pois o desenvolvedor precisa se lembrar de publicar os eventos. Uma limitação dessa abordagem é a dificuldade de implementá-la com alguns bancos de dados NoSQL devido aos seus recursos limitados de transação e consulta.
Essa abordagem elimina a necessidade de 2PC ao fazer com que a aplicação use transações locais para atualizar o estado e publicar eventos. Vamos agora analisar uma abordagem que garante a atomicidade fazendo com que a aplicação apenas atualize o estado.
Explorando o log de transações de um banco de dados
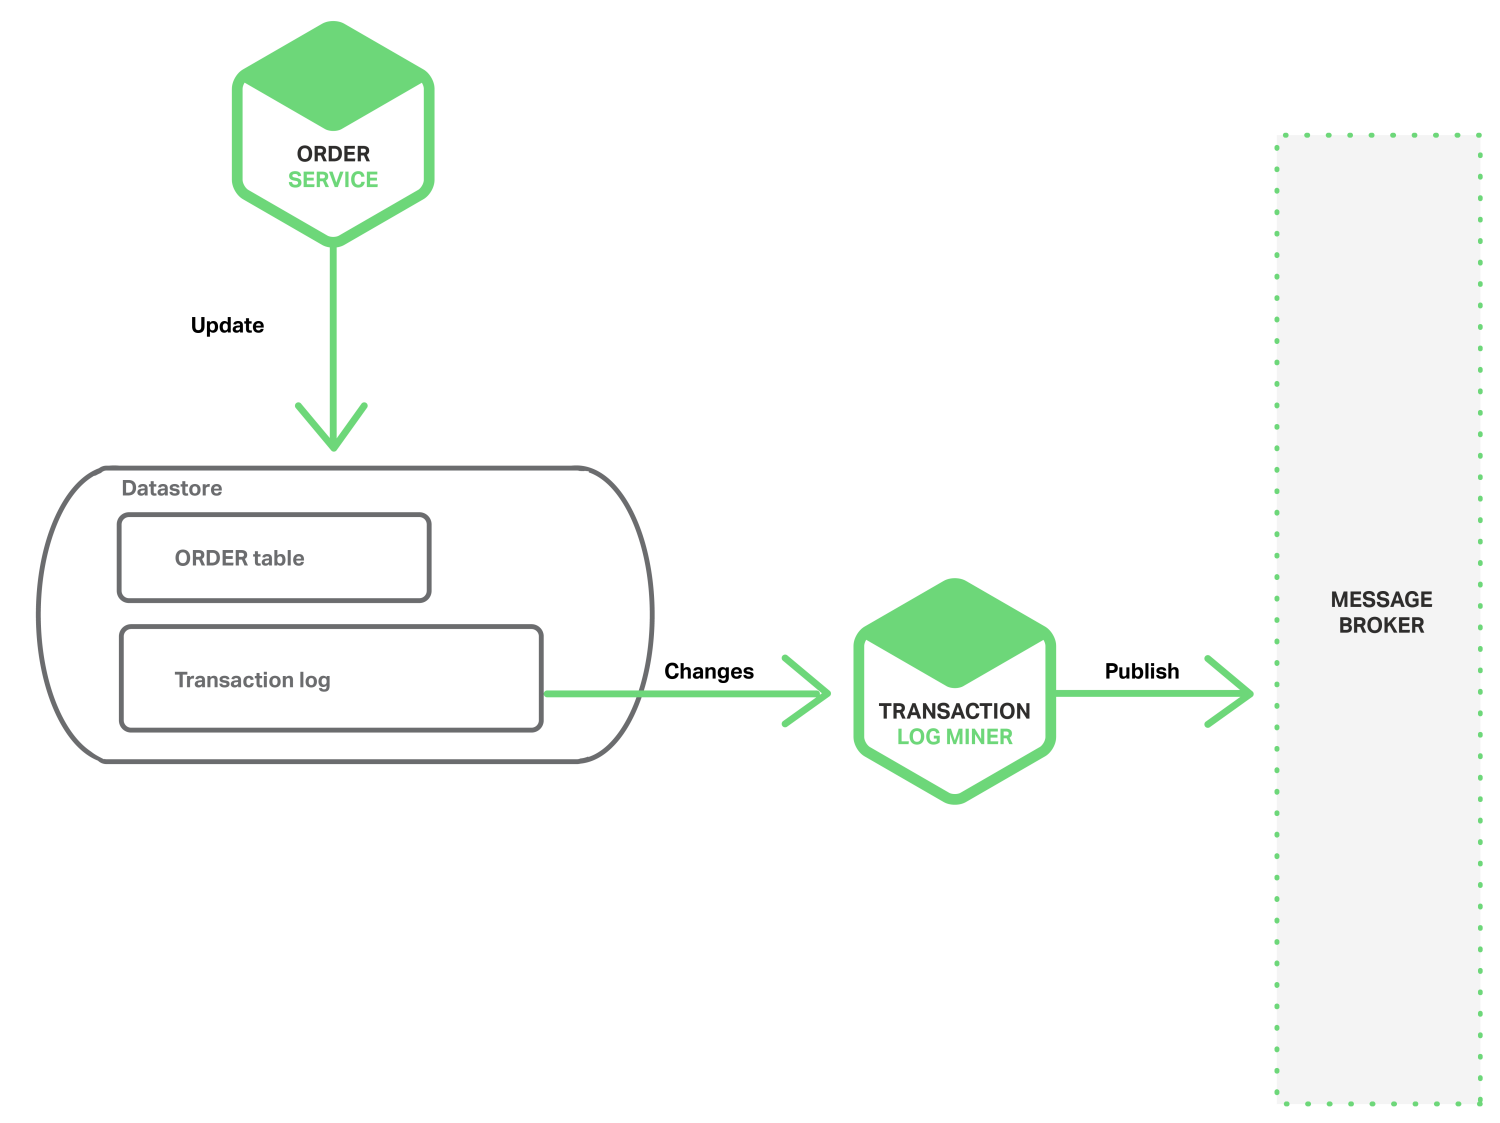
Outra forma de garantir a atomicidade sem 2PC é publicar os eventos por meio de uma thread ou de um processo que analisa o log de transações ou de commits do banco de dados. A aplicação atualiza o banco de dados, o que faz com que as alterações sejam registradas no log de transações. A thread ou o processo de mineração do log de transações lê esse log e publica eventos no broker de mensagens. O diagrama a seguir mostra essa arquitetura.
Um exemplo dessa abordagem é o projeto de código aberto LinkedIn Databus. O Databus analisa o log de transações do Oracle e publica eventos correspondentes às alterações. O LinkedIn usa o Databus para manter vários repositórios de dados derivados consistentes com o sistema de registro.
Outro exemplo é o mecanismo de streams do AWS DynamoDB, que é um banco de dados NoSQL gerenciado. Um stream do DynamoDB contém a sequência, em ordem cronológica, das alterações (operações de criação, atualização e exclusão) feitas nos itens de uma tabela do DynamoDB nas últimas 24 horas. Uma aplicação pode ler essas alterações do stream e, por exemplo, publicá-las como eventos.
A mineração do log de transações tem várias vantagens e desvantagens. Uma vantagem é garantir que um evento seja publicado para cada atualização sem usar 2PC. A mineração do log de transações também pode simplificar a aplicação ao separar a publicação de eventos da lógica de negócios da aplicação. Uma grande desvantagem é que o formato do log de transações é específico de cada banco de dados e pode até mudar entre versões do banco de dados. Além disso, pode ser difícil reconstruir, por meio de engenharia reversa, os eventos de negócios de alto nível a partir das atualizações de baixo nível registradas no log de transações.
A mineração do log de transações elimina a necessidade de 2PC ao fazer com que a aplicação execute apenas uma tarefa: atualizar o banco de dados. Vamos agora analisar uma abordagem diferente, que elimina as atualizações e se baseia exclusivamente em eventos.
Usando Event Sourcing
Event sourcing garante a atomicidade sem 2PC ao usar uma abordagem radicalmente diferente, centrada em eventos, para persistir entidades de negócio. Em vez de armazenar o estado atual de uma entidade, a aplicação armazena uma sequência de eventos que alteram seu estado. A aplicação reconstrói o estado atual de uma entidade reprocessando os eventos. Sempre que o estado de uma entidade de negócio muda, um novo evento é adicionado ao final da lista de eventos. Como salvar um evento é uma única operação, essa operação é inerentemente atômica.
Para entender como o event sourcing funciona, considere a entidade Pedido como exemplo. Em uma abordagem tradicional, cada pedido corresponde a uma linha na tabela ORDER e a linhas, por exemplo, na tabela ORDER_LINE_ITEM. Já com o event sourcing, o Serviço de Pedidos armazena um Pedido na forma de eventos que alteram seu estado: Criado, Aprovado, Enviado, Cancelado. Cada evento contém dados suficientes para reconstruir o estado do Pedido.
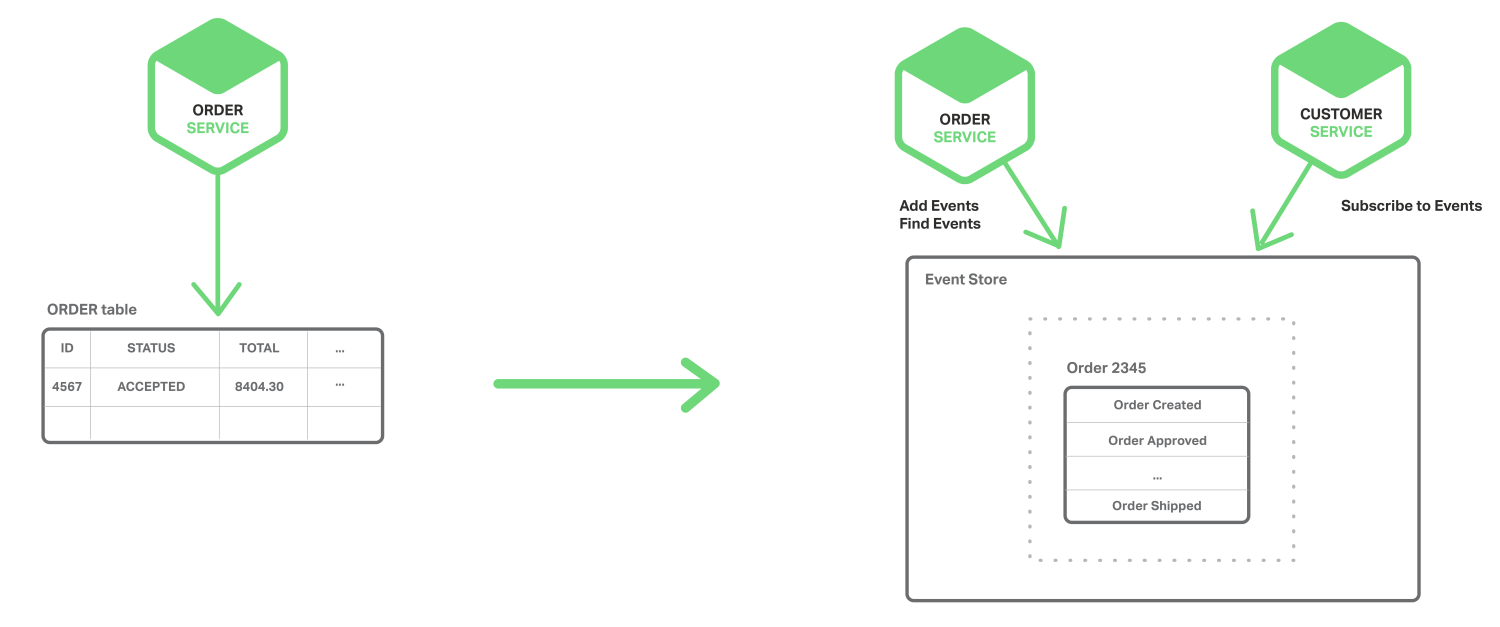
Os eventos são persistidos em um Event Store, que é um banco de dados de eventos. Esse repositório tem uma API para adicionar e recuperar os eventos de uma entidade. O Event Store também funciona como o Message Broker nas arquiteturas que descrevemos anteriormente. Ele fornece uma API que permite que os serviços assinem eventos. O Event Store entrega todos os eventos a todos os assinantes interessados. O Event Store é a espinha dorsal de uma arquitetura de microsserviços orientada a eventos.
O event sourcing oferece vários benefícios. Ele resolve um dos principais problemas na implementação de uma arquitetura orientada a eventos e permite publicar eventos de forma confiável sempre que o estado muda. Com isso, resolve problemas de consistência de dados em uma arquitetura de microsserviços. Além disso, como persiste eventos em vez de objetos de domínio, evita em grande parte o problema de incompatibilidade de impedância objeto-relacional. O event sourcing também fornece um log de auditoria 100% confiável das alterações feitas em uma entidade de negócio e permite implementar consultas temporais que determinam o estado de uma entidade em qualquer momento. Outro grande benefício do event sourcing é que a lógica de negócio consiste em entidades de negócio fracamente acopladas que trocam eventos. Isso facilita muito a migração de uma aplicação monolítica para uma arquitetura de microsserviços.
O event sourcing também tem algumas desvantagens. É um estilo de programação diferente e pouco familiar e, por isso, há uma curva de aprendizado. O armazenamento de eventos só oferece suporte direto à busca de entidades de negócio pela chave primária. É necessário usar a Segregação de Responsabilidades de Comandos e Consultas (CQRS) para implementar consultas. Como resultado, as aplicações precisam lidar com dados com consistência eventual.
Resumo
Em uma arquitetura de microsserviços, cada microsserviço tem seu próprio armazenamento de dados privado. Diferentes microsserviços podem usar diferentes bancos de dados SQL e NoSQL. Embora essa arquitetura de banco de dados ofereça benefícios significativos, ela traz alguns desafios para o gerenciamento de dados distribuídos. O primeiro desafio é como implementar transações de negócio que mantenham a consistência entre vários serviços. O segundo desafio é como implementar consultas que recuperem dados de vários serviços.
Para muitas aplicações, a solução é usar uma arquitetura orientada a eventos. Um dos desafios de implementar uma arquitetura orientada a eventos é como atualizar o estado e publicar eventos de forma atômica. Existem algumas maneiras de fazer isso, incluindo o uso do banco de dados como fila de mensagens, a mineração de logs de transações e o event sourcing.
Nas próximas publicações do blog, continuaremos a nos aprofundar em outros aspectos dos microsserviços.
Editor – Esta série de artigos em sete partes agora está completa:
- Introdução aos microsserviços
- Construindo microsserviços: usando um gateway de API
- Criando microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços
- Gerenciamento de dados orientado a eventos para microsserviços (este artigo)
- Como escolher uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, em formato de e-book – Microsserviços: do design à implantação. Confira também nossa série sobre a arquitetura de referência de microsserviços e a página de soluções de microsserviços.
O blogueiro convidado Chris Richardson é o fundador do projeto original CloudFoundry.com, uma das primeiras PaaS (plataforma como serviço) Java para o Amazon EC2. Atualmente, ele presta consultoria a organizações para aprimorar a maneira como desenvolvem e implantam aplicações. Ele também publica regularmente sobre microsserviços em seu blog em http://microservices.io.
Sobre o autor
Publicações relacionadas no blog
Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.
Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.
Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.
Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.