
A medida que las capacidades de la IA y el aprendizaje automático se consideran cada vez más esenciales para impulsar la innovación y la eficiencia en empresas de todos los tamaños, las organizaciones deben determinar cuál es la mejor manera de facilitar a sus desarrolladores de aplicaciones el acceso a dichas capacidades. En muchos casos, se utilizará un servicio de inferencia de IA, es decir, «un servicio que invoca modelos de IA para generar un resultado a partir de una entrada determinada» (por ejemplo, para predecir una clasificación o generar texto), normalmente en respuesta a una llamada a una API desde el código de otra aplicación.
Estos servicios de inferencia pueden desarrollarse y utilizarse de muy diversas formas (incluso dentro de una misma organización). Pueden desarrollarse íntegramente de forma interna o consumirse como SaaS, aprovechar proyectos de código abierto y utilizar modelos abiertos o comerciales. Pueden formar parte de una «plataforma de aprendizaje automático» plenamente funcional que respalde iniciativas más amplias de ciencia de datos y creación de modelos, o limitarse a proporcionar un endpoint de API desde el que invocar los modelos. Pueden ejecutarse en un centro de datos privado, en una nube pública, en un centro de colocación o mediante una combinación de estas opciones. Es probable que las organizaciones de mayor tamaño recurran a más de una opción de inferencia de IA (especialmente cuando su grado de madurez organizativa en este ámbito es menor). Aunque no existe un enfoque único que sirva para todo el mundo, están surgiendo varios patrones comunes.
Descripción general de los patrones
Examinaremos tres patrones generales de consumo de inferencia de IA, así como sus distintas ventajas y desventajas:
- Inferencia de IA como SaaS – Las aplicaciones se conectan a un proveedor externo especializado en servicios de inferencia de IA.
- Inferencia de IA gestionada en la nube – Las aplicaciones se conectan a servicios de inferencia de IA totalmente gestionados que se ejecutan en la nube pública.
- Inferencia de IA autogestionada – Las aplicaciones consumen inferencia de IA gestionada por la propia organización, ya sea como parte de un servicio centralizado o directamente en el ámbito de la aplicación.
Puntos clave para la toma de decisiones
Al evaluar las ventajas e inconvenientes de los siguientes patrones operativos, conviene tener en cuenta algunos factores clave:
Consideraciones operativas
Escalabilidad – ¿Quién es responsable y hasta qué punto puede una opción determinada aumentar o reducir su escala a medida que cambian las necesidades de capacidad con el tiempo? ¿Existen límites máximos de escalabilidad o capacidad?Coste – A primera vista, los servicios totalmente gestionados pueden parecer más caros, pero, si se tiene en cuenta el coste total de propiedad (incluidos el hardware especializado y el personal necesarios), la decisión puede no estar tan clara. ¿Cómo varían los costes operativos a medida que aumenta o disminuye la capacidad? ¿Existen costes mínimos?Mantenimiento / Soporte – ¿Quién es responsable del mantenimiento del servicio de inferencia? ¿Tendrá su organización que contratar empleados o pagar a consultores especializados en este ámbito, o tendría más sentido optar por un servicio gestionado?
Consideraciones de desarrollo
Facilidad de integración con las cargas de trabajo – ¿Con qué rapidez se puede integrar el servicio de IA con las cargas de trabajo que lo utilizan? ¿Es la oferta de servicios compatible con el patrón de uso previsto (por ejemplo, inferencia sin conexión o por lotes) y con los entornos operativos?Agilidad – ¿Con qué rapidez se puede adaptar la aplicación en su conjunto a los cambios en los requisitos empresariales? ¿Qué aspectos de la arquitectura están más arraigados y serían difíciles de cambiar?
Consideraciones de rendimiento
Rendimiento – ¿Son relevantes para sus casos de uso la ubicación física del servicio (en relación con los consumidores del servicio) y la latencia de la inferencia?Disponibilidad de hardware – ¿Tiene el servicio algún requisito especial de hardware? En caso afirmativo, ¿dispone de capacidad para satisfacer la demanda prevista (tanto en entornos locales como en la nube)?
Consideraciones sobre los datos
Fuga de datos – ¿Existe el riesgo de que se envíen datos confidenciales al servicio de inferencia o de que estén presentes en el resultado de la inferencia? En caso afirmativo, ¿se puede inspeccionar el tráfico y aplicar medidas de protección?Gobernanza de datos – ¿A dónde se envían geográficamente los datos de la aplicación (y cómo)? ¿Mantiene la organización el control directo o se envían a terceros? ¿Existen normativas o políticas de cumplimiento especiales que determinen cómo deben tratarse los datos?
Patrón SaaS
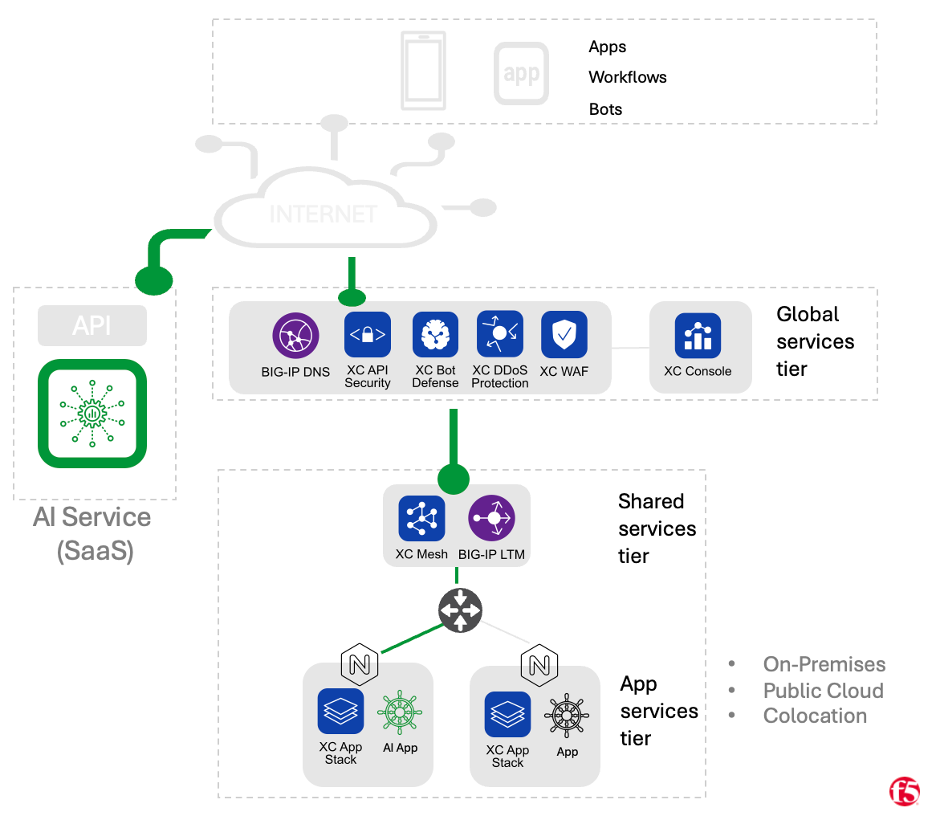
Las organizaciones pueden optar por utilizar los servicios de un proveedor de SaaS especializado en alojar modelos de IA para inferencia (como OpenAI o Cohere). En este caso, las cargas de trabajo que se ejecutan en la infraestructura de una organización (ya sea un centro de datos privado, un centro de colocación o una nube pública) utilizan las API publicadas por el proveedor de SaaS. Con este patrón, la responsabilidad de operar la infraestructura necesaria para alojar los modelos recae por completo en el proveedor de SaaS, y el tiempo necesario para ponerla en marcha puede ser muy breve. Sin embargo, estas ventajas implican una pérdida de control, ya que este patrón es el menos «flexible» de los que abordaremos. Asimismo, el control sobre los datos confidenciales suele ser menor con este modelo, en el que normalmente se utiliza la Internet pública para conectarse al servicio y es menos probable que el proveedor externo de SaaS pueda satisfacer requisitos normativos estrictos.
Ideal para
- Tiempo de comercialización: prototipado rápido y lanzamientos de productos mínimos viables (MVP).
- Organizaciones sin conocimientos especializados ni experiencia interna significativa en inferencia de IA.
- Aplicaciones sin necesidades importantes o estrictas de seguridad o gobernanza de datos.
Puntos fuertes
- Tiempo de comercialización reducido: un modelo operativo sencillo puede acortar los plazos de integración.
- Los proveedores de servicios especializados están bien preparados para afrontar los retos de escalabilidad de la inferencia.
- No requiere invertir en hardware especializado ni en personal especializado.
Desafíos
- Problemas de latencia y conectividad en comparación con los servicios ubicados junto a las cargas de trabajo de las aplicaciones.
- Las cuestiones relativas a la privacidad, la gobernanza y la seguridad de los datos dependen de un proveedor de SaaS externo (o pueden ser incompatibles con este).
- Los costes operativos a gran escala pueden ser superiores a los de los modelos de alojamiento propio.
- Es posible que no se admitan el alojamiento de modelos personalizados ni los servicios de personalización de modelos.
Patrón gestionado en la nube
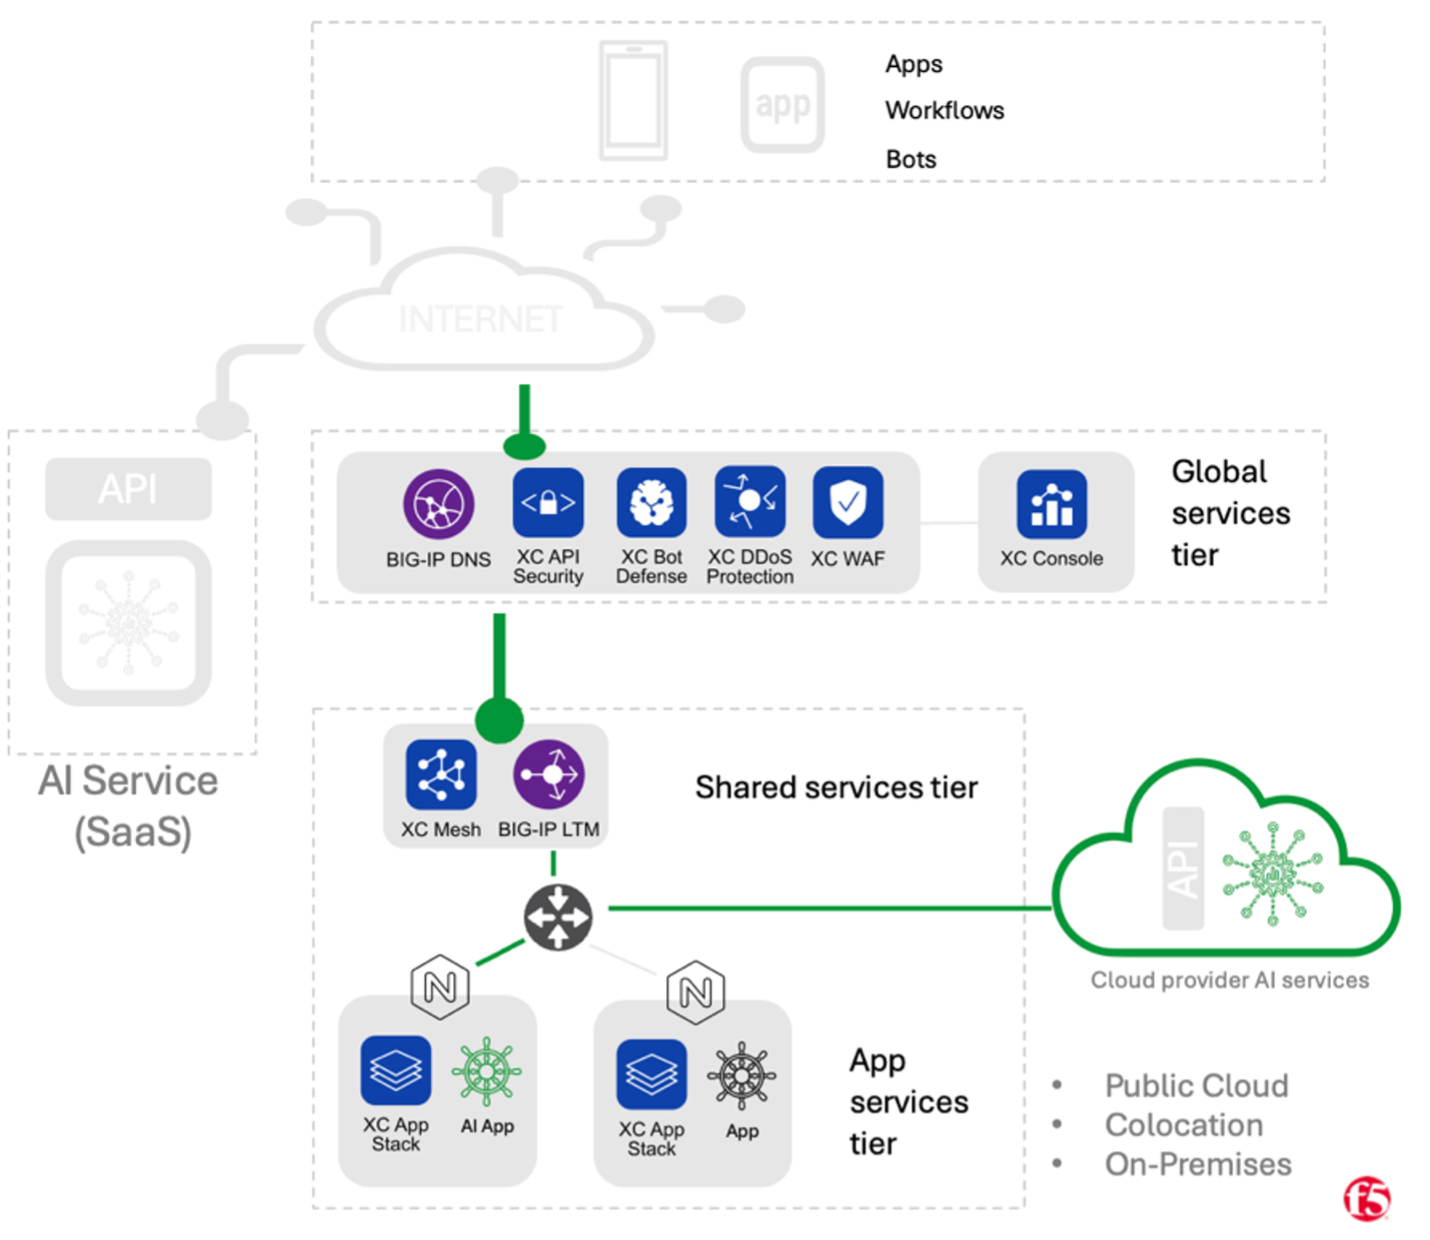
En este patrón, las organizaciones aprovechan los servicios gestionados que ofrecen los proveedores de nube pública (por ejemplo, Azure OpenAI, Google Vertex y AWS Bedrock). Al igual que en el primer patrón, la carga operativa que supone implementar, escalar y mantener los modelos de IA recae en el proveedor de nube, en lugar de en la organización que los utiliza. La principal diferencia entre este patrón y el patrón SaaS anterior es que, en este caso, normalmente se puede acceder a los endpoints de la API de inferencia a través de redes privadas, y las cargas de trabajo que consumen IA pueden ubicarse junto al servicio de modelos de IA (por ejemplo, en la misma zona o región). Como resultado, los datos no suelen transitar por la Internet pública, es probable que la latencia sea menor y los mecanismos para conectarse a estos servicios son similares a los utilizados con otros servicios gestionados de proveedores de nube (es decir, cuentas de servicio, políticas de acceso y ACL de red). Las organizaciones que utilizan redes multinube pueden obtener algunas de estas mismas ventajas incluso cuando las cargas de trabajo y los servicios de inferencia de IA están alojados en nubes diferentes.
Ideal para
- Organizaciones con inversiones existentes en la nube pública.
- Aplicaciones que se ejecutan en otros servicios gestionados en la nube o se conectan a ellos.
Puntos fuertes
- Muchas organizaciones ya están familiarizadas con la conexión de sus cargas de trabajo a otros servicios gestionados por proveedores de nube (por ejemplo, bases de datos, almacenes de objetos, etc.).
- La carga operativa y de infraestructura que supone ejecutar y escalar modelos recae principalmente en el proveedor de servicios en la nube.
- Las cuestiones relacionadas con la latencia y algunas relativas a la privacidad de los datos pueden ser más fáciles de abordar.
Desafíos
- Las aplicaciones multicloud o de nube híbrida requieren un esfuerzo adicional para conectarlas y protegerlas.
- La falta de uniformidad entre los servicios gestionados en la nube y las API puede generar dependencia de un proveedor.
- Las organizaciones sin una presencia significativa en la nube pública pueden enfrentarse a dificultades.
- Los costes operativos a gran escala pueden ser superiores a los de los modelos de alojamiento propio.
- Es posible que no se admitan los servicios de alojamiento y personalización de modelos personalizados.
Patrón autogestionado
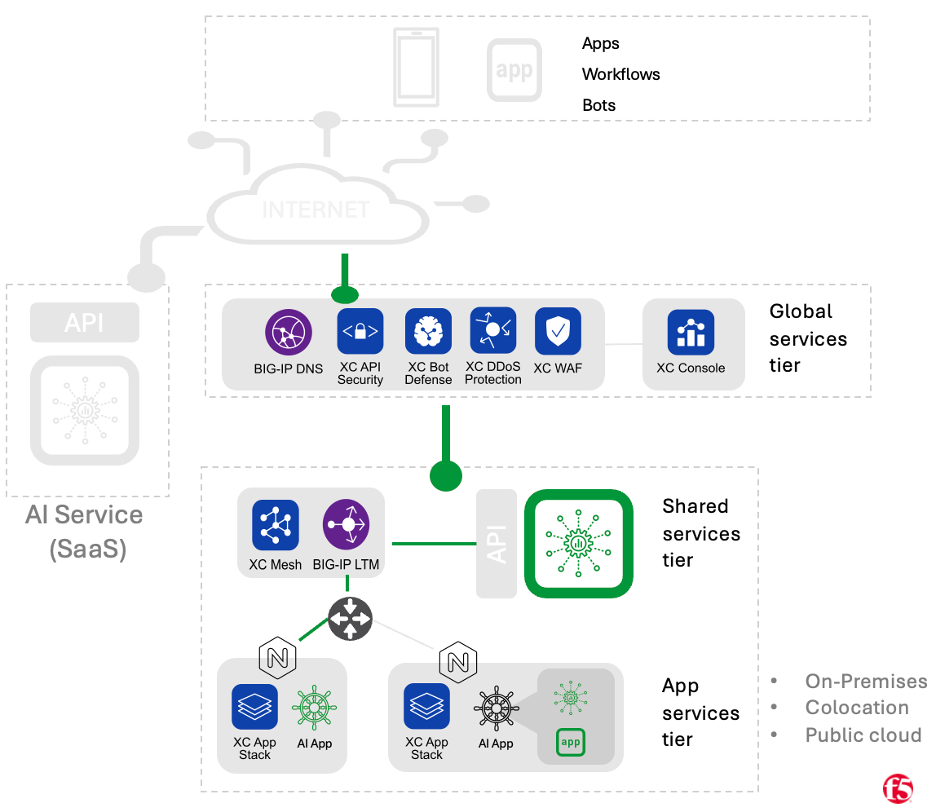
En el modelo autogestionado, primero analizaremos el caso en el que la inferencia de modelos de IA se ejecuta como un «servicio compartido» centralizado y, a continuación, examinaremos el caso en el que no existe ningún servicio centralizado y las cuestiones operativas quedan en manos de los equipos de cada aplicación.
Servicio compartido autogestionado
En la variante de «servicio compartido» del patrón autogestionado, una organización puede contar con uno o varios equipos dedicados al mantenimiento de la infraestructura de inferencia, los modelos que se ejecutan en ella, las API utilizadas para conectarse a ella y todos los aspectos operativos del ciclo de vida del servicio de inferencia. Al igual que con los demás patrones, las cargas de trabajo de las aplicaciones de IA consumirían los servicios de inferencia mediante llamadas a API. La infraestructura de servicio de modelos podría ejecutarse en centros de datos privados, en la nube pública o en una instalación de coubicación. Los equipos responsables de operar el servicio de inferencia pueden aprovechar plataformas de aprendizaje automático autoalojadas (como Anyscale Ray o MLFlow). Como alternativa, podrían recurrir a herramientas más específicas para servir inferencias, como el servidor Text Generation Inference de Hugging Face, o a software desarrollado internamente. Con la inferencia autogestionada, las organizaciones se limitan a utilizar modelos que hayan entrenado ellas mismas o que estén disponibles para ejecutarse localmente (por lo que los modelos propietarios de un servicio orientado a SaaS podrían no ser una opción).
Ideal para
- Organizaciones consolidadas con amplia experiencia en la gestión de infraestructuras.
- Organizaciones con grandes necesidades de inferencia que justifican el coste total de propiedad de un servicio autogestionado.
- Aplicaciones con los requisitos más estrictos de privacidad de datos y cumplimiento normativo.
Puntos fuertes
- Las organizaciones tienen el control absoluto de todos los aspectos del servicio de inferencia.
- Los retos relacionados con la privacidad de los datos suelen ser más fáciles de abordar con modelos alojados en la propia infraestructura.
- A gran escala, los costes pueden ser más eficientes que los de los servicios de inferencia gestionados en la nube o basados en SaaS.
Desafíos
- Las organizaciones tienen el control absoluto de todos los aspectos del servicio de inferencia (es probable que se requieran grandes inversiones en infraestructura y personal, además de mantenimiento y desarrollo continuos, así como abordar cuestiones de escalabilidad).
- No suele ser rentable para organizaciones con necesidades mínimas de inferencia y escasa preocupación por la privacidad de los datos.
- Sin acceso a modelos cerrados o propietarios que puedan estar disponibles como SaaS o servicios gestionados en la nube.
Autogestionado, no un servicio compartido
La otra variante del patrón autogestionado se da en las organizaciones que no cuentan con un equipo central responsable de ejecutar servicios de inferencia de IA para que los utilicen las aplicaciones. En esta modalidad, los equipos de cada aplicación pueden ejecutar sus modelos en la misma infraestructura que tienen asignada para la carga de trabajo de la aplicación. Pueden optar por acceder a esos modelos mediante una API o utilizarlos directamente sin conexión. Con este patrón, los desarrolladores pueden obtener, a menor escala, algunas de las mismas ventajas que ofrece el modelo autogestionado de «servicio compartido».
Ideal para
- Aplicaciones que requieren procesamiento por lotes e inferencia sin conexión.
- Organizaciones con un consumo de inferencia muy bajo, pero con estrictos requisitos de privacidad de datos y cumplimiento normativo.
Fortalezas
- La opción más flexible para los desarrolladores de aplicaciones, ya que ofrece una amplia variedad de posibilidades de integración con las cargas de trabajo.
- Permite alcanzar los objetivos de privacidad de los datos y latencia a pequeña escala.
- En algunos casos, puede resultar más rentable que los otros modelos analizados (por ejemplo, para un único equipo con grandes necesidades de consumo).
Desafíos
- La carga operativa del ciclo de vida del modelo recae en cada uno de los equipos de aplicaciones.
- No aprovecha las economías de escala a medida que aumenta el consumo de inferencia de IA de una organización (falta de coherencia, uso ineficiente de los recursos, etc.)
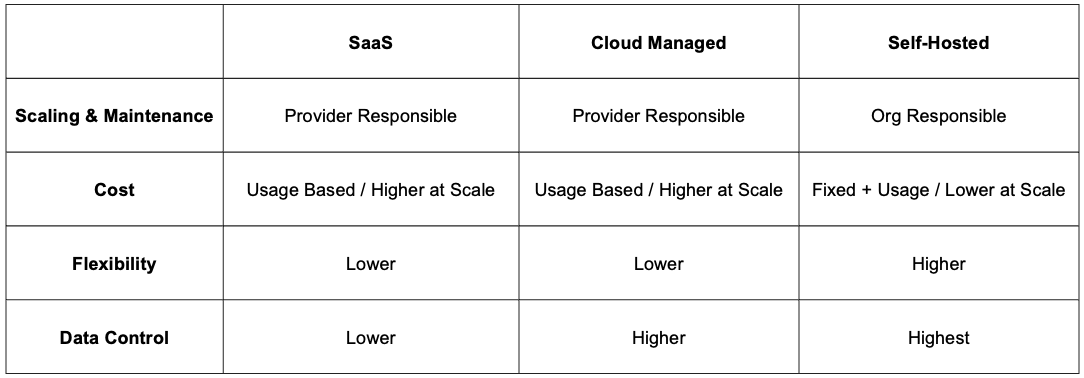
Resumen de las ventajas y desventajas de los patrones
Protección de aplicaciones de IA y servicios de inferencia de modelos
En esencia, las aplicaciones de IA se parecen mucho a cualquier otra aplicación moderna. Se crean combinando componentes de cara al usuario y de backend, suelen depender de almacenes de datos externos, hacen un uso intensivo de llamadas a API, etc. Estas aplicaciones heredan los mismos retos de seguridad comunes a todas las aplicaciones modernas y necesitan que se les apliquen las mismas medidas de protección de la misma manera (por ejemplo, autenticación y autorización, protección contra ataques DDoS, WAF, prácticas de desarrollo seguro, etc.). Sin embargo, las aplicaciones de IA, y especialmente las que utilizan IA generativa, también están sujetas a una serie de riesgos específicos que quizá no afecten a otras aplicaciones (por ejemplo, consulte OWASP Top 10 para LLM). La naturaleza generalmente impredecible de estos modelos puede dar lugar a problemas novedosos, especialmente en casos de uso en los que se concede a los modelos un grado significativo de autonomía.
Afortunadamente, dada la gran dependencia de las interacciones mediante API con la inferencia de modelos de IA en los patrones descritos anteriormente, muchas organizaciones ya están bien preparadas para implementar estas nuevas medidas de seguridad. Por ejemplo, una puerta de enlace de API que proporcione funciones tradicionales de limitación de velocidad, autenticación, autorización y gestión del tráfico podría ampliarse para admitir límites basados en tokens que ayuden a controlar los costes (ya sea para el tráfico saliente en el nivel de la aplicación hacia un servicio gestionado por un proveedor o de tipo SaaS, o mediante autorización RBAC para el tráfico entrante como protección ante un servicio de inferencia autogestionado). Del mismo modo, la infraestructura que actualmente presta servicios tradicionales de firewall de aplicaciones web (WAF), como la detección de inyecciones SQL o XSS, podría ser un lugar lógico para añadir protecciones contra la inyección de instrucciones y ataques similares. La mayoría de las prácticas modernas de observabilidad son directamente aplicables a casos de uso específicos de inferencia de IA mediante API, y los equipos deberían poder sacar buen partido de las herramientas y prácticas existentes en este ámbito.
Conclusión
Aunque el revuelo en torno a las aplicaciones basadas en IA y los servicios de inferencia es sin duda reciente, los principios fundamentales que intervienen en su despliegue y protección existen desde hace mucho tiempo. Las organizaciones deberán sopesar las ventajas y los inconvenientes a la hora de determinar la mejor forma de aprovechar las capacidades de la IA, como hacen al adoptar cualquier otra tecnología, teniendo en cuenta sus casos de uso específicos, los recursos disponibles y sus objetivos a largo plazo. Del mismo modo, aunque los casos de uso de la IA —y, en particular, de la IA generativa— plantean algunos retos de seguridad novedosos, las necesidades que comparten con otras aplicaciones modernas y la gran dependencia de la interacción con los modelos a través de API ofrecen una excelente oportunidad para utilizar y ampliar los patrones, las prácticas y las herramientas existentes. Tanto si se opta por un alojamiento propio como por un servicio gestionado, garantizar que los desarrolladores tengan acceso a una solución segura, escalable y de alto rendimiento que satisfaga los requisitos específicos de la empresa es fundamental para maximizar el valor y el impacto de las inversiones en IA.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.