
La IA generativa ofrece numerosas oportunidades en el ámbito de las operaciones y el desarrollo, pero también plantea muchos retos para quienes intentan incorporarla a una solución de seguridad.
Uno de estos retos consiste en obtener información mediante LLM (modelos de lenguaje de gran tamaño) a partir de contenido confidencial que no puede compartirse con ningún servicio de IA de terceros, como las políticas de seguridad utilizadas para proteger aplicaciones y API frente al fraude y el uso indebido.
Un segundo reto de los LLM es su tendencia a alucinar, especialmente cuando se les pide que analicen o generen contenido relacionado con un tema sobre el que tienen pocos conocimientos. Esto suele ocurrir con los lenguajes específicos de dominio como DEX. Se trata de un lenguaje puramente funcional, con tipado estático y no completo de Turing que, aunque está bien definido, no se utiliza de forma generalizada.
El primer reto, la privacidad de los datos, parece insuperable en un principio. Las empresas de seguridad deben tomarse muy en serio la privacidad y la seguridad de todos los datos de sus clientes, incluidas las políticas. Por tanto, aunque el uso de un LLM para ayudar a extraer información valiosa de las políticas beneficiaría tanto a las operaciones como a los clientes, se necesita una solución capaz de obtener información de los datos confidenciales sin compartirlos con un LLM de terceros, lo que impediría que este pudiera procesarlos. El segundo reto (las alucinaciones) es uno que todo el sector intenta superar actualmente, especialmente en lo que respecta a las respuestas sobre políticas, configuraciones y código.
Mientras que los humanos ven un programa como una secuencia de caracteres, el compilador lo interpreta de otra manera. Para el compilador, un programa DEX es un tipo de estructura de datos denominada AST (árbol de sintaxis abstracta). Este árbol es un grafo acíclico dirigido, lo que significa que las políticas en cuestión se prestan bien a su representación como grafo. Por tanto, la solución que encontramos utiliza una base de datos de grafos (Neo4j) y un agente GPT para generar consultas GraphQL sobre ella. Este enfoque resuelve eficazmente el primer reto, ya que podemos utilizar GraphQL para consultar una base de datos de grafos que contiene los datos, al tiempo que protegemos su privacidad frente al LLM de terceros.
El segundo reto —las alucinaciones— es más difícil de superar, pero nuestro enfoque también resulta eficaz en este caso, ya que utiliza múltiples técnicas de IA para mitigar el riesgo. Además, GraphQL es un lenguaje de consulta ampliamente utilizado y bien documentado con el que están familiarizados la mayoría de los modelos GPT, y cuya sintaxis puede verificarse fácilmente mediante numerosas herramientas. Esto reduce la probabilidad de que se produzca una alucinación y permite garantizar que el resultado sea correcto antes de utilizarlo.
¿Qué son las alucinaciones de la IA?
Las alucinaciones de la IA se producen cuando una IA generativa genera resultados que no se basan en datos o patrones reales, sino que son inventados o están distorsionados. Estas alucinaciones suelen deberse a limitaciones o sesgos en los datos de entrenamiento de la IA, o bien ocurren cuando esta intenta generar resultados para situaciones que no ha encontrado antes. Las alucinaciones pueden manifestarse como contenidos o conclusiones inventados o incoherentes, que pueden carecer de sentido lógico o no ajustarse a los datos de entrada. Por ejemplo, una IA generadora de texto podría producir frases que parecen plausibles, pero que en realidad carecen de sentido o no guardan relación con el contexto proporcionado.
¿Qué es GraphQL?
GraphQL es un lenguaje de consultas de código abierto para API (interfaces de programación de aplicaciones) y un entorno de ejecución del lado del servidor que permite ejecutar dichas consultas mediante un sistema de tipos definido para los datos. Fue desarrollado por Meta (Facebook) y está diseñado para ofrecer una alternativa más eficiente, potente y flexible a las API RESTful tradicionales. Las API de GraphQL se definen mediante un esquema que especifica los tipos de datos que se pueden consultar o modificar. Este tipado fuerte permite disponer de mejores herramientas, así como de capacidades de introspección y validación.
Nuestro enfoque
Nuestro enfoque para incorporar de forma segura la IA generativa a la seguridad se materializa en un agente GPT. Aunque el uso de un lenguaje bien documentado ayuda a reducir el riesgo de alucinaciones, necesitábamos encontrar una forma de limitar el espacio de salida de nuestro agente a un formato en el que se pudieran detectar errores mediante programación, sin enviar datos confidenciales a OpenAI. Utilizar GraphQL como espacio de salida resulta adecuado en este caso, ya que ofrece suficiente capacidad expresiva para responder a la mayoría de las preguntas y, al mismo tiempo, constituye una abstracción que puede validarse mediante programación con respecto a un esquema conocido.
Aunque hemos aplicado este enfoque a DEX, funcionará con cualquier conjunto de datos suficientemente interconectado y relacional, como redes sociales, topologías de redes e infraestructuras, cadenas de suministro y datos geoespaciales (cartográficos).
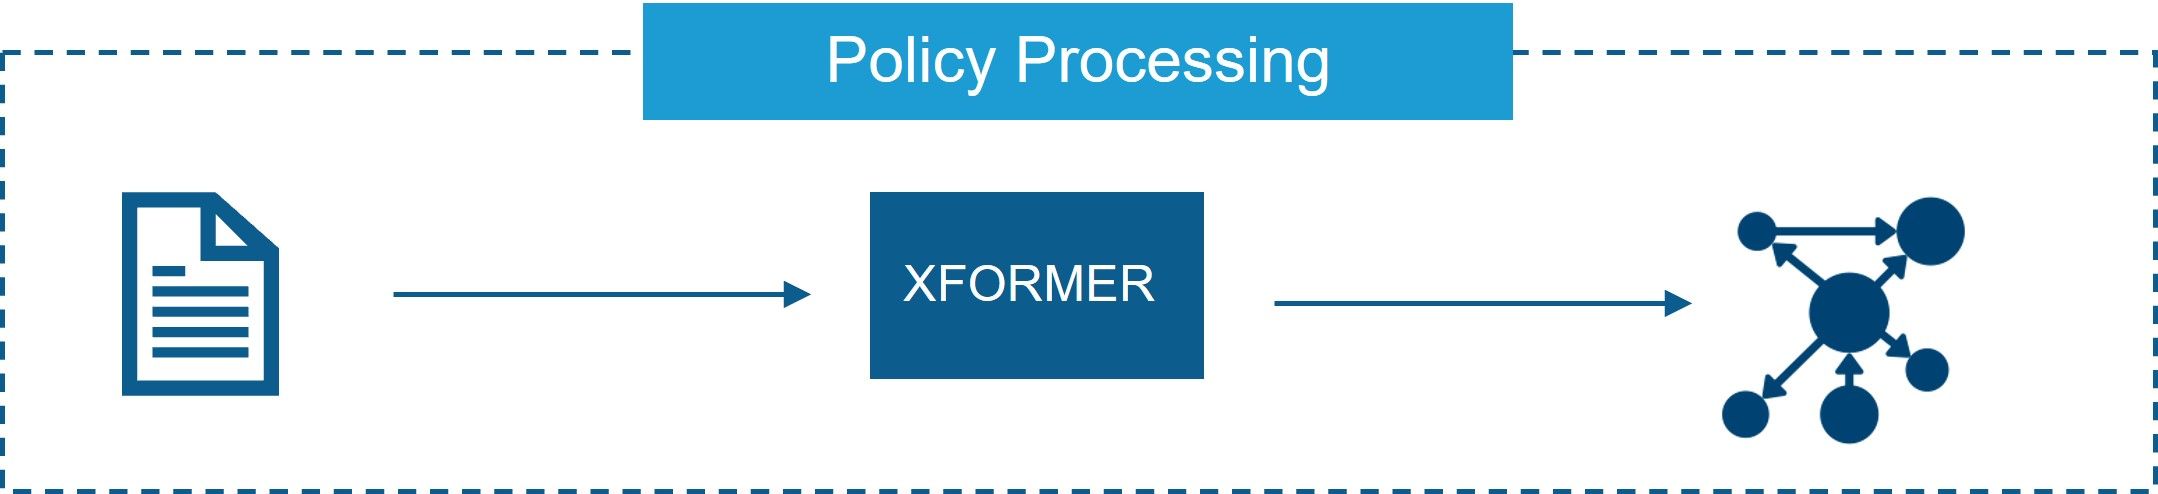
La arquitectura PC-graph consta de componentes que transforman DEX en una representación gráfica. Los datos del grafo resultante se almacenan en una base de datos Neo4j. La salida de un agente GPT puede enviarse mediante una API a un servidor GraphQL Apollo, que ejecuta la consulta en la base de datos de grafos.
Nuestro agente utiliza GPT4 para responder a solicitudes en lenguaje natural sobre políticas escritas en DEX. Para ello, comprende la API de pc-graph y responde con una consulta o mutación adecuada que el usuario puede revisar y ejecutar posteriormente.
Además de la API de pc-graph, nuestro agente también comprende las bibliotecas utilizadas y algunos conceptos del lenguaje DEX. Esta información se selecciona cuidadosamente para incluirla en el contexto durante la ejecución y ofrecer resultados óptimos.
Uno de los retos que esto plantea es que el agente necesita un contexto amplio para albergar las partes relevantes del esquema, así como el material complementario, como la documentación de neo4j-graphQL, que incluye tipos, consultas y mutaciones adicionales generados por la biblioteca. Al utilizar GPT4-8k, sencillamente nos quedamos sin espacio para realizar un aprendizaje en contexto adecuado. Un contexto de 32k ofrece resultados aceptables, pero también conlleva un coste adicional. Por ejemplo, debemos enviar el SDL (lenguaje de definición de esquemas) de GraphQL a OpenAI en cada solicitud. Esto no supondría un problema si pudiéramos ajustar los modelos conversacionales GPT4 con nuestro esquema, lo que eliminaría la necesidad de incluirlo en el contexto. Sin embargo, OpenAI no ofrece actualmente esta posibilidad.
Hemos identificado tres enfoques de IA que mejoran los resultados de GPT4:
- Cadena de pensamiento
- La cadena de pensamiento (CoT) es un concepto de IA que simula procesos de pensamiento similares a los humanos, lo que permite a los sistemas seguir una secuencia lógica de ideas o conceptos, de forma parecida a cómo las personas enlazan sus pensamientos. Esto facilita la comprensión del lenguaje natural, el razonamiento y la comprensión del contexto. Esta técnica ofrece los mejores resultados cuando se aplica al modelo de última generación GPT-4.
- IA reflexiva
- La IA reflexiva, también conocida como IA autoconsciente o IA con capacidades de reflexión, hace referencia a sistemas de inteligencia artificial capaces de realizar introspección y tomar decisiones sobre sus propias acciones y procesos. Este nivel de IA va más allá del aprendizaje automático tradicional y de las capacidades básicas de toma de decisiones, ya que implica un mayor grado de autoconciencia y autoevaluación. Reflexion, un marco para agentes lingüísticos con aprendizaje por refuerzo verbal, «reflexiona verbalmente sobre las señales de retroalimentación de las tareas y, a continuación, conserva su propio texto reflexivo en un búfer de memoria episódica para mejorar la toma de decisiones en intentos posteriores».
- Dialogar consigo misma
- Los agentes de resolución mediante diálogo (DERA) se presentaron como un método para mejorar de forma iterativa los resultados de los LLM mediante la comunicación de comentarios. La técnica utiliza dos agentes: un investigador para procesar la información y un decisor para emitir los juicios finales. La interacción se plantea como un diálogo entre los agentes y otorga al decisor autonomía para valorar el resultado final.
Como último paso, utilizamos herramientas que realizan una comprobación estática de errores de sintaxis en las consultas GraphQL para detectar cualquier posible alucinación que haya eludido las medidas de mitigación iniciales.
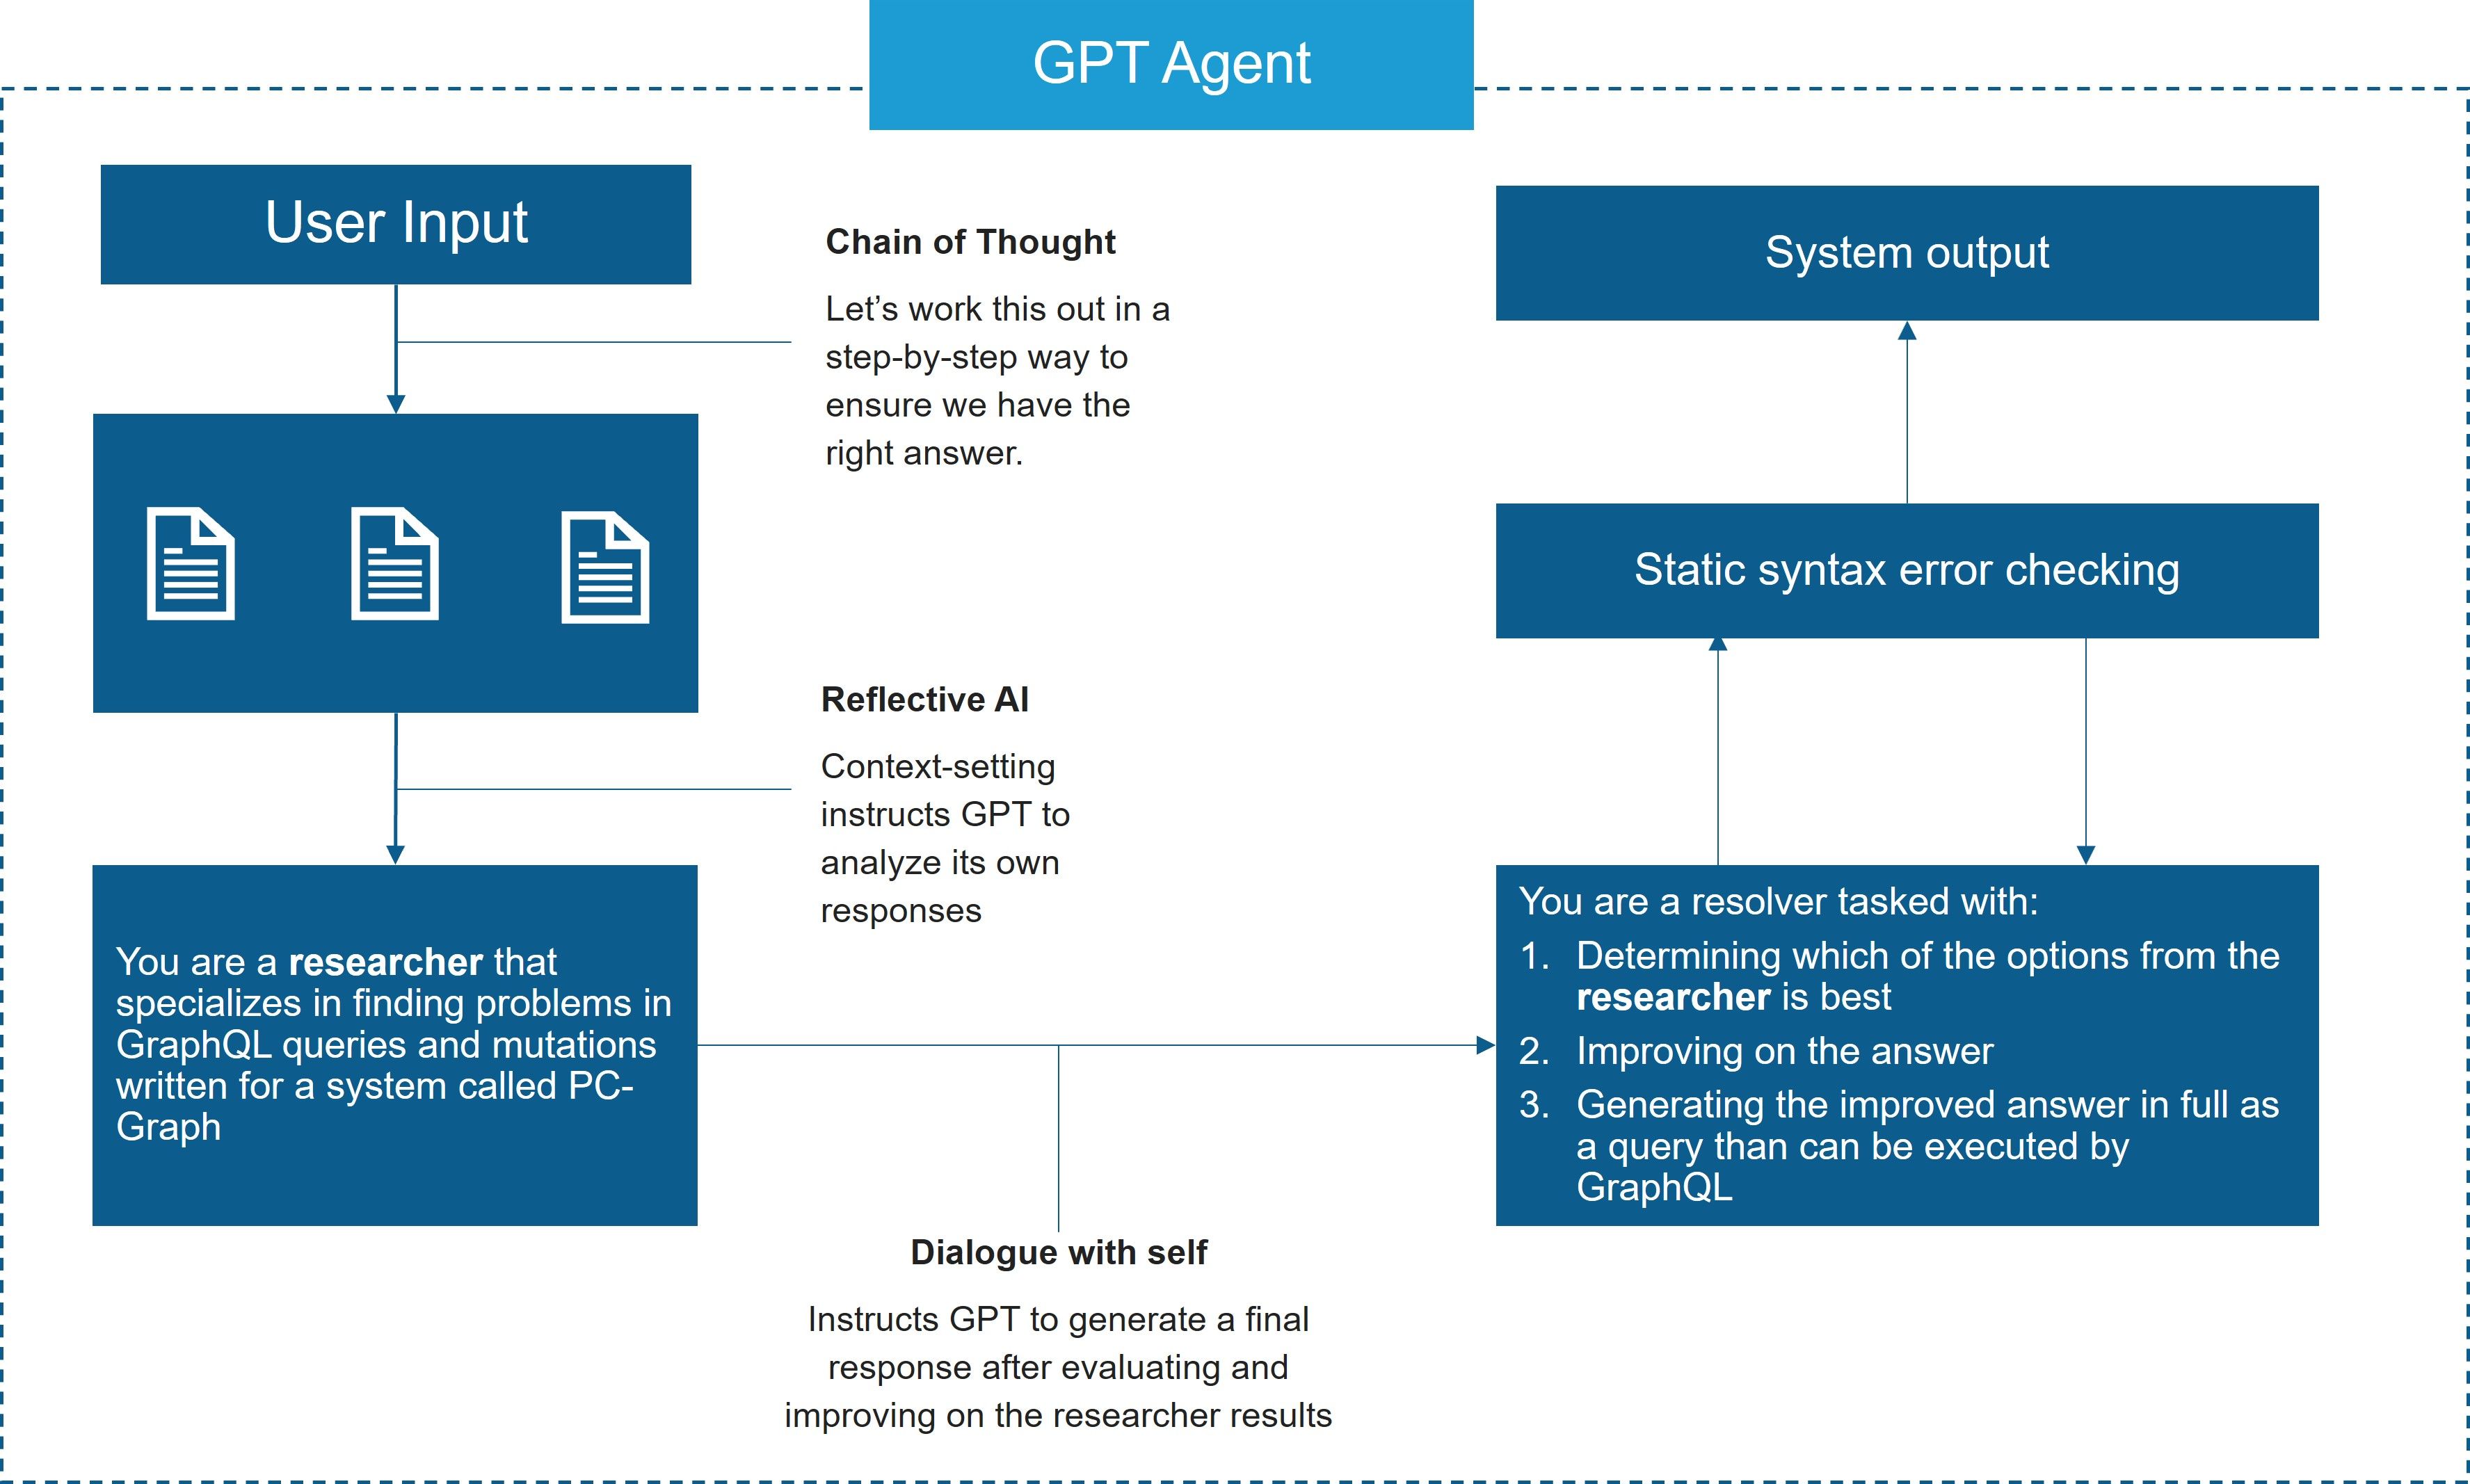
Este diseño se mejora aún más generando inicialmente tres posibles respuestas en una misma instrucción. Esto no solo reduce el tiempo y el coste de cada instrucción, sino que también mejora la coherencia, ya que aumenta la probabilidad de que aparezcan aspectos correctos de una respuesta. De este modo, también dejamos margen para introducir variaciones aleatorias con el fin de explorar opciones poco probables, pero acertadas.
Gracias a nuestro enfoque, hemos podido extraer información valiosa de las pólizas sin compartir datos privados. La calidad y la coherencia de los resultados de nuestras consultas también han mejorado notablemente, con una reducción significativa de las alucinaciones, especialmente en tareas que implican crear consultas extensas o complejas con múltiples filtros y/o funciones de agregación.
En cierto modo, podemos tenerlo todo: cuando nos vemos obligados a elegir entre un agente creativo y uno determinista, simplemente optamos por ambos.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.