De cada cien personas, solo cinco consiguen obtener la información que necesitan de las innumerables herramientas de monitorización que utilizan para supervisar el rendimiento, la disponibilidad y la seguridad de sus activos digitales.
¿Y los otros noventa y cinco? Es como si estuvieran mirando bonitos diagramas de Venn que no sirven para nada.
Una de las causas de que se pasen por alto conclusiones relevantes no es la escasez de herramientas, ni siquiera la falta de datos, sino el sesgo constante presente en ellos.
Sesgo continuo en los datos
El sesgo de los datos se debe a una selección subjetiva dentro de un sistema. Esta selección es el resultado de decisiones que abarcan desde qué datos se recopilan y de qué sistemas proceden hasta cómo se muestran las visualizaciones en los paneles de control.
Una de las fuentes más importantes de sesgo en los datos es el legado de los sistemas basados en agentes, que requieren instalar software adicional en todos los sistemas de los que se quieran recopilar datos. Los agentes suelen estar vinculados a una plataforma de análisis y, en el pasado, el precio de estos productos solía incluir el coste de los agentes. Con descuentos para implementaciones a gran escala, por supuesto, pero aun así suponían una opción costosa.
El coste de implementar —y gestionar— agentes introducía sesgos en los datos, ya que limitaba los sistemas de los que se podían recopilar datos. Las opiniones —fundamentadas en la experiencia o no— sobre la conveniencia de supervisar una aplicación o un sistema determinados solían condicionar la decisión de implementación.
El volumen de datos generado también es una fuente de sesgo continuo, ya que llevó a tomar decisiones basadas en opiniones sobre el valor de determinados puntos de datos. ¿De verdad necesitas todas esas métricas o podemos limitarnos a tres o cuatro? La selección subjetiva de métricas impide validar las variaciones o los cambios en el conjunto de los datos. Esas variaciones o cambios podrían indicar un posible problema —o riesgo—, pero pasan desapercibidos porque los datos se consideraron irrelevantes.
Por último, las decisiones sobre la visualización en los paneles sesgan aún más la interpretación y suelen basarse en conocimientos y experiencias que quizá no compartan otros usuarios del panel. Incluso la elección del tipo de gráfico puede introducir sesgos. Esto es especialmente cierto en el caso de las métricas operativas basadas en series temporales, como el rendimiento y el tiempo de actividad.
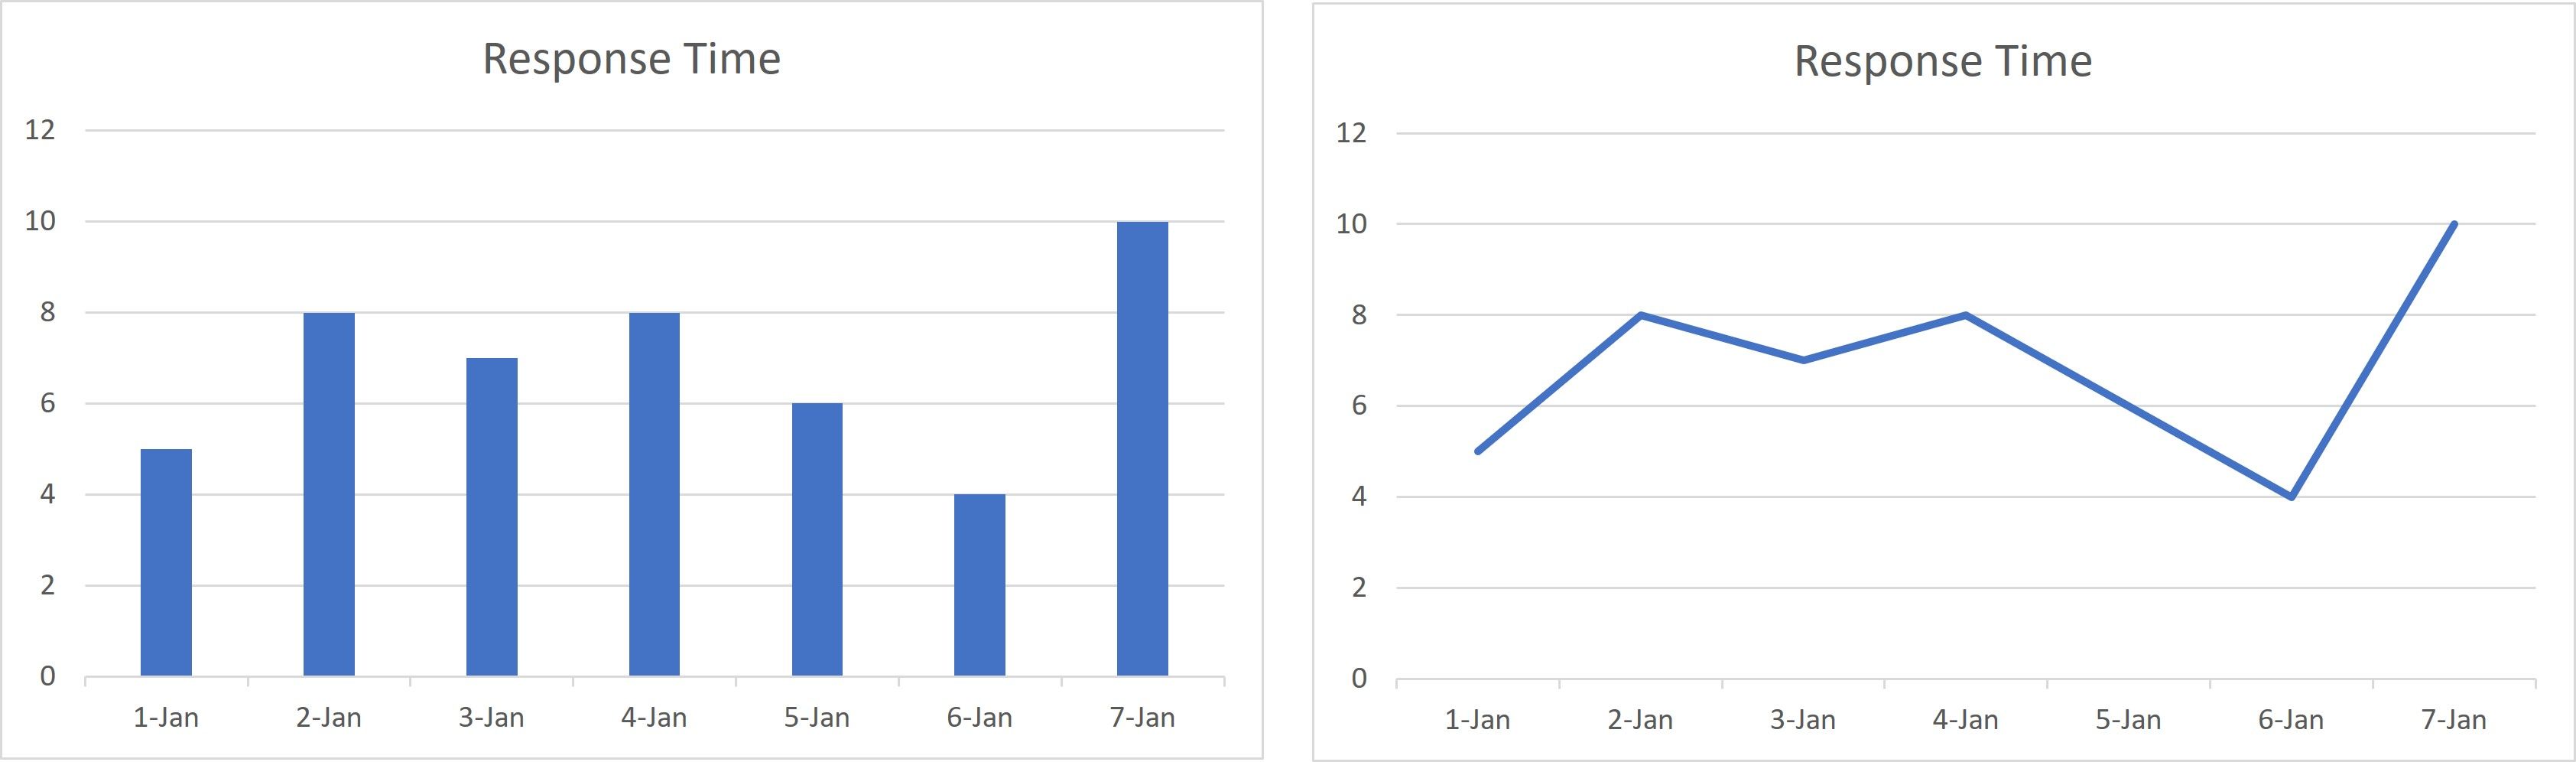
Los gráficos de barras se utilizan a menudo para representar datos de series temporales, pero no resultan tan eficaces como los gráficos de líneas. Un gráfico de barras nos obliga a comparar la altura de las barras para comprender los cambios en el tiempo de respuesta, en lugar de permitir que la forma de la línea nos muestre lo que está sucediendo. Estas sencillas decisiones pueden tener un profundo impacto en los operadores que recurren a la visualización para conocer el estado operativo de un sistema.
Todas estas decisiones introducen continuamente sesgos en los datos y afectan a nuestra capacidad para interpretarlos y, por tanto, para comprender lo que realmente significan.
Eliminar el sesgo en los datos
Si queremos tomar mejores decisiones en un mundo donde lo digital es la opción predeterminada, necesitaremos datos de mayor calidad, y eso implica eliminar tantos sesgos en los datos como sea posible.
Esta es una de las razones por las que OpenTelemetry resulta tan prometedor. Estandarizar la forma en que se genera y se ingiere la telemetría mediante agentes de código abierto (y, por tanto, de bajo coste o gratuitos) contribuirá en gran medida a eliminar una de las causas fundamentales del sesgo de los datos: el presupuesto de TI. Al garantizar que se pueda recopilar telemetría de todos los sistemas, en lugar de solo de unos pocos considerados «dignos», se elimina una importante fuente de sesgo en los datos. Por eso, nuestra visión del edge incluye la idea de integrar la generación de telemetría en la propia plataforma, para que esté siempre disponible en todas partes.
El lago de datos como servicio también puede ser un medio eficaz para abordar el sesgo introducido por la selección de datos debido al volumen y al coste de almacenarlos a lo largo del tiempo. Al externalizar la escalabilidad y la capacidad, las organizaciones pueden incorporar más telemetría con mayor libertad, lo que facilita la detección de anomalías y patrones que afectan al rendimiento, entre otros aspectos. En los últimos cinco años hemos visto una oferta creciente de este tipo de servicios, a menudo englobados en la categoría XaaS, que sigue absorbiendo una proporción cada vez mayor del presupuesto de TI. Deloitte señaló en un informe sobre XaaS publicado este año que casi la mitad de las organizaciones destinará al menos la mitad de su gasto en TI a XaaS.
Por último, al pasar de las visualizaciones a la información procesable, se puede abordar el problema del sesgo en la presentación de datos operativos mediante paneles. En lugar de limitarse a mostrar instantáneas de puntos de datos en momentos concretos, esta información se basa en los patrones y las relaciones descubiertos en los datos. Además, puede evitar intervenciones urgentes innecesarias provocadas por la dependencia de métricas binarias. Los sistemas modernos están diseñados para fallar y recuperarse automáticamente. Recibir una notificación cada vez que esto ocurre puede generar fatiga por alertas y reducir la productividad. La capacidad de analizar la telemetría en el contexto de un flujo de usuario completo permite saber cuándo un componente que ha fallado requiere intervención y cuándo no. Pasar de un modelo basado en la interpretación de múltiples visualizaciones a otro que aproveche información exhaustiva puede eliminar parte del sesgo inherente a la visualización.
A medida que las empresas avanzan hacia un modelo digital por defecto, dependen necesariamente cada vez más de los datos. Eliminar los sesgos de esos datos será un paso fundamental para garantizar que las decisiones basadas en ellos conduzcan al mejor resultado posible tanto para los clientes como para la empresa.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.