
Alors que les capacités d’IA et d’apprentissage automatique sont de plus en plus considérées comme essentielles pour stimuler l’innovation et l’efficacité au sein des entreprises de toutes tailles, les organisations doivent déterminer la meilleure façon de permettre à leurs développeurs d’applications d’y accéder. Dans de nombreux cas, elles auront recours à un service d’inférence d’IA, c’est-à-dire « un service qui fait appel à des modèles d’IA pour produire un résultat à partir d’une entrée donnée » (par exemple, pour prédire une catégorie ou générer du texte), le plus souvent en réponse à un appel d’API provenant d’un autre code applicatif.
Ces services d’inférence peuvent être conçus et utilisés de multiples façons, y compris au sein d’une même organisation. Ils peuvent être développés entièrement en interne ou consommés sous forme de SaaS, s’appuyer sur des projets open source et utiliser des modèles ouverts ou commerciaux. Ils peuvent faire partie d’une « plateforme de machine learning » complète, destinée à soutenir des initiatives plus larges de science des données et de création de modèles, ou se limiter à fournir un point de terminaison d’API permettant d’appeler les modèles. Ils peuvent être exécutés dans un centre de données privé, dans un cloud public, dans un centre de colocation ou dans une combinaison de ces environnements. Les grandes organisations sont susceptibles de recourir à plusieurs solutions d’inférence d’IA, en particulier lorsque leur maturité organisationnelle dans ce domaine est encore faible. Bien qu’il n’existe aucune approche universelle adaptée à tous, quelques modèles courants commencent à se dégager.
Vue d’ensemble des modèles
Nous examinerons trois grands modèles de consommation de l’inférence d’IA, ainsi que leurs différents avantages et inconvénients :
- Inférence IA en mode SaaS – Les applications se connectent à un prestataire externe spécialisé dans les services d’inférence IA.
- Inférence IA gérée dans le cloud – Les applications se connectent à des services d’inférence IA entièrement gérés et exécutés dans le cloud public.
- Inférence d’IA autogérée – Les applications utilisent une inférence d’IA gérée par l’organisation elle-même, soit dans le cadre d’un service centralisé, soit directement au niveau de l’application.
Principaux points de décision
Lors de l’évaluation des compromis entre les modes de fonctionnement suivants, il convient de garder à l’esprit quelques facteurs clés :
Considérations opérationnelles
Évolutivité – Qui en est responsable, et dans quelle mesure une option donnée peut-elle s’adapter à la hausse comme à la baisse à l’évolution des besoins en capacité au fil du temps ? Existe-t-il des limites de mise à l’échelle ou des plafonds de capacité ?Coût – Les services entièrement gérés peuvent sembler plus coûteux à première vue, mais la prise en compte du coût total de possession (notamment le matériel spécialisé et les effectifs nécessaires) peut rendre la décision moins évidente. Comment les coûts d’exploitation évoluent-ils lorsque la capacité augmente ou diminue ? Existe-t-il un seuil minimal de coûts ?Maintenance / Assistance – Qui est responsable de la maintenance du service d’inférence ? Votre organisation devra-t-elle recruter des spécialistes ou faire appel à des consultants possédant une expertise dans ce domaine, ou serait-il plus judicieux d’opter pour un service géré ?
Considérations relatives au développement
Facilité d’intégration aux charges de travail – Dans quels délais le service d’IA peut-il être intégré aux charges de travail qui l’utilisent ? L’offre de services est-elle compatible avec le mode d’utilisation prévu (par exemple, inférence hors ligne ou par lots) et les environnements d’exploitation ?Agilité – Dans quels délais l’application dans son ensemble peut-elle être adaptée à l’évolution des besoins métier ? Quels aspects de l’architecture sont plus profondément ancrés et seraient difficiles à modifier ?
Considérations relatives aux performances
Performances – L’emplacement physique du service (par rapport à ses utilisateurs) et la latence de l’inférence ont-ils une incidence sur vos cas d’usage ?Disponibilité du matériel – Le service nécessite-t-il du matériel spécifique et, si oui, disposez-vous des capacités nécessaires pour répondre à la demande prévue (aussi bien dans les environnements sur site que dans le cloud) ?
Considérations relatives aux données
Fuite de données – Existe-t-il un risque que des données sensibles soient envoyées au service d’inférence ou figurent dans le résultat de l’inférence ? Si tel est le cas, le trafic peut-il être inspecté et des garde-fous peuvent-ils être mis en place ?Gouvernance des données – Où les données de l’application sont-elles envoyées géographiquement (et comment) ? L’organisation en conserve-t-elle directement le contrôle ou sont-elles transmises à des tiers ? Existe-t-il des réglementations ou politiques de conformité particulières qui régissent la manière dont vous devez traiter les données ?
Modèle SaaS
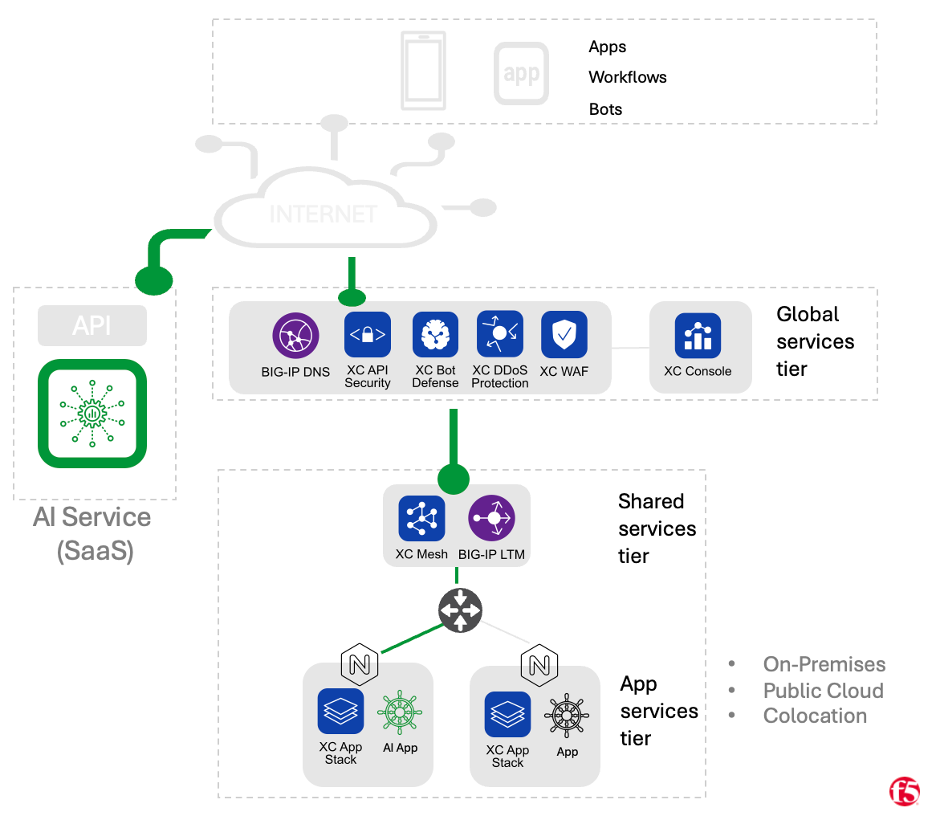
Les organisations peuvent choisir de recourir aux services d’un fournisseur SaaS spécialisé dans l’hébergement de modèles d’IA à des fins d’inférence (comme OpenAI ou Cohere). Dans ce cas, les charges de travail exécutées sur l’infrastructure de l’organisation (qu’il s’agisse d’un centre de données privé, d’un site de colocation ou d’un cloud public) utilisent les API publiées par le fournisseur SaaS. Avec ce modèle, la charge liée à l’exploitation de l’infrastructure nécessaire à l’hébergement des modèles incombe entièrement au fournisseur SaaS, et la mise en service peut être très rapide. Toutefois, ces avantages se font au détriment du contrôle, ce modèle étant le moins « flexible » de ceux que nous aborderons. De même, le niveau de contrôle sur les données sensibles est généralement le plus faible avec ce modèle : la connexion au service s’effectue habituellement via l’Internet public, et le fournisseur SaaS externe est moins susceptible de pouvoir répondre à des exigences strictes en matière de conformité réglementaire.
Particulièrement adapté à
- Délai de mise sur le marché : prototypage rapide, lancement de MVP.
- Organisations ne disposant pas en interne d’une expertise ou d’une expérience significative en matière d’inférence d’IA.
- Applications ne nécessitant pas de mesures importantes ou strictes en matière de sécurité et de gouvernance des données.
Points forts
- Délai de mise sur le marché réduit : un modèle opérationnel simple peut permettre des délais d’intégration courts.
- Les prestataires de services spécialisés sont bien équipés pour relever les défis liés au passage à l’échelle de l’inférence.
- Ne nécessite aucun investissement dans du matériel spécialisé ni dans du personnel dédié.
Défis
- Problèmes de latence et de connectivité par rapport aux services colocalisés avec les charges de travail applicatives.
- Les préoccupations relatives à la confidentialité des données, à la gouvernance et à la sécurité dépendent d’un fournisseur SaaS externe (ou peuvent être incompatibles avec celui-ci).
- À grande échelle, les coûts d’exploitation peuvent être plus élevés qu’avec des modèles auto-hébergés.
- L’hébergement de modèles personnalisés et les services de personnalisation de modèles peuvent ne pas être pris en charge.
Modèle géré dans le cloud
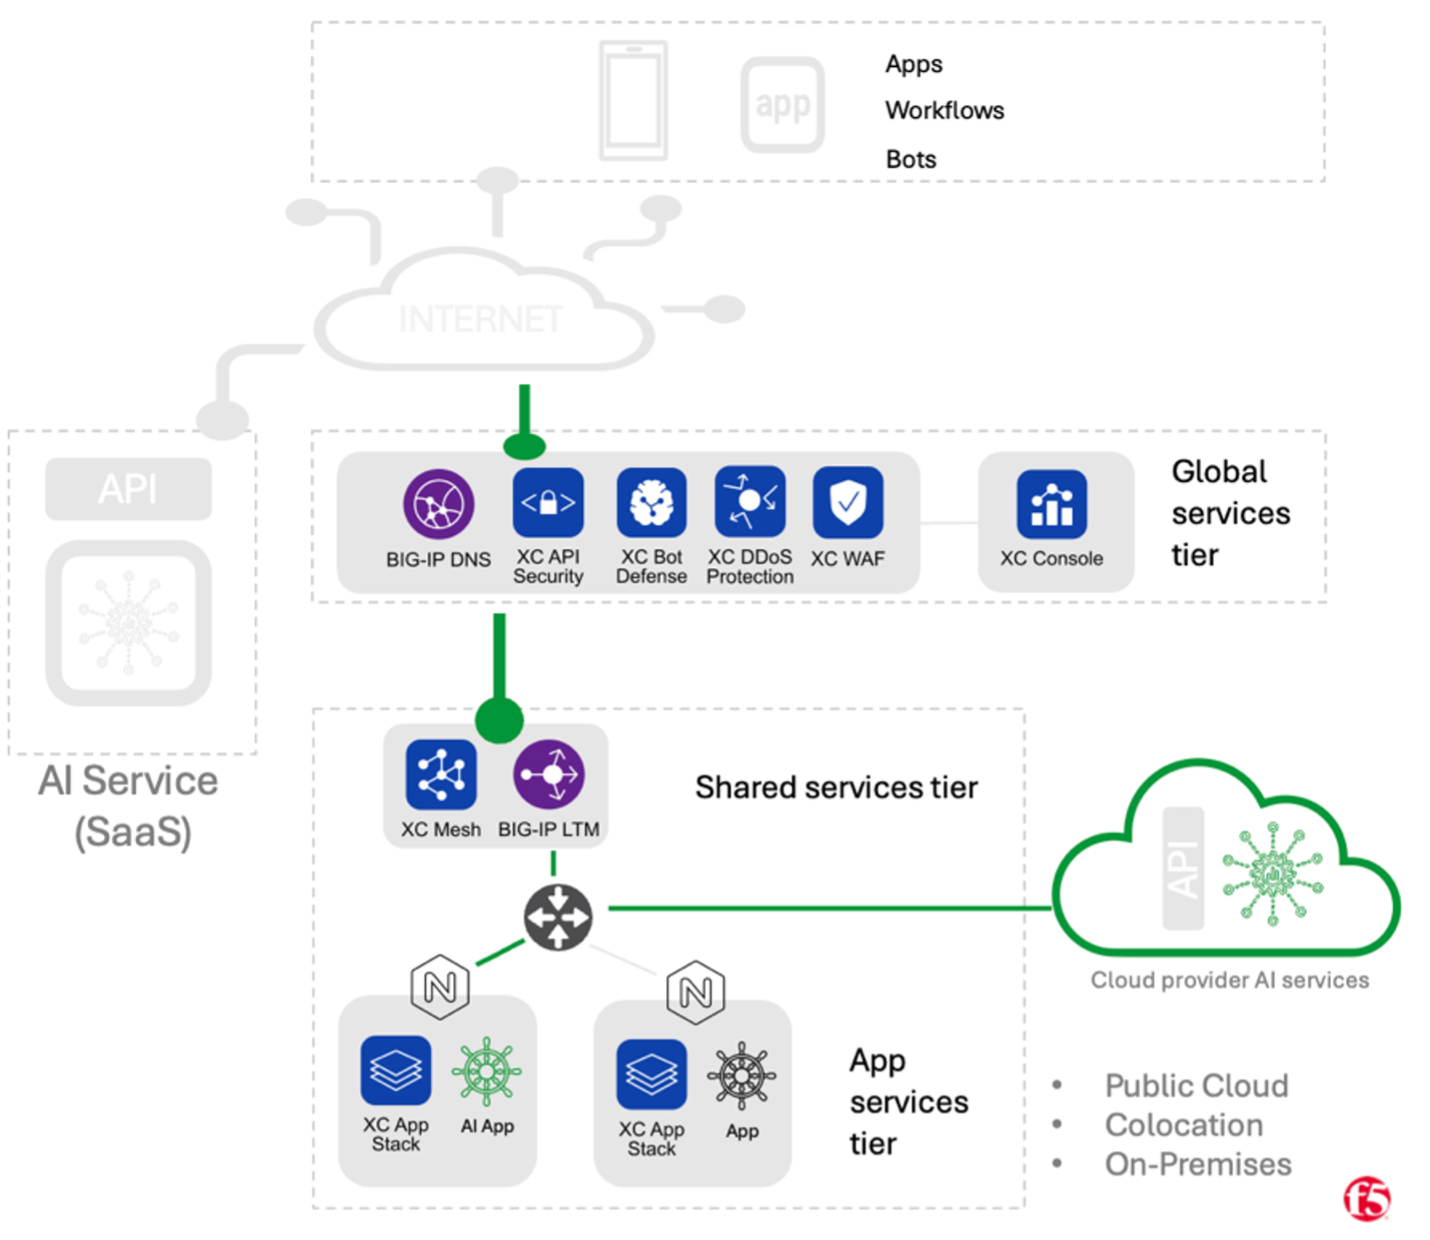
Dans ce modèle, les organisations s’appuient sur des services managés proposés par des fournisseurs de cloud public (par exemple, Azure OpenAI, Google Vertex ou AWS Bedrock). Comme dans le premier modèle, la charge opérationnelle liée au déploiement, à la mise à l’échelle et à la maintenance des modèles d’IA incombe au fournisseur de cloud plutôt qu’à l’organisation utilisatrice. La principale différence entre ce modèle et le modèle SaaS présenté ci-dessus réside dans le fait que les points de terminaison des API d’inférence sont généralement accessibles via des réseaux privés et que les charges de travail utilisant l’IA peuvent être colocalisées avec le service de modèles d’IA (par exemple, dans la même zone ou région). Par conséquent, les données ne transitent généralement pas par l’Internet public, la latence est susceptible d’être plus faible et les mécanismes de connexion à ces services sont similaires à ceux utilisés pour les autres services managés des fournisseurs de cloud (notamment les comptes de service, les politiques d’accès et les listes de contrôle d’accès réseau). Les organisations qui utilisent des réseaux multicloud peuvent bénéficier de certains de ces mêmes avantages, même lorsque les charges de travail et les services d’inférence d’IA sont hébergés dans des clouds différents.
Particulièrement adapté à
- Organisations ayant déjà investi dans le cloud public.
- Applications s’exécutant dans d’autres services gérés dans le cloud ou s’y connectant.
Points forts
- De nombreuses organisations savent déjà comment connecter leurs charges de travail à d’autres services gérés par des fournisseurs de cloud (par exemple, des bases de données, des espaces de stockage d’objets, etc.).
- La charge opérationnelle et infrastructurelle liée à l’exécution et à la mise à l’échelle des modèles incombe principalement au fournisseur de services cloud.
- Les problèmes de latence et certaines préoccupations liées à la confidentialité des données peuvent être plus faciles à résoudre.
Défis
- Les applications multicloud/hybrides nécessitent des efforts supplémentaires pour être connectées et sécurisées.
- Le manque d’uniformité entre les services gérés dans le cloud et les API peut entraîner une dépendance vis-à-vis d’un fournisseur.
- Les organisations qui ne disposent pas d’une présence étendue dans le cloud public peuvent rencontrer des difficultés.
- À grande échelle, les coûts d’exploitation peuvent être plus élevés qu’avec les modèles auto-hébergés.
- L’hébergement de modèles personnalisés et les services de personnalisation de modèles peuvent ne pas être pris en charge.
Modèle autogéré
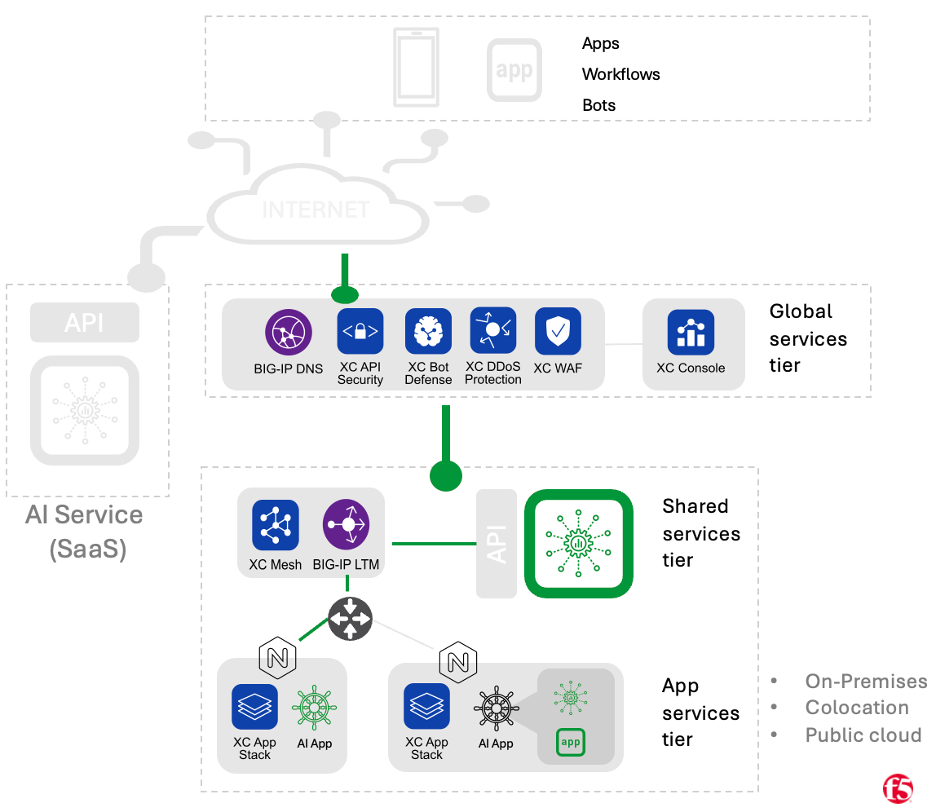
Pour le modèle autogéré, nous aborderons d’abord le cas où l’inférence des modèles d’IA est exécutée sous la forme d’un « service partagé » centralisé, puis nous examinerons le cas où aucun service centralisé n’existe et où les préoccupations opérationnelles sont laissées à la charge de chaque équipe applicative.
Service partagé autogéré
Dans la variante « service partagé » du modèle autogéré, une organisation peut disposer d’une ou de plusieurs équipes dédiées chargées de la maintenance de l’infrastructure d’inférence, des modèles qui y sont exécutés, des API utilisées pour s’y connecter, ainsi que de tous les aspects opérationnels du cycle de vie du service d’inférence. Comme pour les autres modèles, les charges de travail des applications d’IA consomment les services d’inférence au moyen d’appels d’API. L’infrastructure de mise à disposition des modèles peut être exécutée dans des centres de données privés, dans un cloud public ou dans un centre de colocation. Les équipes chargées d’exploiter le service d’inférence peuvent tirer parti de plateformes de machine learning auto-hébergées, telles qu’Anyscale Ray ou MLFlow. Elles peuvent également s’appuyer sur des outils de mise à disposition de modèles d’inférence plus spécialisés, comme le serveur Text Generation Inference de Hugging Face, ou sur des logiciels développés en interne. Avec l’inférence autogérée, les organisations sont limitées aux modèles qu’elles ont elles-mêmes entraînés ou qui peuvent être exécutés localement. Les modèles propriétaires proposés par un service SaaS peuvent donc ne pas être disponibles.
Particulièrement adapté à
- Organisations matures disposant d’une vaste expérience en gestion d’infrastructures.
- Organisations ayant d’importants besoins en inférence qui justifient le coût total de possession d’un service autogéré.
- Applications soumises aux exigences les plus strictes en matière de confidentialité des données et de conformité.
Points forts
- Les organisations contrôlent entièrement tous les aspects du service d’inférence.
- Les problématiques liées à la confidentialité des données sont généralement plus faciles à résoudre avec des modèles auto-hébergés.
- À grande échelle, les coûts peuvent être plus avantageux que ceux des services d’inférence gérés dans le cloud ou basés sur le SaaS.
Défis
- Les organisations contrôlent entièrement tous les aspects du service d’inférence (des investissements importants dans l’infrastructure et les ressources humaines seront probablement nécessaires, auxquels s’ajouteront des enjeux permanents de maintenance, de développement et de mise à l’échelle).
- Généralement peu rentable pour les organisations ayant des besoins minimes en matière d’inférence et peu de préoccupations concernant la confidentialité des données.
- Aucun accès aux modèles fermés ou propriétaires éventuellement disponibles sous forme de SaaS ou de services gérés dans le cloud.
Autogéré, et non un service partagé
L’autre variante du modèle autogéré concerne les organisations qui ne disposent pas d’une équipe centrale chargée d’exploiter des services d’inférence d’IA destinés aux applications. Dans cette configuration, chaque équipe applicative peut exécuter ses modèles sur l’infrastructure qui lui a été allouée pour la charge de travail de l’application. Elle peut choisir d’accéder à ces modèles via une API ou de les utiliser directement en mode « hors ligne ». Ce modèle peut permettre aux développeurs de bénéficier, à plus petite échelle, de certains des avantages du modèle autogéré de type « service partagé ».
Particulièrement adapté à
- Applications nécessitant un traitement par lots et une inférence hors ligne.
- Organisations ayant une très faible consommation en matière d’inférence, mais des exigences strictes en matière de confidentialité des données et de conformité.
Points forts
- La solution la plus flexible pour les développeurs d’applications, offrant un large éventail de possibilités d’intégration aux charges de travail.
- Permet d’atteindre les objectifs de confidentialité des données et de latence à petite échelle.
- Peut s’avérer plus rentable que les autres modèles évoqués dans certains cas (par exemple, pour une seule équipe ayant des besoins de consommation élevés).
Défis
- La charge opérationnelle liée au cycle de vie du modèle incombe à chaque équipe applicative.
- Ne permet pas de tirer parti des économies d’échelle à mesure que la consommation d’inférence d’IA de l’organisation augmente (manque de cohérence, utilisation inefficace des ressources, etc.)
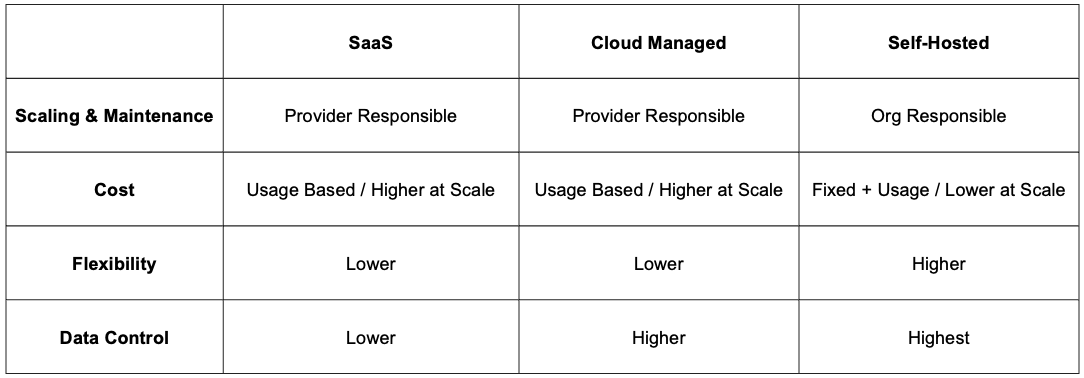
Résumé des compromis entre les modèles
Sécuriser les applications d’IA et les services d’inférence de modèles
Fondamentalement, les applications d’IA ressemblent beaucoup à n’importe quelle autre application moderne. Elles combinent des composants destinés aux utilisateurs et des composants backend, s’appuient souvent sur des magasins de données externes, font un usage intensif des appels d’API, etc. Ces applications héritent des mêmes enjeux de sécurité que toutes les applications modernes et nécessitent les mêmes protections, mises en œuvre de la même manière (par exemple, AuthNZ, protections contre les attaques DDoS, WAF, pratiques de développement sécurisé, etc.). Toutefois, les applications d’IA, en particulier celles qui exploitent l’IA générative, présentent également un certain nombre de risques spécifiques qui ne concernent pas nécessairement les autres applications (voir, par exemple, le Top 10 de l’OWASP pour les LLM). Le caractère généralement imprévisible de ces modèles peut engendrer des problèmes inédits, en particulier dans les cas d’usage où une grande autonomie leur est accordée.
Heureusement, compte tenu de la forte dépendance des modèles évoqués ci-dessus aux interactions pilotées par API avec l’inférence des modèles d’IA, de nombreuses organisations sont déjà bien placées pour mettre en œuvre ces nouvelles mesures de sécurité. Par exemple, une passerelle API assurant les fonctions classiques de limitation du débit, d’authentification, d’autorisation et de gestion du trafic pourrait être étendue afin de prendre en charge des limites basées sur le nombre de jetons et ainsi contribuer à la maîtrise des coûts (soit en sortie, au niveau de l’application, vers un service géré par un fournisseur ou proposé en mode SaaS, soit en entrée, au moyen d’une autorisation RBAC servant de protection en amont d’un service d’inférence autogéré). De même, une infrastructure assurant actuellement des fonctions classiques de pare-feu d’applications web (WAF), telles que la détection des injections SQL ou des attaques XSS, pourrait constituer un emplacement logique pour ajouter des protections contre l’injection de prompts et les attaques similaires. La plupart des pratiques modernes d’observabilité s’appliquent directement aux cas d’usage propres à l’inférence d’IA pilotée par API, et les équipes devraient pouvoir tirer pleinement parti des outils et pratiques déjà en place dans ce domaine.
Conclusion
Si l’engouement autour des applications basées sur l’IA et des services d’inférence est certes récent, les principes fondamentaux qui régissent leur déploiement et leur sécurisation existent depuis longtemps. Les organisations devront évaluer les compromis afin de déterminer la meilleure façon d’exploiter les capacités de l’IA, comme elles le font pour toute autre technologie, en fonction de leurs cas d’usage spécifiques, des ressources disponibles et de leurs objectifs à long terme. De même, bien que les cas d’usage de l’IA — et en particulier de l’IA générative — présentent certains défis de sécurité inédits, les besoins qu’ils partagent avec d’autres applications modernes et leur forte dépendance aux interactions avec les modèles via des API offrent une excellente occasion de réutiliser et d’étendre les modèles d’architecture, les pratiques et les outils existants. Qu’il s’agisse d’une solution auto-hébergée ou d’un service géré, il est essentiel de veiller à ce que les développeurs aient accès à une solution sécurisée, évolutive et performante, répondant aux besoins spécifiques de votre entreprise, afin de maximiser la valeur et l’impact de vos investissements dans l’IA.
À propos de l’auteur
Articles de blog associés
Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.