Cet article de blog est le troisième d’une série consacrée à la fourniture de données pour l’IA.
L’IA générative peut sembler fonctionner sans effort en apparence. Pourtant, derrière chaque modèle performant se cache un pipeline de données aussi complexe et sensible qu’une raffinerie industrielle.
Les dirigeants du secteur de l’IA soulignent régulièrement que le principal obstacle au déploiement de l’IA à grande échelle ne réside pas dans les modèles, mais dans les flux de données qui les alimentent. McKinsey & Company estime que la demande des entreprises en infrastructures de données adaptées à l’IA augmente de plus de 30 % par an, tandis que les besoins en données des environnements d’entraînement des modèles progressent encore plus rapidement. Ainsi, lorsque ces pipelines connaissent des défaillances, même les GPU les plus avancés restent inutilisés.
Une brève analogie permet de mieux cerner le défi.
“Imaginez un pipeline de données d’IA comme une chaîne de production moderne. Les matières premières (les données de l’entreprise) doivent être collectées, contrôlées et préparées correctement avant d’entrer dans la chaîne.”
Elles sont ensuite affinées au fil d’une série d’étapes de précision — nettoyage, étiquetage, conversion et validation — afin de répondre à des normes de qualité strictes. Enfin, les composants finis doivent être acheminés efficacement vers les bons postes de production, au bon moment. Si une phase manque de cohérence, prend du retard ou est mal coordonnée, toute l’opération s’engorge, tout comme une chaîne de montage s’arrête lorsqu’un seul poste de travail connaît une défaillance.
Tout comme les matières premières doivent être collectées, transformées et acheminées jusqu’au poste de production, les données d’entreprise doivent passer par des étapes d’ingestion, de transformation et de mise à disposition avant de pouvoir servir à l’entraînement ou à l’ajustement fin des modèles, ou être utilisées pour la génération augmentée par récupération (RAG). Si l’une de ces étapes est compromise ou retardée, l’ensemble du système d’IA s’en trouve fragilisé, ce qui nuit à l’entreprise et réduit le retour sur investissement.
Cet article examine ces trois étapes et explique comment F5 BIG-IP et le stockage objet compatible S3 prennent en charge les workflows de création de modèles sur lesquels les entreprises s’appuient aujourd’hui.
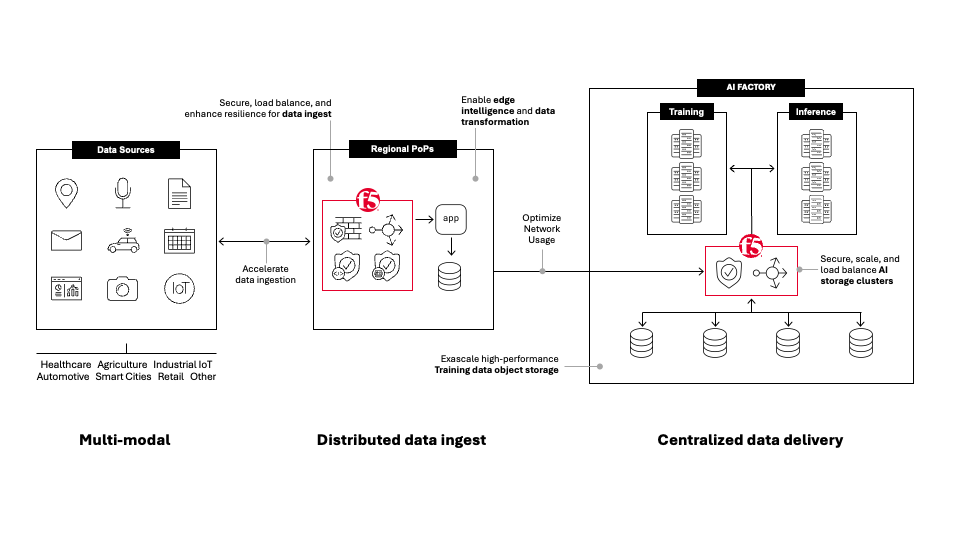
Phase 1 : ingestion — collecte et consolidation des données brutes
L’ingestion correspond au moment où les données entrent dans l’écosystème de l’IA. Les entreprises disposent rarement d’une source unique de vérité : leurs « matières premières » sont réparties entre les systèmes des différents services, les services cloud, les espaces de stockage d’objets, les outils SaaS, les journaux, les API et même les données externes de tiers. Une grande partie de ces données arrive dans des formats différents, à des fréquences variables et avec des niveaux d’intégrité inégaux.
Au cours de cette phase, les données doivent être identifiées, authentifiées, normalisées et validées à mesure qu’elles sont acheminées vers des magasins d’objets centralisés ou distribués. Des métadonnées leur sont associées, les schémas sont mis en correspondance et de premiers contrôles qualité sont effectués. Si l’ingestion est négligée, le reste du pipeline en subit les conséquences. La dérive des modèles — c’est-à-dire leur dégradation au fil du temps —, les hallucinations et l’instabilité des tâches d’entraînement trouvent souvent leur origine dans une ingestion incohérente ou mal gouvernée.
C’est également à ce stade que la fragilité des connexions devient une véritable préoccupation. Dans de nombreux environnements fortement distribués, les connexions persistantes aux systèmes distants sont interrompues de manière inattendue. Sans mesures de protection adéquates, ces défaillances laissent des sessions abandonnées ouvertes dans l’environnement de stockage objet, épuisant progressivement les ressources et nuisant à la fiabilité de l’environnement.
F5 BIG-IP assure ici la stabilité en gérant ces connexions, en évitant une consommation incontrôlée des ressources et en garantissant que les transferts de données s’achèvent de manière prévisible, même lorsque le réseau à la source est peu fiable. Les atouts reconnus de BIG-IP — authentification intégrée (notamment la validation des jetons, l’intégration des identités et le TLS mutuel), gestion du trafic, protection des API et défense contre les attaques DDoS — protègent également les données sensibles importées dans l’organisation.
Grâce à ces garde-fous, les données parviennent de manière fiable aux systèmes de stockage compatibles avec S3 qui alimentent l’étape suivante.
Phase 2 : Transformation — affiner les données pour les rendre exploitables par le modèle
Si l’ingestion charge la matière première, la transformation est la raffinerie qui la convertit en ressources de données de haute qualité, prêtes à être utilisées par les modèles. Le travail réalisé à ce stade est bien plus complexe que ne le pensent de nombreuses équipes, et un nombre étonnant de projets d’IA échouent à cette étape. Les environnements de production de modèles reposent sur des données cohérentes et bien gouvernées ; lorsque celles-ci sont bruitées, incohérentes, mal formatées ou mal étiquetées, l’entraînement devient instable et la qualité des modèles diminue.
La transformation consiste à nettoyer, convertir et préparer les données afin qu’elles puissent être utilisées pour l’entraînement ou l’ajustement de modèles, ou encore pour la génération augmentée par récupération (RAG).
Les documents et les fichiers PDF sont convertis en texte structuré ou en représentations vectorielles. Les images et les journaux sont analysés et convertis dans des formats standard. Les valeurs manquantes sont corrigées. Les informations sensibles sont masquées ou chiffrées. La traçabilité est consignée afin que les autorités de réglementation puissent déterminer comment des ressources spécifiques ont été produites ou modifiées. Dans les pipelines RAG, c’est également à cette étape qu’interviennent la stratégie de segmentation, la génération des représentations vectorielles et la mise à jour des index.
Traditionnellement, la transformation s’effectuait au sein d’un environnement centralisé, mais ce modèle est en train d’évoluer. Face à l’explosion des volumes de données, il devient de plus en plus pertinent d’effectuer une partie de la transformation en périphérie ou à proximité des sources de données.
F5 BIG-IP permet d’enrichir et d’affiner les données de manière distribuée grâce à des formats flexibles pouvant être déployés au plus près de leurs sources. Associé à un stockage objet flexible compatible S3 déployé en périphérie, il permet aux entreprises de filtrer et d’affiner les données avant de les renvoyer vers le pipeline central. Cela réduit les coûts liés au trafic et limite le risque de transférer du contenu inutile ou non conforme.
Une fois la transformation terminée, l’organisation dispose de ressources propres, fiables et sécurisées, prêtes à être utilisées par les systèmes de calcul en aval.
Phase 3 : livraison — acheminer les données optimisées vers les ressources de calcul appropriées au bon moment
La livraison est l’étape où les données affinées sont mises à disposition des clusters de GPU, des tâches d’ajustement fin, des bases de données vectorielles ou des pipelines RAG qui en dépendent.
La qualité de la mise à disposition des données se fait immédiatement sentir par les utilisateurs et les équipes d’exploitation. Si les données arrivent trop lentement, les GPU sont sous-alimentés. Si le routage est inefficace, les tâches restent en attente plus longtemps que prévu. Si les contrôles d’accès sont insuffisants, des jeux de données sensibles risquent d’être exposés.
Une étape de mise à disposition bien conçue garantit un transfert rapide et régulier des données entre le stockage et les ressources de calcul. Des voies d’accès à haut débit permettent aux tâches d’entraînement distribué de lire en parallèle les données stockées dans un stockage objet. Une mise en cache intelligente améliore les performances.
Les workflows automatisés planifient les entraînements, adaptent les ressources et acheminent les requêtes de recherche sémantique. Les outils de supervision suivent la latence, le débit et les anomalies de performance.
La sécurité reste ici un enjeu crucial. Les accès doivent être contrôlés au moment de l’utilisation, et pas seulement lors de l’ingestion, afin de garantir que chaque jeu de données n’est accessible qu’aux modèles, tâches ou utilisateurs autorisés.
F5 BIG-IP prend en charge cette approche en appliquant les politiques, en validant les jetons et en surveillant les schémas de requêtes. Il optimise également la répartition du trafic afin que les données soient acheminées vers les ressources de calcul aussi efficacement que possible.
Associées à un stockage évolutif compatible avec S3, ces fonctionnalités créent un environnement qui alimente en continu les tâches d’entraînement et d’ajustement fin, réduisant ainsi les temps d’inactivité des GPU et garantissant des performances prévisibles.
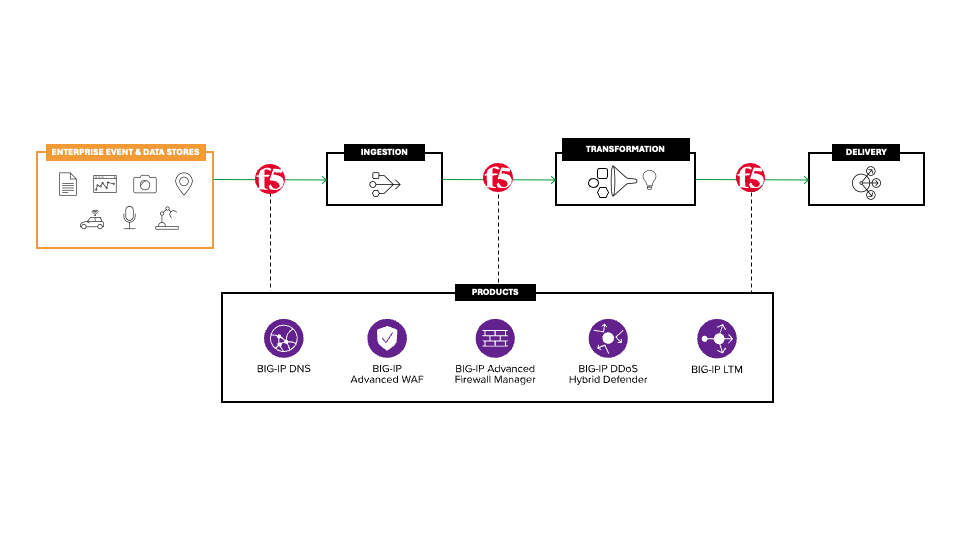
Comment les trois étapes s’articulent
Bien que l’ingestion, la transformation et la livraison soient des processus distincts, elles fonctionnent selon un cycle continu.
L’ingestion garantit que des données récentes et gouvernées provenant de l’ensemble de l’entreprise entrent dans le système. La transformation affine ces données pour en faire des ressources de haute qualité adaptées à l’entraînement, à l’indexation RAG ou à l’ajustement fin. La livraison achemine ces ressources vers les ressources de calcul appropriées, rapidement et sans en altérer l’intégrité.
Toute faiblesse dans l’un de ces domaines ralentit l’ensemble des opérations. En outre, les défaillances des pipelines sont omniprésentes. Globalement, selon plusieurs sources, plus de 80 % des projets d’IA en entreprise échouent. Nombre d’entre elles indiquent également qu’au moins 70 à 80 % de ces échecs sont imputables à des données de mauvaise qualité ou de qualité insuffisante.
Mais lorsque le pipeline fonctionne de manière fluide de bout en bout, grâce à des services réseau sécurisés et résilients tels que BIG-IP et à un stockage évolutif compatible S3, les entreprises peuvent accélérer l’entraînement, affiner leurs modèles avec davantage de confiance et exploiter des environnements de fonderie de modèles à l’échelle industrielle.
F5 fournit et sécurise les applications d’IA partout
Pour en savoir plus sur nos solutions de fourniture de données pour l’IA, consultez notre page consacrée aux solutions de fourniture de données et d’infrastructure pour l’IA .
L’engagement de F5 en faveur de l’IA ne se limite pas à la fourniture de données. Découvrez comment F5 sécurise et distribue les applications d’IA partout.
N’oubliez pas de consulter les autres articles de blog de notre série consacrée à la distribution des données pour l’IA :
Alimenter le pipeline de données d’IA avec F5 et un stockage compatible S3
Optimiser l’IA en éliminant les goulots d’étranglement des charges de travail modernes
Pourquoi le stockage pour l’IA exige une nouvelle approche de l’équilibrage de charge
Bonnes pratiques pour optimiser l’infrastructure d’IA à grande échelle
Déployer des applications d’IA à grande échelle : le rôle des ADC
Sécurisez votre pipeline de données d’IA sans le ralentir
À propos des auteurs
Mark Menger est architecte de solutions chez F5, où il est spécialisé dans les partenariats technologiques liés à l’IA et à la sécurité. Il dirige le développement de l’architecture de référence de F5 pour l’IA, contribuant ainsi à faire progresser des solutions d’IA sécurisées et évolutives. Fort de son expérience en tant qu’architecte de solutions globales et ingénieur solutions, Mark a participé à l’élaboration de l’architecture cloud sécurisée de F5 et au codéveloppement de son architecture distribuée à quatre niveaux. Coauteur de Solving IT Complexity, il met son expertise au service de la résolution des défis informatiques. Auparavant, il a occupé des postes de développeur d’applications et d’architecte d’entreprise, en se concentrant sur les applications modernes, l’automatisation et l’accélération de la création de valeur issue des investissements dans l’IA.
Autres articles de Mark MengerArticles de blog associés
IA et cybersécurité
Découvrez comment l’IA et la cybersécurité fonctionnent de concert. Découvrez comment l’IA et le machine learning (ML) permettent à votre entreprise de rester sécurisée, efficace et prête à innover avec F5.

Suivre le rythme de l’innovation de pointe ne suffit pas à faire avancer l’entreprise : se préparer à la réglementation de l’IA
À mesure que la réglementation de l’IA évolue, réfléchissez aux mesures de protection que vous pouvez mettre en place dès maintenant.
Les contrôleurs de mise à disposition d’applications reviennent au cœur des priorités stratégiques
L’IA rebat les cartes de la livraison d’applications. Nirav Shah de F5 revient sur la nouvelle étude de Gartner® consacrée aux ADC et explique ce qu’elle implique pour les décisions des entreprises en matière d’infrastructure.
Ce que nos clients nous disent sur l’IA, le multicloud hybride et la sécurité des applications
Le nouveau vice-président senior du marketing produit de F5 explique les pressions liées à l’IA auxquelles sont confrontés les dirigeants d’entreprise et ce dont ils ont besoin pour renforcer leur organisation.

Cinq niveaux de cyberrésilience antifragile transforment les pratiques en résultats
Découvrez comment cinq niveaux de résilience antifragile transforment les perturbations en comportements adaptatifs qui limitent les défaillances et renforcent l’architecture multicloud hybride.

Optimiser les pipelines d’IA en éliminant les goulets d’étranglement dans les charges de travail modernes
À mesure que les charges de travail d’IA montent en puissance, les entreprises constatent des ralentissements provenant du pipeline de données en amont qui alimente le modèle d’IA. Voici comment F5 BIG-IP peut les aider.