
F5とIBMで構築するエンタープライズクラウド
はじめに
一部の推計によると、プライベートクラウドとも呼ばれるエンタープライズクラウドは、パブリッククラウドを上回るペースで導入が進んでいます。企業向けコンサルティング会社のAccentureは、2011年末までに企業におけるプライベートクラウドの普及率が77%に達すると予測しています。1 アジャイルなオンサイトインフラストラクチャの構築に向けたこの急速な動きの主な背景には、企業規模を問わず、IT部門がインフラストラクチャとデータの両方を社内で制御・管理する必要性があります。
クラウドインフラストラクチャの導入を決定した後、内部/プライベートクラウドと外部/パブリッククラウドのどちらを選ぶかは、コスト、リスク、価値の分析によって決まります。一般に、パブリッククラウドは柔軟性が高く、最大限のコスト削減が期待できますが、セキュリティ、サービスレベル契約(SLA)、可用性、管理に関するリスクを伴います。IT部門は低い初期コストでほぼ無制限の拡張性を活用できる一方、制御を手放すことになります。従来のオンサイトまたはホスティング型データセンターから外部のパブリッククラウドへ移行することは、基本的にデータセンター全体を他者の手に委ねるようなものです。
エンタープライズクラウドでは、IT部門が必要なレベルの制御を確保し、パブリッククラウドに伴うリスクを回避できます。一方、プライベートクラウドは導入コストが高く、スタッフにはより高度な知識と専門性が求められるうえ、オンプレミスのデータセンターがさらに複雑になります。エンタープライズクラウドインフラストラクチャは必要に応じて拡張でき、動的なプロビジョニングと俊敏性を実現しますが、こうした拡張性と制御性を得るには、多くの場合、初期コストが高くなります。
F5 Networks®とIBMは共同で、複雑さに伴う多くの課題を軽減するエンタープライズクラウド向けリファレンスアーキテクチャを設計しました。パブリッククラウドのアーキテクチャと拡張性を構成する多くの要素をオンプレミスに導入することで、社内システムを個別に構築するコストを大幅に削減します。必要なコンポーネントを事前に定義し、それらがどのように連携するかを明確にすることで、F5とIBMは、包括的で動的かつ俊敏なエンタープライズクラウドインフラストラクチャを構築しました。
ワークフロー
オンデマンドプロビジョニングシステムで最も重要な要素は、イベントに基づいて判断し、アクションを実行できることです。システム内のどこかでイベントが発生すると、アラートまたはメッセージが生成されます。そのメッセージは、メッセージバスをサブスクライブしているコンポーネント、またはAPI呼び出しによって直接リクエストを受けたコンポーネントによって取得され、処理されます。ワークフローとは、各コンポーネントがシステムメッセージに基づいて動作するプロセスと順序を指します。
エンタープライズクラウドでは通常、ワークフローは、リソースを要求または解放するプロビジョニングコンポーネントと、リソース割り当ての管理に必要な手順に分けられます。仮想マシン(VM)に追加のCPUリソースが必要になると、そのCPUリソースの調達元の決定、新しいVMの起動、IPアドレスの割り当てなどを行うワークフローが開始されます。
ワークフローアーキテクチャ
F5とIBMのエンタープライズクラウドアーキテクチャは、次の2つの重要な原則に基づいています。
- イベント通知メッセージの伝送には一元化されたメッセージバスが使用され、イベントに応じて動作する必要があるすべてのコンポーネントがこのバスに接続されています。
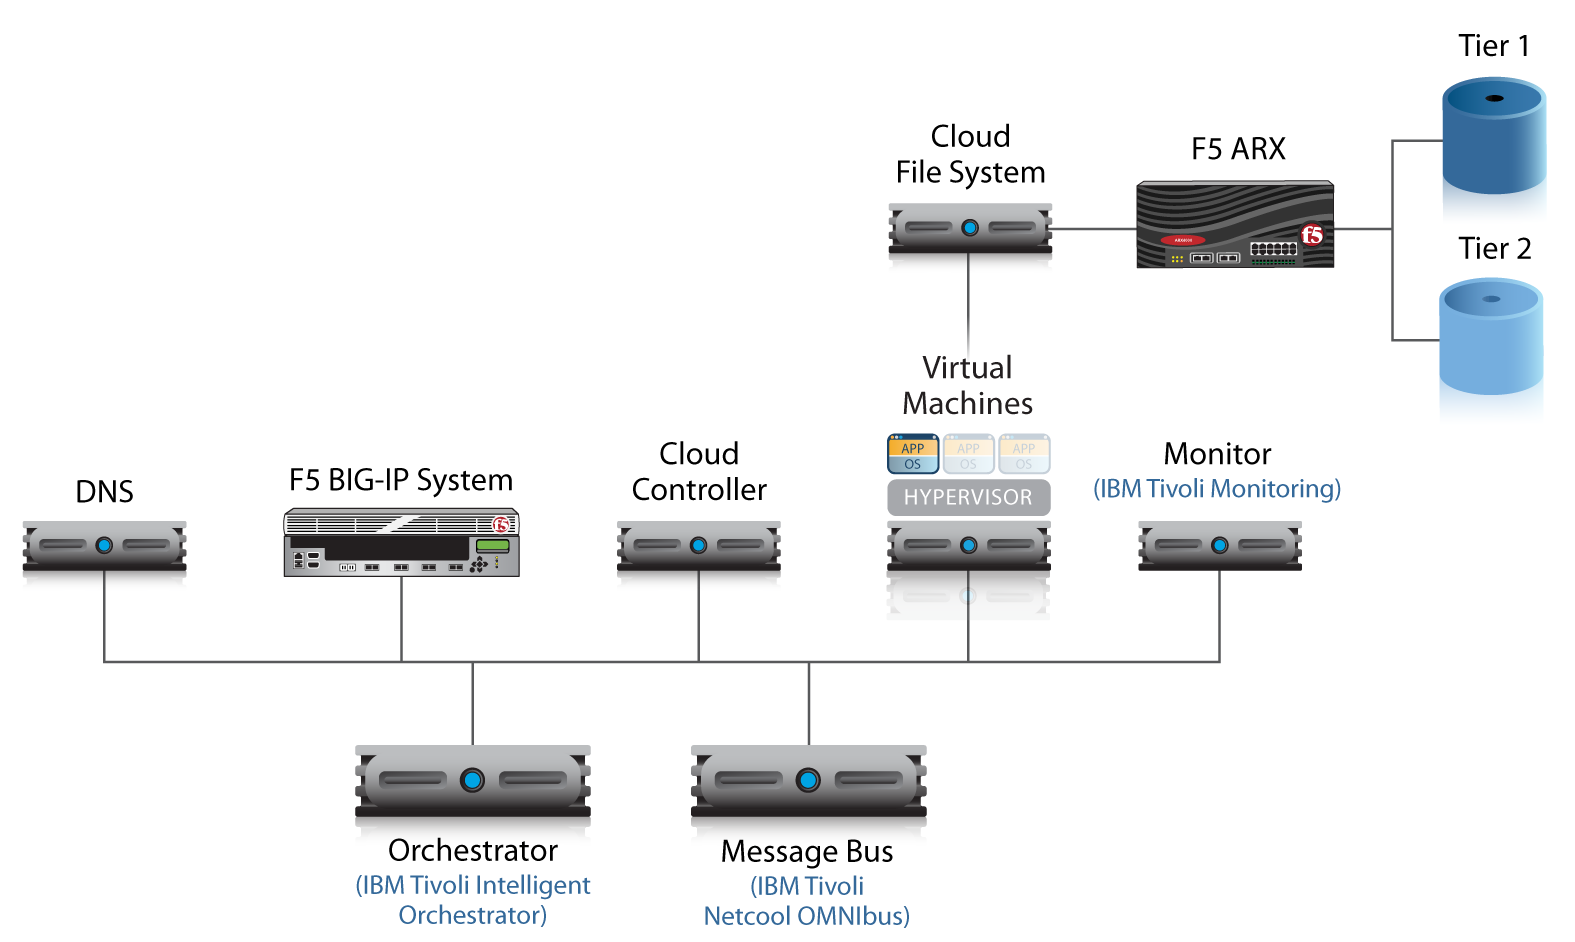
この2つの原則に加え、F5とIBMのリファレンスアーキテクチャは柔軟性が非常に高く、既存のあらゆるデータセンターやクラウドアーキテクチャに適合できます。たとえば、VMの導入を管理するオーケストレーションエンジンがすでに存在する場合、このリファレンスアーキテクチャを調整して、既存のエンジンを使用できます。エンタープライズクラウドの構築にはインフラストラクチャ全体の入れ替えが必要だと誤解されることがありますが、F5とIBMのソリューションは、可能な限りあらゆる段階で既存のコンポーネントと統合できるように設計されています。
ワークフローのコンポーネント
既存のコンポーネントか新規のコンポーネントかを問わず、エンタープライズクラウドのワークフローは、それぞれ特定のタスクを実行するコンポーネントで構成されます。クラウドシステム全体は、これらの個々のコンポーネントで構成され、各コンポーネントが連携することで、完全なクラウドインフラストラクチャを提供します。このインフラストラクチャは、クラウドイベントを管理する一連の連携タスクであるコンポーネントワークフローによって稼働し、制御されます。
メッセージバス
メッセージバスは、イベントやアラートに基づくメッセージを、影響を受ける各コンポーネントに伝達するシステムです。イベントによってメッセージが生成されると、そのメッセージはメッセージバスを介して特定のコンポーネントに送信されます。各コンポーネントには、受信したメッセージの処理方法を定めたルールがあります。また、メッセージバスは、特定のコンポーネント向けのルールに基づいてメッセージを正規化する役割も担います。
F5とIBMのリファレンスクラウドアーキテクチャでは、中央メッセージバスとしてIBM Tivoli Netcool OMNIbusソリューションを使用していますが、システム全体へのイベント通知の伝達には、任意のエンタープライズメッセージバスを使用できます。
オーケストレーター
オーケストレーターは、エンタープライズクラウドの頭脳に相当するコンポーネントです。バス経由で受信したメッセージに基づき、プロビジョニングに関する大局的な意思決定の大半を担います。また、「新しい仮想マシンのプロビジョニング」ワークフローの開始など、クラウドアーキテクチャにおける主要なイベントやワークフローを開始します。さらに、各ワークフローに必要なデータを取得し、該当するコンポーネントに提供する役割も担います。たとえば、新しいVMのプロビジョニングに必要なIPアドレス情報を提供します。
リファレンスアーキテクチャでは、バスからのメッセージを処理してワークフローイベントを開始する一連のインタープリタ型スクリプトを使用して、オーケストレーターを構築します。IBM Tivoli Intelligent Orchestrator、HP Operations Orchestration、VMware vCenter Orchestratorなど、任意の種類のオーケストレーターを使用できます。
クラウドコントローラー
クラウドコントローラーは、プロビジョニングプロセスの開始に必要な予備データの収集と集約を担うフロントエンドシステムです。この情報は、最初に作成プロセスの一環として管理者から提供され、プロビジョニングに使用するワークフローの種類ごとに異なります。たとえば、クラウドコントローラーは、VMの配置場所、アプリケーションの種類(Webサーバー、データベースサーバー、メールサーバーなど)、最小リソース要件などの情報を収集します。
自動プロビジョニングの実行時に、この予備データがすでにシステムに保存されている場合、オーケストレーターは既存の情報を要求して取得し、プロビジョニングワークフローの初期データとして使用します。クラウドコントローラーの例としては、Eucalyptus Cloud Controller、VMware vCloud Director、Amazon EC2などがあります。将来の成長や他のクラウドプラットフォームへの拡張を見据え、標準的なクラウドAPI群と統合または通信できるクラウドコントローラーを選択することを推奨します。これにより、エンタープライズクラウドプラットフォームを再設計することなく、クラウドコントローラーをパブリッククラウドプロバイダーやハイブリッドクラウドプロバイダーへ拡張できます。
クラスターコントローラー/ハイパーバイザー
クラスターコントローラーは、エンタープライズクラウドにおいて、プロビジョニング中の仮想マシンと、そのVMの実行に必要なストレージおよびメタデータを管理するコンポーネントです。VMの実行環境として、クラスターコントローラーには仮想プラットフォームのハイパーバイザーが含まれ、より大規模なハイパーバイザー管理環境が含まれる場合もあります。たとえば、クラスターコントローラーには、VMware ESXiのような最小構成のハイパーバイザーを使用する場合もあれば、VMware vSphereやVMware vCloudのような、より大規模な分散ハイパーバイザーシステム群を使用する場合もあります。
監視
ヘルスおよびステータスの監視は、あらゆるエンタープライズアプリケーションの導入に不可欠な要素です。また、監視により、仮想マシンが稼働し、ネットワーク上の接続に応答している場合など、プロビジョニングシステムにステータスの更新情報が提供されます。システムを継続的に監視することで、リアルタイムのアラートを生成できます。このアラートは最終的に新しいワークフローに取り込まれ、プロビジョニングの判断に影響を与えます。アプリケーションとネットワークのステータスを監視できるコンポーネントであれば、エンタープライズクラウド環境に導入できます。ただし、F5とIBMのリファレンスアーキテクチャでは、IBM Tivoli Monitoringソフトウェアを使用しています。
DNS
Domain Name System(DNS)は、F5とIBMのエンタープライズクラウド参照アーキテクチャにおいて重要な役割を果たします。IPv4およびIPv6のIPアドレスとドメイン名の情報だけでなく、クラウドコントローラーが収集した情報やマシン固有の識別情報などのシステムメタデータも格納します。この参照アーキテクチャでは、DNSが標準ベースのシステムであり、ほとんどのネットワークにすでに存在すること、すべてのクラウドコンポーネントから利用できること、インフラストラクチャにデータベース型のストレージを追加する必要性を軽減できることから、メタデータの格納先として採用されています。IT部門が管理し、ゾーンおよびゾーンファイルを追加できるDNSソリューションであれば、いずれも使用できます。
ストレージ
F5とIBMのリファレンスアーキテクチャでは、クラスタコントローラーはローカルストレージから仮想マシンを実行します。ただし、仮想マシンが実行されていない間、VMの仮想ディスクは仮想化ストレージ上にあります。ワークフローのプロビジョニングイベント中、クラスタコントローラーはNetwork File System(NFS)経由で仮想ストレージデバイスに仮想ディスクを要求します。
アプリケーションデリバリーコントローラー
エンタープライズクラウドを構成する最後のコンポーネントは、Application Delivery Controller(ロードバランサーとも呼ばれます)です。F5とIBMのリファレンスアーキテクチャでは、F5® BIG-IP® Local Traffic Manager™(LTM)がこれに該当します。BIG-IP LTMは、仮想マシンから送られるアプリケーションデータの接続、サービス、配信を管理します。最終的に、BIG-IP LTMは、ワークフローのプロビジョニングイベントに応じて動作するシステムの最終部分となります。
手順解説:手動および自動プロビジョニング
F5とIBMのエンタープライズクラウド参照アーキテクチャは、実環境でアプリケーションを動的にデプロイするための、リソースベースのプラットフォームを提供することを目的としています。すべてのコンポーネントを配置すると、各コンポーネントがさまざまなワークフローを通じて連携し、必要に応じて新しいアプリケーションサービスをプロビジョニングします。エンタープライズクラウドに配置されたシステムのプロビジョニング方法には、手動プロビジョニングと自動プロビジョニングの2つがあります。
手動プロビジョニング
通常、エンタープライズクラウドの最初のワークフローは、システム管理者またはアプリケーション申請者からの入力に基づく手動プロセスによって開始されます。ただし、ワークフロー自体が手動というわけではありません。手動で行うのは、システムに初めて情報を入力する作業だけです。管理者からデータを収集すると、システムはアプリケーションのプロビジョニングに向けて、事前定義された自動ワークフローイベントを開始します。
ステップ1:クラウドコントローラーへのデータ入力
クラウドコントローラーのGUIを使用して、管理者(新しいプロビジョニングイベントの開始を担当するユーザーによっては、アプリケーション申請者)が、新しい仮想マシンを起動してアプリケーションをオンラインにするために必要な情報を入力します。通常、これには次のような上位レベルのインフラストラクチャデータが含まれます。
- アプリケーションタイプ:Microsoft SharePoint、Webサーバー、メールサーバー、Oracleデータベースなど、利用可能なアプリケーションタイプの定義済みリスト。
- ネットワーク情報:クラスターIPアドレス、フロントエンドURL、このアプリケーションを外部公開するか内部専用にするかなど。
- プロビジョニング情報:ネットワークの場所(多くの場合、物理データセンターに関連付けられた地理的な参照情報。例:「Europe– Copenhagen Data Center」)や、特定のアプリケーションタイプで許可されるインスタンス数の最小値と最大値に関する制限など、プロビジョニングシステムに必要な追加情報。
この情報は、エンタープライズクラウド全体で自動プロビジョニングを行うためのメタデータとして使用されます。
ステップ2:プロビジョニングワークフローを開始し、メタデータを配布
管理者が必要なデータを送信すると、次にクラウドコントローラーは、その情報を、「vm12345」のように動的に生成され、プロビジョニング対象のインスタンスをシステム全体で識別するために使用される一意のインスタンスIDとともにパッケージ化し、メッセージバス経由でオーケストレーターに配信します。
最初のステップで提供されたすべての情報は、オーケストレーターに配信される前に、メッセージバスによって正規化されます。
同時に、クラウドコントローラーはAPIを介して同じメタデータと一意のインスタンスIDをハイパーバイザーに提供し、必要なアプリケーションイメージをデプロイするよう指示します。このイベントを受けて、ハイパーバイザーは該当する仮想マシンのディスクイメージをクラウドベースのストレージに要求します。ストレージデバイスはNFS経由で適切なディスクイメージを取得し、そのイメージのローカルストレージへのコピーを開始します。
ステップ3:オーケストレーターがメタデータを配布
オーケストレーターは、正規化されたイベント情報とメタデータをメッセージバスから受信すると、2つの異なるワークフローを開始し、監視システムとDNSにメタデータを同時に送信します。監視システムは、この情報を使用してアプリケーションの自動監視スケジュールを設定し、アプリケーションが稼働中であるという通知を受けた後、監視を開始します。このステップでは、オーケストレーターが監視システムのイベントに対するしきい値も定義します。たとえば、この仮想インスタンスのCPU使用率が75%を超えた場合にイベント通知を送信するよう、モニターに指示します。
オーケストレーターは、仮想インスタンスのメタデータもDNSに送信します。このデータは、エンタープライズクラウド全体で使用できるようにDNSに保存されます。オーケストレーターは、適切なDNSゾーン形式でメタデータを送信する役割を担うため、インスタンスIDに基づいてドメイン名を構成し、IPv4およびIPv6のDNSレコードを作成し、クラウドコントローラーから取得したインスタンス情報を追加したうえで、新しいインスタンス情報を適切なゾーンに追加する必要があります。たとえば、一意のインスタンスIDを使用して「vm12345.vm.cloud.example.com」のDNSエントリを作成し、既存のexample.comゾーンに追加します。
エンタープライズクラウド全体にメタデータを配布する最後のステップでは、ホスト名、IPアドレス、アプリケーションタイプ(またはBIG-IP LTM上のプール)、監視情報などの新しいインスタンス情報をBIG-IP LTM Application Delivery Controllerに登録します。
ステップ4:仮想マシンの通知
ステップ2では、クラウドコントローラーがハイパーバイザーに対し、新たにプロビジョニングされたインスタンスに関連付けられた仮想マシンを起動するよう指示しました。そのVMが想定どおりに稼働し、接続可能になると、メッセージバス上のイベントアラートを介してオーケストレーターに通知します。オーケストレーターはそのイベントアラートを受け取り、新しいVMをプール内で利用可能としてマークし、負荷分散方式に基づいて新しい接続を仮想インスタンスに送信、分散するようBIG-IP LTMに指示するワークフローを開始します。また、BIG-IP LTMは、アプリケーションプールに割り当てられた設定済みのアプリケーションモニターを使用して、新しいインスタンスの監視を開始します。
新たに稼働を開始したVMからのイベントアラートを受けると、オーケストレーターはエンタープライズクラウド全体の監視システムに通知し、仮想インスタンスの監視を開始するよう指示します。この時点で、新たにプロビジョニングされた仮想インスタンスはエンタープライズクラウド上で稼働し、アプリケーションサービスのリクエストを処理しています。これは、エンタープライズクラウドを構成するすべてのサービスの通常の動作モードです。
自動プロビジョニング
手動プロビジョニングは、エンタープライズクラウド内でサービスをプロビジョニングするワークフローの最初のステップですが、最も頻繁に行われるプロビジョニングではありません。システムが円滑に稼働している場合、エンタープライズクラウドは、より動的かつ柔軟な自己監視型システムへと移行し、必要性と需要に応じて新しいサービスを自動的にプロビジョニングします。このアジャイルなセルフプロビジョニングは、あらゆるクラウドプラットフォームの中核を成すものであり、リアルタイムのイベントを監視して対応するための自動プロビジョニングイベントとワークフローを追加する必要があります。
ステップ1:監視とアラート
あらゆる自動プロビジョニングシステムの最初のステップは、システム全体のイベントを収集して検出する監視です。初回の手動プロビジョニングでは、名前、場所、監視の種類、イベントのしきい値など、仮想インスタンスに関する情報を監視システムに登録します。この情報は、アプリケーションと仮想インスタンスの可用性およびパフォーマンスを自動的に監視するために使用されます。監視システムがイベント(たとえば、特定の仮想インスタンスによる使用可能なCPUリソースの75%超の消費)を検出すると、メッセージバス上にイベントを生成し、リソースが枯渇していることをオーケストレーターに通知します。
ステップ2:データ収集
一般的な自動プロビジョニングのシナリオでは、オーケストレーターが新しい仮想インスタンスを作成し、現在のインスタンスにかかるリソース負荷の軽減を図ります。2つ以上の仮想インスタンスを使用して、アプリケーションのコンピューティング負荷とネットワーク負荷を分散します。
自動プロビジョニングワークフローを開始するには、オーケストレーターがコンポーネントのイベントを収集するとともに、新しい仮想インスタンスのプロビジョニングに必要なメタデータを要求する必要があります。F5とIBMのリファレンスアーキテクチャでは、メタデータはDNSに保存され、最初の手動プロビジョニングワークフローの一環として登録されます。DNSは、アプリケーションタイプ、地理的位置、プロビジョニングのしきい値などの情報をオーケストレーターに返します。
ステップ3:ワークフローの開始
自動プロビジョニングワークフローの最終ステップでは、オーケストレーターがDNSから取得したメタデータを、メッセージバス経由でクラウドコントローラーに送信します。この自動化されたステップは、管理者がマシン情報を入力し、プロビジョニングワークフローを手動で開始する手順を実質的に再現するものです。クラウドコントローラーはこの情報を受け取り(手動プロビジョニングで管理者から受け取る場合と同様)、新しい仮想インスタンスのプロビジョニングワークフローを開始します。以降は、新しい仮想インスタンスが起動して稼働し、新しい接続を受け付けるようになるまで、前述のプロビジョニング手順とワークフローが繰り返されます。
一般的なエンタープライズクラウド環境では、手動と自動の両方のプロビジョニングワークフローを使用します。新しいサービスやアプリケーションは、管理者がサービスのデプロイ方法とデプロイ先を制御できるよう、最初は手動ワークフローを使用してデプロイします。サービスが稼働を開始すると、自動プロビジョニングワークフローがリソースの需要と可用性に基づいてプロビジョニングを管理します。
まとめ
プライベートエンタープライズクラウドの導入によって、複雑さが増したり、運用できなくなったりする事態は避けるべきです。クラウド導入の目的は、新しいサービスの構築を妨げる要因を減らし、より俊敏なコンピューティングインフラストラクチャを提供することにあります。エンタープライズクラウドは、その俊敏性をデータセンターにもたらし、管理性と制御性を大幅に向上させます。
F5はIBMと共同で、自動プロビジョニング型エンタープライズクラウドのリファレンスアーキテクチャを構築しました。このアーキテクチャはモジュール性と柔軟性を備えるよう設計されており、必要に応じて既存のコンポーネントを統合できるほか、APIと共有メッセージングインフラストラクチャを介して、エンタープライズクラウド全体を他のあらゆるクラウドプラットフォームに接続できます。プライベートエンタープライズクラウドはそれぞれ異なりますが、F5とIBMのアーキテクチャはさまざまな環境に適応し、あらゆるアプリケーション導入環境やデータセンターにアジャイルなインフラストラクチャのメリットをもたらします。
1 Babcock, Charles(2011年1月18日)。「Private Clouds Taking Off」Information Week。Web。
2012年1月10日公開