Toda grande mudança na arquitetura de aplicações força a rede a se adaptar. Essa não é uma ideia nova, muito menos revolucionária. Já vimos isso acontecer repetidas vezes. E, a cada vez, o mesmo padrão se repetiu. Surgiu um novo tipo dominante de aplicação, e “a rede” se adaptou para oferecer o suporte necessário, pois essas aplicações exigem recursos que a infraestrutura existente não consegue fornecer. É exatamente essa pressão que estamos observando agora com a inferência de IA.
Inferência não é treinamento. Não é experimentação. Não é um exercício de ciência de dados. A inferência é um comportamento de execução em produção e funciona como uma camada de aplicação. Ela tem usuários, padrões de tráfego, sensibilidade à latência, modos de falha, restrições de custo e riscos de segurança. Tratá-la como um serviço de backend ou uma carga de trabalho especializada não leva em conta o que realmente está acontecendo.
A inferência é um novo tipo de aplicação.
Nossa pesquisa anual deixa essa realidade evidente. Quase 80% das organizações operam a inferência por conta própria. Apenas uma pequena minoria depende exclusivamente de serviços públicos de IA. A maioria das organizações executa a inferência em seus próprios ambientes, em várias nuvens, juntamente com aplicações e APIs tradicionais. Elas já enfrentam problemas de roteamento, disponibilidade, desempenho e segurança durante a inferência.
Esse é o ponto principal. Os problemas surgem durante a inferência; não antes, nem depois e, certamente, não durante o treinamento.
As técnicas tradicionais de entrega não são suficientes neste caso. O balanceamento de carga pressupõe back-ends intercambiáveis. As verificações de integridade pressupõem disponibilidade binária. O direcionamento estático de tráfego pressupõe um comportamento previsível. Nenhuma dessas premissas se sustenta quando as solicitações variam em custo, qualidade, latência e risco com base em prompts, tokens e no comportamento do modelo.
Portanto, logo e, por conseguinte, “a rede” precisa mudar novamente.
A nova pilha de rede
Durante décadas, a pilha de rede foi descrita em termos de pacotes e protocolos. As camadas 2 e 3 processavam pacotes. As camadas 4 a 7 processavam sessões, protocolos e aplicações. Essa abordagem funcionava porque as aplicações expressavam intenção e finalidade por meio de protocolos. A inferência não.
A inferência expressa intenção e propósito por meio de prompts.
É por isso que agora estamos vendo o surgimento de uma nova camada dominante. A camada 8. A camada de prompts.
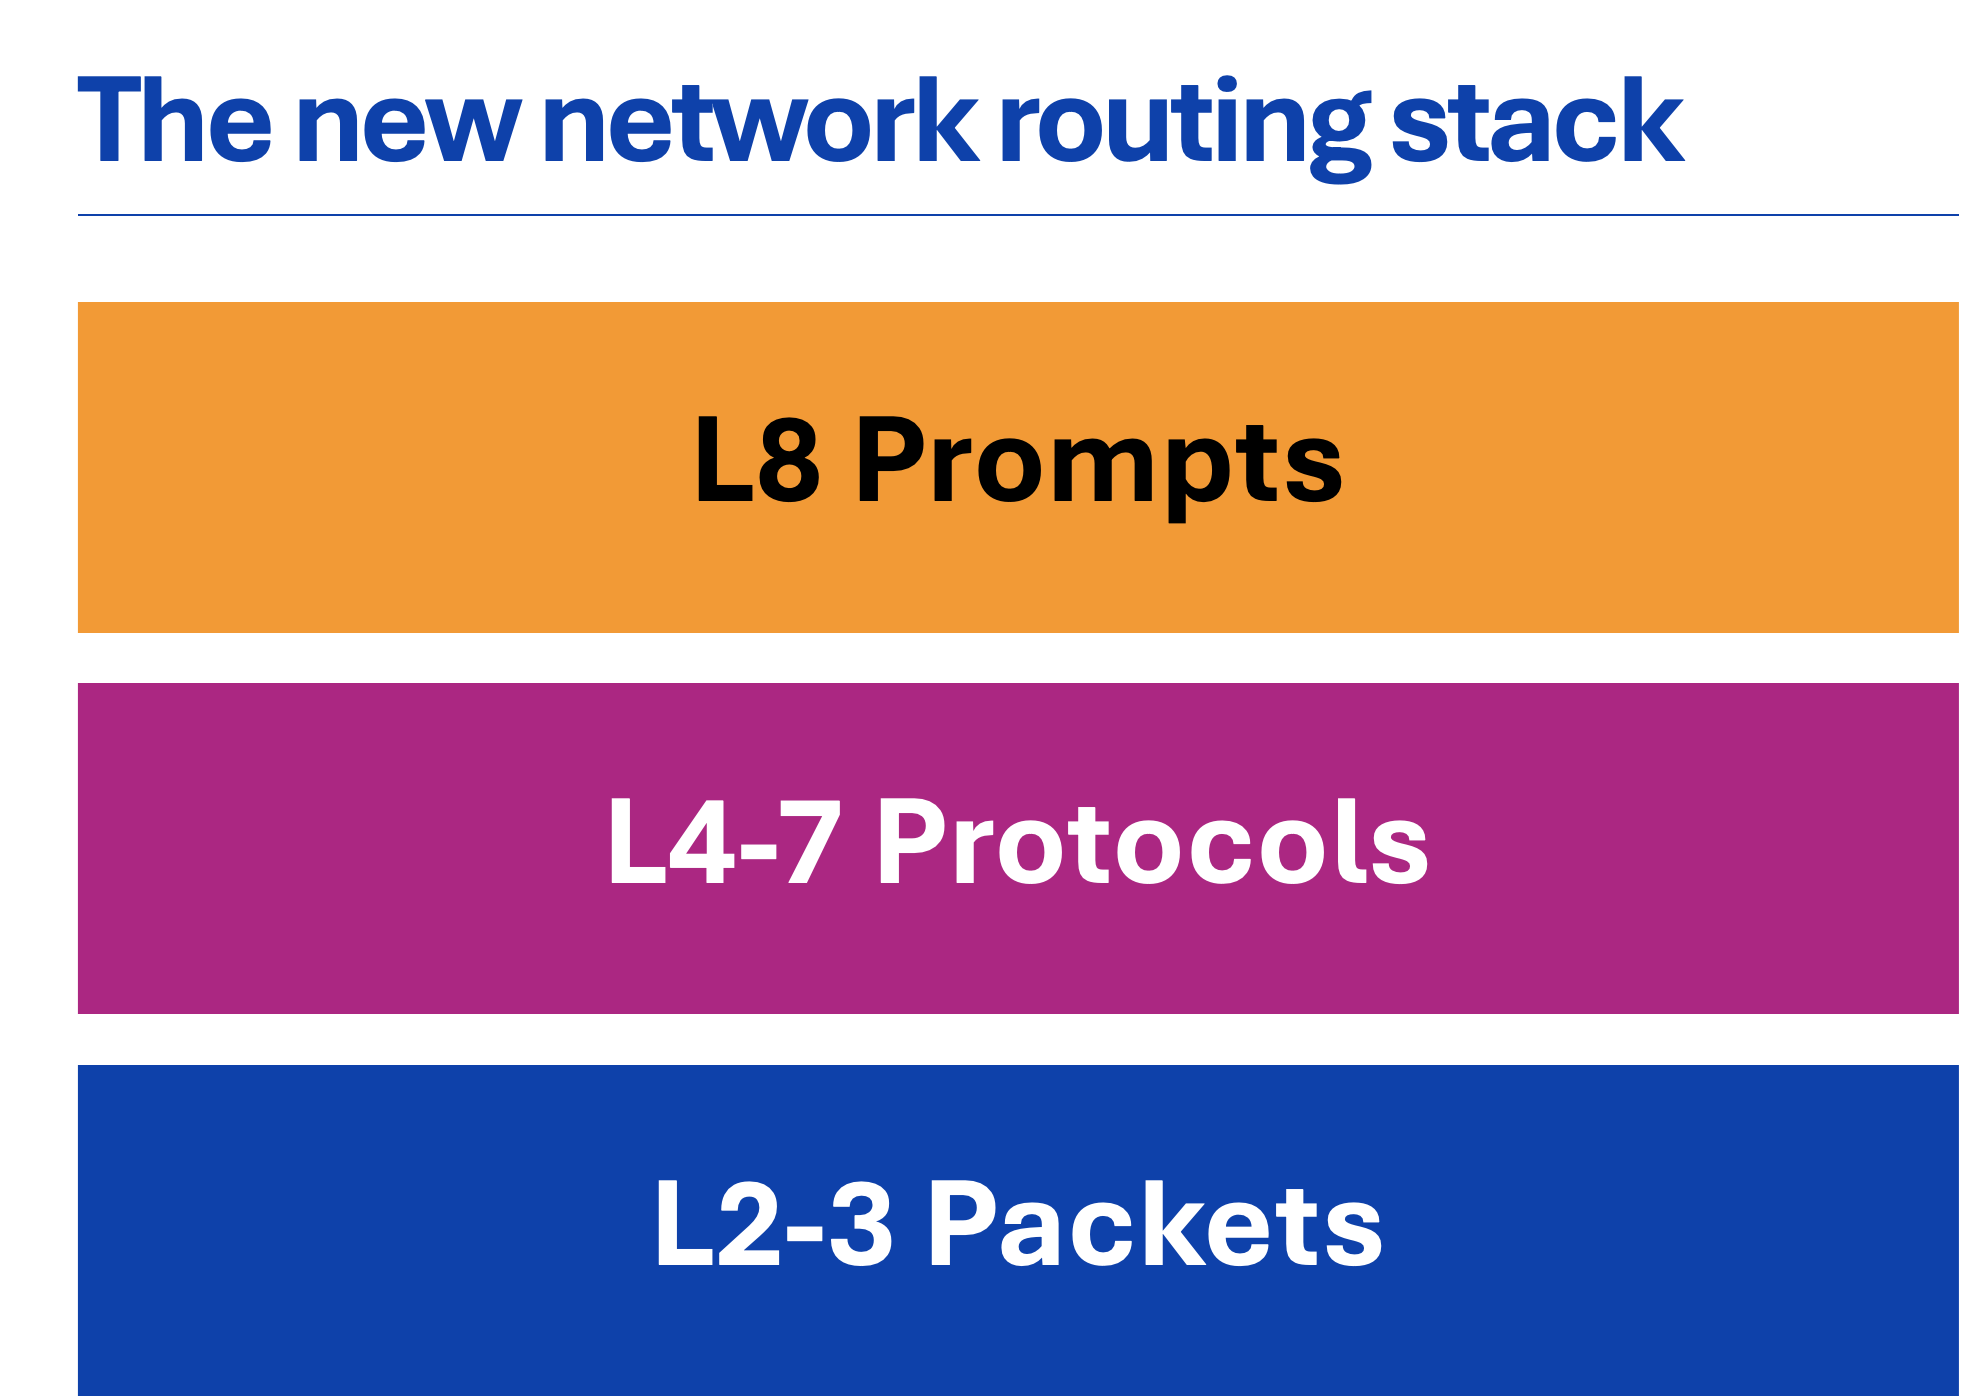
Mas espere um pouco, Lori, você deve estar pensando. Já faz muito tempo que fazemos o roteamento com base em partes do payload, então o que torna isso tão diferente?
Que bom que perguntou!
Na verdade, a diferença é bastante profunda, especialmente considerando que, na inferência, os URIs não correspondem a “funções” e que aquilo que está sendo invocado exige extrair a intenção do… prompt. É fundamentalmente por isso que o direcionamento de tráfego baseado em payload não chegou ao patamar de uma nova camada. Ele não mudou radicalmente o jogo. Inferência? Ah, a inferência não apenas muda o jogo, como também reescreve as regras regularmente.
Agora, o ponto principal é que, na “camada de prompt”, as decisões de roteamento não se baseiam mais apenas em IPs, portas, URIs ou mesmo em partes do payload. Elas se baseiam em quem está fazendo a solicitação, o que está sendo solicitado, quanto isso custa, qual é o nível de risco e qual qualidade de resultado é necessária. Juntamente com a moderação de saída e o controle de tokens, essa camada da pilha foi identificada por nossa pesquisa mais recente como aquela em que a entrega e a segurança de aplicações têm o maior impacto. Acrescente o roteamento de modelos (também na camada 8) e teremos a maioria das organizações já reconhecendo a importância dessa camada para proteger e escalar a inferência de IA.
A inspeção de prompts, o controle de tokens, a moderação de resultados e o roteamento de modelos não são recursos opcionais. Eles são requisitos básicos para operar inferência em produção.
Não se preocupe: as camadas abaixo dela não desaparecem, assim como as camadas L2-3 não desapareceram quando as L4-7 passaram a ocupar o topo da pilha. Elas simplesmente se tornam a base. O roteamento de pacotes continua sendo importante. O tratamento de protocolos também.
Mas não se engane: o valor agora está na camada 8.
A resposta à inferência confirma a mudança
Os controladores de entrega de aplicações surgiram porque as redes criadas para pacotes não conseguiam oferecer suporte a aplicações. Os gateways de API surgiram porque as redes criadas para aplicações web não conseguiam oferecer suporte a APIs. O suporte à inferência está surgindo agora porque as redes criadas para APIs não conseguem oferecer suporte a aplicações autônomas, probabilísticas e com custos variáveis.
A resposta do mercado confirma essa mudança. Startups estão surgindo em torno do roteamento de modelos, gateways de inferência, governança de tokens e controle de prompts. Os hiperescaladores estão desenvolvendo discretamente os mesmos recursos internamente.
A resposta das empresas confirma essa mudança. Noventa por cento das organizações utilizam serviços de inferência, e 70% delas usam dois ou mais serviços de inferência diferentes, inclusive serviços próprios. Elas estão implementando estratégias multimodelo, experimentando a IA agêntica e adotando a automação orientada por IA nas operações.
Isso não é exagero. É uma mudança estrutural.
A inferência não é apenas mais uma carga de trabalho. As arquiteturas que permanecerem ancoradas em pacotes e protocolos continuarão funcionando, mas não conseguirão escalar com eficiência. As pilhas de rede que se limitarem às APIs terão dificuldade para controlar sistemas autônomos.
A inferência deslocou o ponto de controle para as camadas superiores da pilha. O restante é inevitável.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog
Por que o roteamento de modelos pode se tornar uma infraestrutura de segurança
A IA agêntica expõe os limites da identidade. Modelos especializados, combinados com roteamento baseado em políticas, vinculam a autoridade à escolha do modelo, reduzindo o raio de impacto e a complexidade da governança.
Top 10 em entrega de aplicações de IA: incapacidade de lidar com a latência
A IA transforma a latência em um problema de confiança, não apenas de desempenho: respostas lentas do “assistente” parecem hesitação ou falha, e prompts e respostas com muitos tokens aumentam a carga de trabalho mesmo em sistemas funcionando normalmente.
As 10 principais ameaças à entrega de aplicações de IA: observabilidade incompleta
A IA não escala sozinha. Sem um plano de controle unificado que elimine as barreiras entre ferramentas e responsabilidades, a inferência se torna a camada mais frágil e que mais exige coordenação.
Habilidades de agentes: um padrão aberto emergente
As skills declaram intenção, mas não impõem controle. A segurança de verdade deve estar nos limites das ferramentas, onde os pensamentos dos agentes se transformam em ações e as políticas podem ser aplicadas.
De pacotes a prompts: a inferência adiciona uma nova camada à pilha
Inferência não é treinamento. Não é experimentação. Não é um exercício de ciência de dados. Inferência é um comportamento de execução em produção e funciona como uma camada de aplicação.

A influência da inferência: APIs, DPUs e o caos do contexto
A inferência de IA está remodelando a infraestrutura, multiplicando APIs, sobrecarregando a capacidade computacional e tornando o contexto mais complexo. Saiba por que uma arquitetura mais inteligente e políticas de execução são essenciais.