Editor – Esta série de sete artigos está agora completa:
- Introdução aos microsserviços
- Criando microsserviços: usando um gateway de API
- Construindo microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços (este artigo)
- Gerenciamento de dados orientado a eventos para microsserviços
- Escolhendo uma estratégia de implantação de microsserviços
- Refatoração de um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação. Confira também a nova página de soluções para microsserviços.
Este é o quarto artigo da nossa série sobre a criação de aplicações com microsserviços. O primeiro artigo apresenta o padrão de arquitetura de microsserviços e discute as vantagens e desvantagens do uso de microsserviços. O segundo<.htmla> e o terceiro artigos da série descrevem diferentes aspectos da comunicação em uma arquitetura de microsserviços. Neste artigo, exploramos o problema intimamente relacionado da descoberta de serviços.
Por que usar a descoberta de serviços?
Imagine que você esteja escrevendo um código que chama um serviço que possui uma API REST ou uma API Thrift. Para fazer uma solicitação, seu código precisa saber a localização na rede (endereço IP e porta) de uma instância do serviço. Em uma aplicação tradicional executada em hardware físico, as localizações das instâncias do serviço na rede são relativamente estáticas. Por exemplo, seu código pode ler essas localizações em um arquivo de configuração que é atualizado ocasionalmente.
No entanto, em uma aplicação moderna de microsserviços baseada em nuvem, esse é um problema muito mais difícil de resolver, como mostra o diagrama a seguir.
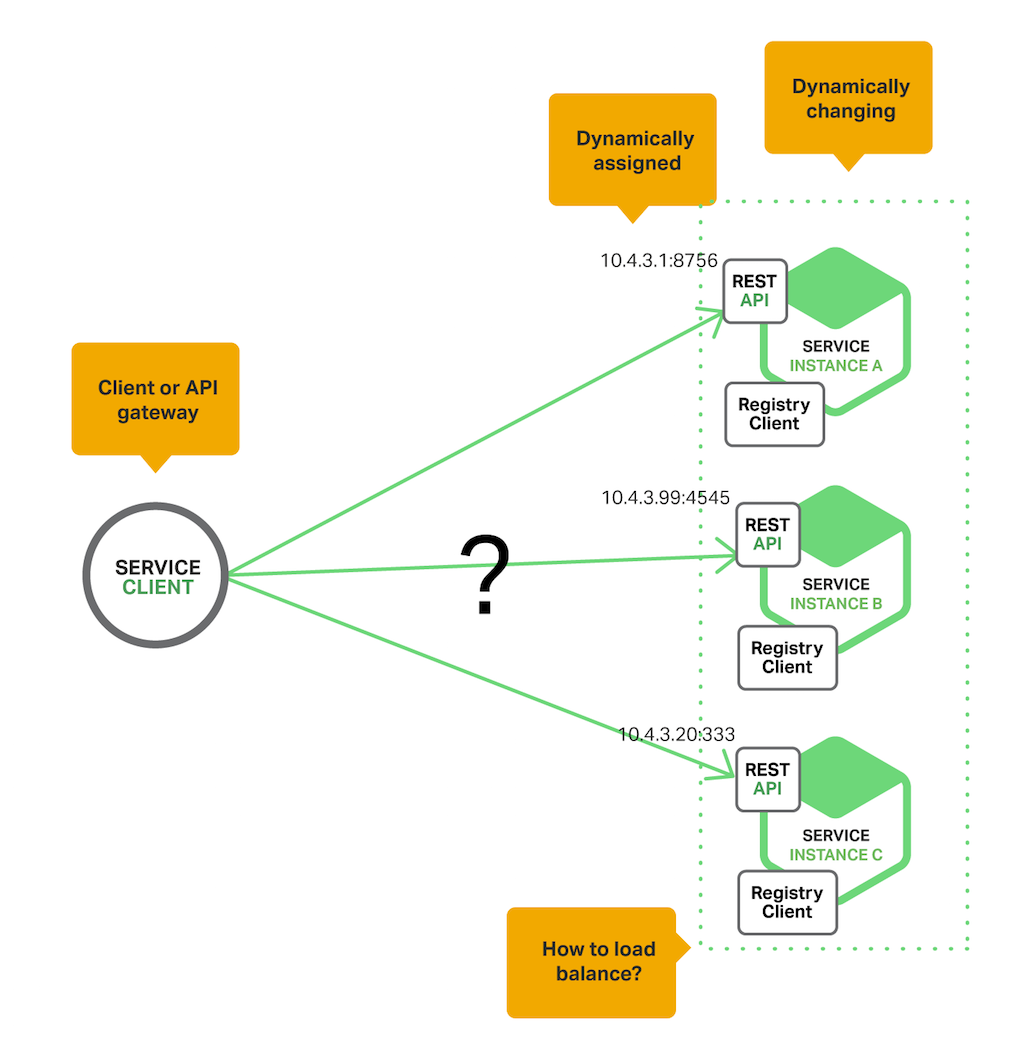
As instâncias de serviço têm localizações de rede atribuídas dinamicamente. Além disso, o conjunto de instâncias de serviço muda de forma dinâmica devido ao escalonamento automático, a falhas e a atualizações. Consequentemente, o código do cliente precisa usar um mecanismo de descoberta de serviços mais sofisticado.
Há dois padrões principais de descoberta de serviços: descoberta do lado do cliente e descoberta do lado do servidor. Vamos analisar primeiro a descoberta do lado do cliente.
O padrão de descoberta do lado do cliente
Ao usar a descoberta no lado do cliente, o cliente é responsável por determinar os endereços de rede das instâncias de serviço disponíveis e distribuir as solicitações entre elas. O cliente consulta um registro de serviços, que é um banco de dados das instâncias de serviço disponíveis. Em seguida, ele usa um algoritmo de balanceamento de carga para selecionar uma dessas instâncias e fazer uma solicitação.
O diagrama a seguir mostra a estrutura desse padrão.
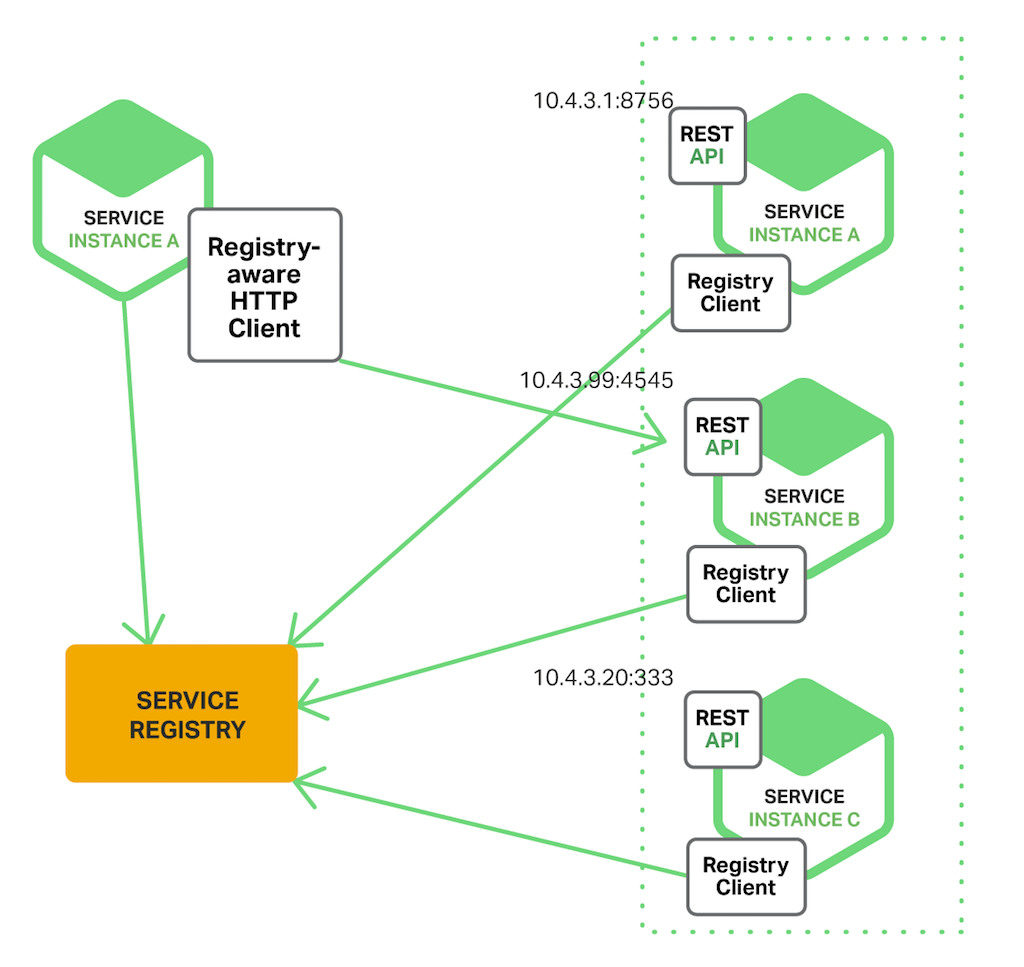
A localização de rede de uma instância de serviço é registrada no registro de serviços quando ela é iniciada. Ela é removida do registro de serviços quando a instância é encerrada. Normalmente, o registro da instância de serviço é atualizado periodicamente por meio de um mecanismo de heartbeat.
Netflix OSS oferece um excelente exemplo do padrão de descoberta no lado do cliente. Netflix Eureka é um registro de serviços. Ele fornece uma API REST para gerenciar o registro de instâncias de serviço e consultar as instâncias disponíveis. Netflix Ribbon é um cliente IPC que funciona com o Eureka para balancear a carga das solicitações entre as instâncias de serviço disponíveis. Abordaremos o Eureka em mais detalhes posteriormente neste artigo.
O padrão de descoberta no lado do cliente apresenta diversas vantagens e desvantagens. Esse padrão é relativamente simples e, com exceção do registro de serviços, não há outros componentes envolvidos. Além disso, como o cliente conhece as instâncias de serviço disponíveis, ele pode tomar decisões inteligentes de balanceamento de carga específicas para a aplicação, como usar hashing consistente. Uma desvantagem significativa desse padrão é que ele acopla o cliente ao registro de serviços. É necessário implementar a lógica de descoberta de serviços no lado do cliente para cada linguagem de programação e framework usados pelos clientes dos seus serviços.
Agora que analisamos a descoberta no lado do cliente, vamos analisar a descoberta no lado do servidor.
O padrão de descoberta no lado do servidor
A outra abordagem para a descoberta de serviços é o padrão de descoberta no lado do servidor. O diagrama a seguir mostra a estrutura desse padrão.
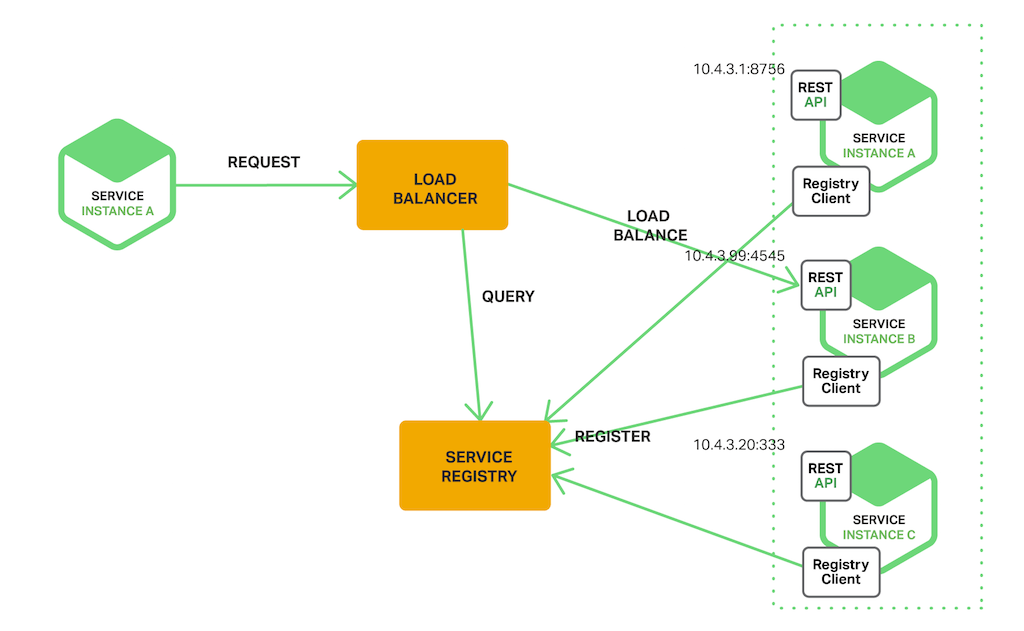
O cliente faz uma solicitação a um serviço por meio de um balanceador de carga. O balanceador de carga consulta o registro de serviços e encaminha cada solicitação para uma instância de serviço disponível. Assim como na descoberta do lado do cliente, as instâncias de serviço são registradas e removidas do registro de serviços.
O AWS Elastic Load Balancer (ELB) é um exemplo de roteador de descoberta do lado do servidor. Um ELB é normalmente usado para balancear a carga do tráfego externo proveniente da Internet. No entanto, também é possível usar um ELB para balancear a carga do tráfego interno de uma nuvem privada virtual (VPC). Um cliente faz solicitações (HTTP ou TCP) por meio do ELB usando o nome DNS dele. O ELB balanceia a carga do tráfego entre um conjunto de instâncias registradas do Elastic Compute Cloud (EC2) ou contêineres do EC2 Container Service (ECS). Não há um registro de serviços separado. Em vez disso, as instâncias do EC2 e os contêineres do ECS são registrados no próprio ELB.
Servidores HTTP e balanceadores de carga, como o NGINX Plus e o NGINX, também podem ser usados como balanceadores de carga com descoberta no lado do servidor. Por exemplo, esta publicação no blog descreve o uso do Consul Template para reconfigurar dinamicamente o proxy reverso do NGINX. O Consul Template é uma ferramenta que regenera periodicamente arquivos de configuração arbitrários com base nos dados de configuração armazenados no registro de serviços do Consul. Ela executa um comando shell arbitrário sempre que os arquivos são alterados. No exemplo descrito na publicação do blog, o Consul Template gera um arquivo nginx.conf, que configura o proxy reverso, e depois executa um comando que instrui o NGINX a recarregar a configuração. Uma implementação mais sofisticada poderia reconfigurar dinamicamente o NGINX Plus usando sua API HTTP ou DNS.
Alguns ambientes de implantação, como Kubernetes e Marathon, executam um proxy em cada host do cluster. O proxy desempenha a função de balanceador de carga com descoberta no lado do servidor. Para fazer uma solicitação a um serviço, o cliente encaminha a solicitação por meio do proxy usando o endereço IP do host e a porta atribuída ao serviço. Em seguida, o proxy encaminha a solicitação de forma transparente para uma instância disponível do serviço em execução em algum ponto do cluster.
O padrão de descoberta no lado do servidor apresenta várias vantagens e desvantagens. Uma grande vantagem desse padrão é que os detalhes da descoberta ficam abstraídos do cliente. Os clientes simplesmente fazem solicitações ao balanceador de carga. Isso elimina a necessidade de implementar a lógica de descoberta para cada linguagem de programação e framework usados pelos clientes do seu serviço. Além disso, como mencionado acima, alguns ambientes de implantação oferecem essa funcionalidade gratuitamente. No entanto, esse padrão também apresenta algumas desvantagens. A menos que o balanceador de carga seja fornecido pelo ambiente de implantação, ele será mais um componente de sistema de alta disponibilidade que você precisará configurar e gerenciar.
O Registro de Serviços
O registro de serviços é uma parte fundamental da descoberta de serviços. Trata-se de um banco de dados que contém os endereços de rede das instâncias de serviço. Um registro de serviços precisa ter alta disponibilidade e estar sempre atualizado. Os clientes podem armazenar em cache os endereços de rede obtidos do registro de serviços. No entanto, essas informações acabam ficando desatualizadas, e os clientes deixam de conseguir descobrir instâncias de serviço. Por isso, um registro de serviços consiste em um cluster de servidores que usam um protocolo de replicação para manter a consistência.
Como mencionado anteriormente, Netflix Eureka é um bom exemplo de registro de serviços. Ele fornece uma API REST para registrar e consultar instâncias de serviço. Uma instância de serviço registra sua localização na rede usando uma solicitação POST. A cada 30 segundos, ela deve renovar seu registro usando uma solicitação PUT. Um registro é removido por meio de uma solicitação HTTP DELETE ou quando o registro da instância expira. Como seria de esperar, um cliente pode recuperar as instâncias de serviço registradas usando uma solicitação HTTP GET.
A Netflix alcança alta disponibilidade executando um ou mais servidores Eureka em cada zona de disponibilidade do Amazon EC2. Cada servidor Eureka é executado em uma instância do EC2 que possui um endereço IP elástico. Os registros TEXT do DNS são usados para armazenar a configuração do cluster Eureka, que consiste em um mapeamento das zonas de disponibilidade para uma lista dos endereços de rede dos servidores Eureka. Quando um servidor Eureka é iniciado, ele consulta o DNS para recuperar a configuração do cluster Eureka, localiza seus pares e atribui a si mesmo um endereço IP elástico não utilizado.
Os clientes do Eureka — serviços e clientes de serviços — consultam o DNS para descobrir os endereços de rede dos servidores Eureka. Os clientes preferem usar um servidor Eureka na mesma zona de disponibilidade. No entanto, se nenhum estiver disponível, o cliente usará um servidor Eureka em outra zona de disponibilidade.
Outros exemplos de registros de serviços incluem:
- etcd – Um armazenamento de chave-valor altamente disponível, distribuído e consistente, usado para configuração compartilhada e descoberta de serviços. Dois projetos de destaque que usam o etcd são o Kubernetes e o Cloud Foundry.
- consul – Uma ferramenta para descobrir e configurar serviços. Ela fornece uma API que permite aos clientes registrar e descobrir serviços. O Consul pode realizar verificações de integridade para determinar a disponibilidade dos serviços.
- Apache Zookeeper – Um serviço de coordenação amplamente utilizado e de alto desempenho para aplicações distribuídas. O Apache Zookeeper era originalmente um subprojeto do Hadoop, mas agora é um projeto de nível superior.
Além disso, como observado anteriormente, alguns sistemas, como Kubernetes, Marathon e AWS, não têm um registro de serviços explícito. Em vez disso, o registro de serviços é simplesmente uma parte integrada da infraestrutura.
Agora que analisamos o conceito de registro de serviços, vamos ver como as instâncias de serviço são registradas nele.
Opções de registro de serviços
Como mencionado anteriormente, as instâncias de serviço devem ser registradas no registro de serviços e removidas dele. Há algumas maneiras diferentes de lidar com o registro e a remoção. Uma opção é as instâncias de serviço se registrarem por conta própria, o padrão de autorregistro. A outra opção é algum outro componente do sistema gerenciar o registro das instâncias de serviço, o padrão de registro por terceiros. Vejamos primeiro o padrão de autorregistro.
O padrão de autorregistro
Ao usar o padrão de autorregistro, uma instância de serviço é responsável por se registrar e cancelar seu próprio registro no registro de serviços. Além disso, se necessário, a instância de serviço envia solicitações de heartbeat para evitar que seu registro expire. O diagrama a seguir mostra a estrutura desse padrão.
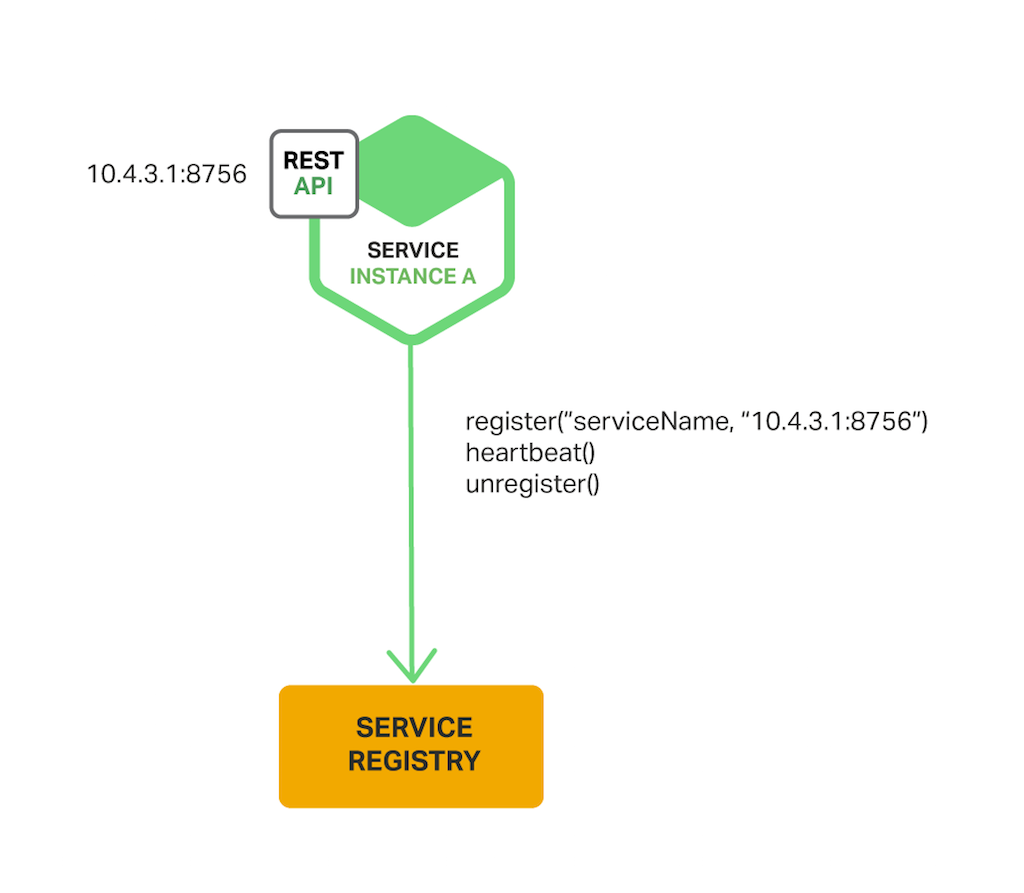
Um bom exemplo dessa abordagem é o cliente Eureka do Netflix OSS. O cliente Eureka cuida de todos os aspectos do registro e cancelamento do registro de instâncias de serviço. O projeto Spring Cloud, que implementa vários padrões, incluindo a descoberta de serviços, facilita o registro automático de uma instância de serviço no Eureka. Basta adicionar à sua classe de configuração Java a anotação @EnableEurekaClient.
O padrão de autorregistro apresenta várias vantagens e desvantagens. Uma das vantagens é que ele é relativamente simples e não requer nenhum outro componente do sistema. No entanto, uma grande desvantagem é que ele acopla as instâncias de serviço ao registro de serviços. É necessário implementar o código de registro em cada linguagem de programação e framework usados pelos seus serviços.
A abordagem alternativa, que desacopla os serviços do registro de serviços, é o padrão de registro por terceiros.
O padrão de registro por terceiros
Ao usar o padrão de registro por terceiros, as instâncias de serviço não são responsáveis por se registrar no registro de serviços. Em vez disso, outro componente do sistema, conhecido como registrador de serviços, é responsável pelo registro. O registrador de serviços acompanha as alterações no conjunto de instâncias em execução, seja consultando periodicamente o ambiente de implantação ou assinando eventos. Ao detectar uma nova instância de serviço disponível, ele a registra no registro de serviços. O registrador de serviços também remove do registro as instâncias de serviço encerradas. O diagrama a seguir mostra a estrutura desse padrão.
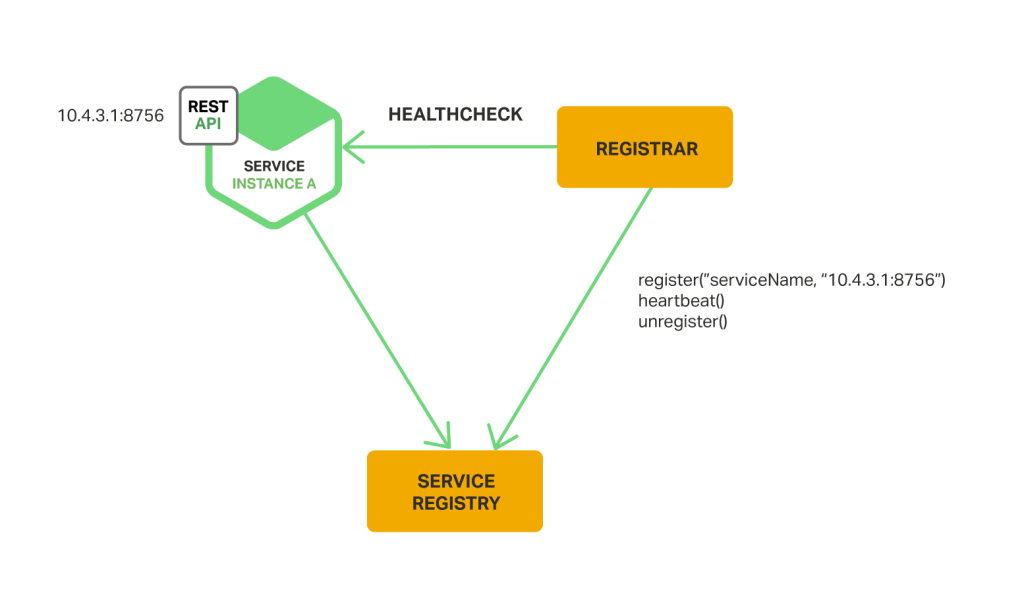
Um exemplo de registrador de serviços é o projeto de código aberto Registrator. Ele registra e cancela automaticamente o registro de instâncias de serviço implantadas como contêineres Docker. O Registrator é compatível com vários registros de serviços, incluindo etcd e Consul.
Outro exemplo de registrador de serviços é o NetflixOSS Prana. Destinado principalmente a serviços escritos em linguagens que não usam a JVM, ele é um aplicativo sidecar executado junto a uma instância de serviço. O Prana registra e cancela o registro da instância de serviço no Netflix Eureka.
O registrador de serviços é um componente integrado aos ambientes de implantação. As instâncias do EC2 criadas por um grupo de Auto Scaling podem ser registradas automaticamente em um ELB. Os serviços do Kubernetes são registrados automaticamente e disponibilizados para descoberta.
O padrão de registro por terceiros apresenta várias vantagens e desvantagens. Uma grande vantagem é que os serviços ficam desacoplados do registro de serviços. Não é necessário implementar a lógica de registro de serviços para cada linguagem de programação e framework usados pelos seus desenvolvedores. Em vez disso, o registro das instâncias de serviço é gerenciado de forma centralizada em um serviço dedicado.
Uma desvantagem desse padrão é que, a menos que ele esteja integrado ao ambiente de implantação, trata-se de mais um componente de sistema de alta disponibilidade que você precisa configurar e gerenciar.
Resumo
Em uma aplicação de microsserviços, o conjunto de instâncias de serviço em execução muda dinamicamente. As instâncias têm localizações de rede atribuídas de forma dinâmica. Consequentemente, para que um cliente faça uma solicitação a um serviço, ele deve usar um mecanismo de descoberta de serviços.
Uma parte fundamental da descoberta de serviços é o registro de serviços. O registro de serviços é um banco de dados de instâncias de serviço disponíveis. O registro de serviços fornece uma API de gerenciamento e uma API de consulta. As instâncias de serviço são registradas e removidas do registro de serviços por meio da API de gerenciamento. A API de consulta é usada pelos componentes do sistema para descobrir instâncias de serviço disponíveis.
Há dois padrões principais de descoberta de serviços: descoberta no lado do cliente e descoberta no lado do servidor. Em sistemas que usam a descoberta de serviços no lado do cliente, os clientes consultam o registro de serviços, selecionam uma instância disponível e fazem uma solicitação. Em sistemas que usam a descoberta no lado do servidor, os clientes fazem solicitações por meio de um roteador, que consulta o registro de serviços e encaminha a solicitação para uma instância disponível.
Há duas maneiras principais pelas quais as instâncias de serviço são registradas e removidas do registro de serviços. Uma opção é que as próprias instâncias de serviço se registrem no registro de serviços, o padrão de autorregistro. A outra opção é que algum outro componente do sistema gerencie o registro e a remoção em nome do serviço, o padrão de registro por terceiros.
Em alguns ambientes de implantação, é necessário configurar sua própria infraestrutura de descoberta de serviços usando um registro de serviços, como Netflix Eureka, etcd ou Apache Zookeeper. Em outros ambientes de implantação, a descoberta de serviços é integrada. Por exemplo, Kubernetes e Marathon gerenciam o registro e o cancelamento do registro de instâncias de serviço. Eles também executam um proxy em cada host do cluster que desempenha a função de roteador de descoberta no lado do servidor.
Um proxy reverso HTTP e balanceador de carga, como o NGINX, também pode ser usado como balanceador de carga para descoberta no lado do servidor. O registro de serviços pode enviar as informações de roteamento ao NGINX e acionar uma atualização de configuração sem interrupções; por exemplo, você pode usar o Consul Template. O NGINX Plus oferece suporte a mecanismos adicionais de reconfiguração dinâmica – ele pode obter informações sobre instâncias de serviço do registro usando DNS e fornece uma API para reconfiguração remota.
Em futuras publicações no blog, continuaremos a explorar outros aspectos dos microsserviços. Inscreva-se na lista de e-mails da NGINX (o formulário está abaixo) para receber notificações sobre a publicação dos próximos artigos da série.
Editor – Esta série de artigos em sete partes está concluída:
- Introdução aos microsserviços
- Construindo microsserviços: usando um gateway de API
- Construindo microsserviços: comunicação entre processos em uma arquitetura de microsserviços
- Descoberta de serviços em uma arquitetura de microsserviços (este artigo)
- Gerenciamento de dados orientado a eventos para microsserviços
- Escolhendo uma estratégia de implantação de microsserviços
- Refatorando um monólito em microsserviços
Você também pode baixar a coleção completa de artigos, além de informações sobre como implementar microsserviços usando o NGINX Plus, no formato de ebook – Microsserviços: do projeto à implantação.
O blogueiro convidado Chris Richardson é o fundador do CloudFoundry.com original, uma das primeiras PaaS (plataforma como serviço) Java para o Amazon EC2. Atualmente, ele presta consultoria a organizações para aprimorar a forma como desenvolvem e implantam aplicações. Ele também publica regularmente sobre microsserviços em https://microservices.io.
Sobre o autor
Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.