El renacimiento de la infraestructura tiene un lema: que los servidores sirvan y la inferencia infiera.
En los albores de la tecnología, pasé años inmerso en pruebas y análisis de aceleradores SSL. Estas pequeñas tarjetas se diseñaron para resolver un importante problema derivado del crecimiento explosivo de los negocios y el comercio digitales: las funciones de seguridad que utilizaban SSL consumían ciclos de CPU y constituían una fuente importante de problemas de rendimiento. Por ello, el sector —incluido F5— desarrolló hardware para descargar esas funciones y dejar que los servidores se dedicasen a servir.
Hoy estamos viendo cómo surgen los mismos problemas con la IA —en concreto, con la inferencia— y, sin ironía alguna, también estamos viendo aparecer el mismo tipo de soluciones; a saber, hardware especializado que permite a los servidores dedicarse a servir y a los sistemas de inferencia dedicarse a inferir.
Sí, no estoy seguro de que sea gramaticalmente correcto, pero de momento lo dejamos así, ¿vale? Gracias.
Como ya hemos señalado, las aplicaciones de IA son aplicaciones modernas por su arquitectura. Sin embargo, en el núcleo de una aplicación de IA se encuentra la inferencia, y ahí es donde la IA se diferencia de las aplicaciones modernas «normales».
La inferencia en acción
Hemos visto cómo los complejos de computación de IA se construyen a partir de conjuntos de CPU y GPU. Estos recursos informáticos deben mantener unas proporciones y un equilibrio determinados para que el clúster funcione de forma eficiente. Cada vez que una CPU no puede seguir el ritmo, una GPU muy cara permanece inactiva.
En realidad, solo una parte del procesamiento de un servidor de inferencia se dedica a la inferencia propiamente dicha. Gran parte consiste en el procesamiento web estándar de solicitudes HTTP y API. Es esa parte del servicio de inferencia la que utiliza la CPU y a menudo se ve sobrecargada. Cuando eso ocurre, las GPU se utilizan cada vez menos, ya que el componente del servidor encargado de la inferencia se atasca intentando gestionar las solicitudes.
Probablemente por eso, el 15 % de las organizaciones afirma que utiliza menos del 50 % de las GPU que tiene disponibles y ha adquirido (Estado de la infraestructura de IA a gran escala en 2024).
Parte del problema radica en el uso de recursos de CPU para tareas que debería asumir la infraestructura. Servicios como la gestión del tráfico, las operaciones de seguridad y la supervisión también consumen recursos de CPU y aumentan la carga del sistema en su conjunto. Esto reduce la capacidad y el rendimiento de los servidores de inferencia y disminuye el aprovechamiento de los recursos de GPU.
Por suerte, este renacimiento de la infraestructura busca preservar los recursos de CPU para las tareas de inferencia, trasladando las operaciones de infraestructura a una nueva unidad de procesamiento: la DPU.
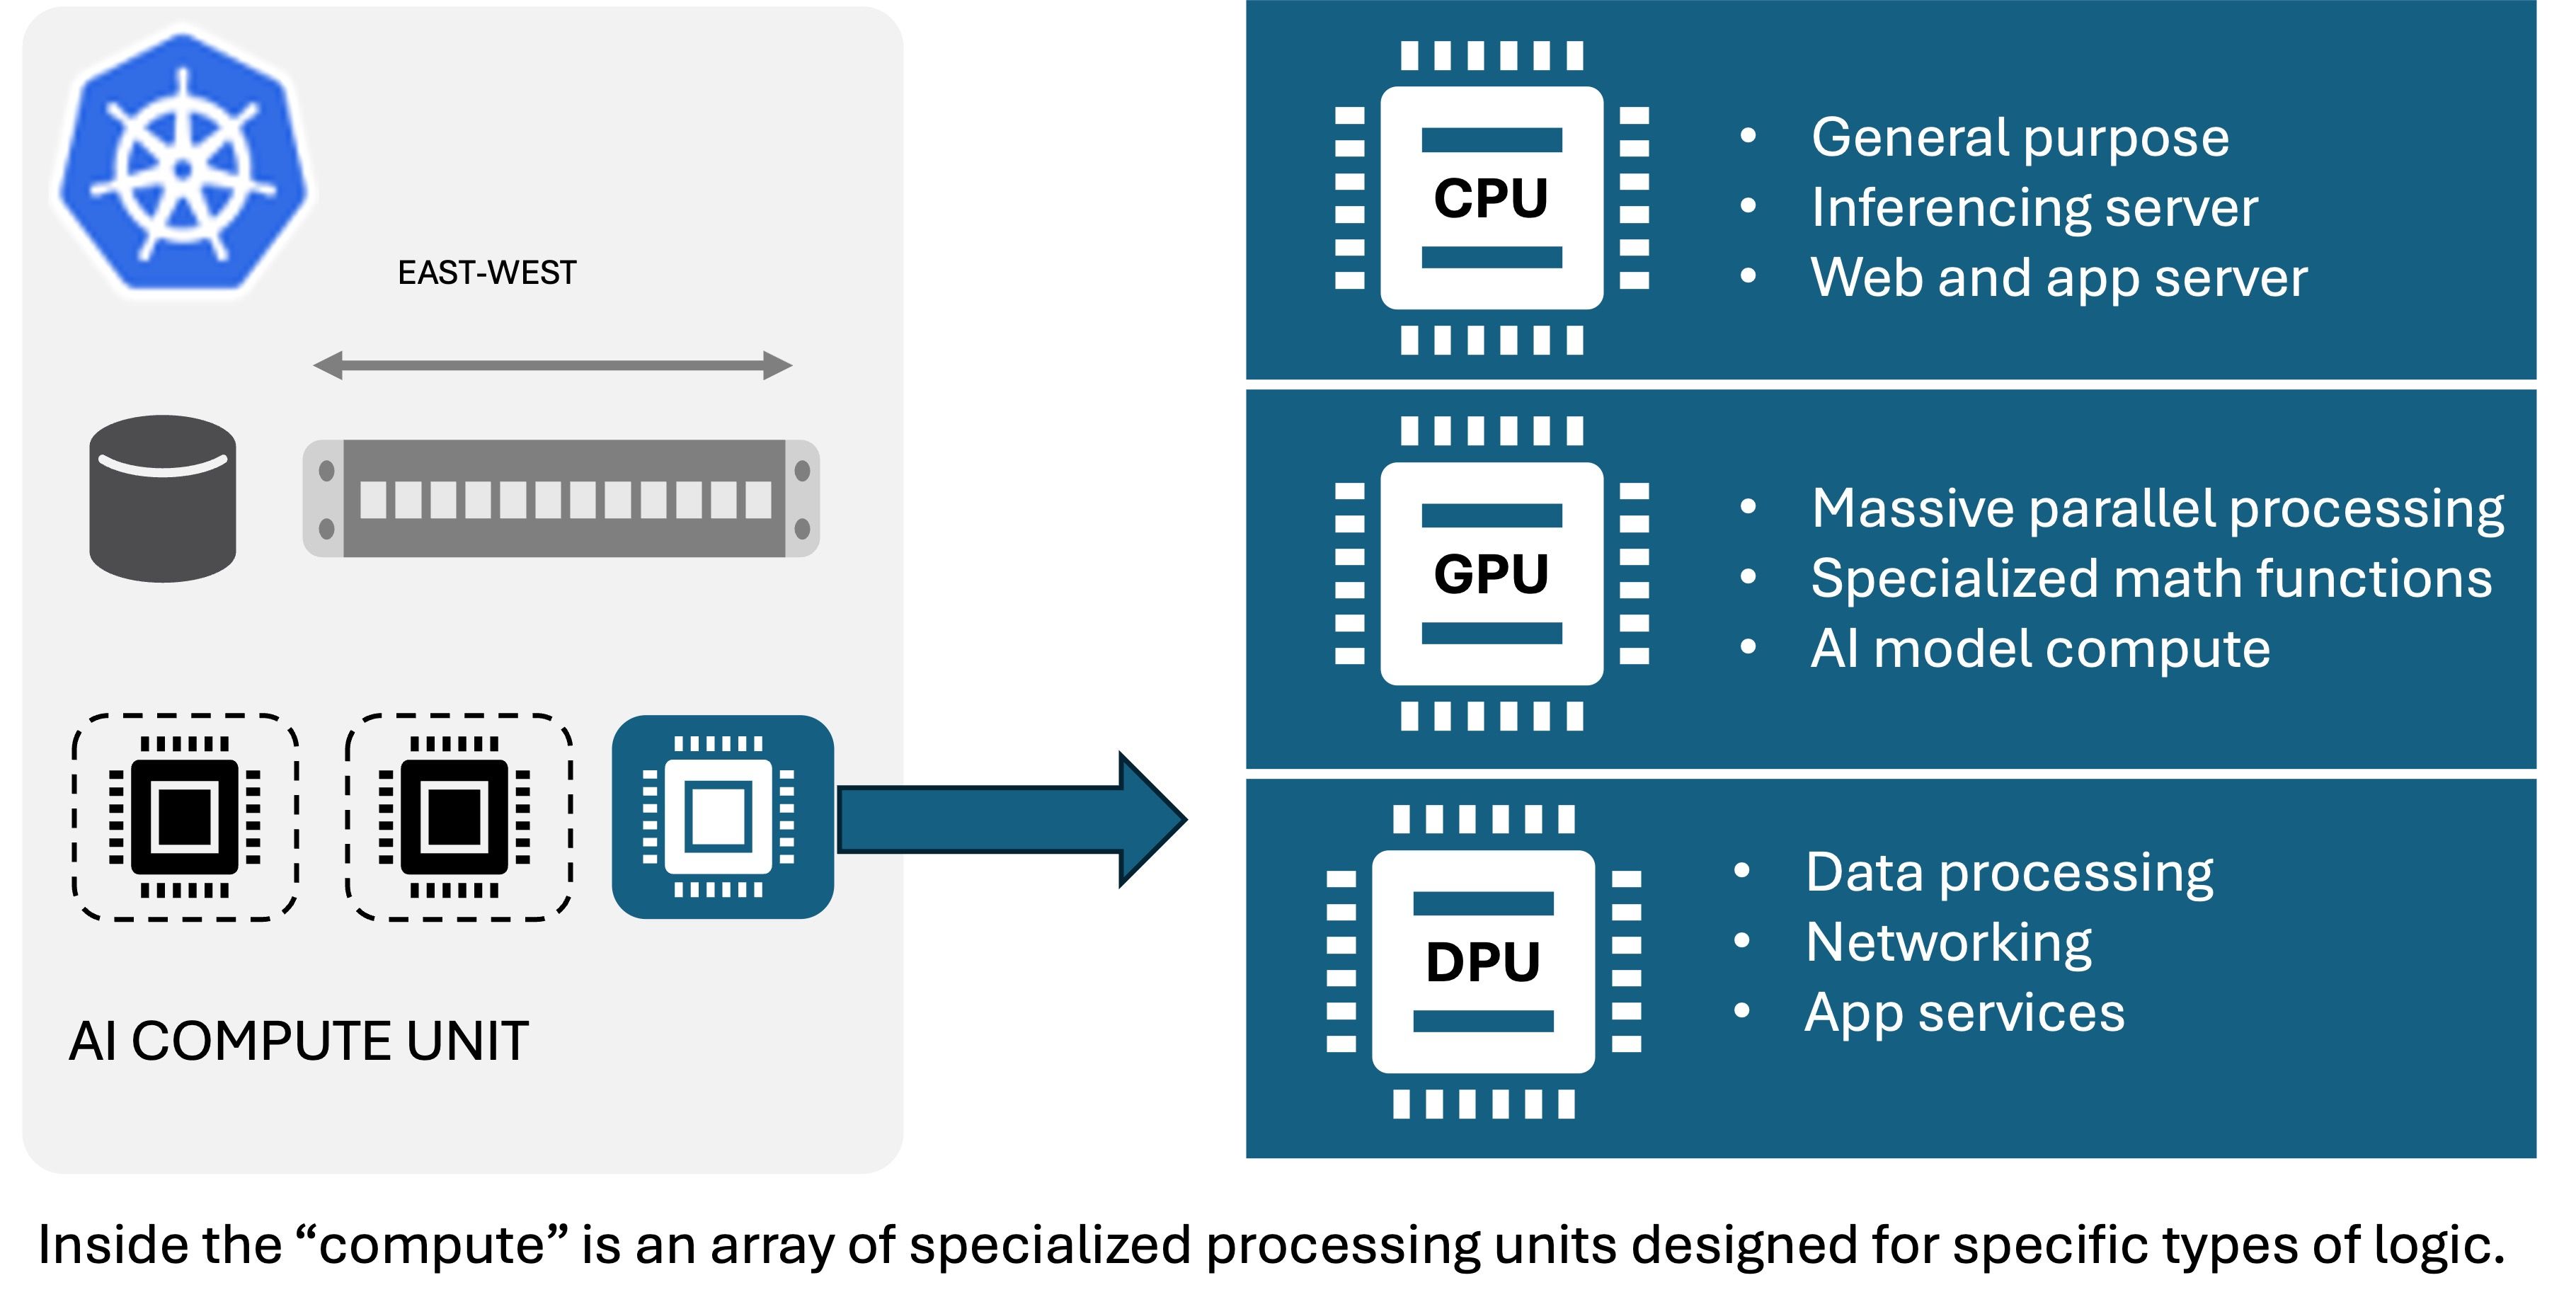
Lo interesante de las DPU es que admiten dos modos diferentes. En uno de ellos, pueden descargar tareas de red como RDMA sobre InfiniBand o Ethernet. Esto resulta de gran ayuda al crear un complejo de computación de IA por el que van a circular grandes cantidades de datos, por ejemplo, para entrenar un modelo de IA o ampliar la capacidad de inferencia para una amplia base de usuarios.
Pero las DPU también se pueden configurar en modo «DPU». En Kubernetes, esto hace que aparezcan como un nodo independiente en el que se pueden ejecutar funciones como la entrega de aplicaciones y la seguridad. De este modo, se reserva capacidad de procesamiento de la CPU para los servicios de inferencia al «descargar» las cargas de trabajo de infraestructura menos predecibles y más exigentes en su propio nodo del clúster. Esto permite que soluciones como F5 BIG-IP Next SPK (Service Proxy for Kubernetes) gestionen y protejan mediante API las solicitudes entrantes de IA de norte a sur (N-S), y las distribuyan correctamente al servicio de inferencia adecuado dentro del complejo de computación de IA.
Este enfoque permite a las organizaciones aprovechar los conocimientos y las inversiones existentes en la gestión de infraestructuras con Kubernetes, ya que nuestra solución es nativa de Kubernetes. Núcleo, nube o perímetro: no importa, porque la operación se realiza a nivel de clúster y es uniforme en todos los entornos.
También separa la responsabilidad de gestionar la entrega de aplicaciones y los servicios de seguridad, lo que permite a los equipos de operaciones de red y seguridad encargarse de la infraestructura con independencia de las cargas de trabajo de IA gestionadas por los equipos de operaciones de desarrollo y aprendizaje automático.
Por último, aprovechar la DPU para la entrega de aplicaciones y la seguridad permite satisfacer mejor las necesidades de multitenencia de las organizaciones. No se trata solo de aislar las cargas de trabajo de los clientes, sino también las de los modelos. Nuestra investigación revela que las organizaciones ya utilizan, de media, 2,9 modelos diferentes. Poder gestionar el uso de cada uno mediante una solución uniforme aumentará la confianza en la seguridad y la privacidad de los datos que consume y genera cada modelo.
No es la primera vez que F5 trabaja con las DPU de NVIDIA en casos de uso relacionados con la IA. Sin embargo, sí es la primera vez que colaboramos para desarrollar una solución que ayude a clientes de todos los tamaños a crear complejos de computación de IA escalables y seguros, de modo que puedan aprovechar con seguridad y confianza la potencia de la inferencia en cualquier entorno y optimizar el uso de los recursos de GPU para que no permanezcan inactivos.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.