¿Cómo es realmente una aplicación de IA? Después de haber creado unas cuantas, parece un buen momento para desglosarla en sus (muchas) partes y analizar las implicaciones operativas.
Ya hemos analizado anteriormente qué tienen en común (mucho) y qué tienen de diferente (también mucho) las aplicaciones de IA. Es bastante sencillo definir una aplicación de IA como «una aplicación que utiliza IA, ya sea predictiva o generativa».
Es cierto, pero ¿qué implica eso para quienes deben desarrollar, implementar, distribuir, proteger y operar estos nuevos tipos de aplicaciones?
Para empezar, implica nuevos elementos en juego. Y no solo servicios de inferencia. Hay otros componentes nuevos que se están convirtiendo en incorporaciones habituales a la arquitectura de las aplicaciones, como las bases de datos vectoriales. También implica una mayor dependencia de las API.
También es cierto que la mayoría de estos componentes están en contenedores. Cuando configuro un nuevo proyecto de aplicación de IA, pongo en marcha un contenedor que ejecuta PostgreSQL para usarlo como almacén de datos vectoriales. Esto permite implementar RAG (generación aumentada por recuperación), una técnica que utiliza un porcentaje significativo de las aplicaciones de IA, según diversos informes del sector (como este de Databricks por ejemplo). Esto se debe a que puedo ampliar un modelo de IA estándar con los datos que quiera sin tener que ajustarlo ni entrenarlo por mi cuenta. Para un número considerable de casos de uso, esa es la mejor forma de implementar una aplicación de IA.
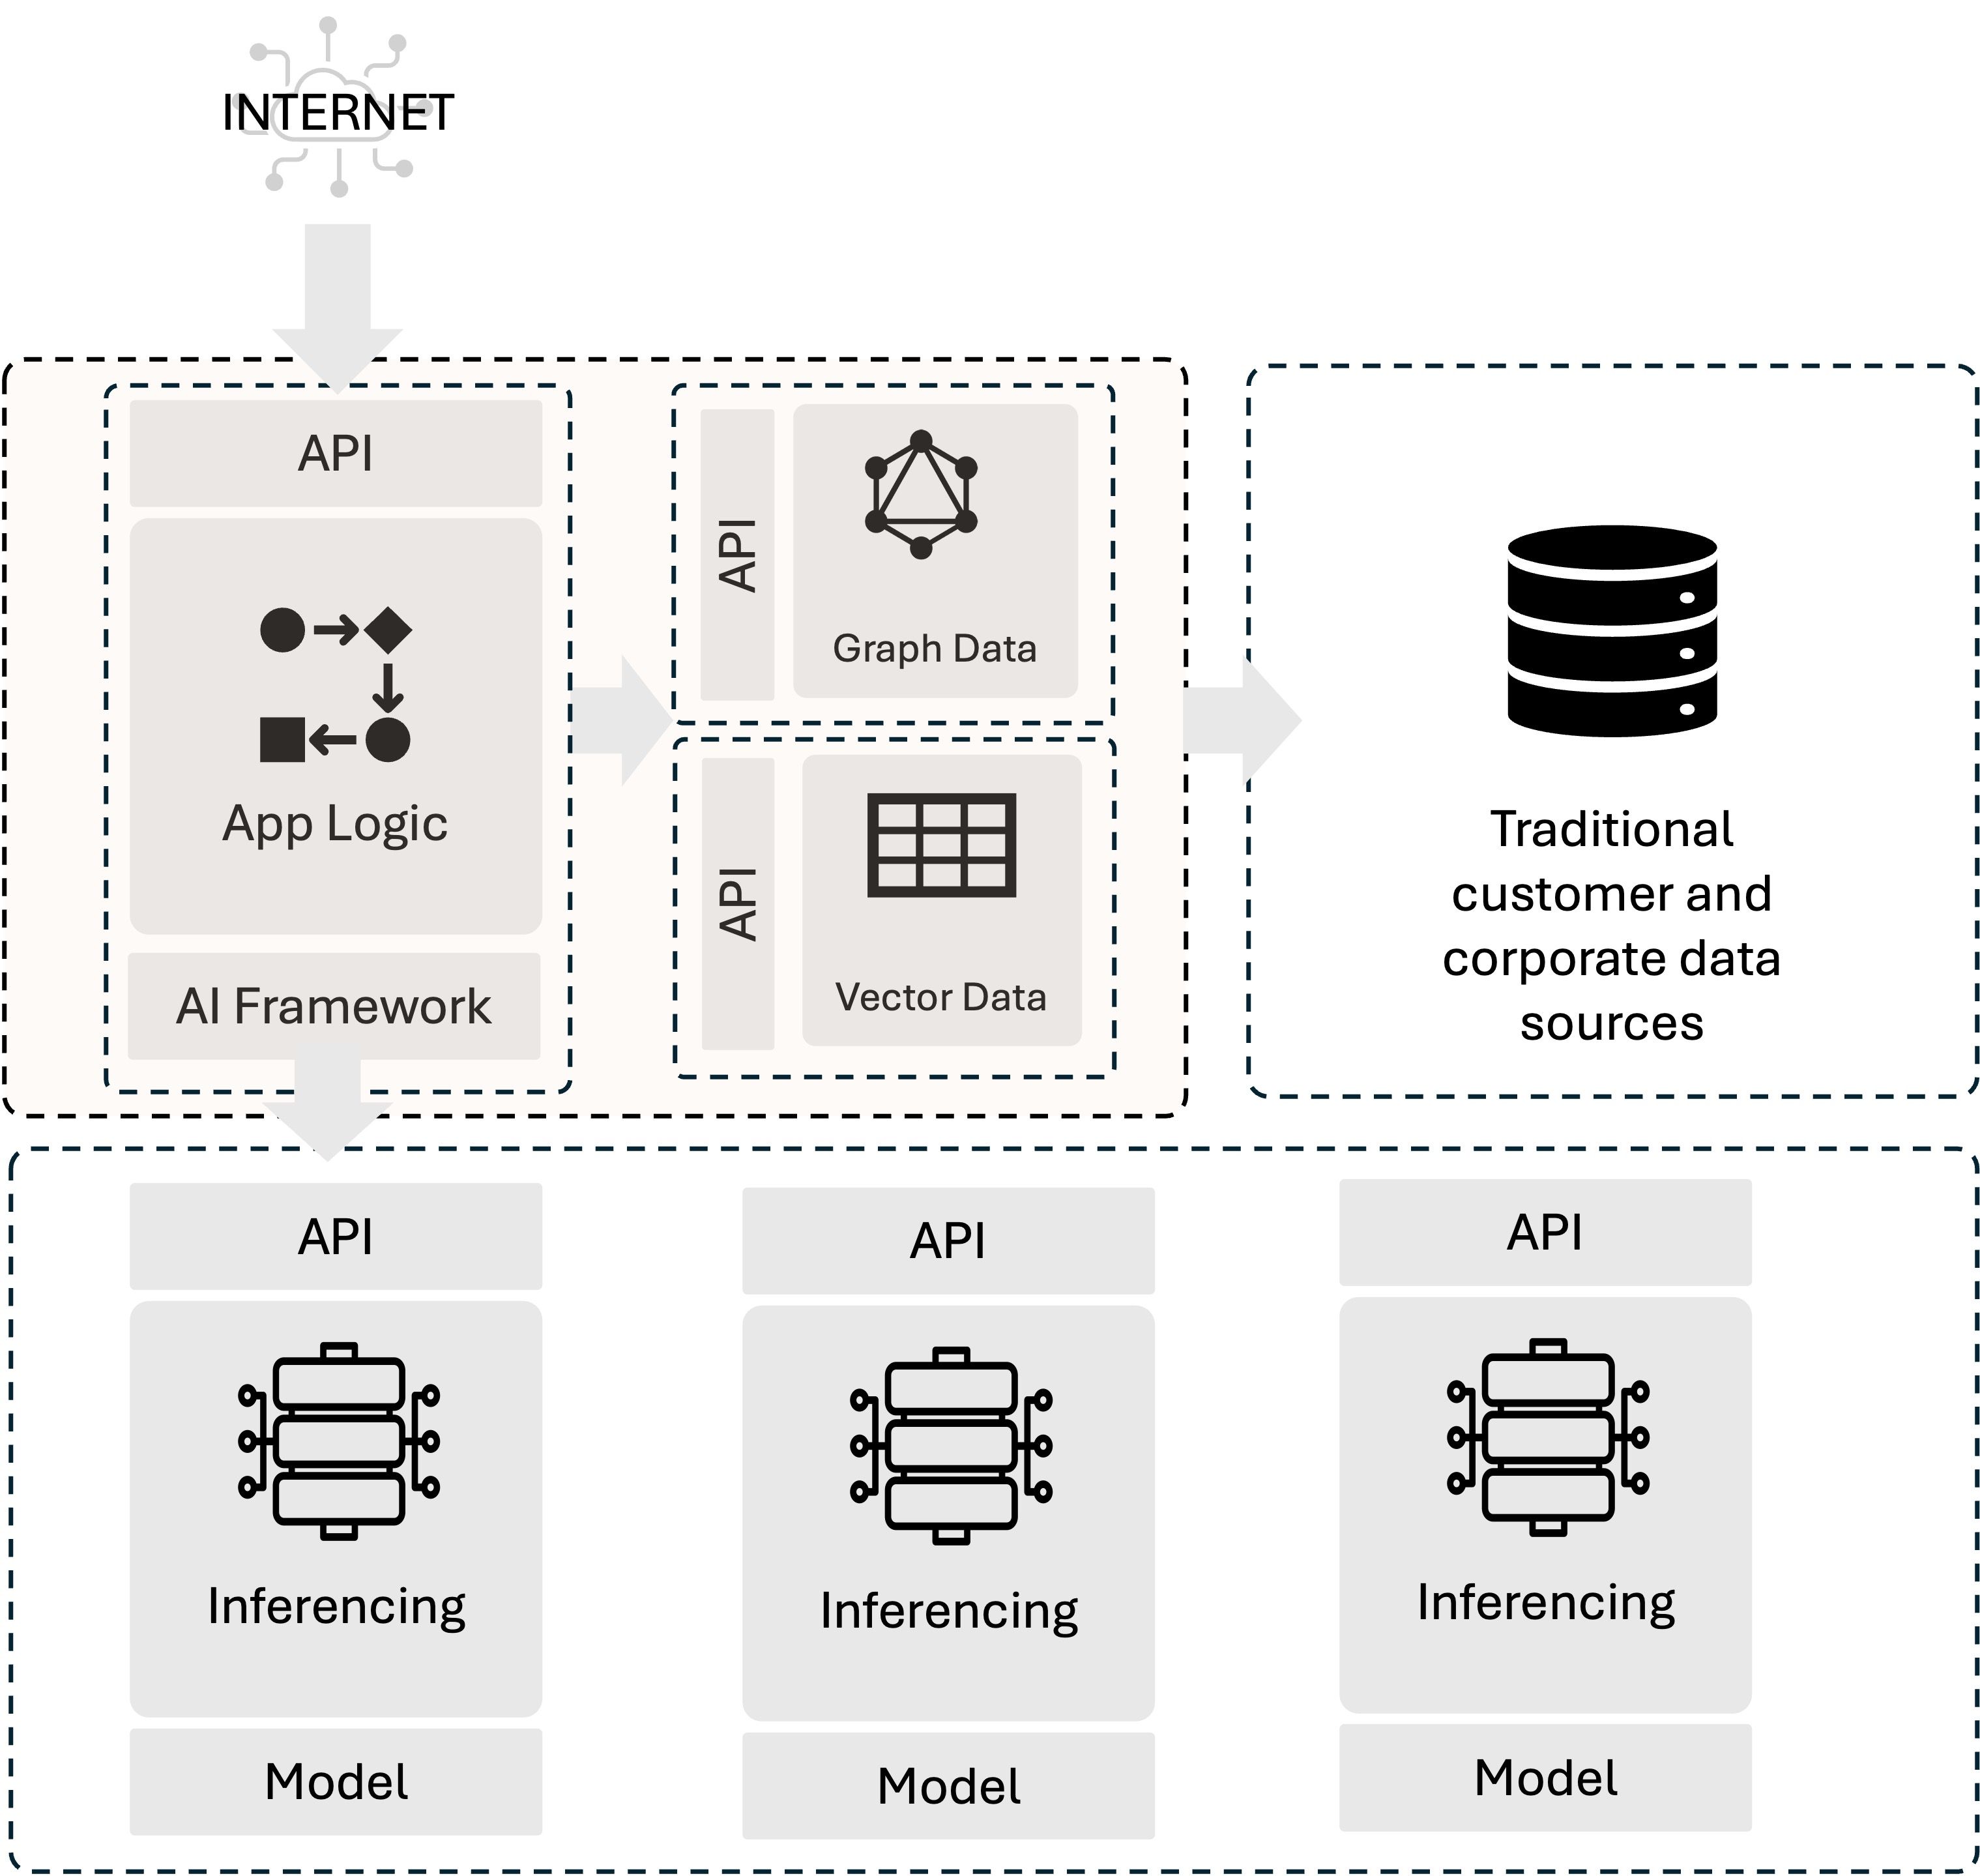
También puedo poner en marcha un grafo de conocimiento, normalmente ejecutando una base de datos de grafos en contenedores como Neo4J. Las bases de datos de grafos resultan especialmente útiles al trabajar con datos que se prestan a una estructura de grafo, como los de redes sociales, motores de recomendación y detección de fraudes. También resultan útiles para mitigar las alucinaciones relacionadas con la generación de políticas, como descubrimos a principios de año. La incorporación de una base de datos de grafos puede añadir un nuevo protocolo, GraphQL, a la lista de «nuevos elementos que hay que proteger».
A continuación, decidiré qué servicio de inferencia quiero utilizar. Tengo varias opciones. Podría utilizar un servicio de un proveedor de nube o IA como servicio (al estilo de ChatGPT), o bien ejecutar un servicio local. Por ejemplo, en mis últimos experimentos he utilizado Ollama y phi3 en mi MacBook. En este caso, solo ejecuto una instancia del servidor de inferencia porque, bueno, ejecutar varias consumiría más recursos de los que tengo. En producción, por supuesto, probablemente habría más instancias para garantizar que pueda satisfacer la demanda.
Como voy a utilizar phi3, elijo phidata como framework para acceder al servicio de inferencia. También he utilizado langchain al recurrir a la IA como servicio, una opción muy popular. La buena noticia es que, desde el punto de vista operativo, el framework no funciona fuera de la propia aplicación principal de IA.
Impacto operativo de las aplicaciones de IA
Aún no he escrito ni una sola línea de código y ya tengo varios componentes en ejecución, cada uno accesible mediante una API y ejecutándose en su propio contenedor. Por eso partimos de la premisa de que una aplicación de IA es una aplicación moderna y conlleva los mismos retos habituales de entrega, seguridad y funcionamiento. También por eso creemos que el despliegue de modelos de IA aumentará radicalmente el número de API que habrá que distribuir y proteger.
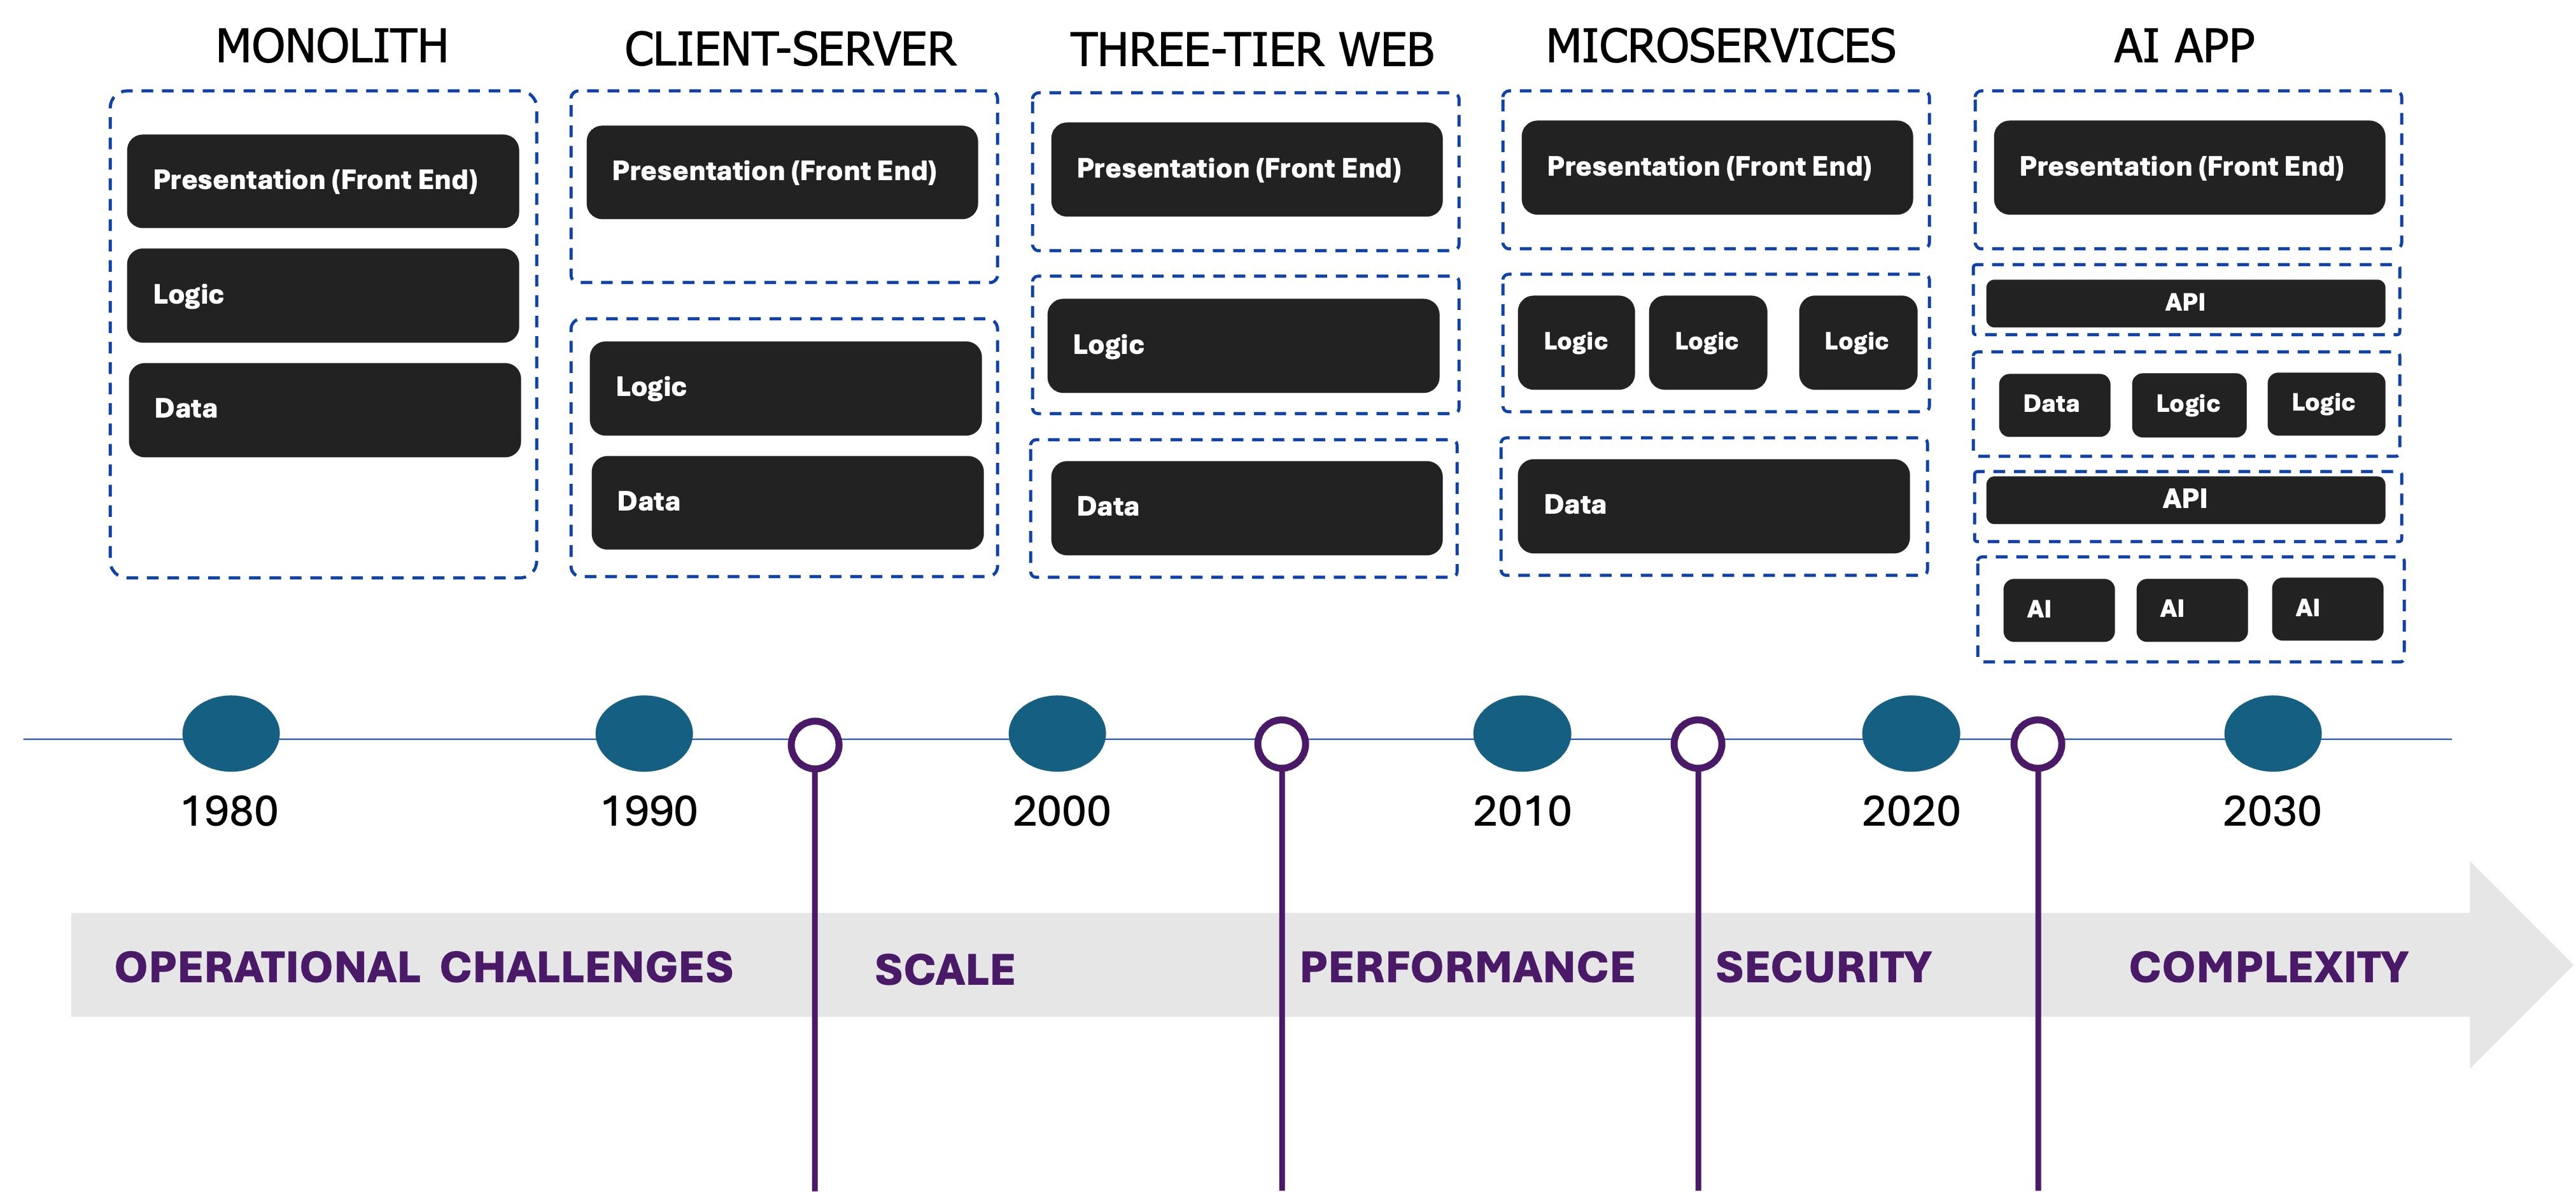
Las aplicaciones de IA añaden otra capa a un entorno ya de por sí complejo, lo que, naturalmente, aumenta la complejidad. Esto significa que la arquitectura de las aplicaciones de IA incrementará la carga de todas las funciones operativas, desde la seguridad y la ingeniería de fiabilidad de sitios (SRE) hasta la red. Cada uno de estos componentes también tiene su propio perfil de escalabilidad; es decir, algunos tendrán que escalar más rápido que otros, y la forma en que se distribuyan las solicitudes variará simplemente porque la mayoría utiliza API diferentes y, en algunos casos, protocolos distintos.
Además, la arquitectura interna de las aplicaciones de IA va a ser muy variable. Es decir, es probable que la aplicación de IA que yo desarrolle presente unas características y necesidades de tráfico local diferentes de las de la aplicación de IA que desarrolle usted. Y una mayor heterogeneidad implica, naturalmente, una mayor complejidad, ya que es lo contrario de la estandarización, que fomenta la homogeneidad.
Durante décadas, la estandarización ha sido el medio por el que las empresas han acelerado la comercialización de nuevas funcionalidades y han logrado una mayor eficiencia operativa, al tiempo que liberaban los recursos humanos necesarios para abordar la variabilidad de las arquitecturas de las aplicaciones de IA.
Por eso vemos que algunos servicios compartidos —en particular, la seguridad de las aplicaciones y las API— se están trasladando al edge, al estilo de la seguridad como servicio. Este conjunto de servicios compartidos no solo puede proteger mejor las cargas de trabajo en todos los entornos (núcleo, nube y edge), sino también proporcionar un conjunto común de servicios que sirva como estándar para las aplicaciones de IA.
Comprender la anatomía de las aplicaciones de IA ayudará a determinar no solo los tipos de servicios de entrega y seguridad de aplicaciones que necesita, sino también dónde los necesita.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.