
Há um ditado no meio militar: “Amadores discutem táticas, mas profissionais estudam logística.” Essa ideia pode parecer surpreendente à primeira vista, quando pensamos no brilhantismo de Lee em Chancellorsville ou na genialidade de Aníbal durante as Guerras Púnicas; no entanto, a história mostra que nem Lee nem Aníbal venceram suas respectivas guerras. O principal motivo foi a logística: a capacidade de manter um exército abastecido com alimentos, roupas e armas, no momento e no lugar certos. Apesar das táticas brilhantes, foi a logística que, em última análise, determinou a vitória. Em outras palavras, as táticas permitem aproveitar ao máximo os recursos disponíveis no campo de batalha, mas é a logística que possibilita chegar até ele e permanecer nele.
Gosto da analogia militar porque acredito que ela tenha paralelos com a forma como as soluções orientadas por dados costumam ser apresentadas hoje. O fascínio das “táticas” — técnicas avançadas de IA, como aprendizado profundo, classificação por florestas aleatórias, gradient boosting e assim por diante — frequentemente ofusca a “logística” menos atraente dos fundamentos da arquitetura de dados que viabilizam essas técnicas avançadas.
O primeiro passo em uma discussão sobre arquitetura de dados é definir o que o conceito de “arquitetura de dados” abrange. Como era de se esperar, a resposta é complexa — envolve várias camadas e facetas. Para dar uma base concreta à discussão, é útil começar pensando no percurso dos dados de telemetria coletados. O diagrama abaixo mostra um pipeline de dados em alto nível, destacando os pontos de contato entre o pipeline e a base da arquitetura de dados.
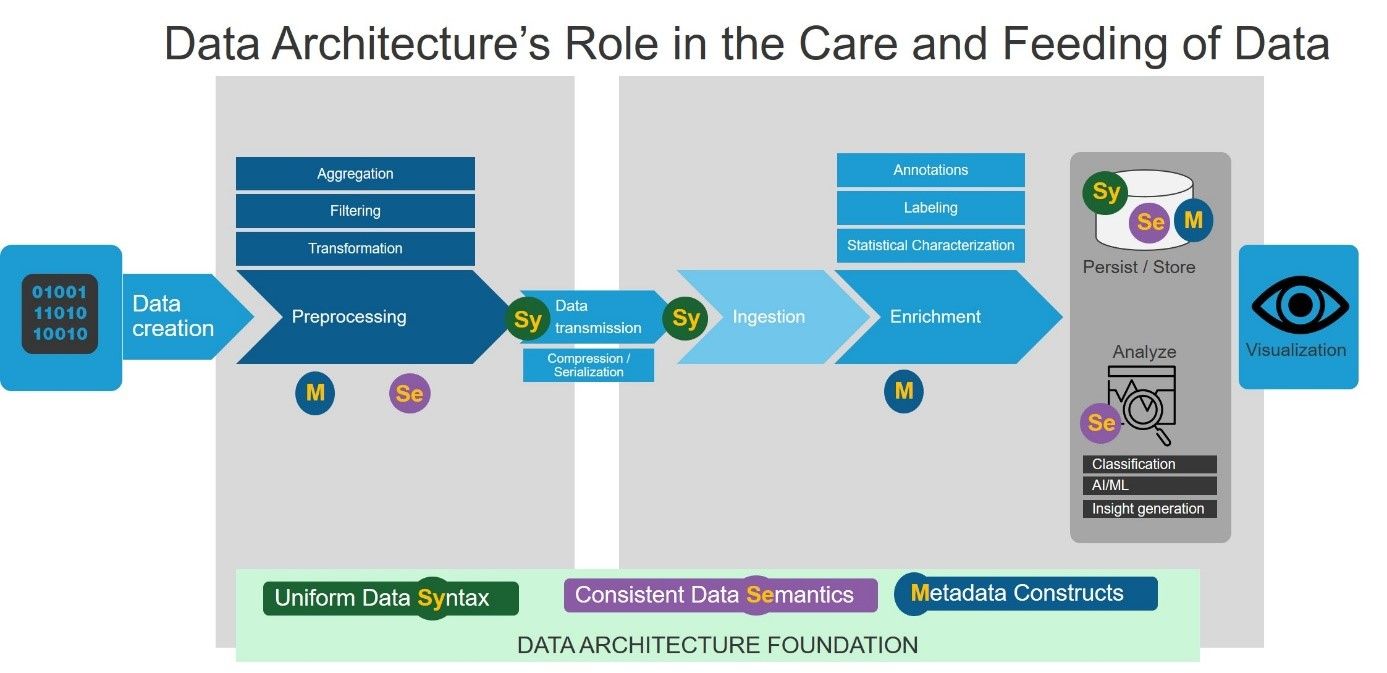
A jornada de cada elemento de dados começa com sua criação, muitas vezes seguida por algum pré-processamento antes de ser serializado e transmitido a um coletor/agregador de dados, normalmente hospedado na nuvem. Em seguida, o próprio coletor de dados pode (após a desserialização e a ingestão) realizar processamento e enriquecimento adicionais antes de enviar os dados para um armazenamento persistente e/ou alimentar um pipeline de análise de dados. Por fim, os resultados enriquecidos/analisados são disponibilizados para consumo humano por meio de uma plataforma de visualização e podem até mesmo ser consumidos por sistemas automatizados na forma de entradas de feedback para sistemas de malha fechada com autoajuste ou autorrecuperação.
Com o contexto do pipeline de dados estabelecido, podemos agora retomar a questão de entender o que significa “arquitetura de dados”. A primeira resposta, no nível mais superficial, concentra-se na representação dos dados e na sintaxe de serialização. Por exemplo, se um evento de dados contiver um campo de objeto chamado ‘customer’, a perspectiva sintática determinará se esses dados serão representados como uma string, um UUID inteiro ou de alguma outra forma.
No entanto, se nos aprofundarmos um pouco mais, uma segunda resposta vai além da mera sintaxe: ela diz respeito à semântica dos dados — ou seja, a uma interpretação bem definida e consistente do conteúdo dos dados. Mais uma vez, usando o campo ‘customer’ como exemplo, suponha que a questão sintática já tenha sido respondida — que, de fato, o elemento de dados tenha sido definido como um campo do tipo string. Em seguida, a arquitetura de dados deve ser capaz de responder à questão do significado e da interpretação: a semântica corresponde ao nome de uma pessoa ou ao nome de uma empresa? Se for o nome de uma pessoa, trata-se de <last-name>, <first-name> ou ambos? Quando combinada a uma sintaxe uniforme, uma semântica consistente permite que o pipeline de dados execute funções como filtragem e agregação de dados de forma genérica e robusta, com base em uma interpretação lógica coerente do conteúdo dos dados. Além disso, o armazenamento de dados também pode realizar facilmente consultas federadas em diferentes instâncias do pipeline de criação de dados, desde que os dados criados sigam uma sintaxe e uma semântica consistentes.
Por fim, aprofundando ainda mais a análise, em muitos casos é importante contar com um terceiro recurso na arquitetura de dados: um vocabulário para contextualizar a telemetria e interpretar os próprios dados — o vocabulário de metadados. Isso é especialmente importante no contexto dos requisitos de governança de dados corporativos, seja para fins de conformidade, auditoria ou até mesmo para fluxos de trabalho internos que exijam uma compreensão abrangente dos dados gerenciados em um data warehouse. Os metadados geralmente assumem a forma de anotações nos dados, seguindo o mesmo tipo de consistência sintática e semântica dos próprios dados. Por exemplo, os campos de metadados provavelmente seriam usados para registrar a identidade da fonte de dados e o histórico do processamento dos dados coletados, a fim de cumprir os requisitos legais de retenção de dados.
Outra forma de usar os campos de metadados no vocabulário de um esquema de descrição de dados é para analisar aspectos dos próprios campos de dados, como a ordinalidade de um elemento de dados ou as questões de privacidade. Retomando mais uma vez nosso exemplo do campo de dados ‘cliente’, as anotações de metadados no esquema de dados poderiam marcar o elemento de dados como exclusivo, enquanto anotações adicionais, no contexto de um fluxo de dados (como o de transações de compras no varejo), poderiam marcar os elementos de dados como obrigatórios e únicos — em outras palavras, os metadados seriam usados para indicar que o campo customerID deve ser exclusivo (podendo ser usado como chave primária do banco de dados) e que cada evento de compra deve ter um, e apenas um, customerID associado. A utilidade do conjunto completo de recursos de metadados, no contexto do pipeline de dados, está no fato de que eles podem ser aproveitados para adicionar anotações de conformidade de dados, fornecer um vocabulário de enriquecimento de dados e viabilizar fluxos de trabalho flexíveis de governança para o data warehouse.
Portanto, em resumo, a resposta à pergunta “O que é arquitetura de dados?” é que ela consiste, no mínimo, em fornecer uma estrutura que garanta consistência sintática e semântica aos dados coletados. Além disso, uma arquitetura de dados robusta também deve abranger uma estratégia de metadados suficientemente poderosa não apenas para especificar restrições aos dados, mas também para permitir análises sobre os próprios dados.
Quando tratada como uma área de foco específica e bem implementada, uma arquitetura de dados se assemelha muito a uma boa infraestrutura de logística militar. Assim como no contexto militar, ela fornece uma base que multiplica a eficiência e a robustez de todos os componentes dos sistemas construídos sobre ela, permitindo que esses sistemas mais visíveis sejam empregados com máxima eficácia. No contexto de um sistema de processamento de dados, a base da arquitetura de dados possibilita modelos mais flexíveis e avançados de governança de dados, facilita o compartilhamento de dados entre diferentes fontes por meio de um data warehouse robusto e permite uma abordagem mais ágil à ingestão de novos fluxos de dados, promovendo a agilidade dos negócios.
Sobre o autor
Publicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.