
A enorme complexidade da entrega de aplicações modernas não se compara à de uma década atrás. Antes, contávamos com estratégias estáticas de balanceamento de carga que distribuíam fluxos de tráfego previsíveis entre alguns poucos servidores. Hoje, lidamos com ambientes multicloud dinâmicos, microsserviços que são iniciados ou encerrados conforme a demanda e bases de usuários que podem saltar de mil para um milhão da noite para o dia. O balanceamento de carga tradicional, orientado por regras, nem sempre consegue acompanhar esse ritmo.
É aí que entra o aprendizado por reforço (RL) entra em cena. Ao observar continuamente seu ambiente e tomar decisões que maximizam o desempenho geral, um agente de RL tem o potencial de se adaptar às mudanças em tempo real melhor do que qualquer script pré-programado. É a diferença entre seguir uma receita à risca e cozinhar por intuição: uma abordagem se adapta a condições conhecidas, enquanto a outra evolui dinamicamente conforme a situação.
Tese: À medida que as infraestruturas de aplicações se tornam cada vez mais complexas, precisamos substituir o balanceamento de carga estático ou baseado em heurísticas por sistemas adaptativos orientados por aprendizado por reforço, a fim de manter a resiliência, otimizar o desempenho e preparar nossas redes para o futuro.
Não faltam exageros em torno da IA, mas o aprendizado por reforço (RL) é uma área em que tanto as pesquisas acadêmicas quanto os projetos-piloto no mundo real estão começando a apresentar resultados concretos e promissores. Não estamos falando de uma possibilidade distante; as técnicas de RL já estão gerando resultados positivos em ambientes de simulação e em determinados ambientes de produção.
Introdução ao aprendizado por reforço: por que ele faz sentido
Antes de nos aprofundarmos, vamos explicar o aprendizado por reforço (RL) de forma mais simples. Imagine um agente — o “cérebro” do sistema — responsável por coletar dados, tomar decisões e adaptar sua estratégia à medida que as condições mudam. Esse agente é inserido em um ambiente dinâmico (como um sistema multinuvem), no qual recebe uma “recompensa” por resultados bem-sucedidos — como reduzir a latência ou aumentar a taxa de transferência. Com o tempo, ele aprimora sua estratégia para obter recompensas maiores com mais frequência.
- Adaptativo e contínuo: Ao contrário de um algoritmo estático, limitado a um conjunto específico de regras, o aprendizado por reforço continua aprendendo com novos padrões de tráfego.
- Lógica escalável: As estruturas de aprendizado por reforço podem coordenar milhares de variáveis — como uso da CPU, consumo de memória ou disponibilidade de nós — e otimizá-las simultaneamente.
- Resiliente a choques: Mudanças repentinas, como um pico no tráfego de comércio eletrônico durante as festas de fim de ano, podem ser corrigidas automaticamente, sem precisar esperar que uma pessoa ajuste os limites.
Controvérsia: o aprendizado por reforço é um exagero?
Alguns engenheiros consideram o RL uma solução excessivamente complexa. “Por que consertar o que não está quebrado?” é uma pergunta comum. Bem, na F5, temos observado novos cenários de clientes — como microsserviços distribuídos globalmente ou implantações de edge multilocatário — nos quais as regras estáticas não são apenas abaixo do ideal, mas às vezes até perigosas. Uma política que era perfeita no último trimestre pode falhar de forma espetacular sob novas condições. A capacidade do RL de se adaptar em meio à incerteza pode ser crucial nesses cenários.
Por dentro da F5: uma visão dos experimentos no mundo real
Na F5, realizamos experimentos de RL em pequena escala em ambientes de simulação modelados com base no tráfego real de clientes. Veja um exemplo:
- A configuração: Criamos um cenário sintético de “maratona de compras” — imagine grandes eventos de compras em diferentes continentes começando simultaneamente. O tráfego aumentava de forma imprevisível, com picos de consultas que exigiam muita memória em horários incomuns.
- O agente de RL: Implantado em um ambiente conteinerizado, o agente de RL ajustava quais microsserviços deveriam ser iniciados com base nos padrões de uso. Ele aprendeu a direcionar tarefas com uso intensivo de CPU para nós com hardware especializado, enquanto transferia processos menos intensivos para instâncias de nuvem mais econômicas.
- Os resultados: Em comparação com uma abordagem clássica de round-robin com algum autoescalonamento, o método baseado em RL reduziu os tempos médios de resposta em 12% a 15%. Além disso, manteve as taxas de erro mais estáveis durante picos extremos de tráfego.
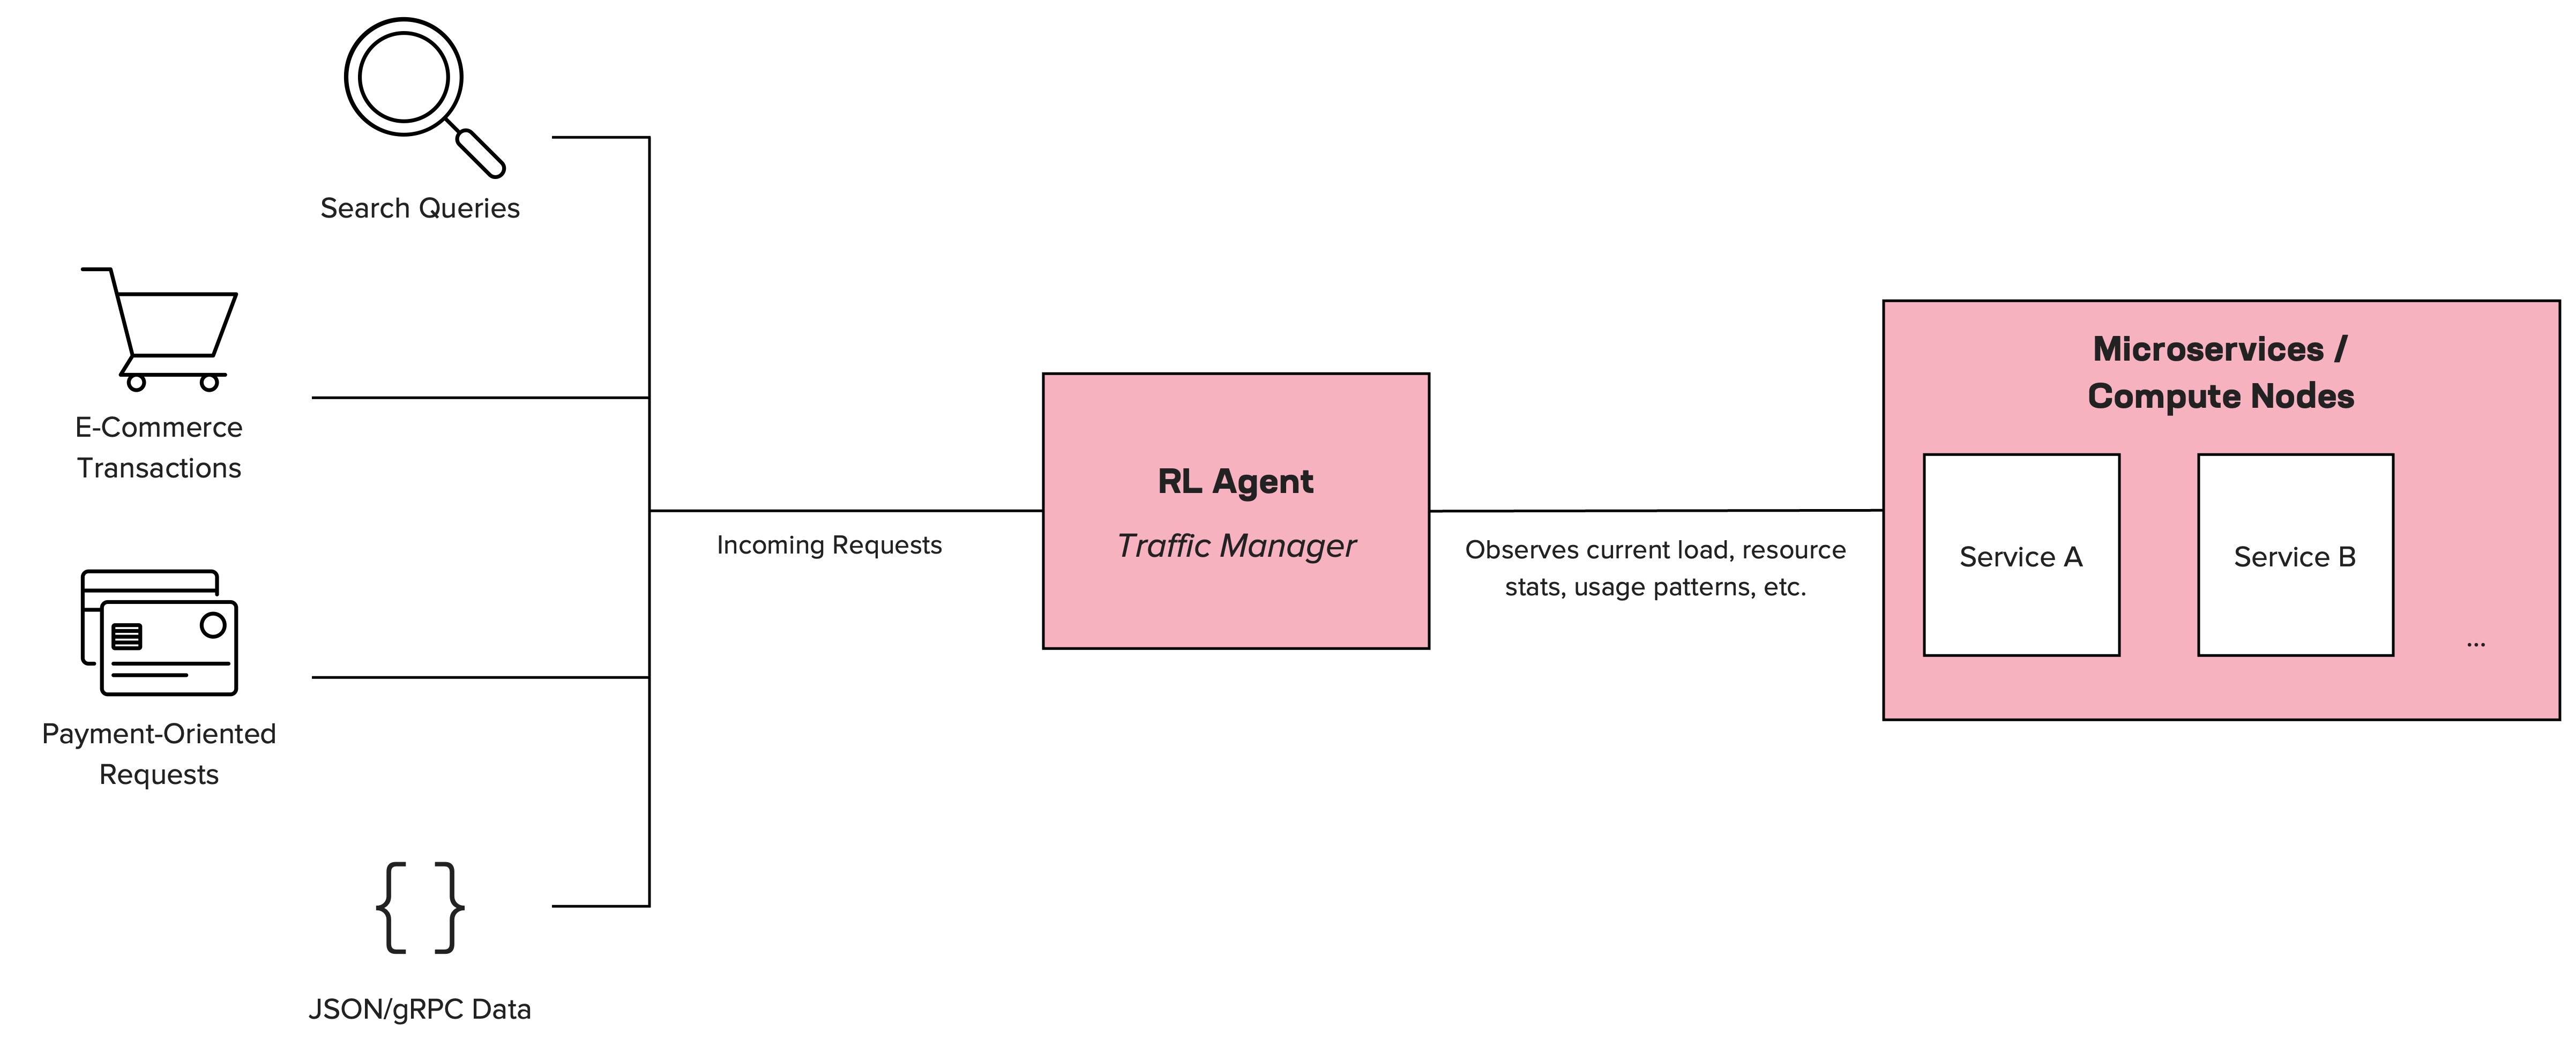
Este diagrama conceitual mostra como o agente de RL atua no lugar de um balanceador de carga típico (ou em conjunto com ele).
- Solicitações recebidas: Usuários ou aplicativos clientes enviam solicitações.
- Agente de RL: Atua como o cérebro do gerenciamento de tráfego. Ele monitora métricas em tempo real (uso da CPU, memória e taxas de erro) e toma decisões de roteamento ou escalonamento.
- Microsserviços / Nós: O agente de RL inicia os microsserviços adequados ou direciona o tráfego para nós específicos com base nos resultados do aprendizado.
Este exemplo mostra o potencial do aprendizado por reforço (RL) para superar o balanceamento de carga tradicional em muitos cenários.
Possíveis armadilhas: não se deixe levar pelo entusiasmo ainda
É claro que o RL não é uma solução milagrosa. O treinamento pode ser demorado, e tivemos que investir em um monitoramento robusto para garantir que o agente de RL não estivesse “manipulando” o sinal de recompensa ao tomar decisões de curto prazo que prejudicassem o resultado geral. Ainda assim, quando funciona, o RL pode superar as heurísticas tradicionais por uma margem considerável. Veja a seguir alguns outros pontos a considerar:
1. Complexidade vs. confiabilidade
- Problema: O aprendizado por reforço introduz uma nova camada de complexidade em sistemas que já são complexos. Se não for gerenciado com cuidado, um agente pode ficar preso em ótimos locais ou perseguir objetivos conflitantes (vazão vs. custo vs. latência).
- Mitigação: Abordagens híbridas em que o aprendizado por reforço (RL) cuida das decisões de alto nível, enquanto heurísticas comprovadas atuam como mecanismos de segurança.
2. Qualidade dos dados e definição de recompensas
- Problema: O aprendizado por reforço depende de sinais de recompensa. Se suas métricas estiverem incorretas ou você incentivar o comportamento errado, o agente poderá explorar peculiaridades do ambiente que não se traduzem em valor real para o negócio.
- Mitigação: Invista em monitoramento robusto, definição de métricas e testes offline abrangentes.
3. Preocupações éticas e regulatórias
- Problema: Se um agente de aprendizado por reforço discriminar inadvertidamente determinadas regiões ou padrões de uso em busca de eficiência de custos, ele poderá ultrapassar limites éticos ou legais.
- Mitigação: As equipes de implementação devem definir previamente as ações permitidas e auditar regularmente as decisões orientadas por aprendizado de máquina.
Tendências mais amplas de adoção no setor em 2025
Além dos nossos experimentos internos, o setor está em polvorosa com o RL. Alguns destaques:
- Artigos de conferências: Eventos de IA de prestígio — como a NeurIPS ‘24 — contam com trilhas inteiras dedicadas ao aprendizado por reforço distribuído para otimização de redes.
- Provedores de nuvem: Os principais provedores de nuvem agora oferecem kits de ferramentas especializados para escalonamento automático e roteamento de tráfego baseados em aprendizado por reforço, reduzindo a distância entre a pesquisa acadêmica e as ferramentas práticas.
- Implantações na borda: Com o surgimento do 5G e das redes de borda, há uma necessidade urgente de coordenar recursos entre vários data centers de pequeno porte. A adaptabilidade do aprendizado por reforço é ideal para essas arquiteturas dinâmicas e geograficamente distribuídas.
Ainda assim, a adoção do RL pelas empresas para o gerenciamento de tráfego ainda está em seus estágios iniciais. Muitas empresas continuam hesitantes devido a preocupações com a imprevisibilidade ou a dificuldades para explicar as decisões do RL às equipes de conformidade ou aos órgãos reguladores. Isso ressalta a importância da IA Explicável (XAI) — uma área de pesquisa ativa que busca esclarecer como os modelos de ML chegam às suas decisões.
Uma visão para 2030
Na minha visão, nos próximos cinco anos, o gerenciamento de tráfego baseado em RL deixará de ser usado apenas em testes de nicho e passará a ser adotado de forma mais ampla por empresas inovadoras. Até 2030, prevejo que:
- Orquestração dinâmica de múltiplas nuvens: O RL se tornará o padrão para orquestrar cargas de trabalho em várias nuvens públicas e privadas, otimizando custos e desempenho com muito mais eficiência do que os ajustes manuais atuais.
- Integração mais estreita com a observabilidade de IA: Ferramentas que registram, visualizam e interpretam de forma integrada as decisões dos agentes de RL reduzirão as preocupações com conformidade e simplificarão a depuração.
- Agentes colaborativos: Veremos vários agentes de RL trabalhando juntos em um único ambiente, cada um com tarefas especializadas, como uma equipe de especialistas — alguns cuidando da alocação de recursos, outros se concentrando em restrições de segurança ou de qualidade de serviço.
Embora alguns céticos questionem se o aprendizado por reforço (RL) cumprirá essas promessas, vejo essa tecnologia como um caminho promissor para superar os desafios inevitáveis decorrentes do aumento da complexidade. Pela minha experiência, esse movimento já está ganhando força, e estou confiante de que o RL continuará moldando o futuro do gerenciamento de tráfego à medida que as empresas buscam soluções mais adaptáveis e inteligentes.
Seus próximos passos
Então, está na hora de descartar seus balanceadores de carga já testados e aprovados? Ainda não — mas, se você ainda não começou, sem dúvida é hora de experimentar abordagens baseadas em RL. Teste-as em ambientes de menor risco, avalie os ganhos de desempenho e colabore com equipes multidisciplinares. Isso ajudará você a criar um roteiro prático que equilibre o potencial da RL com as limitações do mundo real.
Publicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.