Die Rolle und die Auswirkungen von GraphQL
Von Rajesh Narayanan
Geprüft von und mit Beiträgen des OCTO-Teams und weiterer Mitwirkender.
Stellungnahme des F5 Office of the CTO
GraphQL hat sich als moderner und effizienter Ansatz für die API-Entwicklung etabliert, der die Einschränkungen herkömmlicher REST-APIs überwindet. Während REST bereits seit den Anfängen des Internets weit verbreitet ist, bietet GraphQL Entwicklern eine neue Perspektive und mehr Kontrolle. Mit GraphQL können Entwickler ein streng typisiertes Schema definieren, das es Clients ermöglicht, genau die benötigten Daten anzufordern. Indem GraphQL sowohl das Abrufen überflüssiger Daten als auch unvollständige Datenabfragen vermeidet, optimiert es die Leistung und erleichtert die Entwicklung moderner, interaktiver Webanwendungen mit komplexen Anforderungen an Datenabfragen und Datenmodellierung.
Wir sind uns jedoch bewusst, dass GraphQL auch Herausforderungen mit sich bringt. Dieses Whitepaper beleuchtet die Sicherheitsbedenken und die Lernkurve, die mit der Einführung von GraphQL verbunden sind. Anhand realer Fallstudien untersuchen wir, welche Vorteile namhafte Unternehmen durch die erfolgreiche Implementierung von GraphQL erzielt haben.
Darüber hinaus stellen wir unsere eigene Untersuchung zu GraphQL vor und berichten über unsere Erfahrungen und Erkenntnisse. Wir geben eine kurze Einführung in GraphQL, vergleichen es mit REST und gehen näher auf die Herausforderungen ein, die es bewältigt. Auch Sicherheitsaspekte werden erörtert, um Organisationen dabei zu unterstützen, fundierte Entscheidungen zu treffen. Unsere Forschung zeigt das transformative Potenzial von GraphQL. Wir veranschaulichen, wie wir die Softwarearchitektur einer Testmanagement-Suite vereinfacht haben, wodurch die Menge der über GraphQL zugänglich gemachten, in JSON-Objekten verborgenen Daten um mehr als 300 % gestiegen ist.
Abschließend empfehlen wir Unternehmen, die mit der Skalierung, Optimierung oder dem Betrieb einer REST-API-Infrastruktur zu kämpfen haben, nachdrücklich, GraphQL als praktikable Lösung in Betracht zu ziehen. Unsere Erkenntnisse bieten all jenen, die sich auf den Weg mit GraphQL machen, praktische Orientierung und ermöglichen es ihnen, dessen Vorteile zu nutzen und Herausforderungen effektiv zu bewältigen.
Einführung in GraphQL
WARUM GRAPHQL?
Die Einschränkungen von REST-APIs führen zu einer steigenden Nachfrage nach einem neuen Ansatz für API-Technologien.
Der auf REST (Representational State Transfer) basierende Ansatz wurde ursprünglich als eine Reihe von Architekturprinzipien für die Entwicklung von Web-APIs vorgeschlagen. Mit dem Aufkommen des Web 2.0 entwickelte sich REST in den 2000er- und 2010er-Jahren zu einer besseren Möglichkeit, serviceorientierte Architekturen (SOA) zu implementieren, als andere Technologien wie die Common Object Request Broker Architecture (CORBA).
Mit der zunehmenden Verbreitung mobiler Geräte stieg die Zahl der Clients und damit auch der Bedarf an präzisen Daten. REST-basierte APIs führten jedoch häufig dazu, dass zu viele oder zu wenige Daten abgerufen wurden, was Ineffizienzen zur Folge hatte. Bei diesem Ansatz, wie ihn beispielsweise Apps wie Facebook nutzten, waren für eine einzige Aktualisierung oft zahlreiche REST-API-Aufrufe erforderlich. Dadurch erhöhte sich der Netzwerkverkehr, während Leistung und Benutzererlebnis beeinträchtigt wurden.
GraphQL wurde speziell entwickelt, um diese Einschränkungen durch ein stark typisiertes Schema und eine effizientere Möglichkeit zur Datenabfrage zu beheben. Dadurch eignet es sich besonders für Anwendungsfälle, in denen gezielt bestimmte Daten benötigt werden, um die Netzwerkbandbreite optimal zu nutzen. Darüber hinaus ermöglicht die Fähigkeit von GraphQL zur Schema-Introspektion eine bessere Dokumentation und leistungsfähigere Tools. Eine stärker standardisierte Implementierung von REST hätte zwar eine gewisse Konkurrenz darstellen können, doch die einzigartigen Funktionen und Vorteile von GraphQL machen es zu einer überzeugenden Wahl für moderne, verteilte und datenintensive Anwendungsarchitekturen.
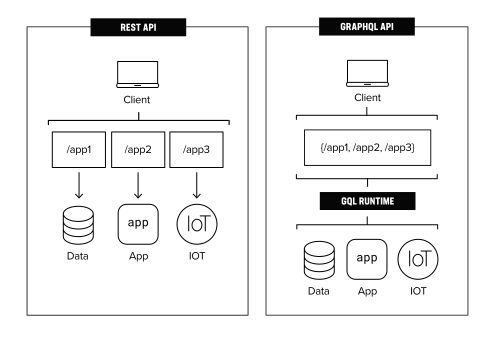
Abbildung 1 zeigt einen topologischen Unterschied bei der Implementierung von REST und GraphQL. Wie in „REST API vs. GraphQL“ erläutert wird, „besteht der wesentliche Unterschied zwischen GraphQL- und REST-APIs darin, dass GraphQL eine Abfragesprache ist, während REST ein Architekturkonzept für netzwerkbasierte Software darstellt.“
METAS MOTIVATION FÜR GRAPHQL
Meta entwickelte GraphQL im Jahr 2012 (als Open Source veröffentlicht 2015), um die Leistung und Flexibilität seiner mobilen Apps zu verbessern. Vor GraphQL basierten Metas mobile Apps auf einer Kombination aus RESTful APIs und nativem Code, wodurch es schwierig war, die Vielzahl an Geräten, Bildschirmgrößen und Netzwerkbedingungen zu unterstützen, für die die Apps ausgelegt sein mussten.
Eine der größten Herausforderungen bestand darin, dass RESTful APIs häufig nicht die richtige Datenmenge zurückgaben – manchmal zu viele und manchmal zu wenige Daten. Wenn die API große Datenmengen zurückgab, die von den mobilen Apps nicht benötigt wurden, führte dies zu langen Ladezeiten und einer schlechten Performance. Gab die API hingegen zu wenige Daten zurück, mussten die mobilen Apps mehrere Anfragen an verschiedene Endpunkte senden, um alle benötigten Daten abzurufen. Dies erhöhte die Latenz und machte den Prozess komplexer.
Meta entwickelte GraphQL, damit jede App mit einer einzigen Anfrage genau die benötigten Daten abrufen konnte. Dadurch ließ sich die Datenübertragung zwischen den mobilen Apps und den Backend-Diensten optimieren, was zu kürzeren Ladezeiten und einer besseren Leistung führte. Darüber hinaus erleichterten die starke Typisierung und die selbstdokumentierenden Funktionen von GraphQL den Entwicklern das Verständnis und die Nutzung der API.
VORTEILE VON GRAPHQL
GraphQL bietet leistungsstarke Funktionen zum Abrufen und Bearbeiten von Daten und damit erhebliche Vorteile gegenüber herkömmlichen API-Ansätzen.
Streng typisierte Schemas
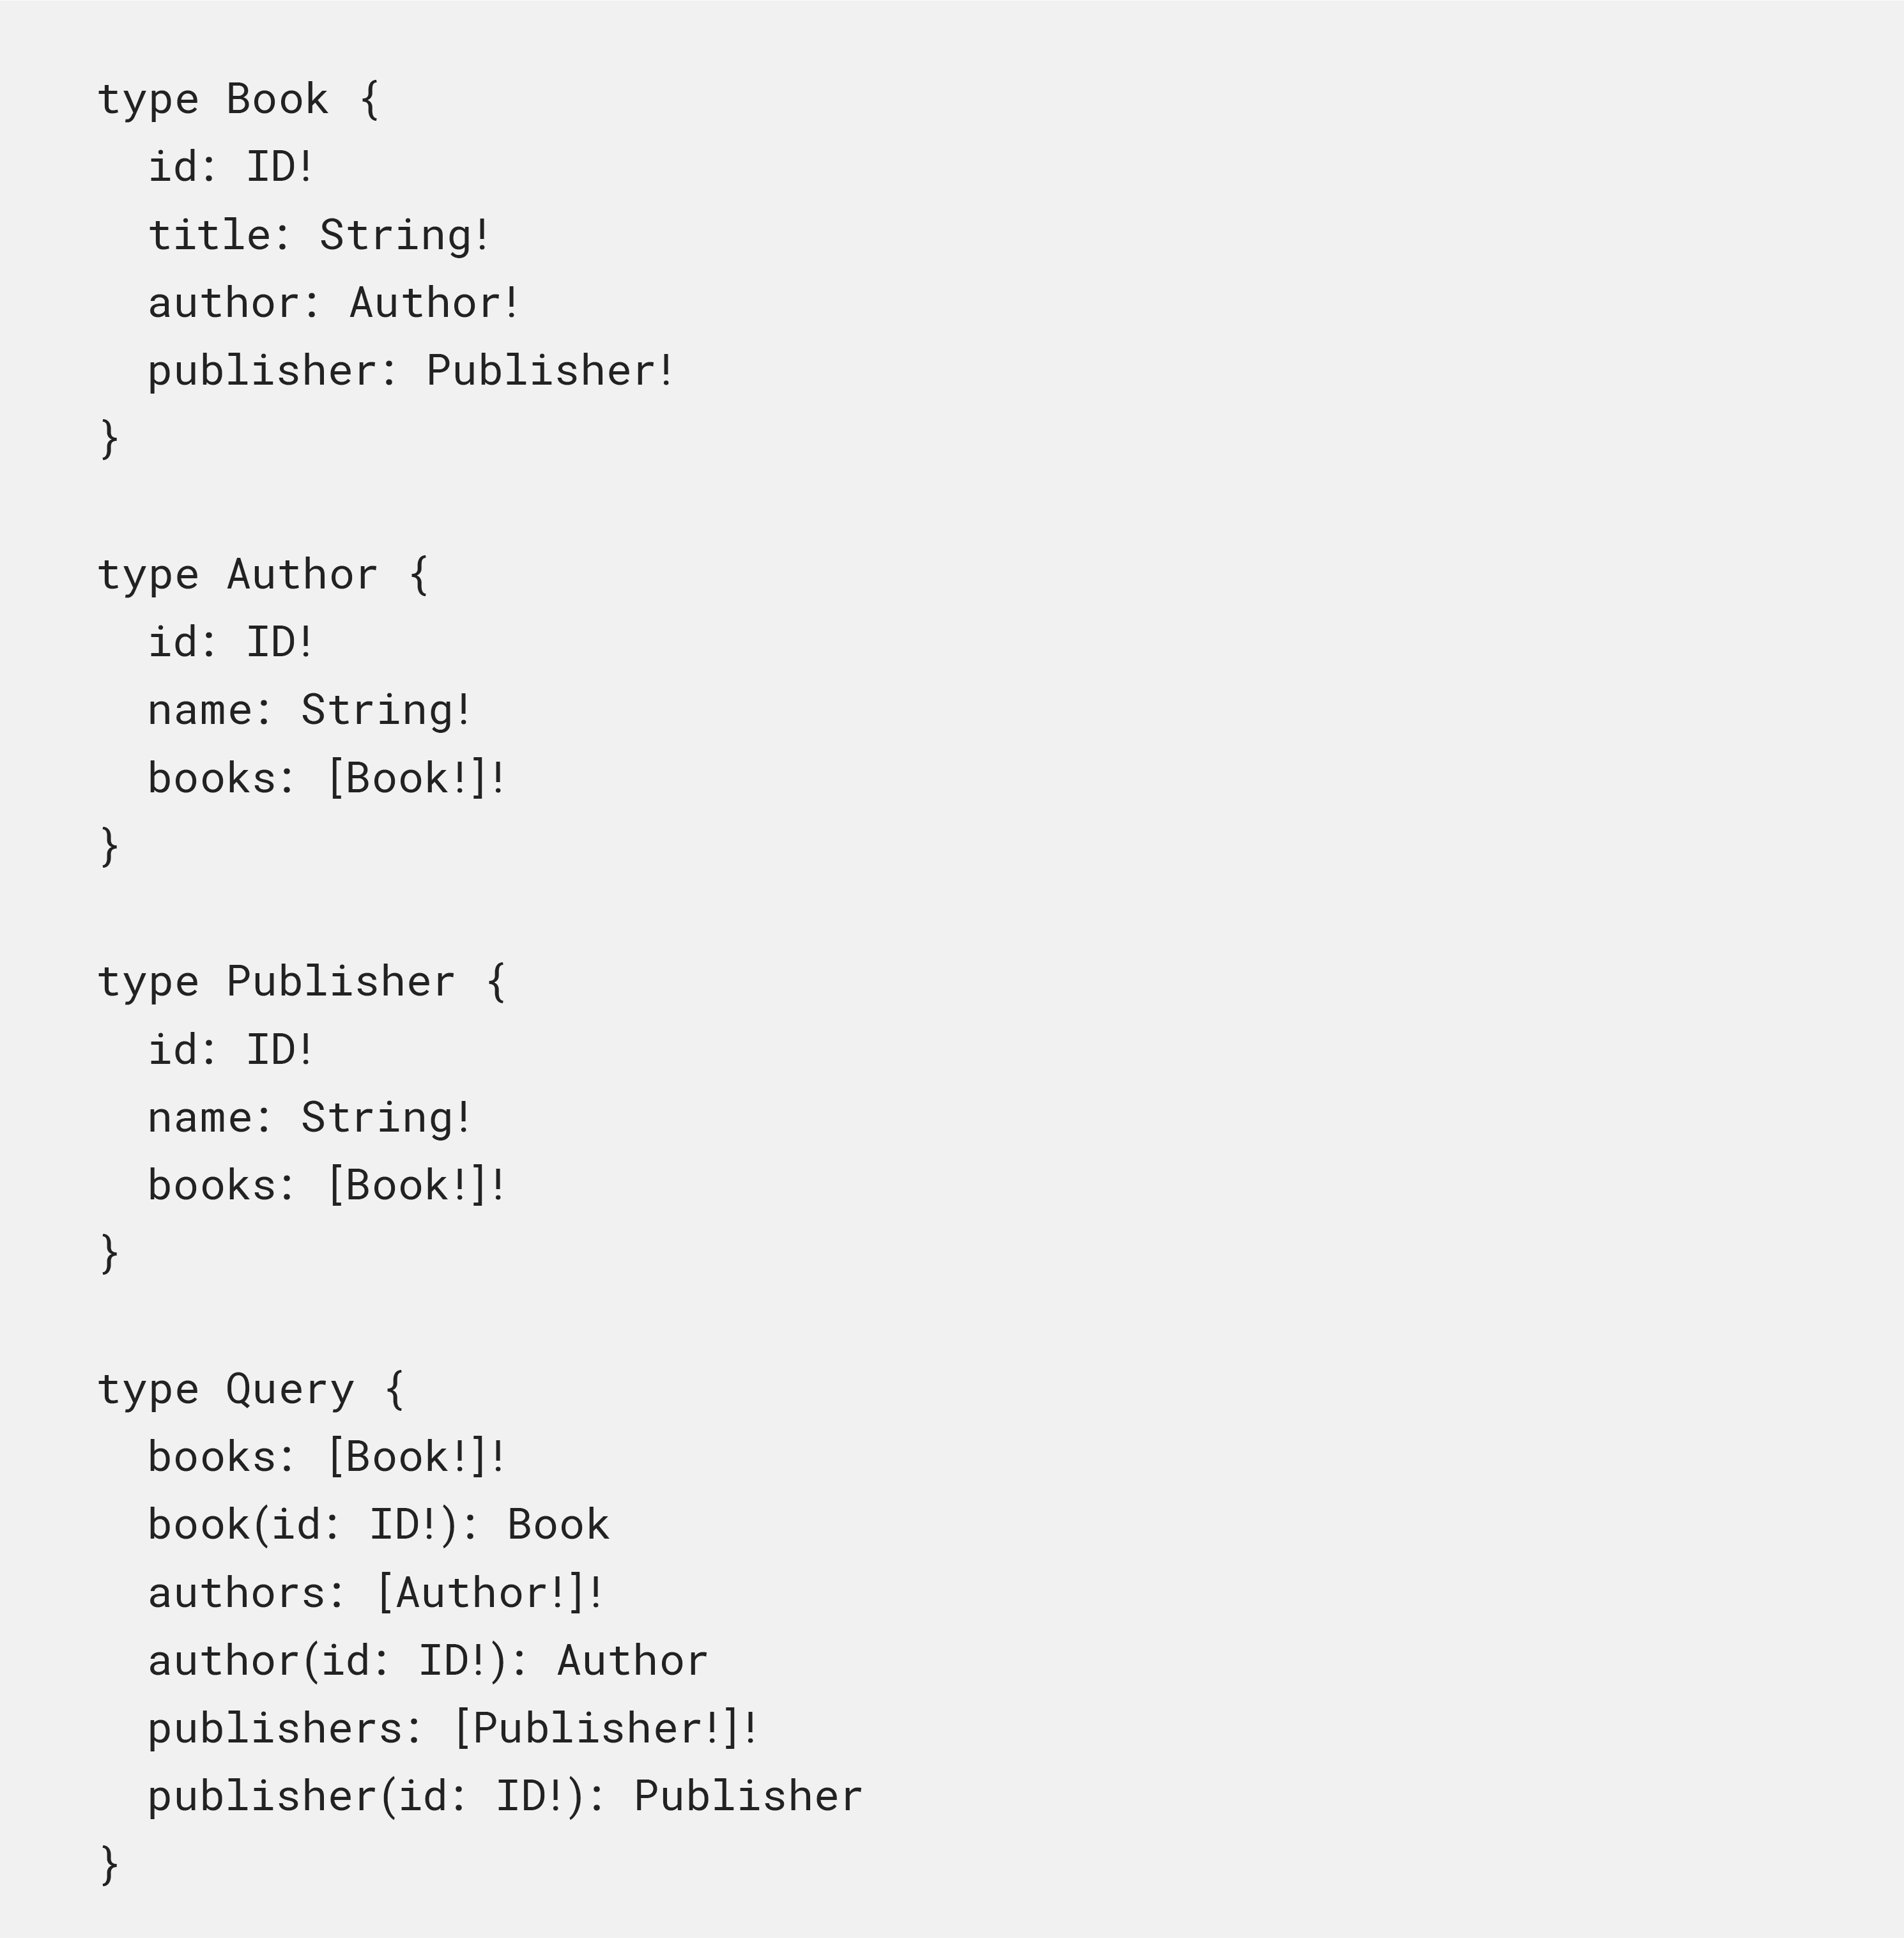
GraphQL verfügt über ein stark typisiertes Schema, das für Klarheit und Genauigkeit bei der Definition der Struktur und der Typen von Daten sorgt, die über eine API abgefragt werden können. Nehmen wir an, wir haben eine API für eine Bibliothek, die Bücher, Autoren und Verlage umfasst.
a) GraphQL-Schema: In GraphQL würde ein stark typisiertes Schema wie in der nachstehenden Abbildung 2 aussehen:
Streng typisierte Schemas in GraphQL bieten Sicherheitsvorteile, da sie die Validierung von Eingaben ermöglichen, das übermäßige oder unzureichende Abrufen von Daten verhindern, eine klare Dokumentation und Tool-Unterstützung bereitstellen, die Versionskontrolle erleichtern und die Autorisierung sowie Zugriffskontrolle unterstützen. Diese Funktionen erhöhen die API-Sicherheit, indem sie das Risiko gängiger Schwachstellen verringern und eine ordnungsgemäße Datenverarbeitung und Zugriffsverwaltung gewährleisten.
Im gezeigten Beispiel (Abbildung 2) definiert das Schema die Datentypen für Bücher, Autoren und Verlage sowie deren Beziehungen zueinander. Das Schema ist streng typisiert, was bedeutet, dass jedes Feld einen bestimmten Datentyp hat und Clients das Schema problemlos introspektieren können, um die verfügbaren Felder und deren Typen zu ermitteln.
b) REST-Schema: Bei REST wäre die Schemadefinition lose typisiert, wie in Abbildung 3 unten dargestellt:
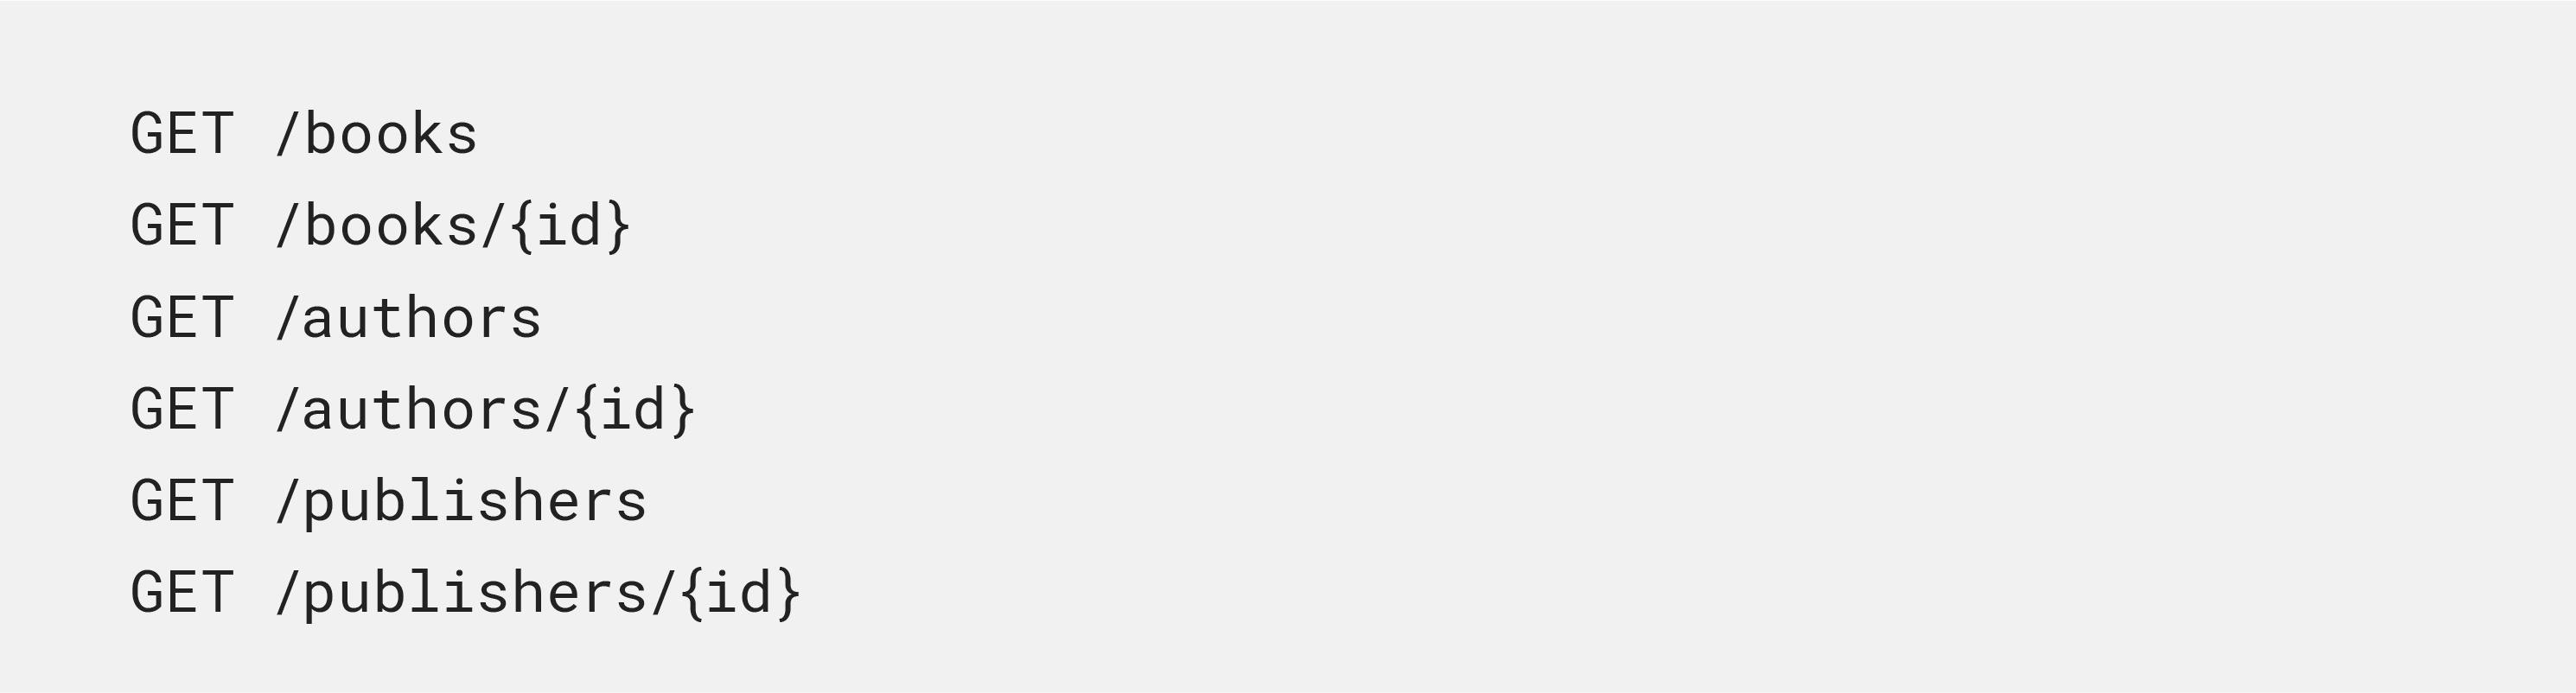
Diese Endpunkte geben JSON-Objekte zurück, die die Bücher, Autoren und Verlage repräsentieren. Das Schema selbst ist jedoch nicht explizit definiert und hängt von den Fähigkeiten und der Interpretation des Programmierers ab. Clients müssen sich auf die Dokumentation stützen, um die Struktur der Daten zu verstehen.
Über REST hinaus
GraphQL hat sich über eine bloß bessere Alternative zu REST hinausentwickelt und hat das Potenzial, zum bevorzugten Ansatz für Unternehmen zu werden, die eine bessere Datenstrategie anstreben. Neben der Überwindung der Einschränkungen von REST gibt es mehrere weitere Gründe dafür, dass sich GraphQL zu einem neuen Ansatz für das API-Design entwickelt hat. Die Tabelle (Abbildung 4) kann zwar die Vorteile von GraphQL gegenüber REST aufzeigen, doch GraphQL ist eher als Reaktion auf die Weiterentwicklung des Internets und der verschiedenen Anwendungen zu verstehen als auf die Feststellung von Problemen mit REST selbst.
| MERKMALE | GRAPHQL | REST |
|---|---|---|
FLEXIBLE DATENMODELLIERUNG |
Mit GraphQL können Entwickler APIs einfach definieren und weiterentwickeln, um sie an veränderte Anforderungen anzupassen. Clients können mithilfe der Abfragesprache genau angeben, welche Daten sie benötigen. Dies ermöglicht einen flexibleren und effizienteren Datenabruf. |
Der Server definiert in der Regel feste Endpunkte, die vordefinierte Datenstrukturen zurückgeben. Clients haben nur begrenzte Kontrolle über Form und Struktur der Antwort, was häufig dazu führt, dass zu viele oder zu wenige Daten abgerufen werden. REST bietet nicht die differenzierte Kontrolle über Datenabruf und -zusammenstellung, die GraphQL ermöglicht. |
GEBÜNDELTE ABFRAGEN |
Mit GraphQL können mehrere Abfragen in einer einzigen Anfrage zusammengefasst werden. Dadurch lässt sich die Anzahl der Übertragungswege zwischen Client und Server erheblich reduzieren und die Performance verbessern. |
REST verfügt über keinen integrierten Mechanismus, um mehrere Abfragen in einer einzigen Anfrage zu bündeln. Jede REST-Anfrage entspricht in der Regel einer einzelnen Ressource oder einem einzelnen Endpunkt. Einige REST-Frameworks oder -Erweiterungen bieten möglicherweise Möglichkeiten, mehrere Anfragen zu bündeln. Diese sind jedoch anders als bei GraphQL weder nativ noch standardisiert. |
TYPISIERTE ABFRAGEN UND ANTWORTEN |
Clients können genau angeben, welche Daten sie benötigen, und Server können ausschließlich die angeforderten Daten zurückgeben. Dadurch wird vermieden, dass zu viele oder zu wenige Daten abgerufen werden. Darüber hinaus ist GraphQL stark typisiert, was Fehler vermeiden hilft und die Werkzeugunterstützung verbessert. |
Bei Abfragen und Antworten wird die Typisierung nicht grundsätzlich erzwungen. Struktur und Format der Daten werden in der Regel vom Server vorgegeben, und Clients müssen die Daten entsprechend interpretieren und verarbeiten. Dies kann zu einer geringeren Typsicherheit führen. |
INTEGRATION IN FRONTEND-FRAMEWORKS |
GraphQL ist für die reibungslose Zusammenarbeit mit Frontend-Frameworks wie React und Vue konzipiert und erleichtert so die Entwicklung moderner, interaktiver Webanwendungen. GraphQL bietet spezielle Bibliotheken und Werkzeuge für eine nahtlose Integration. |
REST kann zwar mit Frontend-Frameworks verwendet werden, die Integration erfordert jedoch möglicherweise mehr manuellen Aufwand und individuelle Implementierungen. Es gibt zwar Bibliotheken von Drittanbietern, REST bietet jedoch keine standardisierte Möglichkeit zur Integration in bestimmte Frontend-Frameworks wie React oder Vue. |
GRAPHBASIERTE ABFRAGEN |
GraphQL ermöglicht komplexe Abfragen, die mehrere Ressourcen und Beziehungen in einer einzigen Anfrage umfassen. Dadurch lassen sich die für die Entwicklung komplexer Benutzeroberflächen benötigten Daten leichter abrufen. |
REST verfolgt in der Regel einen ressourcenorientierten Ansatz, bei dem jeder Endpunkt eine bestimmte Ressource oder Entität repräsentiert. REST bietet von sich aus keinen Mechanismus, um Daten aus mehreren Ressourcen oder Beziehungen in einer einzigen Anfrage abzufragen. |
PERFORMANCE |
Da mit GraphQL gezielt nur die benötigten Daten angefordert werden können, lassen sich Daten effizienter abrufen und die Performance verbessern. |
Bei REST-APIs werden möglicherweise zu viele oder zu wenige Daten abgerufen, da Clients nur begrenzte Kontrolle über die Antwortstruktur haben. Dies kann die Performance beeinträchtigen, insbesondere wenn die API übermäßig viele oder unnötige Daten zurückgibt. |
ENTWICKLERPRODUKTIVITÄT |
Da GraphQL dank seiner Introspektionsfunktionen selbstdokumentierend ist, sind weniger umfangreiche Dokumentationen erforderlich und das Datenmodell wird leichter verständlich. Ein stark typisiertes Schema und die Validierung von Abfragen fördern ein gemeinsames Verständnis und erkennen Fehler frühzeitig. GraphQL verfügt über eine intuitive Abfragesprache und ist leichter zu erlernen, was die Einarbeitung und den Wissenstransfer innerhalb von Entwicklungsteams erleichtert. |
Da ein standardisierter Vertrag zwischen Client und Server fehlt, leidet das informelle Teamwissen. REST-APIs stützen sich in der Regel auf informelle Dokumentationen oder Konventionen, die je nach Implementierung variieren. Das fehlende gemeinsame Verständnis führt zu Inkonsistenzen und Wissenslücken innerhalb der Teams. Dadurch müssen erfahrenere Entwickler wertvolle Zeit für die Einarbeitung anderer Teammitglieder aufwenden, anstatt sich auf das geschäftliche Problem zu konzentrieren. Diese Abhängigkeit von Einzelpersonen bei der Dokumentation führt zu fragmentiertem Teamwissen und erschwert es allen Teammitgliedern, sich ein umfassendes Bild von den Funktionen und Datenstrukturen der API zu machen. |
API-VERSIONIERUNG |
Der inhärente Vorteil von GraphQL bei der Versionierung besteht darin, dass Felder, die entfernt werden sollen, als veraltet gekennzeichnet werden können. So haben die Entwickler auf Clientseite Zeit, entsprechende Anpassungen vorzunehmen. Eine Versionierung ähnlich wie bei REST-APIs ist weiterhin möglich. |
REST bietet von sich aus keine Möglichkeit, Felder als veraltet zu kennzeichnen. Die Entwickler auf Clientseite müssen selbst sicherstellen, dass sie die richtige Version der API verwenden. |
Abbildung 4: Vorteile von GraphQL gegenüber REST
HERAUSFORDERUNGEN BEI GRAPHQL
GraphQL bietet zwar viele Vorteile gegenüber herkömmlichen RESTful APIs, bringt jedoch auch einige Herausforderungen mit sich. Zu den häufigsten Herausforderungen gehören:
- Lernkurve: Da die meisten Entwickler mit REST besser vertraut sind, müssen Unternehmen, die GraphQL einführen möchten, Zeit dafür einplanen, dass ihre Teams den effektiven Umgang damit erlernen. GraphQL erfordert eine andere Herangehensweise an die Entwicklung und Nutzung von APIs, und seine Einführung könnte Änderungen an der zugrunde liegenden Anwendungsarchitektur erforderlich machen. Entwickler müssen sich möglicherweise mit neuen Konzepten wie Schemas, Resolvern und Typen sowie mit neuen Tools und Bibliotheken vertraut machen. Mit GraphQL haben Clients mehr Kontrolle über die Daten, auf die sie zugreifen können, was die Absicherung von APIs erschweren kann. Techniken wie Eingabevalidierung, Authentifizierung und Autorisierung müssen möglicherweise anders angewendet werden als bei RESTful APIs.
- Caching: Caching kann bei GraphQL komplexer sein, da Clients mit jeder Abfrage unterschiedliche Daten anfordern können, wodurch es schwieriger wird, Antworten zwischenzuspeichern und wiederzuverwenden.
- Performance: GraphQL ermöglicht es Clients zwar, nur die benötigten Daten anzufordern, kann aber auch komplexere und ressourcenintensivere Abfragen ermöglichen. Bei GraphQL-APIs können Performanceprobleme auftreten, insbesondere bei der Abfrage großer Datensätze oder bei einer hohen Anzahl gleichzeitiger Anfragen. Entwickler müssen Strategien implementieren, etwa die Abfragetiefe begrenzen oder sicherstellen, dass Clients nur zum Zugriff auf die jeweils benötigten Daten berechtigt sind.
- Fehlerbehandlung: GraphQL kann die Fehlerbehandlung komplexer machen, da Fehler möglicherweise als Teil der Antwort und nicht in Form eines separaten HTTP-Statuscodes zurückgegeben werden.
- Tests: Das Testen mit GraphQL ist aufgrund der Komplexität der Abfragen, fehlender standardisierter Testansätze, der Weiterentwicklung des Schemas und der Validierung von Abfragen zur Laufzeit mit Herausforderungen verbunden. Entwickler müssen Zeit investieren, um geeignete Test-Frameworks und Tools zur Bewältigung dieser Herausforderungen zu finden. Sie müssen eine umfassende Testabdeckung sicherstellen, indem sie geeignete Tools auswählen und die Weiterentwicklung des Schemas berücksichtigen, um GraphQL-APIs effektiv zu testen und deren Funktionalität und Stabilität zu gewährleisten.
- Überwachung: Die Überwachung von GraphQL-APIs kann aufgrund der Komplexität der Abfragen, fehlender Standards für Protokollierung und Metriken sowie möglicher Leistungsprobleme eine Herausforderung darstellen. Die dynamische Natur von GraphQL-Abfragen erschwert es, Struktur und Umfang der angeforderten Daten vorherzusagen und zu überwachen. Da es keine standardisierten Überwachungstools speziell für GraphQL-APIs gibt, ist es schwierig, Einblicke in die Leistung von GraphQL-Abfragen, die Fehlerverfolgung und den Zustand der API zu gewinnen. Entwickler müssen spezielle Überwachungstools und -verfahren einsetzen, die den besonderen Eigenschaften von GraphQL gerecht werden und so eine effiziente Leistung und einen zuverlässigen Betrieb gewährleisten.
GraphQL-Nutzungsmuster
GraphQL ist ein leistungsstarkes Werkzeug, das in einer Vielzahl von Anwendungen eingesetzt werden kann – von der Entwicklung von APIs bis hin zur Bereitstellung der technischen Grundlage für mobile Apps. Dank seiner Flexibilität und der Möglichkeit, Datenquellen zu vereinheitlichen, eignet es sich hervorragend für unterschiedlichste Nutzungsmuster.
- Effiziente APIs entwickeln: Einer der wichtigsten Anwendungsbereiche von GraphQL ist die Entwicklung von APIs, die von Web- und mobilen Anwendungen genutzt werden können. GraphQL bietet eine flexible und leistungsstarke Möglichkeit, Daten zu definieren und darauf zuzugreifen. Daher eignet es sich hervorragend für die Entwicklung von APIs, die eine Vielzahl von Clients und Anwendungsfällen unterstützen müssen.
- Datenabruf und -bearbeitung: GraphQL kann verwendet werden, um Daten aus verschiedenen Quellen abzurufen und zu bearbeiten, darunter Datenbanken, Cloud-Dienste und andere APIs. Durch die Bereitstellung einer einheitlichen Möglichkeit für den Datenzugriff kann GraphQL die Entwicklung und Pflege datengestützter Anwendungen vereinfachen.
- Echtzeit-Anwendungsfälle: GraphQL eignet sich hervorragend für Echtzeit-Anwendungsfälle, da Clients Aktualisierungen bestimmter Daten abonnieren und Benachrichtigungen erhalten können, wenn sich diese Daten ändern. Dies kann in Anwendungen wie Chats, Live-Streaming, Echtzeit-Dashboards und vielen weiteren eingesetzt werden.
- Microservices: Mit GraphQL lässt sich eine flexible, lose gekoppelte Architektur aufbauen, die es verschiedenen Microservices ermöglicht, auf einheitliche und klar definierte Weise miteinander zu kommunizieren.
- Backend für das Frontend: Mit GraphQL lässt sich eine Backend-for-Frontend-Architektur (BFF) aufbauen, die verschiedenen Frontend-Clients einen einheitlichen und effizienten Zugriff auf Daten und Dienste ermöglicht.
- Mobile Entwicklung: GraphQL kann zur Unterstützung mobiler Apps eingesetzt werden, indem es unabhängig von der Plattform oder dem Gerät einen einheitlichen und effizienten Zugriff auf Daten und Dienste ermöglicht.
Erfahrungen mit der Einführung von GraphQL in der Industrie (Fallstudien)
Die Gründe für den Einsatz von GraphQL liegen auf der Hand, wie die folgenden Implementierungen in der Praxis zeigen:
NETFLIX
Netflix fasste seine GraphQL-Reise im Jahr 2020 in einer zweiteiligen Blogserie zusammen, die für alle GraphQL-Fachleute Pflichtlektüre ist. In der vorgestellten Fallstudie ging es um das Studio-Edge-System, bei dem die Studio-APIs für GraphQL neu konzipiert wurden. Die Studio-API von Netflix wird von den Content-Teams genutzt, um die Produktion, Postproduktion und Distribution von Serien und Filmen zu verwalten und zu überwachen. Die API bietet Zugriff auf eine enorme Datenmenge, darunter Metadaten zu Titeln, Informationen zu Mitwirkenden und vieles mehr.
Ursprünglich basierte die Studio-API auf einer herkömmlichen RESTful-Architektur mit Endpunkten, die Daten im JSON-Format zurückgaben. Als die API jedoch wuchs und immer mehr Clients darauf zugriffen, wurde deutlich, dass eine effizientere Lösung erforderlich war.
Netflix begann, GraphQL als mögliche Lösung für die Studio API zu prüfen. Zunächst erstellte das Unternehmen einen kuratierten Graphen für die Studio API. Dabei wurden mehrere entscheidende Vorteile erkannt, darunter die Möglichkeit, die Netzwerkauslastung zu reduzieren, den Datenzugriff zu vereinfachen und die Leistung zu verbessern, indem Clients nur die tatsächlich benötigten Daten anfordern.
Bei der Einführung von GraphQL für die Studio API stand Netflix zudem vor einigen besonderen Herausforderungen. Dazu gehörten insbesondere die Verwaltung der Komplexität des Schemas und die Sicherstellung, dass Clients nur auf Daten zugreifen konnten, für die sie autorisiert waren.
Um diese Herausforderungen zu bewältigen, entwickelte Netflix eine maßgeschneiderte Lösung namens „Netflix GraphQL Federation“, die auf der Apollo-Federation-Spezifikation basiert und das Schema der Studio API in kleinere, leichter zu verwaltende Teile aufteilt. Außerdem implementierte Netflix ein System zur Verwaltung von Berechtigungen und Zugriffskontrollen, mit dem sich der Zugriff von Clients auf bestimmte Teile des Schemas beschränken lässt.
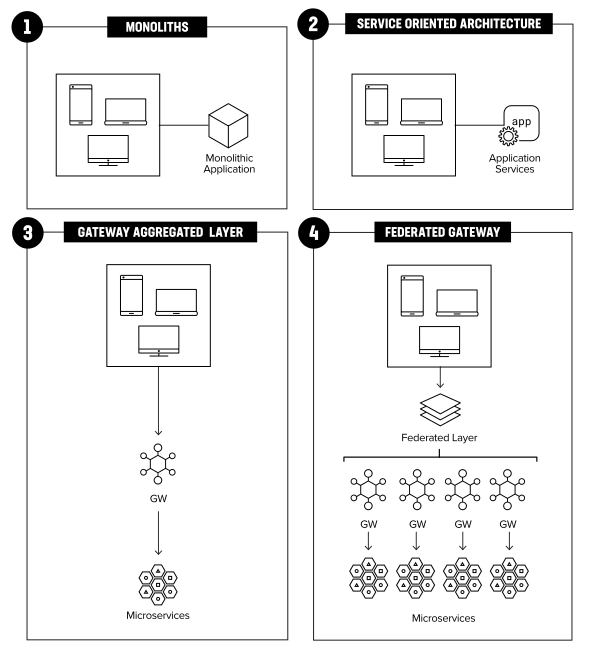
In ihrem Blog veröffentlichten sie außerdem die Entwicklung ihrer API-Architektur – von einem Monolithen hin zu einem föderierten Gateway. Abbildung 5 ist eine angepasste Version der Darstellung aus ihrem Blog.
Wir sind der Ansicht, dass ein weiterer Ansatz fehlt, der in der Branche möglicherweise weit verbreitet, aber nicht formalisiert ist.
Man könnte die Gateway-Aggregationsschicht und das föderierte Gateway aus Abbildung 5 wie unten dargestellt kombinieren:
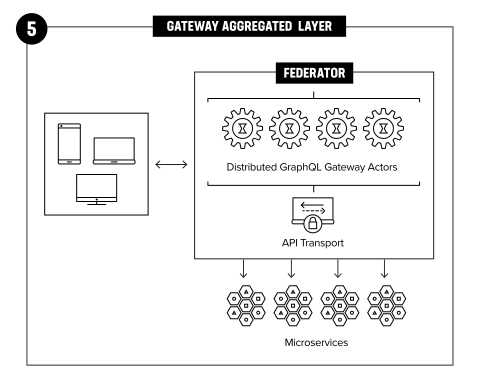
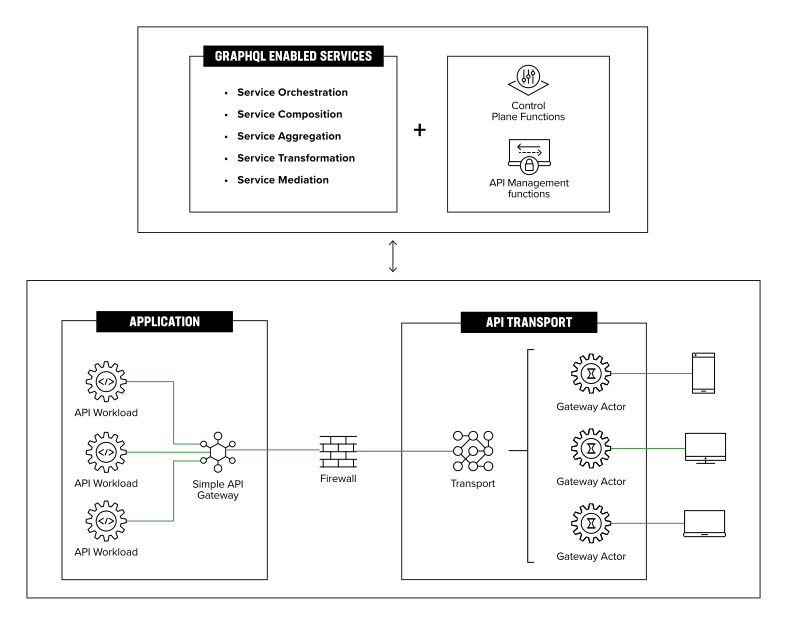
Jedes Zahnradsymbol steht im Wesentlichen für eine kurzlebige, föderierte GraphQL-Instanz (auch Gateway-Akteur genannt), die in Echtzeit (sogar für jede einzelne Transaktion) am Edge, d. h. topologisch nahe bei den Clients, instanziiert werden und über einen sicheren API-Transport eine Verbindung zu den Microservices herstellen kann. Diese Kombination ersetzt im Wesentlichen die Gateway-Aggregationsschicht bzw. die föderierte Schicht durch verteilte Gateway-Akteure, die das Beste aus beiden Funktionalitäten vereinen. Wir bezeichnen dies als „Architektur verteilter GraphQL-Gateway-Akteure“, wie in Abbildung 7 dargestellt.
WEITERE FRÜHE ANWENDER
PayPal
PayPal setzt seit 2018 auf GraphQL, als das Unternehmen die Technologie in seine Checkout-App integrierte. Das Hauptproblem mit REST bestand – ähnlich wie bei Meta – darin, dass dessen Designprinzipien nicht für Web- und mobile Apps sowie deren Nutzer optimiert sind. Client-Anwendungen mussten zahlreiche Anfragen zwischen Client und Server ausführen, wobei das Abrufen der Daten etwa 700 ms dauerte. Dies führte zu längeren Rendering-Zeiten, Frustration bei den Nutzern und niedrigeren Konversionsraten. Bei der Checkout-App stellte PayPal fest, dass Entwickler von Benutzeroberflächen (UI) weniger als ein Drittel ihrer Zeit mit der Entwicklung der UI verbrachten, während die restliche Zeit dafür aufgewendet wurde, herauszufinden, wie Daten abgerufen und verarbeitet werden können.
Weitere Technologien, die das PayPal-Entwicklungsteam in Betracht zog, waren Orchestrierungs-APIs und Bulk REST. Die Entwicklung einer Orchestrierungs-API würde dazu führen, dass zu viele Daten abgerufen werden und die Clients eng an den Server gekoppelt sind. PayPal kam zu dem Schluss, dass dieser Ansatz im Laufe der Zeit dazu führen kann, dass die API schwerfällig und umständlich wird und mehr als nur einem einzigen Zweck dient. Auch das Experiment mit Bulk REST erwies sich als erfolglos. Zwar musste das Entwicklungsteam dadurch die Orchestrierungs-APIs nicht mehr anpassen, doch die Clients benötigten detaillierte Kenntnisse über die Funktionsweise der APIs.
PayPals erste Erfahrung mit GraphQL bei der Entwicklung eines neuen Produkts war ein mobiles SDK zur Integration von PayPal Checkout in Apps. Innerhalb einer Woche nach Beginn der Evaluierung von GraphQL entschied sich das Entwicklungsteam, es für sein neues Produkt einzusetzen. Obwohl die API noch nicht fertig war, konnte das Team das Produkt vorzeitig fertigstellen, ohne dass dafür nennenswerte PayPal-spezifische Kenntnisse erforderlich waren. Die Entwickler konnten schnell eine effiziente und benutzerfreundliche App erstellen, was das Entwicklungsteam davon überzeugte, GraphQL vollständig in seinen Technologie-Stack aufzunehmen.
Starbucks
Starbucks beauftragte einen Drittanbieter mit der Entwicklung seiner Progressive Web App (PWA).
Das Team wurde mit der Entwicklung eines Bestellsystems beauftragt, das komplexe Geschäftslogik effizient und zuverlässig abbilden kann. Da Kundinnen und Kunden ihre Bestellungen individuell anpassen können, musste das Entwicklungsteam sicherstellen, dass das System mehrere Instanzen spezifischer Geschäftslogik unterstützt und die richtigen Daten zur richtigen Zeit an die richtige Stelle übermittelt.
GraphQL ermöglichte es dem Team, eine effiziente API mit serverseitigem Caching und Rendering zu entwickeln, um die Offline-Funktionalität zu verbessern. Darüber hinaus nutzte das Team React, um Animationen zu integrieren und so ein dynamisches und ansprechendes Benutzererlebnis zu schaffen.
GraphQL bei F5
Das Ziel des F5 Office of the CTO bestand darin, herauszufinden, wie wir GraphQL innerhalb des F5-Ökosystems einsetzen können. Derzeit laufen zwei Projekte, in denen der Einsatz von GraphQL untersucht wird.
VERBESSERUNG VON DATENMODELLEN UND TRANSPARENZ
Die von F5 angebotene Testmanagement-Suite (TMS) ermöglicht es Kunden, Endpunkte oder Clients ihrer eigenen Systeme zu testen und festzustellen, ob es sich dabei um Menschen oder Bots handelt.
Dies war ein internes Projekt zur Optimierung der Softwareentwicklung und der Tests für TMS. Das Hauptziel bestand darin, die in der bestehenden SQL-Datenbank gebundenen JSON-Daten zu extrahieren, in Graphdaten umzuwandeln und eine GraphQL-API für Abfragen zu implementieren.
Dies war notwendig, da die aktuelle Datenbank einige Herausforderungen mit sich bringt, darunter das „JSON-Blob-Problem“, das durch die Speicherung von Metadaten als JSON-Objekte in einer tabellarischen Datenbank entsteht. Das Parsen und Verarbeiten dieser Objekte ist grundsätzlich aufwendig und ineffizient. Darüber hinaus enthalten die JSON-Blobs aufgrund ihrer Graphstruktur wertvolle Daten, mit denen sich die Produkte und die Sicherheit von F5 weiter verbessern lassen. Durch die Umstellung auf eine gerichtete Graphdatenbank können die JSON-Blobs effizient geparst und mithilfe gerichteter Beziehungen verwaltet werden, wodurch Datenübertragung und -nutzung optimiert werden.
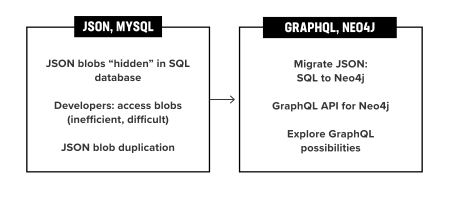
Die Ergebnisse sind vielversprechend. Indem wir ermittelt haben, welche Tabellen in der relationalen TMS-Datenbank JSON-Blobs enthalten, konnten wir feststellen, dass der Umstieg auf eine GraphDB und die Verwendung von GraphQL unsere Einblicke in das System um ein Vielfaches verbessern könnten.
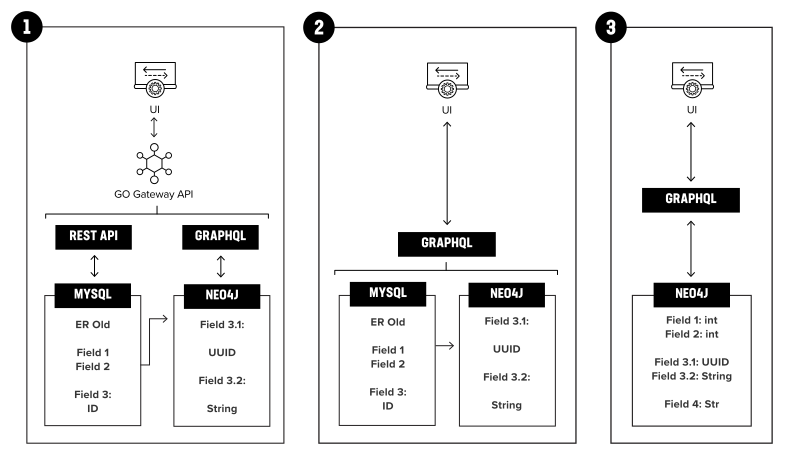
Abbildung 9 zeigt die möglichen Weiterentwicklungen bzw. Implementierungsoptionen für dieses Projekt. Jede Option hat ihre eigenen Auswirkungen.
Option 1 hat die geringsten Auswirkungen auf die Benutzeroberfläche, da der Client nicht geändert werden muss. Ein Hybridmodus wie bei Option 1 oder 2 kann je nach Situation gut funktionieren, insbesondere wenn es nur wenige Spalten mit JSON-Objekten gibt. Darüber hinaus wäre auch das für jedes JSON abgeleitete Schema klein.
Bei der Planung stellten wir jedoch fest, dass die JSON-Objekte Kontextinformationen benötigten, die in anderen Spalten der SQL-Datenbank gespeichert waren. Auch das in jedem JSON-Objekt gespeicherte Schema war recht umfangreich. Dadurch wäre die Pflege der Codebasis aufwendiger geworden. Nach sorgfältiger Abwägung entschieden wir uns daher, die Architektur der Anwendung so umzugestalten, dass sie GraphQL und Neo4J unterstützt, wie in Option 3 dargestellt.
CLOUDGRAPH-INTEGRATION
CloudGraph ist eine kostenlose, universelle Open-Source-GraphQL-API und ein Tool für Cloud Security Posture Management (CSPM) für AWS, Azure, GCP und Kubernetes (K8s). Ziel des Projekts ist es, mit CloudGraph ein „CloudGraph-Plug-in“ (Abbildung 10) zu entwickeln, in dem die Daten von F5 Distributed Cloud (F5XC) angezeigt werden. Dadurch wird eine bessere Übersicht über die Cloud-Ressourcen ermöglicht, die über F5 Distributed Cloud verbunden sind.
Unser Ziel ist die Integration mit CloudGraph, um ein tiefgreifendes Verständnis der Technologie zu erlangen und künftig CloudGraph-Integrationen, Erkenntnisse und GraphQL-APIs für F5XC-Daten zu entwickeln.
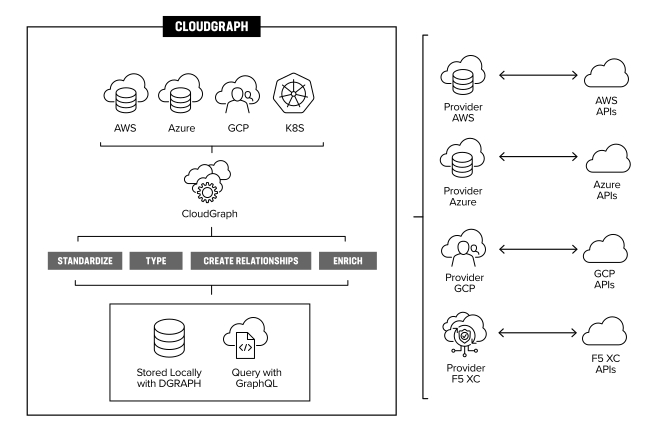
Nach der Integration des benutzerdefinierten F5XC-Providers in die CloudGraph-Plattform und der Nutzung der Plattformfunktion zum Erstellen von Beziehungen erhalten wir einen besseren Überblick über die mit F5XC verbundenen Cloud-Ressourcen und deren Beziehungen über andere Clouds hinweg. Anschließend können wir komplexe Abfragen für Ressourcen in mehreren Clouds desselben Mandanten erstellen. So können wir den Stakeholdern einen umfassenden Überblick über F5XC bieten und eine tiefergehende Integration von CloudGraph prüfen, um zusätzliche GraphQL-Plug-ins und benutzerdefinierte Erkenntnisse für den Cloud-Betrieb bereitzustellen, die für F5 und seine Kunden relevant sind.
Auf Grundlage der oben genannten Initiativen decken sich die Ergebnisse unserer ersten Untersuchungen mit den Erfahrungen aus den zuvor vorgestellten Fallstudien.
Sicherheitsbedenken bei GraphQL
Die anfängliche Annahme, GraphQL sei REST in puncto Sicherheit überlegen, wurde widerlegt, da GraphQL wie jede andere Technologie eigene Risiken birgt, wenn es nicht korrekt implementiert wird. Es ist wichtig zu erkennen, dass GraphQL nicht grundsätzlich sicherer ist als andere Technologien. Eine ordnungsgemäße Implementierung und die Einhaltung bewährter Verfahren sind entscheidend, um die Sicherheit von GraphQL-APIs zu gewährleisten. Indem wir mit diesem Mythos aufräumen, können wir GraphQL mit einem realistischen Verständnis seiner Sicherheitsaspekte betrachten und geeignete Maßnahmen ergreifen, um potenzielle Risiken zu minimieren.
INTROSPEKTIONSANGRIFF
GraphQL stellt Entwicklern mit der Introspektion ein leistungsstarkes Werkzeug zur Verfügung, mit dem sie Informationen über das von einem GraphQL-Dienst verwendete Schema abrufen können. Dieses Werkzeug ermöglicht es Entwicklern, mehr über den Dienst und dessen Struktur zu erfahren. Die Introspektion birgt jedoch auch Risiken. Wird sie in einem produktiven GraphQL-Dienst aktiviert, kann dadurch auch auf vertrauliche Informationen innerhalb des Schemas zugegriffen werden. Dies stellt ein erhebliches Risiko dar, da böswillige Benutzer die Introspektion ausnutzen können, um vertrauliche Daten abzurufen und möglicherweise Schaden anzurichten. Darüber hinaus können diese Benutzer mithilfe der Introspektion potenziell schädliche Operationen leicht identifizieren, da sie das gesamte Schema einsehen und ermitteln können, welche Abfragen ausgeführt werden müssen. Je nach Art des Schemas und der darin enthaltenen Daten können die Folgen eines solchen Datenlecks verheerend sein.
Risikominderung: Eine Möglichkeit, die mit der Introspektion verbundenen Risiken zu mindern, besteht darin, sie mithilfe verschiedener Frameworks in Produktions-APIs zu deaktivieren. Durch die Deaktivierung der Introspektion verlieren Entwickler einige der praktischen Funktionen, die sie bietet. Um diese Funktionen dennoch nutzen zu können, können Entwickler das GraphQL-Schema der Produktions-API bei Tools wie GraphOS registrieren. So behalten sie kontrollierten Zugriff auf das Schema und die darin enthaltenen Informationen.
SQL-INJEKTION
SQL-Injection ist ein weithin bekannter und verbreiteter Angriff, der Risiken von der Manipulation von Daten bis hin zur vollständigen Löschung einer Datenbank birgt. Dieser einfache Angriff nutzt die Verkettung von Zeichenfolgen aus und ermöglicht es Angreifern, ausführbaren Code in Eingaben einzuschleusen. Dadurch erhalten sie unbefugten Zugriff auf die Datenbank und können böswillige Änderungen vornehmen. Interessanterweise ist dieser Angriffsvektor nicht auf SQL-Datenbanken beschränkt, sondern kann auch Graphdatenbanken wie Neo4j betreffen. Neo4j verwendet die Abfragesprache Cypher, die SQL ähnelt und dessen Schwachstellen übernimmt. Diese als Cypher-Injection bezeichnete Angriffsart nutzt die Ähnlichkeiten aus, profitiert jedoch zugleich von bestehenden Lösungen, sodass keine neuen Ansätze entwickelt werden müssen.
Gegenmaßnahmen: Zu den Gegenmaßnahmen gehören die Bereinigung von Benutzereingaben, um Angriffsversuche zu erkennen und zu verhindern, sowie die Verwendung von Parametrisierung, um Benutzereingaben von der direkten Abfrageerstellung zu entkoppeln. Diese Maßnahmen verringern das Risiko von Injection-Angriffen wirksam. Es ist entscheidend, dieses Sicherheitsproblem bei GraphQL-Implementierungen zu beheben. Glücklicherweise stehen dafür bewährte und einfach umzusetzende Lösungen zur Verfügung.
ANGRIFF AUF DIE REST-PROXY-API
Wird eine GraphQL-API einer REST-API vorgeschaltet, kann dies zu Schwachstellen für serverseitige Anforderungsfälschung (Server-Side Request Forgery, SSRF) führen. Angreifer können diese ausnutzen, indem sie Parameter manipulieren, die über den GraphQL-Proxy an die REST-API gesendet werden. Wenn keine der beiden APIs die Parameter für bestimmte Aufrufe validiert, können Angreifer die Kontrolle über das Backend-System erlangen. Wird beispielsweise in einer GraphQL-Abfrage „/delete“ an eine Benutzer-ID angehängt, kann dies bei der Übergabe an die REST-API dazu führen, dass Daten unbeabsichtigt gelöscht werden.
Gegenmaßnahme: Diese Schwachstelle ist zwar durchaus ernst zu nehmen, lässt sich jedoch wirksam beheben, indem Typen im GraphQL-Schema definiert und Parameter gründlich validiert werden, bevor sie an externe APIs oder Dienste gesendet werden. Es ist wichtig zu beachten, dass diese und andere mit GraphQL verbundene Schwachstellen auf Implementierungsfehler zurückzuführen sind und keine inhärenten Probleme von GraphQL selbst darstellen. Solche Probleme entstehen, wenn GraphQL aufgrund einer kurzfristigen Denkweise falsch eingesetzt wird, obwohl die Technologie großes Potenzial bietet.
BATCHING-ANGRIFFE
Authentifizierungsschwachstellen sind ein weitverbreiteter Angriffsvektor in verschiedenen Systemen, darunter auch GraphQL. Da GraphQL das Senden mehrerer Abfragen oder Mutationen in einer einzigen Anfrage ermöglicht, ist es anfällig für Batching-Angriffe, bei denen Brute-Force-Methoden zum Einsatz kommen.
Bei der ersten Angriffsart werden Anmeldepasswörter durch Brute-Force-Angriffe ermittelt. Angreifer senden eine Anfrage mit zahlreichen Mutationen, die jeweils Paare von Anmeldedaten enthalten. Da GraphQL viele Mutationen in einer einzigen Anfrage zulässt, umgeht dieser Angriff die Prüfungen zur Ratenbegrenzung und ermöglicht es, durch das systematische Ausprobieren von Passwörtern eine Sitzung zu erstellen.
Die zweite Angriffsart funktioniert ähnlich, zielt jedoch auf eine weitverbreitete Form der Zwei-Faktor-Authentifizierung (2FA) ab, die als Einmalpasswort (OTP) bezeichnet wird. Dabei wird eine einzelne Anfrage mit mehreren Mutationen gesendet, die jeweils gültige Anmeldedaten in Kombination mit einer anderen OTP-Variante enthalten. Enthält eine der Mutationen das richtige OTP, wird die Anfrage authentifiziert und eine Sitzung eingerichtet.
Gegenmaßnahmen: Die Behebung dieser Schwachstellen erfordert einen umfassenden Ansatz, da es keine absolut sichere Lösung gibt. Entwickler spielen dabei eine entscheidende Rolle, indem sie sichere Programmierpraktiken anwenden und die Geschäftslogik besonders berücksichtigen. Aufseiten des Webservers müssen unbedingt Maßnahmen wie die Begrenzung von Anmeldeversuchen und die Validierung von Benutzereingaben implementiert werden. Darüber hinaus sollte besonders darauf geachtet werden, Anfragen auf mehrere Mutationen zu prüfen, da ein legitimer Anmeldeversuch in der Regel nicht mehr als eine Mutation umfasst.
DENIAL-OF-SERVICE-ANGRIFF
Bei diesen Angriffen wird der GraphQL-Dienst mit übermäßigem Datenverkehr überlastet, sodass er Anfragen legitimer Benutzer nicht mehr verarbeiten kann und es möglicherweise zu Serverabstürzen kommt. DoS-Angriffe können durch rekursive GraphQL-Abfragen oder durch das Senden umfangreicher Abfragen ausgeführt werden.
Bei rekursiven Abfragen nutzen Angreifer die zyklische Struktur von GraphQL-Schemadefinitionen aus. Enthält das Schema beispielsweise die Typen „Autor“ und „Buch“, kann ein Angreifer Autor und Buch wiederholt in einer Schleife abfragen und den Server dadurch mit rekursiven Aufrufen überlasten und seinen Betrieb stören.
Alternativ können Angreifer Abfragen senden, die eine sehr große Datenmenge aus der Datenbank anfordern. Beispielsweise kann eine Abfrage zahlreiche Autoren und alle ihnen zugeordneten Bücher abrufen. Eine derart umfangreiche Datenanforderung kann das System erheblich verlangsamen oder zum Absturz bringen.
Gegenmaßnahmen: Es gibt mehrere Möglichkeiten, dieses Problem einzudämmen. Der erste Ansatz besteht darin, ein Zeitlimit für Abfragen festzulegen, sodass Benutzer keine Anfragen stellen können, deren Bearbeitung eine bestimmte Dauer überschreitet. Dies löst das Problem jedoch möglicherweise nicht vollständig, da auch innerhalb der vorgegebenen Zeit Schäden entstehen können. Eine weitere Lösung besteht darin, die Abfragetiefe und -komplexität zu begrenzen. Abfragen, die die festgelegte Tiefe oder Komplexität überschreiten und somit von der Definition des Schemas abweichen, können abgelehnt werden. Schließlich kann auch eine Drosselung der Benutzeranfragen wirksam sein. Wenn ein Benutzer eine große Anzahl oder mehrere aufeinanderfolgende Anfragen sendet, kann ihm der Zugriff auf den Server vorübergehend verweigert werden, bis der Server weitere Anfragen verarbeiten kann.
GraphQL-Bereitstellungsmuster
Wie dargestellt, gibt es mehrere Bereitstellungsmuster für GraphQL, die jeweils ihre eigenen Vor- und Nachteile sowie Besonderheiten mit sich bringen. Zu den gängigsten Mustern gehören:
MONOLITHISCHE BEREITSTELLUNG
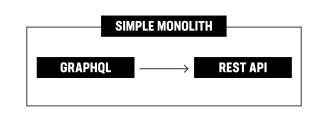
Dies ist das einfachste und gängigste Muster für die Bereitstellung einer GraphQL-API. Bei einer monolithischen Bereitstellung werden der GraphQL-Server, die Datenbank und alle weiteren erforderlichen Dienste gemeinsam als eine Einheit bereitgestellt. Dies erleichtert zwar den Einstieg in GraphQL, kann jedoch mit zunehmendem Wachstum der Anwendung die Skalierung und Wartung erschweren.
ZUSAMMENGESETZTE MONOLITHEN
Zusammengesetzte Monolithen bezeichnen eine Architektur, bei der eine monolithische Anwendung aus einer Kombination von Monolithen und Microservices aufgebaut wird, wobei GraphQL als API-Schicht fungiert (Abbildung 12). Bei diesem Muster wird nicht das gesamte System in einzelne Microservices zerlegt. Stattdessen wird die Anwendung zunächst in Form separater Monolithen entwickelt, die jeweils die gesamte Geschäftslogik und die Datenzugriffsschichten kapseln.
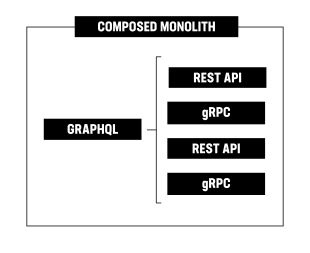
Innerhalb dieser monolithischen Struktur wird GraphQL als API-Schicht eingesetzt, sodass Clients Daten aus verschiedenen zugrunde liegenden Microservices anfordern und abrufen können. Das bedeutet, dass die Anwendung aus Bereitstellungssicht zwar monolithisch bleibt, GraphQL jedoch nutzt, um Daten aus verschiedenen Services zusammenzuführen und den Clients flexibel und effizient bereitzustellen.
Dieses Muster bietet Vorteile wie eine vereinfachte Entwicklung und Bereitstellung sowie die Möglichkeit, die leistungsstarken Abfrage- und Datenabruffunktionen von GraphQL zu nutzen. Entwickler können damit schrittweise eine Microservices-Architektur einführen und gleichzeitig weiterhin von der Flexibilität und Benutzerfreundlichkeit von GraphQL profitieren.
FÖDERIERTE SUBGRAPHEN
Föderierte Graphen in GraphQL-Bereitstellungsmustern führen mehrere GraphQL-Dienste, sogenannte Subgraphen, zu einem einzigen, einheitlichen GraphQL-Schema zusammen. Jeder Subgraph bildet eine separate Domäne oder einen Microservice mit eigenen Daten und Funktionen ab. Diese Architektur nutzt ein zentrales Gateway, das Client-Abfragen anhand der angeforderten Felder an den entsprechenden Subgraphen weiterleitet. Durch die Föderation dieser Subgraphen können Entwickler einen zusammenhängenden Graphen erstellen, in dem Clients nahtlos Abfragen über verschiedene Dienste hinweg ausführen und zwischen ihnen navigieren können.
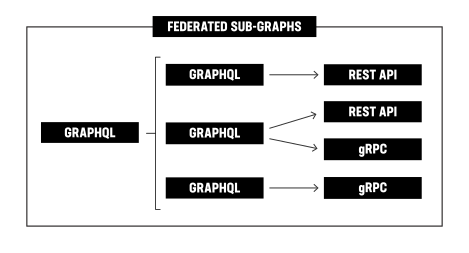
Dieser Ansatz fördert die Modularität, Skalierbarkeit und unabhängige Entwicklung von Diensten, was zu einer höheren Leistung und mehr Flexibilität bei der Erstellung von GraphQL-APIs führt. Föderierte Subgraphen (Abbildung 13) bieten eine leistungsstarke Möglichkeit, Daten aus verschiedenen Diensten zusammenzuführen und eine verteilte, skalierbare Architektur zu schaffen.
HYBRIDE GRAPHEN
Hybride Graphen (Abbildung 14) kombinieren in GraphQL-Bereitstellungsmustern föderierte Subgraphen und nicht föderierte Schemas mithilfe von Stitching-Techniken. Dieser Ansatz ermöglicht es Unternehmen, bestehende GraphQL-APIs oder Altsysteme mit föderierten Microservices zu integrieren. So entsteht eine einheitliche GraphQL-API, die von den Vorteilen beider Ansätze profitiert. Durch das Zusammenführen von Schemas und das Auflösen von Beziehungen zwischen Typen und Feldern bietet die hybride Grapharchitektur Flexibilität, Modularität und Skalierbarkeit.
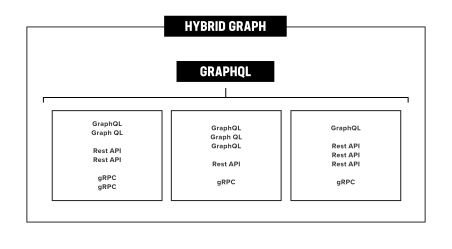
Das Hybrid-Graph-Muster ermöglicht es Unternehmen, schrittweise auf Föderation umzustellen und dabei ihre vorhandenen Ressourcen zu nutzen. Es erlaubt die nahtlose Integration föderierter Subgraphen und nicht föderierter Schemas, erfüllt vielfältige Anforderungen und fördert die Interoperabilität. Dieser Ansatz versetzt Unternehmen in die Lage, umfassende GraphQL-APIs zu entwickeln, die skalierbar sind und sich an veränderte Anforderungen anpassen lassen. Durch die Kombination der Stärken föderierter und nicht föderierter Dienste bieten Hybrid-Graphen eine flexible und leistungsstarke Lösung für die Erstellung von GraphQL-Bereitstellungen.
Zu den Herausforderungen hybrider Graphen in GraphQL-Bereitstellungen zählen die Bewältigung der Komplexität zusammengeführter Schemas, die Vermeidung potenzieller Leistungseinbußen, die Gewährleistung von Datenkonsistenz und -integrität, der Umgang mit der Weiterentwicklung und Versionierung des Systems sowie die komplexe Überwachung und Fehlerbehebung in einer verteilten Architektur. Um diese Herausforderungen zu meistern und einen reibungslosen Betrieb hybrider Graph-Bereitstellungen sicherzustellen, sind eine sorgfältige Planung, Optimierung und robuste Entwicklungspraktiken erforderlich.
SERVERLOSES ROUTING
Bei diesem Muster wird die GraphQL-API als eine Reihe serverloser Funktionen wie AWS Lambda oder Google Cloud Functions bereitgestellt. Dies kann eine kostengünstige und skalierbare Möglichkeit zur Bereitstellung einer GraphQL-API sein, jedoch auch zusätzliche Latenz verursachen und die Komplexität der Architektur erhöhen.
Serverloses Routing bringt zahlreiche Herausforderungen mit sich. Ein Problem besteht darin, verteilte Subgraphen bei wachsender Anwendung nahtlos miteinander zu verbinden. Die Koordination mehrerer Teams und Deployments kann komplex werden, wodurch sich die Subgraphen nur schwer effektiv verwalten und skalieren lassen. Eine weitere Hürde besteht darin, die Datenkonsistenz und Synchronisierung zwischen diesen Subgraphen sicherzustellen. Auch die Überwachung und Fehlerbehebung in einer verteilten serverlosen Umgebung kann schwieriger sein und erfordert geeignete Protokollierungs- und Fehlerbehandlungsmechanismen. Darüber hinaus stellt die Verwaltung von Zugriffskontrollen und Autorisierungen über mehrere serverlose Funktionen und Subgraphen hinweg eine Herausforderung dar. Die Bewältigung dieser Herausforderungen ist für den reibungslosen Betrieb und die Skalierbarkeit eines serverlosen GraphQL-Deployments unerlässlich.
EDGE-BEREITSTELLUNG
Bei einem Edge-Bereitstellungsmuster für GraphQL-APIs wird die API mithilfe eines CDN-Dienstes näher an den Clients bereitgestellt. Dies bietet mehrere Vorteile, darunter eine geringere Latenz für schnellere Antworten, eine geringere Auslastung des Ursprungsservers und Schutz vor DDoS-Angriffen.
Durch die weltweite Verteilung der API-Infrastruktur auf Edge-Server lässt sich der Datenverkehr effizienter bewältigen und global eine bessere Benutzererfahrung bieten. Die Caching- und Filterfunktionen des CDN tragen dazu bei, die Skalierbarkeit zu verbessern und die Verfügbarkeit der API selbst bei hohem Datenverkehr oder böswilligen Angriffen sicherzustellen. Edge-Bereitstellungen können die Leistung und Zuverlässigkeit einer API optimieren, indem sie das Servernetzwerk von CDNs nutzen.
Fazit
GraphQL-Technologien sind inzwischen so ausgereift, dass sie auch von traditionellen Großunternehmen eingesetzt werden können. Obwohl Gartners Hype Cycle for APIs 2022 darauf hindeutet, dass es bis zu einer breiten Akzeptanz noch mehrere Jahre dauern wird, haben wir nun einen entscheidenden Wendepunkt erreicht, an dem die erforderlichen Tools bereits verfügbar sind. GraphQL ist zwar noch relativ neu, hat sich jedoch so weit entwickelt, dass es die Anforderungen etablierter Großunternehmen erfüllen kann.
Die zunehmende Reife von GraphAPI-Technologien ist darauf zurückzuführen, dass immer mehr Unternehmen GraphQL und andere Graphdatenbanktechnologien einsetzen. Je mehr Unternehmen diese Technologien einführen, desto größer wird das Angebot an unterstützenden Tools und Ressourcen, wodurch es anderen Unternehmen leichter fällt, diesem Beispiel zu folgen. Darüber hinaus werden die Vorteile von GraphAPI-Technologien – etwa effizientere Datenabfragen und eine geringere Komplexität – zunehmend anerkannt, was ihre Verbreitung in Unternehmen weiter vorantreibt.
Als Branche müssen wir die Bedeutung von GraphAPI-Technologien wie GraphQL und ihr Potenzial zur Überwindung der Einschränkungen von REST erkennen. Unternehmen dürfen die dringende Notwendigkeit nicht außer Acht lassen, in GraphQL zu investieren und ein umfassendes Verständnis dafür zu entwickeln – insbesondere im Hinblick auf Datenmodellierung, Vielfalt und Intransparenz. So leicht man sich auch von den Funktionen und Möglichkeiten von GraphQL begeistern lässt, müssen wir zugleich das mögliche Tal der Enttäuschungen nach dem Höhepunkt überzogener Erwartungen berücksichtigen. Anbieter müssen der Weiterentwicklung ihrer Produkte Priorität einräumen, damit diese GraphQL vollständig unterstützen. Gleichzeitig sollte die Unternehmens-IT – einschließlich der Anbieter – ermitteln, welche Daten von einer Bereitstellung über GraphQL profitieren und so die Produktivität steigern würden.
Kunden müssen vorrangig ein umfassendes Verständnis ihrer Daten entwickeln und sich bewusst machen, dass ein durchschnittliches Unternehmen anders arbeitet als die Hyperscaler, die GraphQL ursprünglich eingeführt haben. Lassen Sie uns gemeinsam GraphQL als effektives Architekturmuster für Software etablieren und die Branche zu mehr Produktivität und Innovation führen.