
Richtlinien im Payload: Vorbereitung auf KI-Agentenarchitekturen
KI-Agenten verändern die Art und Weise, wie Anwendungen mit der Infrastruktur interagieren. Anders als herkömmliche Systeme bringen Agenten bei jeder Anfrage ihre eigenen Ziele, ihren eigenen Kontext und ihre eigene Entscheidungslogik mit – also was zu tun ist, wie Fehler behoben werden und was als Erfolg gilt. Dieser Wandel stellt langjährige Annahmen über das Traffic-Management infrage und zwingt Unternehmen, ihre Infrastruktur neu zu denken. Statisches Routing, gemeinsam genutzte Ressourcen und zentralisierte Richtlinien reichen in einer Welt, in der jede Anfrage autonom verarbeitet wird, nicht mehr aus.
Agentenarchitekturen erfordern, dass sich die Infrastruktur von der reaktiven Ausführung hin zur Echtzeitinterpretation der eingebetteten Absicht weiterentwickelt. Unternehmen, die diesen Wandel erkennen, können sich darauf vorbereiten, indem sie ihre bestehenden Investitionen anpassen, anstatt sie zu verwerfen.
Einleitung
KI-Agenten sind nicht einfach nur intelligente Anwendungen. Sie stehen für einen grundlegenden Wandel in der Art und Weise, wie Anwendungen arbeiten, Entscheidungen treffen und sich anpassen. Im Gegensatz zu herkömmlichen Systemen reagieren Agenten nicht nur auf Richtlinien zur Datenverkehrssteuerung, sondern bringen ihre eigenen mit. Jede von ihnen gesendete Anfrage enthält nicht nur Daten, sondern auch eine integrierte Logik: was geschehen soll, wie sich der Rückfallmechanismus verhalten soll und was als Erfolg gilt.
Diese Verlagerung verschiebt die Entscheidungsfindung von statischen Steuerungsebenen in die Laufzeit selbst. Dadurch wird die seit Langem bestehende Trennung zwischen Steuerungs- und Datenebene aufgehoben, sodass die Traffic-Infrastruktur – Load Balancer, Gateways und Proxys – anstatt vorkonfigurierte Routen lediglich passiv auszuführen, die für jede einzelne Anfrage geltenden Richtlinien interpretieren muss.
Dieses Whitepaper untersucht, wie Agentenarchitekturen zentrale Annahmen des Traffic Engineerings infrage stellen – von Zustandsprüfungen und Fallback-Logik bis hin zu Observability und der Durchsetzung von Sicherheitsrichtlinien. Es erläutert, warum herkömmliche Konstrukte wie statische Pools und auf Durchschnittswerten basierende Zustandsmetriken in einer Welt, in der die Intention für jede einzelne Anfrage maßgeblich ist, nicht mehr ausreichen. Zudem zeigt es auf, dass sich die Layer-7-Infrastruktur weiterentwickeln muss, da sie sonst Gefahr läuft, zu einer austauschbaren Basiskomponente zu werden – zuverlässig, aber strategisch unsichtbar. Um sich darauf einzustellen, müssen Unternehmen ihren Traffic-Stack neu konzipieren: Er muss zur Laufzeit programmierbar, kontextsensitiv und auf agentennative Protokolle wie das Model Context Protocol (MCP) abgestimmt sein. Dazu gehören die Überarbeitung der Fallback-Logik, die Einführung semantischer Observability und die Unterstützung bei der Durchsetzung von Richtlinien, die von Agenten vorgegeben werden. Neue Werkzeuge wie die Echtzeit-Datenkennzeichnung leisten einen entscheidenden Beitrag zu diesem Wandel.
Kurz gesagt: Bei der Zukunft des Traffic-Managements geht es nicht nur um die Übertragung von Paketen, sondern darum, die jeweilige Absicht umzusetzen.
Agentenarchitekturen: Wesentliche Merkmale
Agentenarchitekturen führen ein neues Betriebsmodell ein, bei dem autonome, auf generativer KI basierende Komponenten – sogenannte Agenten – zielgerichtete Aufgaben ausführen, Entscheidungen in Echtzeit treffen und den erforderlichen Kontext mitführen, um ihre Ausführung dynamisch anzupassen. Diese Agenten funktionieren ähnlich wie das heutige Service Chaining, sind jedoch nicht auf vorkonfigurierte Workflows angewiesen. Stattdessen bestimmen sie zur Laufzeit anhand von Zielen, dem Zustand der Umgebung und den beobachteten Ergebnissen den geeigneten Ausführungsablauf.
Dieser Wandel markiert die Abkehr von traditionellen, zentral orchestrierten Systemen mit vordefinierten Workflows hin zu dezentralen, dynamischen Systemen, die Ausführungspfade in Echtzeit erstellen können. Dabei wird die Vorhersehbarkeit statischer Microservice-Ketten durch eine flexible, reaktionsfähige Entscheidungsfindung ersetzt, die auf Echtzeitdaten und Zielvorgaben basiert.
Agentenbasierte Systeme zeichnen sich durch Folgendes aus:
- Zielorientierte Ausführung: Agenten reagieren auf Anweisungen oder Aufträge und folgen keinen statischen Workflows. Je nachdem, ob sie ihr Ziel erreichen, wählen sie APIs aus, ändern Parameter und passen den Ablauf an. Beispiel: Ein Agent, der den Auftrag „Kundenbeschwerde lösen“ bearbeitet, kann abhängig von den bisherigen Ergebnissen Abrechnungs-, Konto- und Messaging-APIs unterschiedlich aufrufen.
- Portabler Kontext: Agenten führen ihren eigenen Speicher, Zustand und ihre eigenen Richtlinien mit. Über das Model Context Protocol (MCP) oder strukturierte Metadaten betten sie diesen Kontext in jede Anfrage ein.
- Laufzeitanpassung: Anstatt darauf zu warten, dass die Infrastruktur eine Entscheidung trifft, passen sich Agenten dynamisch an, indem sie Vorgänge erneut versuchen, umleiten, eskalieren oder Ausführungspfade in Echtzeit anpassen.
- Integrierte Observability: Jede Aktion beschreibt sich selbst. Agenten können angeben, warum sie einen bestimmten Pfad gewählt haben, was bewertet wurde und ob ein Ziel erreicht wurde. Das ist Observability als Verhalten, nicht nur in Form von Protokollen und Metriken.
Zusammen bewirken diese Faktoren, dass sich die Anwendungslandschaft von etwas Vorhersehbarem zu etwas Anpassungsfähigem und sich stetig Weiterentwickelndem wandelt.
Auswirkungen auf das traditionelle Traffic-Management
Aktuelle Verkehrsmanagementsysteme basieren auf klaren Abgrenzungen:
- Die Steuerungsebene definiert die Zielvorgaben: welche Endpunkte gültig sind, welche Pfade bevorzugt werden und welche Richtlinien gelten.
- Die Datenebene führt Entscheidungen aus: Sie leitet Anfragen weiter, wendet Sicherheitsrichtlinien an und verteilt die Last.
Dieses Modell hat sich seit Jahrzehnten bewährt, insbesondere in serviceorientierten Architekturen und Microservices-Umgebungen. Es setzt voraus, dass sich Datenverkehrsflüsse im Voraus modellieren lassen und Workloads vorhersehbaren Mustern folgen.
Beispiele:
- Ein Load Balancer leitet
/api/loginan einen Pool und/api/imagesan einen anderen weiter. - Integritätsprüfungen kennzeichnen Knoten als verfügbar oder ausgefallen.
- Statische Schwellenwerte bestimmen die Failover-Bedingungen.
Diese Systeme basieren auf:
- Enge Kopplung von Richtlinien und Konfiguration an statische Ressourcen, beispielsweise bestimmte Pools und Mitglieder
- Statische Konstrukte wie Pools und Mitglieder
- Deterministisches Routing basierend auf Pfad, Header oder Protokoll
- Zentrale Orchestrierung für Serviceerkennung, Zustandsprüfungen und Fallback-Logik
Doch agentenbasierte Systeme bringen Flexibilität, Autonomie und selbstgesteuerte Logik mit sich, die diese Annahmen außer Kraft setzen.
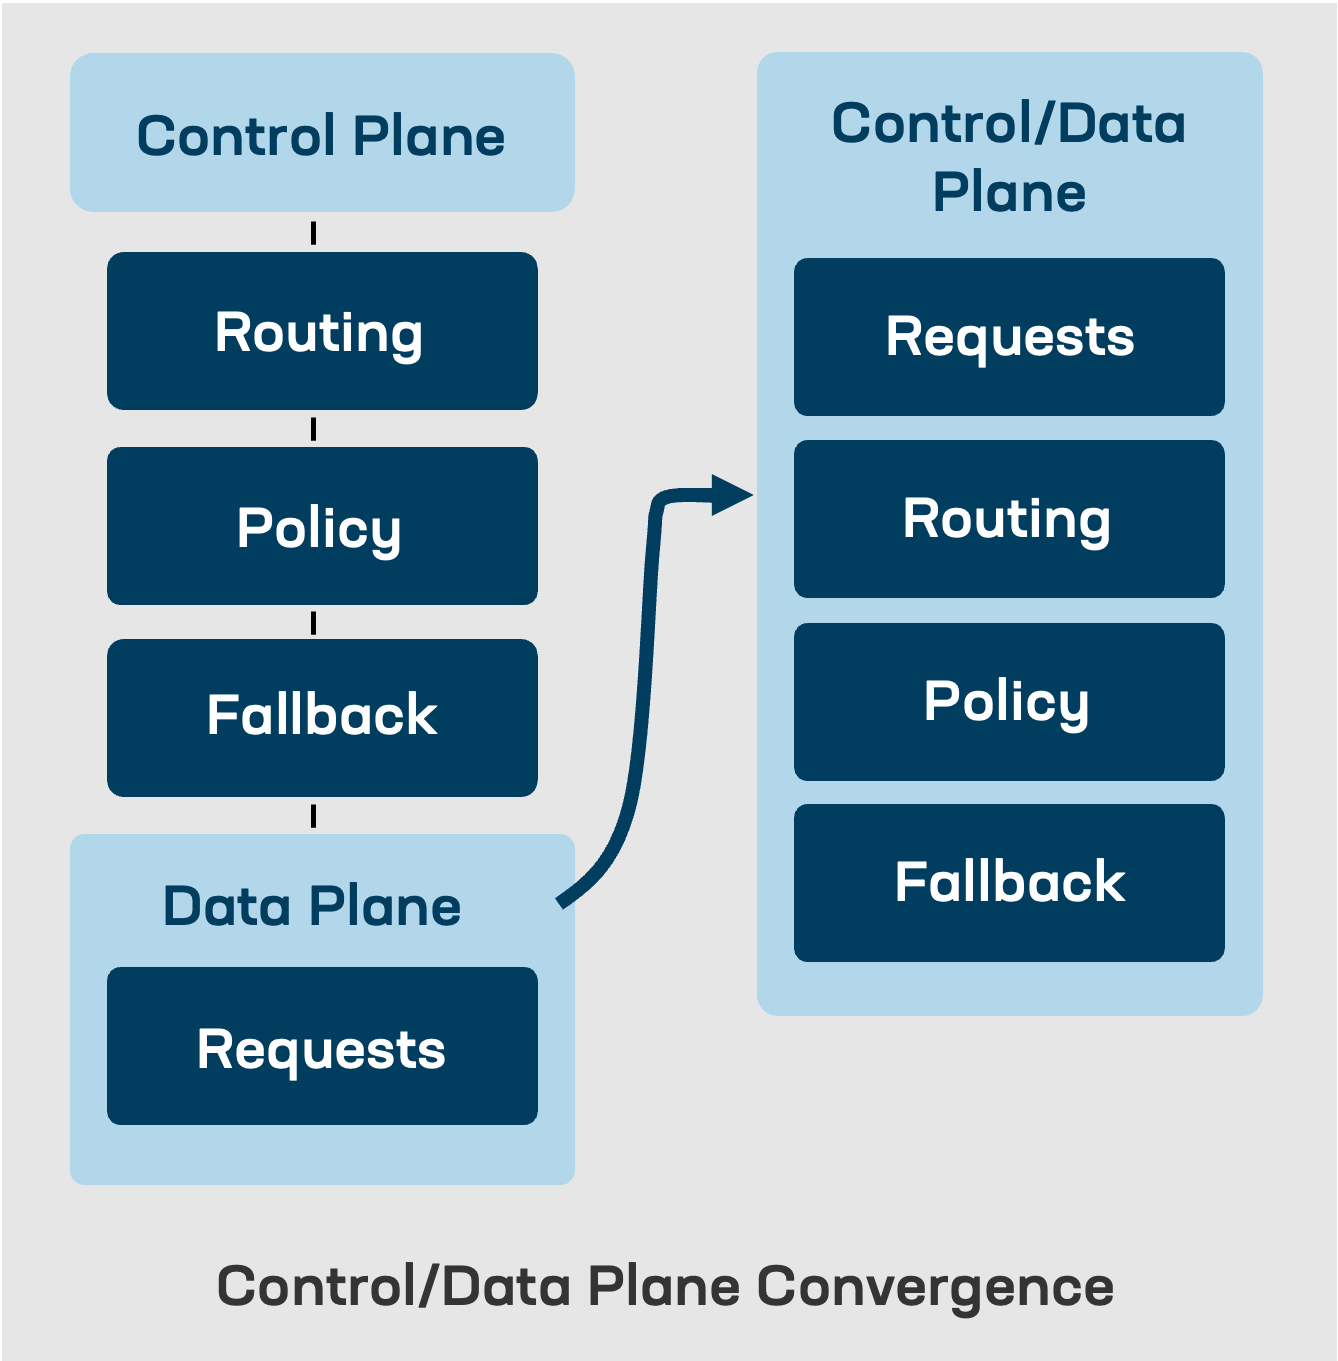
In Agentenarchitekturen beginnt die traditionelle Trennung zwischen Steuerungs- und Datenebene zu verschwimmen. Agenten führen nicht einfach nur Anfragen aus, sondern enthalten auch die Logik, die festlegt, worum es bei der Anfrage geht, unter welchen Bedingungen Ausweichmechanismen ausgelöst werden sollen, wie der Erfolg gemessen wird und sogar welche Route bevorzugt werden soll. Traditionell sind dies Aufgaben der Steuerungsebene, doch Agenten kodieren sie in Headern, Tokens oder Metadaten, die zusammen mit der Anfrage selbst die Datenebene durchlaufen.
Diese Konvergenz bedeutet, dass die Datenebene nicht länger als passiver Ausführer zentral getroffener Entscheidungen fungieren kann. Sie muss Richtlinien dynamisch und aktiv interpretieren. Eine Anfrage ist nicht mehr nur ein Paket, sondern ein Richtlinienartefakt. Daher müssen sich Load Balancer, Gateways und Routing-Schichten von reaktiven Komponenten zu Echtzeitinterpreten der von Agenten übermittelten Absichten weiterentwickeln.
Dieser Wandel stellt die grundlegende Architekturannahme infrage, dass die Steuerungsebene statisch und zentralisiert ist. Stattdessen wird die Entscheidungslogik verteilt, portabel und personalisiert, mit jeder Anfrage weitergegeben und zur Laufzeit ausgeführt. Dies ist nicht nur eine Änderung bei der Bereitstellung, sondern auch eine Veränderung dahingehend, wo und wie Entscheidungen getroffen werden.
Damit wird im Grunde vollendet, was Kubernetes begonnen hat, als es die zugrunde liegende Infrastruktur – Netzwerk, Speicher und sogar das L4-Traffic-Routing – abstrahierte und all das hinter einer deklarativen Steuerungsebene zur bloßen „Installationsarbeit“ machte. Diese Schichten wurden nicht abgeschafft, sondern herabgestuft. Sie wurden unsichtbar, automatisiert und einem neuen, absichtsgesteuerten System untergeordnet.
Agentenarchitekturen tun dasselbe, allerdings für den gesamten Stack und nicht nur für die Infrastruktur.
Kritische Störungen im Verkehrsmanagement
Um diese Störungen anhand eines realen Beispiels zu veranschaulichen, betrachten wir ein Szenario für die lokale Anwendungsbereitstellung:
Beispiel: Eine regionale E-Commerce-Website verwendet einen ADC zur Verwaltung des internen API-Datenverkehrs. Ein KI-Agent soll die Geschwindigkeit der Auftragsabwicklung optimieren. Er stellt fest, dass ein bestimmter API-Endpunkt, z. B. /api/inventory/check, aufgrund der gestiegenen Komplexität der Anfragen und konkurrierender Zugriffe auf die Backend-Datenbank Leistungseinbußen aufweist. Herkömmliche Lastverteilungsalgorithmen, darunter „schnellste Antwort“, können die Besonderheiten dieser Verlangsamung nicht erfassen, da sie die Leistung als allgemeinen Durchschnitt aller Antworten eines bestimmten Pool-Mitglieds berechnen und nicht auf Aufgaben- oder Aufrufebene.
Um seine SLA einzuhalten, leitet der Agent diese Anfragen zur Bestandsprüfung an eine alternative, für transaktionale Abfragen optimierte Knotengruppe weiter. Dazu versieht er jede Anfrage mit einem Kontext-Header, beispielsweise X-Task-Profile: inventory-sensitive. Bei entsprechender Konfiguration kann der Load Balancer diesen interpretieren und den Datenverkehr entsprechend weiterleiten. Da diese Knoten jedoch nicht vorab dem statischen Pool für /api/inventory zugewiesen wurden, müssen Traffic-Steering-Dienste in der Lage sein, vom Agenten übermittelte Anweisungen zu berücksichtigen und das Routing dynamisch aufzulösen, ohne sich auf statische Konstrukte zu stützen.
Dieses Szenario verdeutlicht die Grenzen statischer Konstrukte wie Pools und die Notwendigkeit einer kontextabhängigen, dynamisch programmierbaren Verkehrssteuerung.
Agentenbasierte Systeme stellen mehrere grundlegende Annahmen des Traffic Engineerings infrage:
Konvergenz von Kontroll- und Datenebene: Während Routing-Entscheidungen früher auf statischen Regeln beruhten, werden sie heute aus der Anfrage selbst abgeleitet. Dadurch wird die herkömmliche Durchsetzungslogik außer Kraft gesetzt.
Absichtsbasierte Weiterleitung: Agenten leiten den Datenverkehr anhand von Zielen und nicht nur anhand von Endpunkten weiter. Ein einzelner Endpunkt wie /api/process kann je nach Anweisungen des Agenten Hunderte verschiedener Aufgabenabläufe verarbeiten.
Statische Pools werden obsolet: Herkömmliche Pools setzen feste Rollen voraus. Agenten benötigen jedoch möglicherweise in einem Moment GPU-Zugriff und im nächsten eine CPU-Optimierung, wodurch die Pool-Zugehörigkeit zu unflexibel wird.
Fallbacks und Failover werden strategisch: Früher bedeutete Failover einfach: „Versuche es mit dem nächsten Server.“ Heute bewerten Agenten die Leistung in Echtzeit sowie bisherige Ergebnisse und entscheiden strategisch, wie sie vorgehen.
Verkehrsmuster entstehen, statt sich zu wiederholen: Agenten erstellen Workflows nach Bedarf. Es ist nicht möglich, alle Pfade im Voraus festzulegen – sie bilden sich je nach Bedarf.
Diese Veränderungen stellen Load Balancer, Gateways und Observability-Stacks vor die Herausforderung, flexibel auf eine dynamische Echtzeit-Verkehrslogik zu reagieren.
Gesundheits- und Leistungskennzahlen neu denken
Zustands- und Leistungsmetriken bilden seit jeher die Grundlage des Traffic-Managements. Entscheidungen zur Lastverteilung hängen davon ab, ob ein Server verfügbar ist, wie schnell er reagiert und wie stark er ausgelastet ist. In agentengesteuerten Systemen lässt sich der Zustand jedoch nicht auf ein binäres Schema reduzieren, und die Leistung kann nicht über weit gefasste Kategorien hinweg gemittelt werden. Metriken müssen widerspiegeln, ob ein Ziel für eine bestimmte Aufgabe geeignet ist, und nicht nur, ob es verfügbar ist.
Warum das wichtig ist: Zustandsmetriken wirken sich unmittelbar auf die Verkehrssteuerung, Failover-Entscheidungen und die Leistungsoptimierung aus. In einer agentennativen Umgebung verfolgt jede Anfrage eine andere Absicht und kann einen anderen Pfad oder eine andere Antwortgarantie erfordern. Herkömmliche Ansätze können diesen Anforderungen nicht gerecht werden, weil:
- Sie stützen sich auf oberflächliche Durchschnittswerte (z. B. die durchschnittliche Antwortzeit), die aufgabenspezifische Abweichungen verschleiern.
- Sie bewerten den Zustand ausschließlich aus Sicht des Servers, ohne Einblick in den Erfolg oder die Zufriedenheit auf Agentenebene.
- Sie gehen von einer Homogenität des Datenverkehrs aus, die nicht gegeben ist, wenn Anfragen durch Entscheidungen zur Laufzeit geprägt werden.
Beispiel: Ein Pool von API-Servern kann laut Zustandsprüfungen durchweg „fehlerfrei“ sein, während einer von ihnen bei X-Task-Profile: inventory-sensitive-Abfragen dennoch regelmäßig keine Antworten innerhalb von 100 ms liefert. Ein Agent, der dieses Latenzprofil erwartet, wertet dies als Fehler, selbst wenn die Infrastruktur keine Auffälligkeiten erkennt.
Was benötigt wird:
- Echtzeit-Telemetrie für jede einzelne Anfrage, die die Absicht und die beobachteten Ergebnisse widerspiegelt.
- Aufgabenspezifische Zustandsbewertung, die erkennt, wenn die Leistung eines Knotens bei manchen Aufgaben beeinträchtigt ist, auch wenn er bei anderen fehlerfrei funktioniert.
- Feedbackschleifen, die von Agenten gemeldete Erfolge oder Fehlschläge in die Routing- und Priorisierungslogik einbeziehen.
Datenkennzeichnungstools können hier eine entscheidende Rolle spielen, indem sie den laufenden Datenverkehr kennzeichnen und erfassen, inwieweit Leistung und Kontext übereinstimmen. So können Systeme nicht nur beurteilen, was geschehen ist, sondern auch, ob damit das Ziel des Akteurs erreicht wurde, der den Vorgang initiiert hat.
Fallback-, Circuit-Breaker- und Wiederholungsmechanismen in Agentenarchitekturen
In herkömmlichen Infrastrukturen wird das Fallback-Verhalten, etwa Wiederholungsversuche, die Umleitung auf Backup-Knoten oder das Auslösen von Circuit Breakern, auf der Infrastrukturebene implementiert. Load Balancer, Proxys und Gateways verwenden vordefinierte Schwellenwerte (z. B. Zeitüberschreitungen oder Fehlerraten), um zu bestimmen, wann sie die Weiterleitung des Datenverkehrs an ein Ziel beenden und eine Alternative versuchen sollen.
Agentenarchitekturen kehren diese Logik um.
Agenten bringen ihre eigenen Ausweichstrategien mit. Die Anfrage selbst enthält Richtlinien für Wiederholungsversuche, Eskalationslogik und zielorientierte Prioritäten. Dies erhöht die Komplexität und birgt Konfliktpotenzial mit Failover-Mechanismen auf Infrastrukturebene.
Warum das wichtig ist:
- Die Infrastruktur könnte einen Fehler als behebbar einstufen, während der Agent ihn als inakzeptabel betrachtet (oder umgekehrt).
- Sowohl der Agent als auch die Infrastruktur können gleichzeitig versuchen, auf eine Ausweichlösung zurückzugreifen, was zu redundanten Wiederholungsversuchen, erhöhter Latenz oder Datenverkehrsschleifen führen kann.
- Für durchschnittliche Datenverkehrslasten ausgelegte Schutzschalter können den Zugriff auf Dienste blockieren, die ein Agent weiterhin für optimal hält.
Wesentliche Risiken:
- Doppelter Fallback: Agent und Infrastruktur führen beide Wiederholungsversuche durch, wodurch unnötige Last entsteht.
- Race Conditions: Der Agent wechselt zu einer teureren oder weniger sicheren Option, obwohl das System das Problem innerhalb von Millisekunden gelöst hätte.
- Beeinträchtigung des deterministischen Failovers: Statische Richtlinien können die differenzierten Anforderungen von Agenten nicht berücksichtigen.
- Beschädigung: Die Agentenmetadaten sind fehlerhaft, fehlen oder können nicht gelesen werden.
Anpassungshinweise:
- Die Infrastruktur sollte so weiterentwickelt werden, dass sie von Agenten festgelegte Fallback-Prioritäten erkennt (z. B. über
X-Fallback-Order,X-Timeout-Preference). - Circuit Breaker müssen die jeweilige Absicht berücksichtigen, um eine aufgabenspezifische oder agentenspezifische Logik anstelle globaler Schwellenwerte zu unterstützen.
- Erwägen Sie die Einführung einer verhandlungsfähigen Failover-Logik, bei der Agenten bevorzugte Strategien vorschlagen und Gateways anhand von Systemzustand, Auslastung und Richtlinien entscheiden.
- Verkehrssysteme müssen eine standardmäßige Ausführungslogik unterstützen, wenn Agentenmetadaten fehlen, unvollständig sind oder die Schemavalidierung nicht bestehen, um eine kontrollierte Leistungsminderung sicherzustellen.
- Die Infrastruktur muss rekursive Delegierungen oder miteinander in Konflikt stehende Wiederholungsversuche von Agenten erkennen und verhindern, da diese bei einer Beeinträchtigung des Systems Schleifen auslösen oder das Datenverkehrsaufkommen erhöhen könnten.
Beispiel: Ein Agent, der mit einer Betrugsprüfung in Echtzeit beauftragt ist, fordert eine Antwort innerhalb von 50 ms an. Seine Fallback-Logik bevorzugt ein zwischengespeichertes Teilergebnis gegenüber einer langsamen vollständigen Abfrage. Eine Infrastruktur, die dies nicht berücksichtigt, leitet die Anfrage möglicherweise dennoch an das Backend mit vollem Funktionsumfang weiter, was zu für den Benutzer spürbaren Verzögerungen führt. Ein kooperativeres Modell würde die Fallback-Priorität des Agenten berücksichtigen und die schnellere Antwort mit eingeschränktem Umfang bereitstellen.
Wenn die Entscheidungsfindung auf höhere Ebenen des Stacks verlagert wird, müssen auch die Ausweichstrategien entsprechend angepasst werden. Schutzschalter und Wiederholungslogik dürfen nicht statisch oder undurchsichtig bleiben; sie müssen sich an die von Agenten geäußerten Präferenzen anpassen und zugleich die Sicherheit und Fairness des Gesamtsystems gewährleisten.
Hochverfügbarkeit und Failover sind nach wie vor wichtig
Während Agentenarchitekturen die Entscheidungsfindung und Koordination auf die Anfrageebene verlagern, bleibt die zugrunde liegende Infrastruktur weiterhin dafür verantwortlich, die grundlegende Zuverlässigkeit des Systems sicherzustellen. Daher sind Hochverfügbarkeit (HA) und Failover-Mechanismen auf Infrastrukturebene nach wie vor unverzichtbar. Tatsächlich gewinnen sie sogar noch an Bedeutung, wenn Systeme ein zunehmend dynamisches, autonomes Verhalten annehmen.
Agenten können den Datenverkehr anhand von Zielen und Kontext steuern, sind aber weiterhin auf das Netzwerk angewiesen, damit Dienste auch bei Störungen erreichbar und ausfallsicher bleiben. Load Balancer müssen nicht erreichbare Knoten, ausgefallene Dienste oder beeinträchtigte Umgebungen erkennen und den Datenverkehr unabhängig von der Ausweichstrategie des Agenten in Echtzeit umleiten.
Zentrale Aufgaben, die unverändert bleiben:
- Zustand der Pool-Mitglieder und Backend-Dienste überwachen
- Netzwerkpartitionen oder Routingfehler erkennen
- Datenverkehr basierend auf Betriebsfähigkeit, Verfügbarkeit oder Beeinträchtigungen auf Systemebene umleiten
- Bei Bedarf Hochverfügbarkeit für zustandsbehaftete Dienste oder Sitzungen gewährleisten
Agenten können Logik enthalten, die bestimmt, „was als Nächstes geschehen soll“, doch der Load Balancer legt weiterhin fest, „wie schnell wir den Betrieb wiederherstellen, wenn ein Knoten ausfällt“.
Es ist von entscheidender Bedeutung, dass eine adaptive, agentenorientierte Routing-Logik nicht zulasten der Betriebsstabilität geht. Eine umfassend instrumentierte Infrastruktur muss Folgendes gewährleisten:
- Sofortige Ausfallsicherung und Neuverteilung des Datenverkehrs, wenn Knoten nicht mehr verfügbar sind
- Ausfallsichere HA-Topologien, die Agents und Dienste vor Ausfällen vorgelagerter Systeme schützen
- Schnelle, automatisierte Wiederherstellung, die die Fallback-Logik des Agenten ergänzt, anstatt mit ihr in Konflikt zu geraten
Kurz gesagt: Agentengesteuerte Architekturen machen Failover nicht überflüssig – sie erhöhen vielmehr die Anforderungen. Die Infrastruktur muss nun schneller und kontextsensitiver reagieren, ohne dabei zum Engpass für autonomes Verhalten zu werden.
Auswirkungen auf das Traffic-Management in Unternehmen
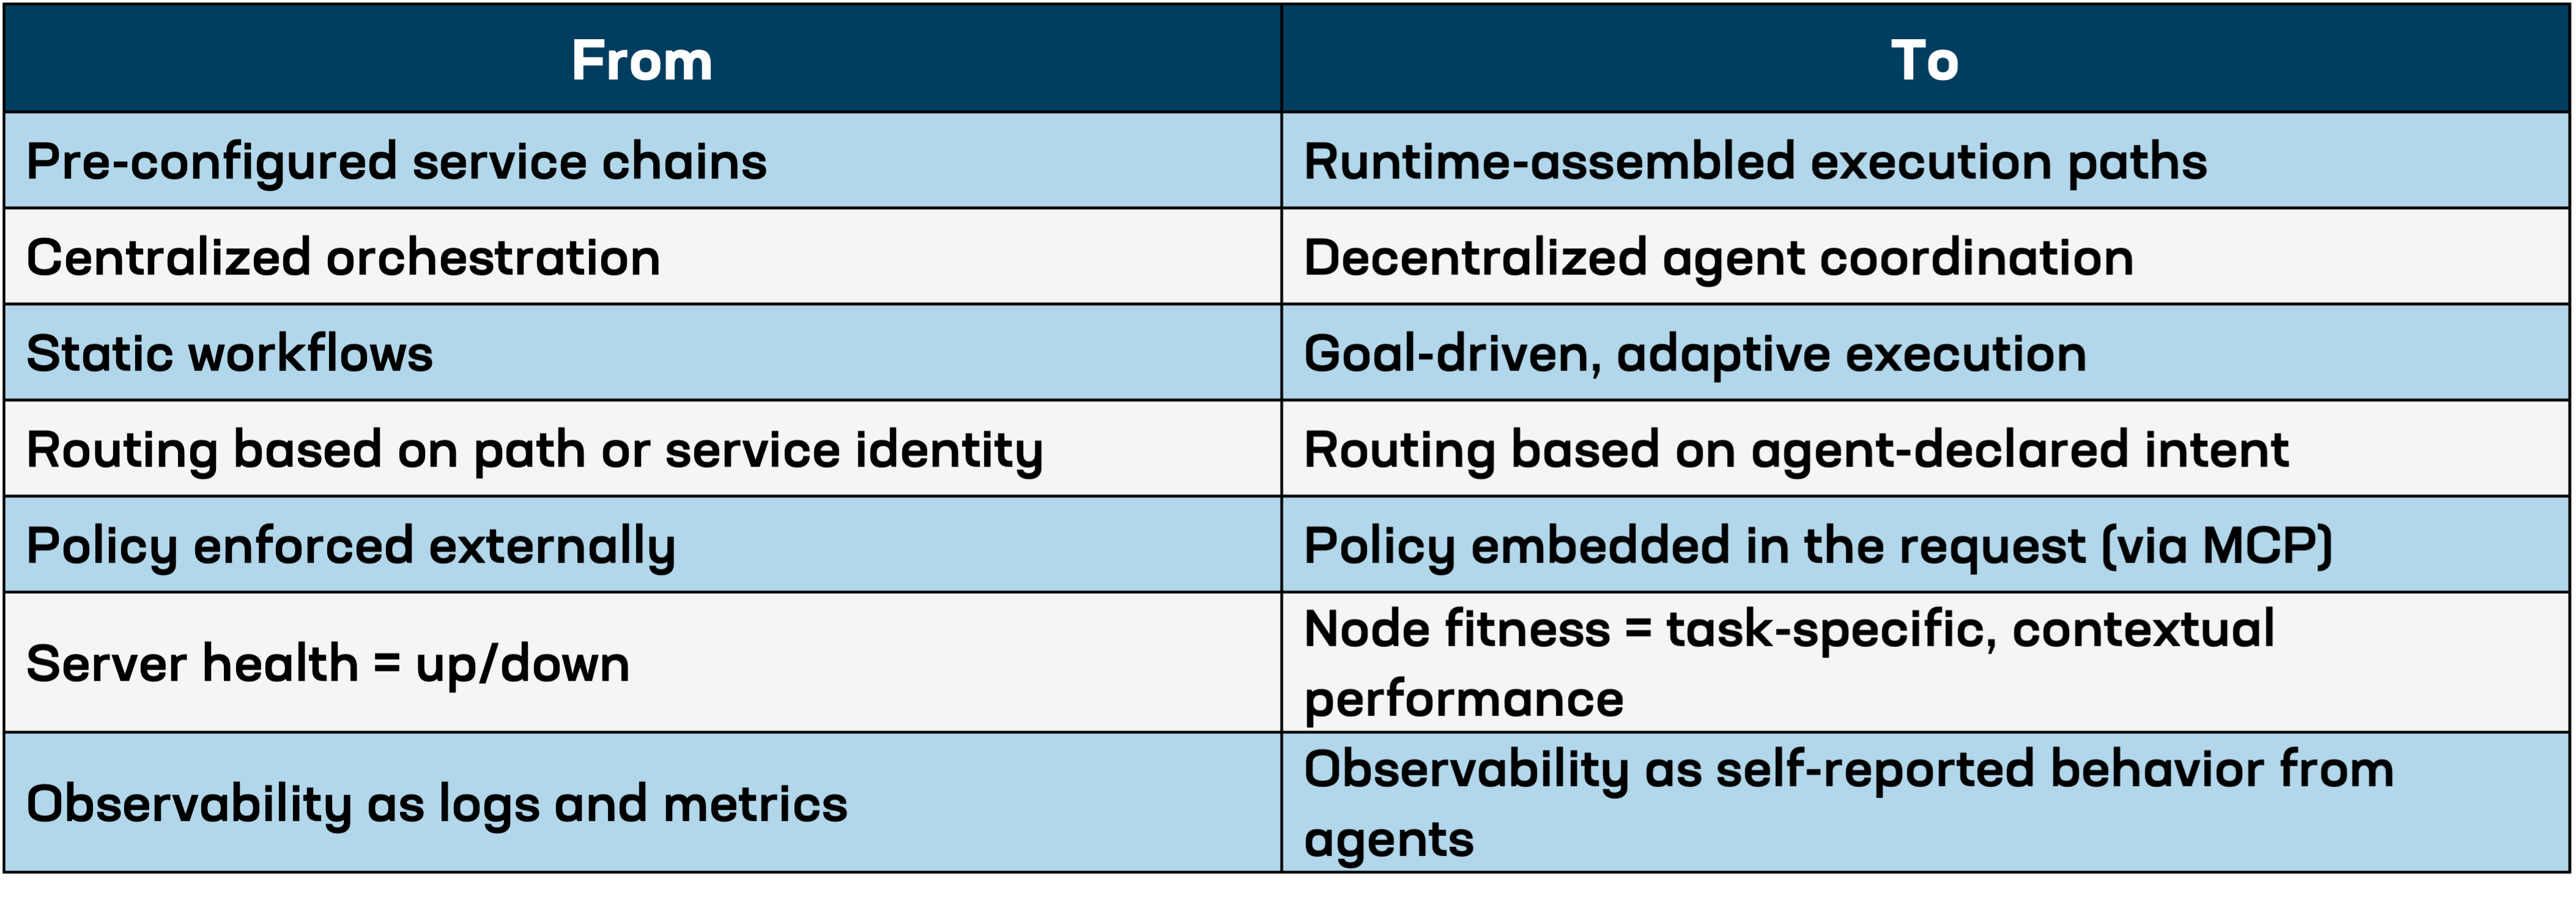
Der Übergang zu agentenbasierten Architekturen verändert grundlegend, wie Systeme zur Datenverkehrssteuerung wie Load Balancer und Gateways arbeiten müssen. Während herkömmliche Systeme zur Datenverkehrssteuerung Entscheidungen anhand vorkonfigurierter Richtlinien trafen, die häufig außerhalb der Anfrage lagen, integrieren agentengesteuerte Systeme diese Richtlinien direkt in die Anfrage. Dies bildet die Grundlage für das, was das Model Context Protocol (MCP) ermöglicht: die anfragespezifische Ausführung eingebetteter Richtlinien.
Wir nennen dieses Modell „Policy in der Nutzlast“. Anstatt zentralisierte Systeme jeden Sonderfall analysieren zu lassen, integriert der Agent relevante Policy-Entscheidungen (etwa zur Ausweichstrategie, Knotenpräferenz, Fehlertoleranz oder zu Datenschutzanforderungen) in jede Anfrage. Die Infrastruktur muss diese Policy-Anweisungen dann in Echtzeit lesen, interpretieren und umsetzen.
Dieses neue Ausführungsmodell verändert die Rolle der Komponenten für das Traffic-Management:
- Von Entscheidern zu Ausführenden: Die Infrastruktur bestimmt nicht mehr, wohin der Datenverkehr geleitet wird, sondern setzt die vom Agenten übermittelte Entscheidung um.Beispiel: Ein Load Balancer, der
X-Route-Preference: gpu-optimizedausliest, muss den Datenverkehr entsprechend weiterleiten, selbst wenn dieser Knoten nicht zum ursprünglichen Pool gehörte. - Zur Laufzeit programmierbar: iRules und Richtlinien müssen Header wie
X-Intent,X-ContextoderX-Goalauswerten. Dadurch verlagert sich die Logik von vorkonfigurierten Pfaden hin zu einer dynamischen Inline-Interpretation. - Kontextabhängiges Routing: ADCs und ähnliche Dienste müssen das Routing anhand von Identität, Absicht und Kontext vornehmen, nicht nur anhand von Host oder Pfad.
- Semantische Beobachtbarkeit: Protokolle sollten nicht nur zeigen, was passiert ist, sondern auch, warum: „Agent hat aufgrund einer Überschreitung des Latenzschwellenwerts umgeleitet“ ist aussagekräftiger als lediglich „an Pool B weitergeleitet.“
Datenkennzeichnungstechnologien und ähnliche Tools können diesen Wandel unterstützen, indem sie den Kontext von Anfragen in Echtzeit mit Tags versehen und klassifizieren. Dadurch lassen sich semantisches Routing und semantische Observability praktikabel umsetzen.
Unternehmensinfrastruktur auf Agentenarchitekturen vorbereiten
KI-Agenten werden nicht isoliert arbeiten. Sie werden mit Altsystemen interagieren, auf herkömmliche APIs zugreifen, Geschäftslogik in Unternehmensdatenbanken verarbeiten und Funktionen aufrufen, die sowohl auf monolithischen Backends als auch auf Microservices gehostet werden. Für Unternehmen bedeutet das: Sie können nicht bei null anfangen, sondern müssen sich weiterentwickeln.
Die Realität: Agenten werden mit allem kommunizieren
Enterprise-Technologie-Stacks sind eine Mischung aus:
- Jahrzehntealte SOAP-APIs, die noch immer im Finanzwesen eingesetzt werden
- RESTful-Dienste hinter Webanwendungen
- Nachrichtenwarteschlangen für asynchrone Bestandssysteme
- Cloud-native Microservices
- SaaS-APIs mit Ratenbegrenzungen und komplexer Authentifizierung
- LLMs und feinabgestimmte Agenten
Agenten müssen lernen, mit all diesen Komponenten zu arbeiten. Und Ihre Infrastruktur muss lernen, diese Interaktion in Echtzeit zu vermitteln und dabei kontextbezogene Richtlinien durchzusetzen.
Worauf sich Unternehmensteams vorbereiten müssen
1. Interne Systeme über absichtsorientierte Schnittstellen zugänglich machen
Agenten wollen nicht fünf Endpunkte, sondern ein einziges Ziel. Stellen Sie Geschäftsfunktionen (z. B. „Bestellstatus abrufen“) über Abstraktionsschichten oder API-Kompositionen bereit, die Agenten über einen einzigen semantischen Einstiegspunkt nutzen können.
Vorbereitungsschritt: Verwenden Sie API-Gateways oder Service-Meshes, um aufgabenorientierte Endpunkte mit klar definierten Ein- und Ausgabeverträgen zu konsolidieren.
2. Instrumentierung für Kontext, nicht nur für Metriken
Herkömmliche Protokollierung konzentriert sich auf Methode, Pfad und Antwortzeit. Für Agenten sind jedoch folgende Aspekte relevant:
- Worin die Aufgabe bestand
- Welcher Ausweichversuch unternommen wurde
- Ob das Ziel erreicht wurde
Vorbereitung: Setzen Sie semantische Observability-Tools ein, die den Datenverkehr mit Labels wie X-Intent, X-Task-Type und X-Agent-Outcome versehen.
3. Laufzeitauswertung eingebetteter Richtlinien unterstützen
Agenten übermitteln in der Anfrage Anweisungen für Ausweichlösungen, Zeitüberschreitungspräferenzen und Sicherheitsanforderungen. Die bestehende Infrastruktur verwirft diese Daten.
Vorbereitungsschritt: Erweitern Sie die Richtlinien für den Datenverkehr, damit sie Agentenmetadaten auswerten und entsprechend handeln können (z. B. X-Route-Preference, X-Fallback-Order, X-Data-Class). Beginnen Sie mit iRules oder einer vergleichbaren Laufzeit-Skriptsprache.
4. Zugriffskontrolle und Governance neu ausrichten
Agenten agieren autonom. Sie müssen Folgendes wissen:
- Welcher Agent in wessen Auftrag handelt
- Auf welche Tools er zugreifen kann
- Auf welche Datenbereiche es zugreifen darf
Vorbereitungsschritt: Integrieren Sie identitätsbasierte Zugriffs- und attributbasierte Richtlinienkontrollen (ABAC), statt sich nur auf IP-Whitelisting oder statische RBAC zu verlassen.
5. Fallback- und Wiederholungslogik entkoppeln
Infrastruktur und Agenten dürfen bei der Wiederherstellung nicht miteinander konkurrieren. Die eine Seite sollte sich um die Laufzeitziele kümmern, die andere systemweite Schutzmechanismen durchsetzen.
Vorbereitungsschritt: Trennen Sie klar den Zuständigkeitsbereich für den Rückgriff der Agenten (was diese steuern) vom Failover der Infrastruktur (wofür Sie verantwortlich sind). Legen Sie Regeln für die Abstimmung und Bedingungen für das Außerkraftsetzen fest.
Fazit
Mit der Weiterentwicklung von KI – von isolierten Modellen hin zu autonomen Agenten – stehen Unternehmen an einem strategischen Wendepunkt. Diese Agenten werden nicht auf der grünen Wiese agieren, sondern in bestehende Anwendungen integriert werden, Legacy-APIs aufrufen und Entscheidungen in geschäftskritischen Systemen steuern. Unternehmen müssen sich daher schon jetzt darauf vorbereiten, sie zu unterstützen – nicht nur mit neuen Tools, sondern auch, indem sie grundlegend überdenken, wie ihre Architektur mit Zielvorgaben, Ausführung und Governance umgeht.
Dies ist kein Zeitpunkt, um bestehende Systeme vollständig zu ersetzen. Vielmehr geht es jetzt um Konvergenz – darum, dass traditionelle Systeme und neu entstehende Verhaltensweisen von Agenten präzise und zielgerichtet zusammenwirken.
Agentenarchitekturen kommen. Unternehmen, die sich jetzt darauf vorbereiten, werden nicht nur Schritt halten, sondern eine Führungsrolle übernehmen.
LORI MACVITTIE
VERÖFFENTLICHT AM 01. JULI 2025