
Die Evolution von Application Delivery Controllern
Einführung
In der heutigen dynamischen Welt stehen Unternehmen ständig vor der Herausforderung, geschäftskritische Anwendungen für Millionen von Benutzern weltweit bereitzustellen. Daher ist es äußerst wichtig, Netzwerk- und Anwendungsdienste einzusetzen, um Anwendungen skalierbar, sicher und verfügbar zu machen. Dies ist einer der Hauptgründe für die Weiterentwicklung von Application Delivery Controllern (ADCs). Keine dieser Funktionen lässt sich jedoch ohne eine solide Grundlage in der grundlegenden Lastverteilungstechnologie umsetzen. Beginnen wir also damit, die Bedeutung der Lastverteilung zu verstehen, wie sie zu einer effizienten Anwendungsbereitstellung beiträgt und wie sich ADCs kontinuierlich weiterentwickeln und auf eine Cloud-First-Welt ausrichten.
Treiber der Nachfrage nach Lastverteilung
Der Zweck des Load Balancings besteht darin, den eingehenden Netzwerk- oder Anwendungsdatenverkehr auf mehrere physische Server zu verteilen und diese Server nach außen wie einen einzigen Server erscheinen zu lassen. Dafür gibt es viele Gründe, doch ausschlaggebend sind vor allem die Anforderungen an „Skalierbarkeit“, „Hochverfügbarkeit“ und „Vorhersagbarkeit“.
Skalierbarkeit bezeichnet die Fähigkeit, sich dynamisch oder auf einfache Weise an eine höhere Auslastung anzupassen, ohne die bestehende Leistung zu beeinträchtigen. Hochverfügbarkeit (High Availability, HA) hingegen bezeichnet die Fähigkeit einer Website, auch beim Ausfall eines oder mehrerer Systeme verfügbar und erreichbar zu bleiben. Die Servicevirtualisierung (die Nachbildung des Verhaltens von Softwarekomponenten zur Beschleunigung und zum Testen der Anwendungsentwicklung) bietet interessante Möglichkeiten sowohl für die Skalierbarkeit als auch für die Verfügbarkeit. Wenn der Dienst oder der Kontaktpunkt für Benutzer von den eigentlichen Servern getrennt wird, lässt sich die Anwendung durch das Hinzufügen weiterer Server skalieren. Darüber hinaus führt der Ausfall eines einzelnen Servers nicht dazu, dass die gesamte Anwendung nicht mehr verfügbar ist. Vorhersagbarkeit ist etwas weniger eindeutig, da sie sowohl Aspekte der Hochverfügbarkeit als auch einige im Laufe der Zeit gewonnene Erkenntnisse umfasst. Am besten lässt sie sich als die Kontrolle darüber beschreiben, wie und wann Dienste im Hinblick auf Verfügbarkeit und Leistung bereitgestellt werden.
Lastverteilung: Eine historische Perspektive
In den Anfangstagen des kommerziellen Internets entdeckten viele angehende Dotcom-Millionäre ein gravierendes Problem in ihren Plänen. Für Großrechner gab es keine Webserver-Software (jedenfalls nicht vor dem AS/400e), und selbst wenn es sie gegeben hätte, wären solche Systeme mit dem Budget eines Start-ups unerschwinglich gewesen. Was sie sich leisten konnten, war handelsübliche Standard-Serverhardware von einem der allgegenwärtigen PC-Hersteller. Das Hauptproblem bestand darin, dass ein einzelner PC-basierter Server unmöglich das Datenverkehrsaufkommen bewältigen konnte, das ihr Unternehmen erzeugen würde. Und wenn er ausfiel, waren sie offline und damit aus dem Geschäft. Glücklicherweise wollten einige dieser Leute ihre Millionen damit verdienen, genau dieses Problem zu lösen. So entstand das Load Balancing.
Am Anfang war das DNS
Bevor kommerziell erhältliche, speziell für die Lastverteilung entwickelte Geräte verfügbar waren, gab es zahlreiche Versuche, mithilfe bestehender Technologien die angestrebte Skalierbarkeit und Verfügbarkeit zu erreichen. Die am weitesten verbreitete (und noch immer eingesetzte) Technologie war DNS-Round-Robin.
Bei dieser Methode wies das DNS verschiedenen Servern unter demselben DNS-Namen mehrere eindeutige IP-Adressen zu. Wenn ein Benutzer also erstmals die Namensauflösung für „www.example.com“ anforderte, leitete der DNS-Server jede neue Verbindung an den jeweils nächsten Server in der Reihenfolge weiter, bis das Ende der Liste erreicht war. Anschließend begann er wieder beim ersten Server. Diese Lösung war einfach und sorgte für eine gleichmäßige Verteilung der Verbindungen auf eine Gruppe von Rechnern.
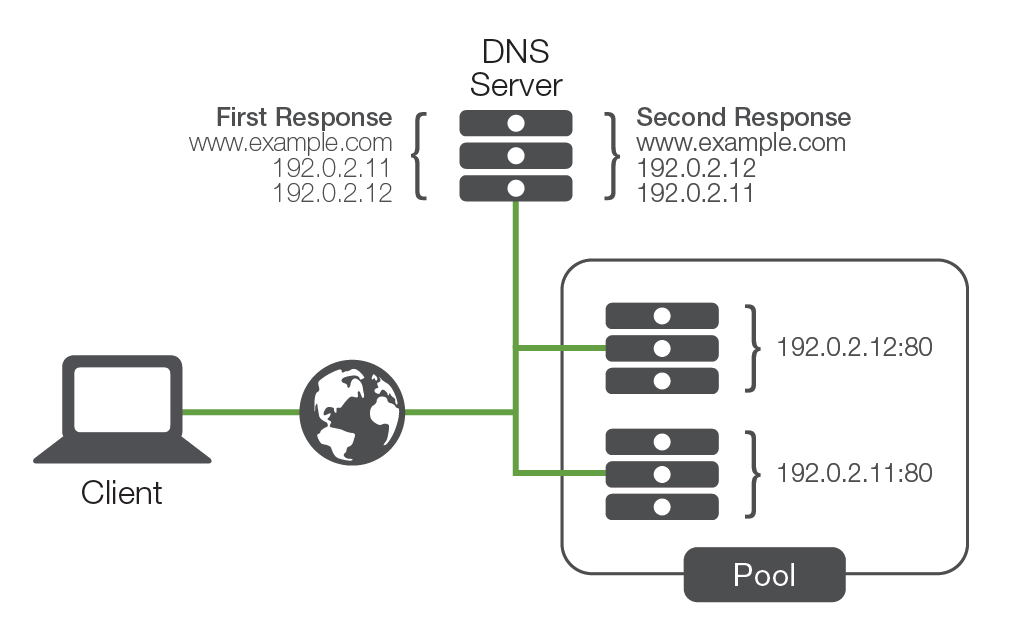
Unter dem Gesichtspunkt der Skalierbarkeit funktionierte diese Lösung bemerkenswert gut, da sie die Möglichkeit bot, einem DNS-Namen eine nahezu unbegrenzte Anzahl von Servern hinzuzufügen. Im Hinblick auf die Verfügbarkeit stellte die Lösung jedoch ein Hindernis dar, da das DNS nicht erkennen konnte, ob die aufgeführten Server funktionierten oder nicht. Wenn ein Server nicht mehr verfügbar war und ein Benutzer versuchte, darauf zuzugreifen, konnte die Anfrage an einen ausgefallenen Server gesendet werden.
Ein weiterer wichtiger Aspekt des DNS-Round-Robin-Verfahrens war die Vorhersagbarkeit, also ein hohes Maß an Gewissheit darüber, dass ein Benutzer an einen bestimmten Server weitergeleitet wird. Im Mittelpunkt steht dabei die Persistenz – das Konzept, mit dem sichergestellt wird, dass ein Benutzer nach Beginn einer Sitzung oder bei der Wiederaufnahme einer zuvor unterbrochenen Sitzung nicht per Lastverteilung einem neuen Server zugewiesen wird. Dies ist ein sehr wichtiges Problem, das sich mit DNS-Round-Robin nicht lösen ließ.
Proprietärer softwarebasierter Lastenausgleich
Um dieses Problem zu lösen, bestand eine der ersten speziell dafür entwickelten Lösungen darin, den Lastenausgleich direkt in die Anwendungssoftware oder das Betriebssystem (OS) des Anwendungsservers zu integrieren. Zwar gab es ebenso viele unterschiedliche Implementierungen wie Unternehmen, die sie entwickelten, doch die meisten Lösungen basierten auf einfachen Netzwerkkniffen. Bei einer solchen Lösung verfügten beispielsweise alle Server in einem Pool (auch als Cluster bezeichnet) zusätzlich zu ihrer eigenen physischen IP-Adresse über eine weitere gemeinsame IP-Adresse.
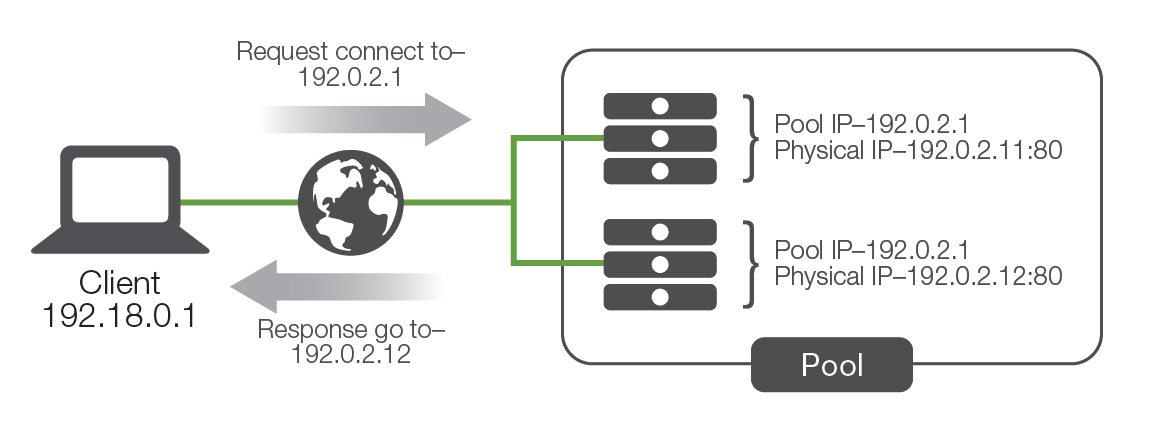
Wenn Benutzer versuchten, eine Verbindung mit dem Dienst herzustellen, stellten sie die Verbindung mit der Pool-IP statt mit der physischen IP-Adresse des Servers her. Der Server im Pool, der zuerst auf die Verbindungsanfrage antwortete, leitete den Benutzer an eine physische IP-Adresse weiter (entweder an seine eigene oder an die eines anderen Systems im Pool), woraufhin die Dienstsitzung begann. Einer der wesentlichen Vorteile dieser Lösung bestand darin, dass die Anwendungsentwickler anhand verschiedener Informationen bestimmen konnten, mit welcher physischen IP-Adresse der Client eine Verbindung herstellen sollte. Beispielsweise konnte jeder Server im Pool erfassen, wie viele Sitzungen die einzelnen Pool-Mitglieder bereits bedienten, sodass neue Anfragen an den am wenigsten ausgelasteten Server weitergeleitet werden konnten.
Anfangs lag die Skalierbarkeit dieser Lösung auf der Hand. Man musste lediglich einen neuen Server einrichten und dem Pool hinzufügen, um die Kapazität der Anwendung zu erhöhen. Im Laufe der Zeit wurde die Skalierbarkeit des anwendungsbasierten Lastausgleichs jedoch zunehmend infrage gestellt. Da die Pool-Mitglieder ständig miteinander kommunizieren mussten, um festzulegen, an welchen Server die nächste Verbindung weitergeleitet werden sollte, nahm der Netzwerkverkehr zwischen ihnen mit jedem neu zum Pool hinzugefügten Server exponentiell zu. Sobald der Pool eine bestimmte Größe erreicht hatte (in der Regel 5–10 Hosts), beeinträchtigte dieser Datenverkehr sowohl den Datenverkehr der Endbenutzer als auch die Prozessorauslastung der Server selbst. Die Skalierbarkeit war also hervorragend, solange nur eine geringe Anzahl von Servern benötigt wurde (übrigens weniger als beim DNS-Round-Robin-Verfahren).
Durch DNS-Round-Robin und softwarebasierte Lastverteilung wurde die Hochverfügbarkeit (HA) erheblich verbessert. Da die Mitglieder des Pools ständig miteinander kommunizierten und die Anwendungsentwickler dank ihrer umfassenden Anwendungskenntnisse feststellen konnten, ob ein Server ordnungsgemäß funktionierte, schlossen diese Lösungen praktisch aus, dass Benutzer jemals auf einen Server gelangten, der ihre Anfragen nicht bearbeiten konnte. Es muss jedoch darauf hingewiesen werden, dass jede Weiterentwicklung intelligenter HA-Funktionen mit einer entsprechenden Belastung der Server- und Netzwerkressourcen einherging, wodurch die Skalierbarkeit weiter eingeschränkt wurde. Eine weitere negative Auswirkung auf die Hochverfügbarkeit betraf die Zuverlässigkeit. Viele der in diesen Systemen zur Verteilung des Datenverkehrs eingesetzten Netzwerktricks waren komplex und erforderten eine umfangreiche Überwachung auf Netzwerkebene. Daher traten bei diesen Verteilungsmethoden häufig Probleme auf, die sich auf die gesamte Anwendung und den gesamten Datenverkehr im Anwendungsnetzwerk auswirkten.
Diese Lösungen verbesserten auch die Vorhersagbarkeit. Da die Anwendungsentwickler wussten, wann und warum Benutzer zum selben Server zurückgeleitet werden mussten, anstatt die Last zu verteilen, konnten sie eine Logik integrieren, die bei Bedarf die Sitzungspersistenz der Benutzer sicherstellte. Außerdem nutzten sie dieselbe „Pooling“-Technologie, um Informationen zum Benutzerstatus zwischen Servern zu replizieren. Dadurch entfielen viele der Fälle, in denen zuvor Sitzungspersistenz erforderlich war. Dank ihrer umfassenden Anwendungskenntnisse konnten sie schließlich Lastausgleichsalgorithmen entwickeln, die auf dem tatsächlichen Zustand der Anwendung basierten und nicht auf Faktoren wie der Anzahl der Verbindungen, die nicht immer ein zuverlässiger Indikator für die Serverauslastung waren.
Neben den potenziellen Einschränkungen hinsichtlich echter Skalierbarkeit und den Problemen mit der Zuverlässigkeit hatte das proprietäre, anwendungsbasierte Load Balancing noch einen weiteren Nachteil: Seine Entwicklung und Wartung waren vom Anwendungsanbieter abhängig. Das Hauptproblem bestand darin, dass nicht alle Anwendungen Load-Balancing- (oder Pooling-)Technologien bereitstellten und die vorhandenen Lösungen häufig nicht mit denen anderer Anwendungsanbieter kompatibel waren. Zwar gab es mehrere Unternehmen, die anbieterneutrale Load-Balancing-Software auf Betriebssystemebene entwickelten, doch diese litt leider unter denselben Skalierbarkeitsproblemen. Und ohne eine enge Integration in die Anwendungen brachten diese Software-„Lösungen“ zusätzliche Herausforderungen im Hinblick auf Hochverfügbarkeit mit sich.
Netzwerkbasierte Hardware zur Lastverteilung
Die zweite Generation speziell entwickelter Lösungen für den Lastenausgleich entstand in Form netzwerkbasierter Appliances. Sie sind die eigentlichen Vorläufer der heutigen Application Delivery Controller. Diese Appliances befanden sich physisch außerhalb der Anwendungen. Obwohl sie ursprünglich als Load Balancer konzipiert waren, realisierten sie den Lastenausgleich mithilfe wesentlich einfacherer Netzwerktechniken wie NAT. Diese Geräte stellten der Außenwelt eine virtuelle Serveradresse bereit. Wenn Benutzer versuchten, eine Verbindung herzustellen, leiteten die Geräte diese an den am besten geeigneten realen Server weiter.
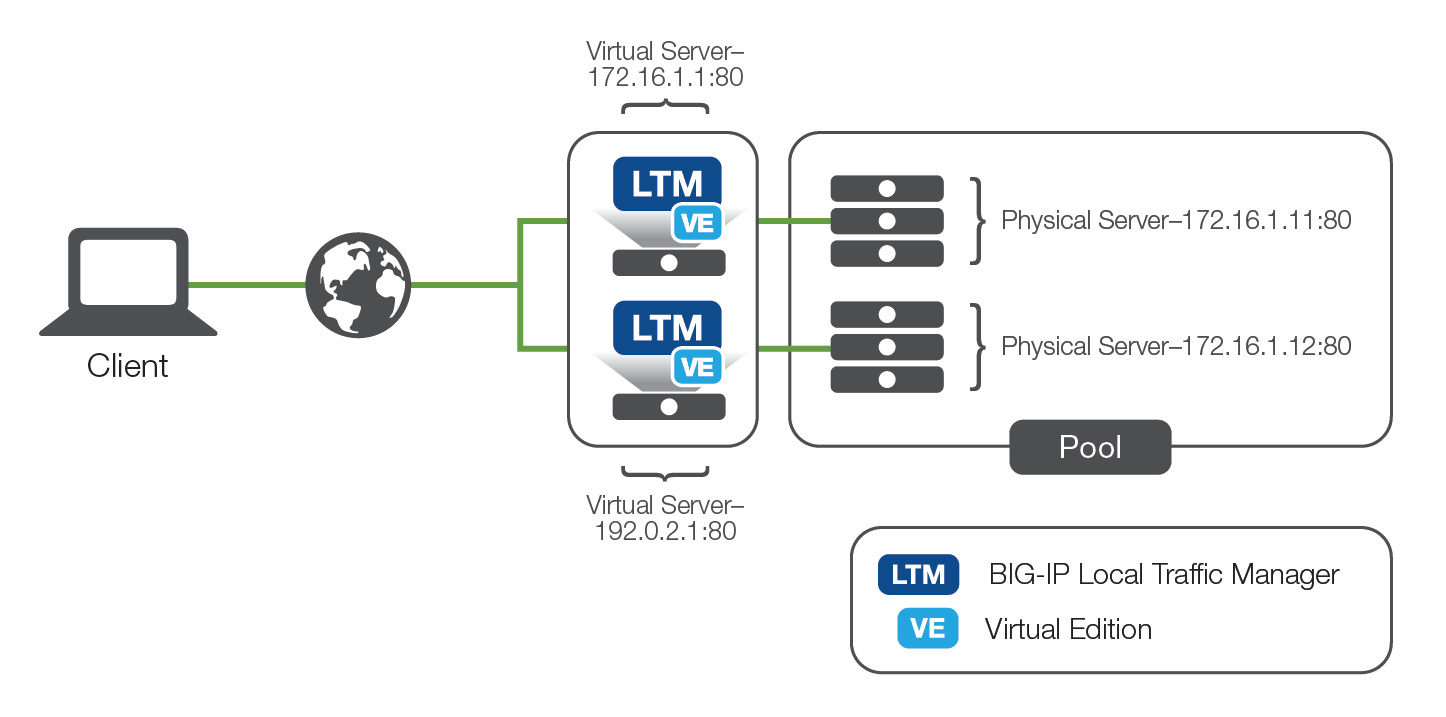
Der Load Balancer konnte genau steuern, welcher Server welche Verbindung erhielt, und setzte zunehmend komplexe „Health Monitors“ ein, um sicherzustellen, dass der Anwendungsserver (ein realer, physischer Server) wie erforderlich reagierte. Wenn der Server nicht ordnungsgemäß reagierte, leitete der Load Balancer automatisch keinen Datenverkehr mehr an diesen Server weiter, bis dieser wieder die gewünschte Antwort lieferte. Obwohl die Health Monitors nur selten so umfassend waren wie die von den Anwendungsentwicklern selbst erstellten, konnte der netzwerkbasierte Hardwareansatz grundlegende Load-Balancing-Dienste für nahezu jede Anwendung auf einheitliche und konsistente Weise bereitstellen – und damit endlich einen vollständig virtualisierten, speziell auf die Anwendungsserver zugeschnittenen Dienstzugangspunkt schaffen.
Unter dem Gesichtspunkt der Skalierbarkeit verzeichneten Unternehmen, die damit begannen, softwarebasiertes Load Balancing durch eine hardwarebasierte Lösung zu ersetzen, einen drastischen Rückgang der Auslastung ihrer Server. Dadurch mussten sie kurzfristig keine zusätzlichen Server anschaffen und konnten langfristig einen höheren ROI erzielen.
In ähnlicher Weise trug HA dazu bei, die Komplexität der Lösung zu reduzieren und einen anwendungsunabhängigen Lastenausgleich bereitzustellen, was zu höherer Zuverlässigkeit und einem größeren Funktionsumfang der Lösung führte. Netzwerkbasierte Hardware für den Lastenausgleich ermöglichte es dem Unternehmen, für alle seine Anwendungen eine hohe Verfügbarkeit zu gewährleisten, anstatt nur für die wenigen mit integriertem Lastenausgleich.
Die netzwerkbasierte Hardware für den Lastenausgleich brachte als zentrale Komponente Vorhersagbarkeit ins Spiel. Nun ließ sich wesentlich leichter vorhersagen und steuern, wohin eine neue Verbindung geleitet werden würde. Diese Geräte machten den Prozess intelligenter und ermöglichten dadurch eine kontrollierte Lastverteilung (im Gegensatz zur unkontrollierten Verteilung durch dynamisches DNS). So konnten Unternehmen die Last entsprechend der Kapazität der einzelnen Server auf diese verteilen.
Das Aufkommen netzwerkbasierter Load Balancer und der Virtualisierung brachte neue Vorteile für Sicherheit und Verwaltung mit sich. So ließ sich etwa die Identität von Anwendungsservern gegenüber der Internet-Community verbergen und die Verbindungen eines Servers konnten schrittweise abgebaut werden, sodass er zu Wartungszwecken offline genommen werden konnte, ohne die Benutzer zu beeinträchtigen. Auf dieser Grundlage entstanden ADCs.
Application Delivery Controller
Mit einer zentralen Lastverteilungsfunktion, die zugleich als Full Proxy fungiert, bot sich der IT eine hervorragende Möglichkeit, neue und aufkommende Dienste zu ergänzen und zu konsolidieren. Dadurch entwickelte sich das Lastverteilungsgerät zu einer erweiterbaren ADC-Plattform. Einfach ausgedrückt bildet die Proxy-Technologie die Grundlage für die Lastverteilung und ist die Basistechnologie, die ADCs überhaupt erst ermöglicht.
Bei der Betrachtung der ADC-Sicherheit ist die durch den Proxy (die Basistechnologie) geschaffene Virtualisierung von entscheidender Bedeutung. Ob es um die Auslagerung der SSL/TLS-Verschlüsselung, die zentrale Authentifizierung oder sogar anwendungsspezifische Firewalls geht: Die Stärke dieser Lösungen beruht darauf, dass ein Load Balancer (als Hardware oder virtuelle Edition) den zentralen Virtualisierungspunkt für alle Anwendungen bildet. Die zentrale Authentifizierung ist ein klassisches Beispiel. Herkömmliche Authentifizierungs- und Autorisierungsmechanismen waren schon immer direkt in die jeweilige Anwendung integriert. Wie beim anwendungsbasierten Load Balancing war jede Implementierung von der jeweiligen Anwendung abhängig und speziell auf sie zugeschnitten, was zu zahlreichen unterschiedlichen Verfahren führte. Wird die Authentifizierung stattdessen am virtualisierten Zugangspunkt zu allen Anwendungen durchgeführt, kann ein einziges, einheitliches Authentifizierungsverfahren eingesetzt werden. Dies vereinfacht nicht nur die Konzeption und Verwaltung des Authentifizierungssystems erheblich, sondern verbessert auch die Leistung der Anwendungsserver, da diese Funktion dort nicht mehr ausgeführt werden muss. Darüber hinaus entfällt insbesondere bei selbst entwickelten Anwendungen der Zeit- und Kostenaufwand für die Entwicklung separater Authentifizierungsprozesse in jeder einzelnen Anwendung.
Verfügbarkeit ist die ADC-Eigenschaft, die sich am einfachsten auf den ursprünglichen Load Balancer zurückführen lässt, da sie mit allen grundlegenden Eigenschaften eines Load Balancers zusammenhängt: Skalierbarkeit, Hochverfügbarkeit und Vorhersagbarkeit. ADCs gehen dabei jedoch noch weiter als herkömmliche Load Balancer. Bei ADCs umfasst Verfügbarkeit auch fortschrittliche Konzepte wie Anwendungsabhängigkeiten und dynamische Bereitstellung. ADCs können berücksichtigen, dass Anwendungen heute nur noch selten eigenständig arbeiten: Häufig sind sie auf andere Anwendungen angewiesen, um ihre vorgesehenen Aufgaben zu erfüllen. Dieses Wissen verbessert die Fähigkeit des ADCs, die Anwendungsverfügbarkeit sicherzustellen, da er auch diese anderen Prozesse berücksichtigt. Die intelligentesten ADCs auf dem Markt bieten zudem Programmierschnittstellen, über die sie ihre Dienste anhand externer Eingaben dynamisch anpassen können. Diese Schnittstellen ermöglichen die dynamische Bereitstellung sowie die automatisierte Auf- und Abskalierung, die für moderne Umgebungen wie Cloud- und containerisierte Bereitstellungen erforderlich sind.
Die Leistungssteigerung war eine weitere naheliegende Erweiterung des Load-Balancing-Konzepts. Load Balancer verbesserten die Anwendungsleistung von Haus aus, indem sie sicherstellten, dass Verbindungen nicht nur an verfügbare Dienste weitergeleitet wurden, die innerhalb eines akzeptablen Zeitrahmens antworteten, sondern auch an diejenigen Dienste mit den wenigsten Verbindungen und/oder der geringsten Prozessorauslastung. Dadurch wurde jede neue Verbindung von dem System verarbeitet, das dafür am besten geeignet war. Als später die SSL/TLS-Auslagerung mithilfe dedizierter Hardware zum festen Bestandteil von Load-Balancing-Lösungen wurde, verringerte sie sowohl den Rechenaufwand für verschlüsselten Datenverkehr als auch die Belastung der Backend-Server und steigerte damit ebenfalls deren Leistung.
Heutige ADCs gehen noch einen Schritt weiter. Diese Geräte umfassen häufig Caching, Komprimierung und sogar Technologien zur Bandbreitensteuerung, um die Gesamtleistung und Bereitstellung von Anwendungen weiter zu verbessern. Anstatt diese Dienste wie herkömmliche eigenständige Appliances statisch bereitzustellen, kann ein ADC zudem seine integrierte Anwendungsintelligenz nutzen, um sie nur dann anzuwenden, wenn sie einen Leistungsvorteil bieten, und so ihren Einsatz optimieren.
So ist beispielsweise die Komprimierungstechnologie – entgegen der landläufigen Meinung – nicht zwangsläufig für alle Benutzer der Anwendung von Vorteil. Benutzer mit geringer Bandbreite können zweifellos erheblich von kleineren Paketen profitieren, da der tatsächliche Datendurchsatz den Engpass darstellt. Auch Verbindungen über große Entfernungen können davon profitieren, weil kleinere Pakete weniger Hin- und Rückübertragungen für den Datentransport erfordern und dadurch die Auswirkungen der Netzwerklatenz verringern. Bei Verbindungen über kurze Entfernungen (etwa innerhalb desselben Kontinents) mit hoher Bandbreite kann sich die Komprimierung jedoch negativ auf die Leistung auswirken. Da der Datendurchsatz hier nicht unbedingt den Engpass darstellt, verursacht der zusätzliche Aufwand für die Komprimierung und Dekomprimierung eine Latenz, die aus Leistungssicht nicht durch den höheren Datendurchsatz ausgeglichen wird. Mit anderen Worten: Wird sie nicht richtig eingesetzt, kann die Komprimierungstechnologie als Lösung mehr Probleme verursachen als das ursprüngliche Problem selbst. Indem ein ADC die Komprimierung jedoch intelligent nur dann einsetzt, wenn sie die Gesamtleistung verbessert, optimiert er den Einsatz und die Kosten der Komprimierungstechnologie und stellt mehr Prozessorzyklen für Funktionen bereit, die diese am effektivsten nutzen.
Wohin sich die Welt entwickelt
Da die digitale Transformation eine so wichtige strategische Notwendigkeit darstellt, haben sich viele Unternehmen auf den Weg in die Cloud gemacht. Angesichts der wachsenden Zahl von Anwendungen, die unsere Welt verändern, wird davon ausgegangen, dass Unternehmen durch den Wechsel in die Cloud von zahlreichen Vorteilen profitieren, darunter höhere Agilität, besser abgestimmte Betriebskosten, bedarfsgerechte Skalierbarkeit und eine stärkere Konzentration auf ihr Kerngeschäft.
Die „Cloud“ ist keine amorphe Einzeleinheit aus gemeinsam genutzten Rechen-, Speicher- und Netzwerkressourcen. Vielmehr besteht sie aus einem komplexen Zusammenspiel von Anbietern, Infrastrukturen, Technologien und Umgebungen, die häufig über mehrere globale Standorte verteilt sind. Aus diesem Grund haben viele Unternehmen ihre Anwendungen in verschiedenen Clouds bereitgestellt – in öffentlichen und privaten Clouds oder sogar in einer Kombination aus allen Varianten. Das ist Multi-Cloud: die neue Realität.
Trotz dieser sich rasant entwickelnden Landschaft gibt es mehrere Faktoren, die die Cloud-Einführung verlangsamen. Die erste Herausforderung ist die unkontrollierte Ausbreitung von Multi-Cloud-Umgebungen: Bestehende Anwendungen wurden per „Lift and Shift“ migriert, während „Cloud-native“ Anwendungen ungeplant und unkontrolliert bereitgestellt wurden. Um ihren kurzfristigen Bedarf zu decken, setzen Unternehmen zudem häufig auf uneinheitliche Cloud-Plattformen, unterschiedliche Architekturen, verschiedene Anwendungsdienste und mehrere Toolsets. Dies führt zu einer hohen architektonischen Komplexität im gesamten Unternehmen und erschwert die Verlagerung von Anwendungen von einer Umgebung in eine andere erheblich – ganz zu schweigen von den damit verbundenen Kosten.
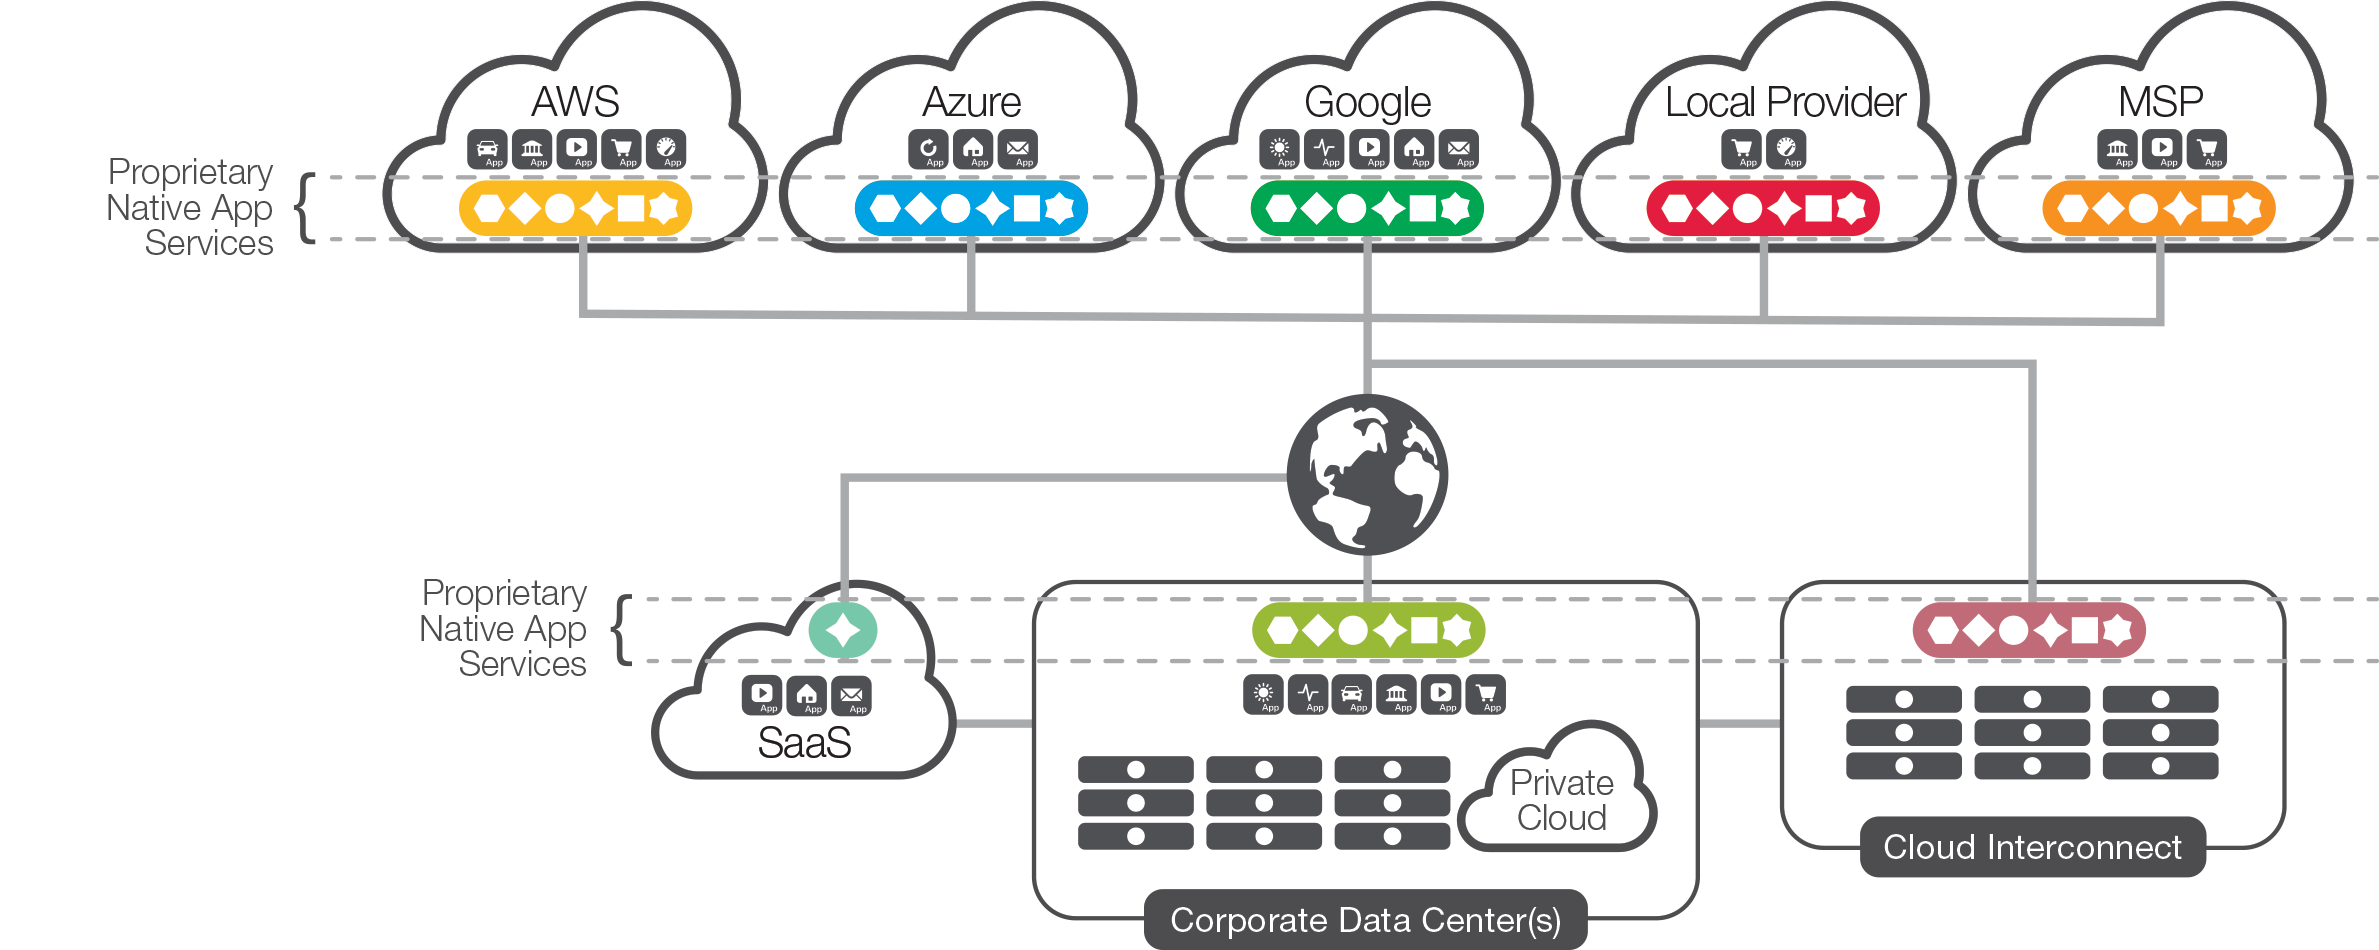
Trotz dieser Herausforderungen wird die Zahl neuer Bereitstellungen in und über öffentliche und private Clouds hinweg in den kommenden Jahren unweigerlich zunehmen. Multi-Cloud rückt immer näher, und für Unternehmen ist es an der Zeit, intelligente Anwendungsdienste und ADCs einzusetzen, die mehr leisten, als nur eine begrenzte Anzahl von Anwendungen zu unterstützen oder ausschließlich auf Hardware und in einer einzigen Cloud betrieben zu werden.
Zusammenfassung
ADCs sind die natürliche Weiterentwicklung der früheren Load Balancer, die einst eine zentrale Position in der Netzwerkinfrastruktur einnahmen. Obwohl ADCs diesen Vorgängern viel zu verdanken haben, stellen sie eine völlig neue Geräteklasse dar, die nicht nur Verfügbarkeit, sondern auch Leistung und Sicherheit bietet. Wie ihr Name bereits andeutet, berücksichtigen sie sämtliche Aspekte, um eine Anwendung bestmöglich bereitzustellen.
Mit fortschrittlichen Funktionen wie Anwendungsintelligenz, SSL-Offloading und Programmierschnittstellen können moderne ADCs Unternehmen dabei unterstützen, ihr Geschäft zu skalieren und Benutzer jederzeit und überall zu erreichen. Angesichts der sich ständig wandelnden Anforderungen der technischen Welt sind ADCs zudem besser in der Lage, sich an die neuesten Technologien in Multi-Cloud- und Container-Umgebungen anzupassen.
Letztlich lässt sich mit Sicherheit sagen, dass ADCs nicht nur der wichtigste Übertragungsweg und Integrationspunkt sein werden, über den Anwendungen schneller, intelligenter und sicherer bereitgestellt werden, sondern sich auch kontinuierlich weiterentwickeln und die Cloud-First-Welt erschließen werden.
VERÖFFENTLICHT AM 10. SEPTEMBER 2017