
Zero-Trust-Sicherheit: Warum Zero Trust wichtig ist (und zwar nicht nur für den Zugriff)
Zusammenfassung
Eines der zentralen Themen beim Netzwerk- und Anwendungszugriff war in den vergangenen Jahren das Konzept „Zero Trust“. In diesem Beitrag zeigen wir, dass sich Zero Trust im Kern durch einige wenige, einfache Grundannahmen charakterisieren lässt, die nicht nur auf den Zugriff, sondern auch allgemeiner auf den gesamten Bereich der Cybersicherheit angewendet werden können.
Dieses Whitepaper stellt ein Rahmenwerk vor, das die umfassenden Konzepte rund um Zero Trust abbildet und sie mit den bestehenden geschäftlichen Rahmenbedingungen verknüpft, die für heutige Führungskräfte im Bereich Anwendungssicherheit maßgeblich sind. Abschließend beschreibt dieses Whitepaper das Zero-Trust-Überzeugungssystem – die treibende Kraft hinter den Tools und Sicherheitsimplementierungen zur Abwehr aktueller und neu entstehender Bedrohungen, die im Mittelpunkt eines nachfolgenden Whitepapers stehen werden.
Dieses Dokument verfolgt zwei Ziele: Erstens soll es die sicherheitsorientierte Denkweise vermitteln, die Führungskräfte im Anwendungsgeschäft verinnerlichen sollten, und zweitens einen Rahmen für Sicherheitsexperten vorstellen, den wir in künftigen Whitepapers weiter ausarbeiten werden.
ZTS: Mit Prinzipien beginnen, nicht mit Technologien
Der Begriff „Zero Trust“ wird mit einer Reihe unterschiedlicher Konzepte auf verschiedenen Abstraktionsebenen in Verbindung gebracht: mal als konkrete Lösungsarchitektur, mal als Vorgabe für den Einsatz bestimmter Technologien und ein anderes Mal als mögliche Eigenschaft eines Produkts. Wir sind der Überzeugung, dass Zero-Trust-Sicherheit im Kern eine Denkweise – ein Überzeugungssystem – ist, aus der sich Techniken und Taktiken ableiten, die bestimmte Technologien nutzen und anschließend zur Abwehr eines breiten Spektrums von Sicherheitsbedrohungen eingesetzt werden können.
Das Zero Trust Security (ZTS) zugrunde liegende Überzeugungssystem kann als nächster Schritt in der Entwicklung des Sicherheitsdenkens betrachtet werden, die vor Jahren mit dem Prinzip der „mehrschichtigen Verteidigung“ (Defense in Depth) begann. Dieses Prinzip beruht auf der Annahme, dass jede einzelne Schutzmaßnahme zwar mit einer geringen, aber realen Wahrscheinlichkeit überwunden werden kann, zusätzliche Schutzebenen für wichtige Ressourcen diese Wahrscheinlichkeit jedoch verringern. Dadurch werden Angreifer ausgebremst und zugleich gezwungen, mehr Ressourcen für einen erfolgreichen Angriff aufzuwenden.
Zero Trust ist eine Weiterentwicklung dieser Denkweise in drei Dimensionen:
- Erstens entwickelt es die Schutzprämisse von einer Reihe einfacher „Filter“, die den Zugriff auf die Anwendung regeln, hin zu einer stärker auf die jeweiligen Ressourcen abgestimmten Reihe von Schutzmaßnahmen, die kontextbezogen auf jede Systemtransaktion angewendet werden. Bei jeder Transaktion gilt es zu verstehen: Wer versucht, welche Aktion an wem auszuführen? „Wer“ und „wem“ können beliebige Komponenten innerhalb des Systems oder bei dessen Nutzung sein – ob Mensch, automatisierter Prozess oder Code. Das Konzept der Identität ist entscheidend für wer und wem, und anhand der einer Identität gewährten Berechtigungen wird festgelegt, was getan werden darf.
- Zweitens betrachtet es die Bewertung von Sicherheitsentscheidungen nicht als statisch und absolut, sondern vielmehr als dynamisch und anpassungsfähig, sodass sie angesichts beobachteter Verhaltensweisen kontinuierlich neu bewertet wird. Bei der Entscheidung über die Behandlung jeder Transaktion – ob die Interaktion zugelassen oder blockiert, zusätzliches Vertrauen aufgebaut werden soll usw. – müssen auch der übergeordnete Geschäftskontext und insbesondere die Abwägung zwischen Risiko und Nutzen berücksichtigt werden.
- Schließlich wird davon ausgegangen, dass unabhängig von der Anzahl der vorhandenen Schutzebenen ein ausreichend motivierter oder vom Glück begünstigter Angreifer die Schutzmaßnahmen entweder überwinden oder umgehen wird. Daher müssen auch die frühzeitige Erkennung einer Kompromittierung und die Abwehr versuchter Angriffe ein zentraler Bestandteil der Gesamtstrategie sein.
Diese Entwicklung ist zum Teil das Ergebnis von Zeit und Erfahrung, wird jedoch zunehmend durch das Zusammentreffen zweier weiterer Trends in der Anwendungssicherheit vorangetrieben. Insbesondere eröffnen heutige Anwendungsarchitekturen einen wesentlich größeren Raum für potenzielle Anwendungsschwachstellen – vor allem Bedrohungen aus dem „Inneren“ der Anwendungsinfrastruktur –, die aufgrund der zunehmenden Raffinesse heutiger Angreifer ausgenutzt werden können. Glücklicherweise haben gleichzeitige Fortschritte bei Sicherheitstools, insbesondere in Verbindung mit modernen Möglichkeiten zur Datenerfassung und -analyse, die praktische Umsetzung zentraler Komponenten der Verteidigungsstrategie ermöglicht.
Der verbleibende Teil dieser Einführung gibt einen Überblick über den Rahmen unseres Ansatzes für Zero-Trust-Sicherheit sowie dessen Umfang. Anschließend gehen die folgenden Abschnitte näher auf die Problemstellung und ihr Verhältnis zu anderen aktuellen Zero-Trust-Ansätzen ein. Darauf aufbauend werden die grundlegenden Überzeugungen – das „Warum“ – erörtert, die bei der Auswahl und Anwendung von Lösungstechnologien maßgeblich sein sollten. Künftige Veröffentlichungen werden sich eingehender mit dem „Wie“ befassen – den Anforderungen an bestimmte Technologien wie Authentifizierung, Zugriffskontrolle und KI-gestützte Analysen im Zusammenhang mit dem Zero-Trust-Reifegradmodell.
ZTS: Es beginnt mit dem Warum
Simon Sineks „Start with Why“-Ansatz ist ein wirksames Instrument zur Vermittlung des ZTS-Frameworks, wie in Abbildung 1 unten dargestellt. Sie können diese Grafik von außen nach innen betrachten: Beginnen Sie mit den Bedrohungsklassen, gegen die ZTS vorgeht, gehen Sie dann näher auf die eingesetzten Sicherheitsmethoden ein und führen Sie schließlich alles auf gemeinsame Prinzipien zurück. Alternativ können Sie die Grafik von innen nach außen betrachten, wobei die Grundüberzeugungen als Leitstern dienen. Aus ihnen ergeben sich die geeigneten Werkzeuge und Techniken, die es Ihnen wiederum ermöglichen, ein breites Spektrum an Bedrohungen zu bewältigen.
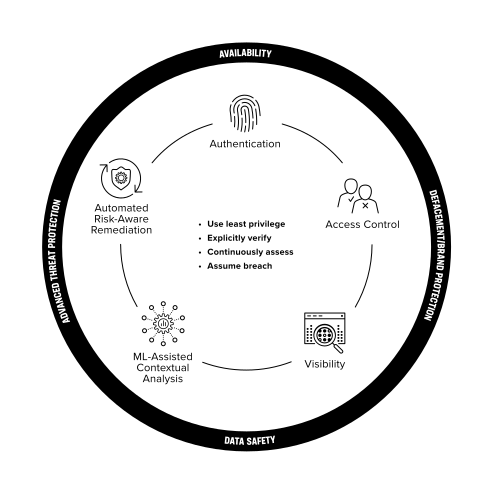
In den folgenden Abschnitten werden die einzelnen konzentrischen Ebenen dieses Diagramms näher erläutert. Kurz zusammengefasst:
- Die Grundüberzeugungen des Ansatzes ergeben sich aus der Formulierung des Anwendungsfalls als:
„Wer versucht, was (welche Handlung) an wem vorzunehmen?“- Um festzustellen, wer und wem, überprüfen Sie ausdrücklich jede Identitätsbestätigung.
- Sobald Sie festgestellt haben, wer es ist, wenden Sie das Prinzip der geringsten Rechte an, um einzuschränken, was ausgeführt werden kann.
- Bewerten und überprüfen Sie kontinuierlich alle drei Faktoren Wer, Was und Wen und gleichen Sie sie weiterhin mit den Richtlinienvorgaben ab.
- Gehen Sie stets davon aus, dass Sicherheitsverletzungen und Kompromittierungen auftreten werden. Seien Sie darauf vorbereitet, einzugreifen, wenn die Aktion (was für wen), basierend auf einer Risiko-Nutzen-Analyse (der Wahrscheinlichkeit eines Betrugs bei der Authentifizierung, gewichtet nach den geschäftlichen Auswirkungen einer irrtümlichen Transaktionsgenehmigung), einen vorab festgelegten akzeptablen Sicherheitsschwellenwert überschreitet.
- Die folgenden Methoden werden verwendet:
- Authentifizierung und Zugriffskontrolle zur Feststellung, wer mit einem gewissen Maß an Sicherheit hinter einer Identität steht, und um anschließend die Berechtigungen dafür einzuschränken, welche (Aktionen) dieser Identität in Bezug auf ein bestimmtes Ziel gestattet werden sollen.
- Transparenz und ML-gestützte Analyse zur Beobachtung und kontinuierlichen Bewertung des vollständigen Kontexts jeder Transaktion – Wer tut was für wen.
- Automatisierte risikobewusste Abhilfemaßnahmen zum Eingreifen in eine Transaktion, wenn das Risiko-Ertrags-Verhältnis den festgelegten Toleranzschwellenwert überschreitet.
- Ein breites Spektrum an Cyberangriffen abwehren durch den Einsatz folgender Methoden:
- Herkömmliche Angriffe wie Defacement oder Datenexfiltration – Sie können diesen Angriffen begegnen, indem Sie die Kompromittierung von Identitäten oder Rechteausweitungen erkennen und mithilfe von Authentifizierung und Zugriffskontrolle durch Richtlinien festlegen, wer was tun darf .
- Verfügbarkeits-/DDoS-Angriffe – Begegnen Sie diesen Angriffen, indem Sie Authentifizierung und Zugriffskontrolle mit risikobewussten Gegenmaßnahmen kombinieren. Beispielsweise können Sie den Zugriff für nicht oder nur unzureichend authentifizierte Akteure blockieren (oder deren Zugriffsrate begrenzen), wenn diese versuchen, ressourcenintensive Transaktionen durchzuführen.
- Fortgeschrittene Bedrohungen, wie etwa Ransomware oder Angriffe auf die Lieferkette -- Diesen Bedrohungen können Sie begegnen, indem Sie Veränderungen und Anomalien bei den Verhaltensmustern erkennen, also wer was mit wem macht, Whom, und diese Erkennung wiederum mit einer risikobewussten Abwehr verknüpfen.
Der Umfang von ZTS
Zero-Trust-Sicherheit erstreckt sich ganzheitlich über den gesamten Anwendungs-, Infrastruktur- und Bereitstellungs-Stack und sollte die komplette Entwicklungspipeline abdecken. Konkret sollte dies Folgendes umfassen:
- Vollständiger Anwendungs- und Infrastruktur-Stack „von oben bis unten“
- Hardware-Rechenplattform, einschließlich Servern, Netzwerkschnittstellenkarten, Koprozessoren und Systemplatinenkomponenten
- Low-Level-Firmware und BIOS für die Hardware.
- Das Betriebssystem der untersten Ebene, z. B. der Hypervisor oder die Laufzeitumgebung.
- Das Betriebssystem auf Anwendungsebene bzw. das Container-Betriebssystem.
- Importierte Anwendungskomponenten von Drittanbietern, entweder kommerziell oder Open Source.
- Jegliche intern entwickelte oder maßgeschneiderte Anwendungssoftware.
- Vollständiger „End-to-End“-Stack für die Anwendungsbereitstellung
- Die Lieferkette für die laufende Wartung und Aktualisierung der einzelnen Elemente des „Top-to-Bottom“-Stacks.
- Alle Inline-Komponenten für die Anwendungsbereitstellung, wie Firewalls, Load Balancer, API-Gateways, Ingress-/Egress-/Mesh-Controller und Inline-Geräte zur Betrugsprävention.
- Alle Komponenten für die Anwendungsbereitstellung, die sich indirekt auf die Verarbeitung des Datenverkehrs auswirken, wie etwa Resolver für das Domain Name System (DNS), oder die indirekt Metadaten empfangen, wie etwa SIEM-Lösungen (Security Information and Event Management) oder föderierte Identitätsdienste.
Traditionell lag der Schwerpunkt von Zero Trust auf den Teams für Anwendungsentwicklung und -bereitstellung, die häufig durch Rollen wie Dev, DevOps, DevSecOps und SRE repräsentiert werden. Wir weisen vor allem darauf hin, um das Gesamtbild zu verdeutlichen: Ein umfassender Zero-Trust-Ansatz sollte idealerweise auch weniger traditionelle Rollen und Infrastrukturen sowie zusätzliche Arbeitsabläufe wie die Beschaffungsstrategie für die Lieferkette einbeziehen.
Problemstellung
Eine der obersten Prioritäten von CIO und CISO besteht darin, die Informationstechnologie zu modernisieren, um das Unternehmenswachstum zu beschleunigen. Darüber hinaus spielen sie eine zentrale Rolle bei der Steuerung von Unternehmensrisiken. Ihr Ziel ist es, das Unternehmen dabei zu unterstützen, Kunden mit neuen digitalen Erlebnissen zu begeistern, die betriebliche Effizienz durch die digitale Vernetzung mit Dritten zu steigern und den Mitarbeitern produktives Arbeiten von überall aus zu ermöglichen – bei gleichzeitiger Minimierung der Geschäftsrisiken. Dazu müssen die Organisationen des CIO und CISO ihren Mitarbeitern die Freiheit geben, modernste Technologien, Architekturen und Best Practices für mehr Agilität einzusetzen. Gleichzeitig müssen sie dieselben Mitarbeiter damit betrauen, angemessene Sicherheitsmaßnahmen zu ergreifen und Kontrollen für das Verhalten von Personen, die Informationen, auf die sie zugreifen, sowie die von ihnen verwendeten Technologien einzurichten, um potenzielle Verluste zu vermeiden.
Unternehmen müssen Risiken verstehen und beherrschen, die mit Veränderungen der Markt- und makroökonomischen Bedingungen, des Verbraucherverhaltens und der Lieferkette sowie mit Sicherheitsbedrohungen zusammenhängen. Eine präzise Risikobewertung und die Fähigkeit, schnell Gegenmaßnahmen zu ergreifen, verschaffen Unternehmen einen Wettbewerbsvorteil. In diesem Dokument konzentrieren wir uns auf das Risiko von Sicherheitsbedrohungen, die unter anderem zum Verlust geistigen Eigentums, zur Unterbrechung von Geschäftsprozessen, zum Verlust personenbezogener Daten und zu Bußgeldern durch Aufsichtsbehörden führen können. Das Sicherheitsrisiko lässt sich durch die Bewertung der folgenden Aspekte der jeweils betrachteten Situation berechnen:
- Wert der beteiligten Assets
Assets, die an Transaktionen beteiligt sind, haben unterschiedliche Bedeutung. Beispielsweise ist eine Datenbank mit personenbezogenen Daten wertvoller als eine Datenbank, in der Einzelhandelsstandorte aufgeführt sind, die Produkte des Unternehmens führen. Sicherheits- und IT-Teams können mithilfe eines deterministischen Verfahrens ein Inventar aller Assets erstellen und diese anhand einer Kennzahl kategorisieren, die den „Wert“ des jeweiligen Assets angibt. - Auswirkungen einer Kompromittierung
Die Art der Kompromittierung bestimmt die damit verbundenen Auswirkungen. Beispielsweise sind die Auswirkungen eines unbemerkten Diebstahls von Informationen aus einem Datenspeicher mit personenbezogenen Daten wesentlich schwerwiegender als eine Beeinträchtigung der Verfügbarkeit des Datenspeichers. Auch wenn dies etwas schwieriger zu erfassen ist, lassen sich verschiedene Arten von Kompromittierungen auflisten und jeweils mit einem Wert für das „Schadensausmaß“ versehen. - Wahrscheinlichkeit einer Kompromittierung
Die Wahrscheinlichkeit, dass eine Transaktion zur Kompromittierung eines Assets führt, ist der am wenigsten deterministische Faktor bei der Bewertung des mit der Transaktion verbundenen Risikos. Menschen sind nicht in der Lage, die erforderliche Menge an Beobachtungen zu bewältigen. Daher setzen Organisationen maschinelles Lernen und künstliche Intelligenz ein, um die Zuverlässigkeit ihrer Berechnung der Kompromittierungswahrscheinlichkeit zu erhöhen.
Die Herausforderung besteht darin, das mit jeder einzelnen Transaktion verbundene Risiko nahezu in Echtzeit zu berechnen und geeignete Maßnahmen zur Risikominderung zu ergreifen, um die Auswirkungen einer möglichen Kompromittierung zu begrenzen.
Das Problem erkennen
Die Anforderungen an eine schnellere Geschäftsentwicklung führen zu neuen Praktiken, die das Cybersicherheitsrisiko erhöhen. Im Folgenden gehen wir näher darauf ein.
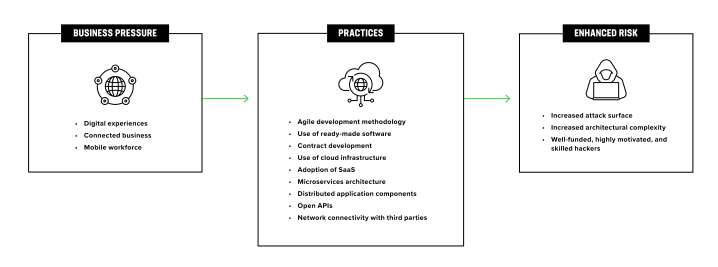
- Anforderungen an die Beschleunigung des Geschäftsbetriebs
- Digitale Erlebnisse
Verbraucher haben ein unstillbares Verlangen nach digitalen Erlebnissen und erwarten regelmäßige Verbesserungen auf verschiedenen Plattformen (PC, Tablet, Mobiltelefon). - Vernetzte Unternehmen
Digitale Geschäftsprozesse erfordern die Vernetzung mit Partnern, Lieferanten und Vertriebspartnern sowie mit Diensten, die von anderen Unternehmen bereitgestellt werden. - Mobile Belegschaft
Mitarbeiter müssen von überall auf Geschäftsanwendungen zugreifen können, um eine effiziente Ausführung zu gewährleisten.
- Digitale Erlebnisse
- Praktiken zur Erfüllung geschäftlicher Anforderungen
- Agile-Entwicklungsmethodik
Unternehmen wechselten vom sequenziellen Wasserfallmodell, bei dem die termingerechte Projektabwicklung im Mittelpunkt steht, zum inkrementellen, iterativen Agile-Entwicklungsansatz mit einem starken Fokus auf Kundenzufriedenheit. - Einsatz vorgefertigter Software
Um so schnell wie möglich neue digitale Erlebnisse bereitzustellen, verwenden Entwickler Code wieder, den ihre Branchenkollegen als Open Source veröffentlicht haben. - Auftragsentwicklung
Durch die Auslagerung von Arbeiten an externe Entwickler können Unternehmen ihre Personalkapazitäten nach Bedarf skalieren. - Nutzung von Cloud-Infrastruktur
Dank der Agilität, Flexibilität und Skalierbarkeit der Cloud sowie ihrer einfachen Nutzung können Entwickler die benötigte Infrastruktur bei Bedarf bereitstellen. - Einführung von SaaS
Software as a Service (SaaS) bietet Vorteile für betriebliche Anwendungen, da sich dadurch der Aufwand für die Beschaffung, Bereitstellung und Wartung solcher Anwendungen in privaten Rechenzentren erheblich reduziert. - Microservices-Architektur
Teams nutzen Microservices, um eine kontinuierliche Bereitstellung und eine schnellere Markteinführung zu erreichen. - Verteilte Anwendungskomponenten
Unternehmen steigern ihre Effizienz, indem sie Microservices auf einer Infrastruktur ausführen, die optimale Tools für die Entwicklung oder Bereitstellung der Servicefunktionalität bietet. Neuere Erweiterungen bestehender Workflows werden mithilfe moderner Anwendungsarchitekturen umgesetzt, die mit den Legacy-Komponenten kommunizieren müssen. Dabei werden beide häufig auf unterschiedlichen Infrastrukturen ausgeführt. - Offene APIs
Ein Ökosystem aus verschiedenen Diensten ist effizienter, als wenn ein Unternehmen alle Dienste selbst entwickelt. - Netzwerkkonnektivität mit Dritten
Unternehmen verbinden sich über verschlüsselte Tunnel mit ihren Partnern, Lieferanten und Vertriebspartnern, um Geschäftsprozesse zu automatisieren und zu optimieren.
- Agile-Entwicklungsmethodik
- Erhöhtes Sicherheitsrisiko
- Vergrößerte Angriffsfläche
Der Einsatz von Drittanbietersoftware und Open-Source-Bibliotheken eröffnet Möglichkeiten für Angriffe auf die Lieferkette. Zudem werden sämtliche Schwachstellen extern entwickelter Software übernommen. Vertragsentwickler sind darauf bedacht, Funktionen termingerecht fertigzustellen; Sicherheit gehört dabei nicht zu ihren Aufgaben. Sobald sie die Software übergeben und das Projekt verlassen haben, ist es für interne Teams außerdem schwierig und zeitaufwendig, den Code zu überprüfen und Sicherheitslücken aufzuspüren. Agile Sprints ermöglichen eine sehr effiziente Bereitstellung von Funktionen, doch das höhere Entwicklungstempo lässt kaum Zeit für detaillierte Sicherheitsprüfungen und Tests. Ein einziger anfälliger Microservice, der mit anderen Microservices kommunizieren kann, erhöht das Sicherheitsrisiko für das gesamte System. Vernetzte Unternehmen steigern zwar die betriebliche Effizienz, doch eine schwerwiegende Folge besteht darin, dass Sicherheitslücken bei einem von ihnen alle anderen beeinträchtigen. Angreifer suchen nach dem schwächsten Glied, um von dort aus in die übrigen Systeme vorzudringen. Eine Schwachstelle oder ein Sicherheitsversäumnis in der SaaS-Plattform oder Cloud-Infrastruktur wird zu einem zusätzlichen Angriffsvektor, während das Modell der geteilten Verantwortung die frühzeitige Erkennung und Behebung erschweren kann. - Erhöhte Architekturkomplexität
Verteilte Anwendungskomponenten, die auf unterschiedlichen Architekturen basieren und in mehreren Infrastrukturen bereitgestellt werden, stellen unterschiedliche Anforderungen an Sicherheit und Compliance. Dies erschwert es Sicherheitsteams, geeignete Mechanismen zum Schutz von Unternehmensanwendungen und -daten zu konzipieren und zu implementieren sowie regulatorische Compliance-Anforderungen zu erfüllen. - Finanzstarke, hoch motivierte und versierte Hacker
Von der Operation Aurora im Jahr 2010 bis zu Solargate im Jahr 2020 erlebten wir ein Jahrzehnt hochentwickelter Cyberangriffe, die erst entdeckt wurden, nachdem sie bereits großen Schaden angerichtet hatten. Betroffen waren Organisationen, die mit modernster Sicherheitstechnologie ausgestattet waren und über hochqualifizierte Sicherheitsteams verfügten. Die Angreifer hielten sich lange Zeit unentdeckt in der IT-Infrastruktur dieser Organisationen auf. Geistiges Eigentum und personenbezogene Daten wurden gestohlen, Geschäftsabläufe gestört und Organisationen durch Ransomware erpresst – obwohl die IT- und Sicherheitsteams weit über die Einhaltung der Vorschriften hinausgingen, die Cyberangriffe verhindern sollen.
- Vergrößerte Angriffsfläche
Richtlinien der US-Regierung
Nach einer Welle anhaltender Cyberangriffe auf verschiedene US-Bundes-, Bundesstaats- und Kommunalbehörden sowie mehrere US-Unternehmen erließ Präsident Joe Biden am eine Durchführungsverordnung zur Verbesserung der Cybersicherheit des Landes 12. Mai 2021. Ein zentraler Bestandteil dieser Verordnung besteht darin, dass Regierungsbehörden die Zero-Trust-Prinzipien anwenden sollen, um sich auf Cyberangriffe vorzubereiten. Im Anschluss an diese Verordnung veröffentlichte die Biden-Regierung am ein Memorandum des Office of Management and Budget (OMB) 26. Januar 2022 für die Leiter der Ministerien und Behörden der Exekutive. Dieses Memorandum des OMB „legt eine Strategie für eine bundesweite Zero-Trust-Architektur (ZTA) fest, die Behörden dazu verpflichtet, bis zum Ende des Haushaltsjahres 2024 bestimmte Cybersicherheitsstandards und -ziele zu erfüllen, um die Abwehrmaßnahmen der Regierung gegen immer ausgefeiltere und anhaltende Bedrohungskampagnen zu stärken.“1 Sowohl die Durchführungsverordnung als auch das OMB-Memorandum beziehen sich auf die Zero-Trust-Architektur, die in der Publikation SP 800-207 des National Institute of Standards and Technology (NIST) beschrieben wird. Diese wurde im August 2020 veröffentlicht und ist von den Regierungsbehörden einzuhalten.
Zero-Trust-Architekturen und Reifegradmodelle
Vordenker in Behörden und der Privatwirtschaft haben Fachbeiträge veröffentlicht, die die Zero-Trust-Architektur erläutern und Empfehlungen für ihre bestmögliche Einführung geben. Im Folgenden fassen wir die darin enthaltenen Ideen zusammen. Der wesentliche Kern der in diesen Beiträgen dargelegten Ideen und Vorschläge besteht darin, jede Transaktion daraufhin zu prüfen, wer versucht, welche Aktion an wemauszuführen, und in Echtzeit anhand des berechneten, damit verbundenen Risikos zu entscheiden, ob die Transaktion zugelassen oder abgelehnt wird.
National Institute for Standards and Technology (NIST): Zero trust architecture
Das NIST-Team führt die Grundsätze von Zero Trust auf und definiert in seinem Dokument NIST SP 800-207 eine abstrakte Zero-Trust-Architektur (ZTA).2 Darüber hinaus erörtert es verschiedene Varianten von Zero-Trust-Ansätzen und beschreibt unterschiedliche Möglichkeiten zur Implementierung der abstrakten Architektur.
Zu den wichtigsten in dem Dokument behandelten Abstraktionen gehören der Policy Decision Point (PDP) und der Policy Enforcement Point (PEP), die zusammenwirken. Der Policy Decision Point besteht aus der Policy Engine (PE) und dem Policy Administrator (PA). Die Policy Engine entscheidet mithilfe eines Vertrauensalgorithmus, ob einem Subjekt der Zugriff auf eine Ressource gewährt werden soll. Diese Entscheidung wird vom Policy Administrator umgesetzt, der mit dem Policy Enforcement Point kommuniziert, um eine neue Sitzung zuzulassen oder abzulehnen sowie eine bestehende Sitzung zu ändern oder zu beenden. Darüber hinaus behandelt das Dokument Varianten des Vertrauensalgorithmus, Netzwerkkomponenten für eine Zero-Trust-Umgebung sowie verschiedene Anwendungsfälle und Bereitstellungsszenarien. Abschließend wird erörtert, wie Angreifer die Zero-Trust-Architektur aushebeln können, damit sich die für die Implementierung Verantwortlichen der Bedrohungen bewusst sind und geeignete Maßnahmen zum Schutz der Komponenten ihrer Zero-Trust-Architektur ergreifen.
Cybersecurity and Infrastructure Security Agency (CISA): Zero-Trust-Reifegradmodell
Mit dem Ziel, Behörden bei der Entwicklung ihrer Zero-Trust-Pläne zu unterstützen, haben führende Experten der Cybersecurity and Infrastructure Security Agency (CISA) ein Zero-Trust-Reifegradmodell veröffentlicht (https://www.cisa.gov/zero-trust-maturity-model).3 Die Arbeit baut auf der abstrakten Zero-Trust-Architektur auf, die im Dokument NIST SP 800-207 beschrieben wird. Die Autoren haben fünf Bereiche identifiziert und empfehlen Organisationen, die Zero-Trust-Prinzipien in jedem dieser Bereiche konsequent umzusetzen. Die Bereiche sind (i) Identität, (ii) Geräte, (iii) Netzwerk, (iv) Anwendungs-Workloads und (v) Daten. Sie empfehlen, in allen fünf Bereichen Transparenz und Analysen sowie Automatisierung und Orchestrierung einzusetzen.
Das Dokument bietet ein übergeordnetes Reifegradmodell für alle fünf zuvor identifizierten Grundpfeiler von Zero Trust und geht anschließend detaillierter auf jeden einzelnen Bereich ein. Organisationen können das Reifegradmodell nutzen, um ihren aktuellen Stand zu ermitteln und sich schrittweise dem optimalen Zustand anzunähern.
US-Verteidigungsministerium (DOD): Referenzarchitektur für Zero Trust
Nach der Aufdeckung der SolarWinds-Angriffe veröffentlichte die National Security Agency (NSA) in ihrem Dokument „Embracing a Zero Trust Security Model“ Leitlinien, in denen sie Cybersicherheitsteams zur Einführung eines Zero-Trust-Sicherheitsmodells riet.4 Fachleute des gemeinsamen Zero-Trust-Entwicklungsteams der Defense Information Systems Agency (DISA) und der National Security Agency erarbeiteten die Zero-Trust-Referenzarchitektur des Department of Defense (DOD).5 Die Autoren begründen die Notwendigkeit der Einführung von Zero Trust wie folgt: „Die durch Datenschutzverletzungen innerhalb und außerhalb des DOD offengelegten Schwachstellen zeigen, dass ein neues und robusteres Cybersicherheitsmodell erforderlich ist, das fundierte, risikobasierte Entscheidungen ermöglicht.“6
Diese Referenzarchitektur stützt ihre Empfehlungen auf die im NIST-Dokument SP 800-207 zur Zero-Trust-Architektur definierten Abstraktionen. Das Dokument stellt ein übergeordnetes Betriebsmodell vor und beschreibt dessen Elemente ausführlich. Es enthält außerdem ein übergeordnetes Reifegradmodell sowie eine Zuordnung der Fähigkeiten, die zur Anwendung von Zero-Trust-Prinzipien auf verschiedene relevante Bereiche erforderlich sind. Zusammen helfen diese Dokumente Organisationen dabei, ihren aktuellen Stand zu bewerten und einen Plan zu entwickeln.
Risikomanagement und Governance nach Zero-Trust-Prinzipien
Eine Haltung, die grundsätzlich von einer möglichen Sicherheitsverletzung ausgeht („Assume Breach“), und die Anwendung von Zero-Trust-Prinzipien können Unternehmen bei ihrem Risiko- und Governance-Management unterstützen. Die Zero-Trust-Prinzipien der „kontinuierlichen Überwachung“ und der „expliziten Verifizierung“ der an Transaktionen beteiligten Akteure ermöglichen es Unternehmen, für alle Akteure und deren Aktivitäten eine dynamische Risikobewertung zu erstellen. Dies entspricht der Empfehlung von Gartner, bestehende Sicherheitsprogramme mithilfe der Methodik „Continuous Adaptive Risk and Trust Assessment“ (CARTA) zu verbessern. Die Anwendung des Prinzips, ausschließlich den geringstmöglichen Zugriff auf Ressourcen zu gewähren, verringert selbst im Falle einer Sicherheitsverletzung das Verlustrisiko. Die durch kontinuierliche Überwachung und explizite Verifizierung gewonnenen Informationen sind zudem für die Erstellung von Compliance-Berichten hilfreich.
Denkweise im Detail
Dieser Abschnitt konzentriert sich auf die Denkweise – das Glaubenssystem, das „Warum“ –, die der Strategie und den Entscheidungen hinsichtlich der Tools und des Designs zugrunde liegt, die ein Unternehmen für Zero-Trust-Sicherheit einsetzen sollte. Tatsächlich lässt sich die Motivation für alle Methoden und Komponententechnologien, die in heutigen Zero-Trust-Lösungen zum Einsatz kommen, auf vier einfache Grundprinzipien reduzieren. Dieser Abschnitt beginnt mit einer Aufzählung dieser Prinzipien. Anschließend wird erläutert, wie sie im breiteren Kontext des Anwendungsentwicklungszyklus angewendet werden können – also wie diese Prinzipien sowohl von Anfang an in der Entwurfsphase als auch im laufenden Betrieb bei der Bereitstellung und Ausführung der Anwendung berücksichtigt werden können.
Betriebsprinzipien für Zero Trust
Wenn Zero-Trust-Lösungen im Kern als Aufbau von Vertrauen in Systeminteraktionen verstanden werden – „Wer tut Was für Wen?“ –, dann lässt sich der Aufbau eines für die jeweilige Interaktion angemessenen Vertrauensniveaus in vier Komponenten unterteilen.
Explizit verifizieren
Wie der Name schon sagt, lautet der Grundsatz des Zero-Trust-Ansatzes: „Vertraue nicht blind, sondern überprüfe immer.“ Daher muss jeder Akteur im System – das „Wer “ und das „Wem“ bei Systeminteraktionen – in der Lage sein:
- Seine Identität nachweisen, einschließlich des Sonderfalls einer „anonymen“ Identität, sofern das System Interaktionen zulässt, die von anonymen Identitäten ausgehen oder für diese bestimmt sind – etwa anonyme Browser in einem Flugreservierungssystem. Bei allen anderen Identitäten muss der Akteur angeben können, wer er ist, und zwar in einem vom System akzeptierten Namensraum.
- Zusätzliche „Nachweise“ für die vom Akteur angegebene Identität entgegennehmen und validieren (bei jeder angegebenen, nicht anonymen Identität). Die Art des „Nachweises“ – Passwörter, Zertifikate, Verhaltensweisen usw. – kann ebenso variieren wie dessen Aussagekraft. Das System muss jedoch in der Lage sein, ein gewisses Maß an Vertrauen in die Identitätsangabe zu ermitteln. Einfache Systeme können das Vertrauen in den Nachweis binär mit Ja oder Nein bewerten, während fortschrittlichere Systeme einen numerischen Vertrauenswert verwenden können, auf den im Rahmen einer auf Risiko und Nutzen basierenden Richtlinie ausdrücklich Bezug genommen werden kann. Dabei ist zu beachten, dass das System das Vertrauen auch auf andere Weise erhöhen oder verringern kann, etwa anhand der Reaktion auf eine aktive Überprüfung oder sogar durch passive Beobachtung des Verhaltens des Akteurs.
- Bewerten und justieren Sie das Vertrauen in die bestätigte Identität anhand einer zusätzlichen Kontextualisierung des aktuellen Verhaltens im Verhältnis zu früheren Verhaltensweisen. Beispielsweise kann das System historische Metadaten über den Akteur vorhalten, etwa dessen früheren und aktuellen geografischen Standort, Hardwareplattformen, IP-Adressen, Reputation usw., um das Vertrauen in den „Nachweis“ der Identität zu erhöhen oder zu verringern.
Darüber hinaus lässt sich der Grundsatz der expliziten Verifizierung nicht nur auf die Identität, sondern auch auf die Aktion anwenden – also auf das Was der Transaktion. Ein häufiger Anwendungsfall liegt vor, wenn die Aktion als API-Aufruf ausgedrückt wird, beispielsweise als Aufruf einer API zur Durchführung einer Datenbankabfrage. In diesem Beispiel kann der Grundsatz der expliziten Verifizierung nicht nur dazu dienen, Vertrauen in die Identität des Akteurs zu schaffen, der die API aufruft, sondern auch die korrekte Verwendung der API-Aktion zu überprüfen, etwa indem sichergestellt wird, dass die an die API übergebenen Parameter den entsprechenden Vorgaben entsprechen.
Bei einem ausgereiften Zero-Trust-Ansatz ist ein „Nachweis“ fast nie absolut. Identitätsnachweise können gestohlen und Geräte kompromittiert werden; Einschränkungen für API-Parameter sind häufig unvollständig. Daher sollte der Begriff „Vertrauen“ im Zero-Trust-Kontext eher als Hinweis darauf verstanden werden, wie wahrscheinlich es ist, dass die bestätigte Identität oder die Transaktionsparameter legitim sind. Das „Vertrauensniveau“ sollte somit als ein wichtiger Faktor – jedoch nicht als der einzige – bei der Entscheidung betrachtet werden, ob eine Transaktion zugelassen, blockiert oder einer weiteren Prüfung unterzogen wird.
Prinzip der geringsten Rechte
Sobald ein akzeptables Maß an „Vertrauen“ in die an einer Transaktion beteiligten Akteure hergestellt wurde, verlangt der Zero-Trust-Ansatz, dass dem Akteur (in der Regel dem Anfragenden, also dem „Wer“) nur die minimal erforderlichen Berechtigungen gewährt werden, damit er die Aufgaben ausführen kann, für die er in diesem System vorgesehen ist. Dieses Prinzip entspricht dem sogenannten „positiven Sicherheitsmodell“ – einem Ansatz, bei dem standardmäßig alle Aktionen untersagt sind und bestimmte Berechtigungen nur dann gewährt werden, wenn sie für den Systembetrieb erforderlich sind. Beispielsweise kann ein Reservierungssystem anonymen Benutzern erlauben, Flugpläne einzusehen; gemäß den Designanforderungen der Anwendung ist es einem anonymen Benutzer jedoch möglicherweise nicht gestattet, einen Flug zu buchen.
Diese Berechtigungen können für einzelne Akteure oder für Akteursklassen gelten. In der Regel sind die Nutzer einer Anwendung entweder Menschen oder Stellvertreter für Menschen und werden in Klassen wie „anonyme Benutzer“, „Kunden“, „Partner“ oder „Mitarbeiter“ eingeteilt. Weniger vertrauenswürdige Akteursklassen müssen für eine erfolgreiche Authentifizierung üblicherweise einen niedrigeren Vertrauensschwellenwert erreichen, haben dafür jedoch auch Zugriff auf weniger oder weniger sensible APIs. Anwendungs- oder infrastruktureigene Akteure, etwa bestimmte Dienste oder Container innerhalb einer Anwendung, verfügen häufig über individuellere Berechtigungen, beispielsweise: „Nur die Container <X> und <Y> dürfen auf die Datenbank zugreifen, nur <X> darf in den Objektspeicher schreiben, aber <Y> und <Z> dürfen daraus lesen.“
Ein wichtiger Aspekt bei der Umsetzung des Prinzips der geringsten Rechte besteht darin, es vorausschauend und gezielter anzuwenden.7 Anstatt allen Akteuren oder einer Gruppe von Akteuren pauschal dieselben Berechtigungen zuzuweisen, sollte eine ausgereifte Zero-Trust-Implementierung insbesondere genauer berücksichtigen, welche Aktion ausgeführt werden soll. Beispielsweise kann auf einer sehr groben Ebene die Berechtigung „Dateisystemzugriff“ gewährt werden. „Dateisystem-Lesezugriff“ beschreibt die tatsächlich erforderliche Berechtigung jedoch präziser und ermöglicht so eine hochwertige Umsetzung des positiven Sicherheitsmodells.
Schließlich können ausgereiftere Ausprägungen des Prinzips der geringsten Rechte mit fortgeschrittenen Implementierungen des Prinzips „Explizit überprüfen“ kombiniert werden, indem die autorisierten Berechtigungen eines Akteurs nicht als absolut betrachtet werden, sondern als abhängig von der durch die Authentifizierung ermittelten Vertrauenswürdigkeit. Berechtigungen werden daher nur gewährt, wenn die Vertrauenswürdigkeit der bestätigten Identität (Wer) einen Mindestschwellenwert erreicht, wobei die Schwellenwerte auf die jeweils versuchte Aktion abgestimmt sind. Beispielsweise kann für eine besonders folgenreiche Aktion (z. B. das Herunterfahren des Systems) eine Vertrauenswürdigkeit von mindestens 90 % erforderlich sein, dass es sich bei dem Akteur um einen Administrator handelt. Beträgt die Vertrauenswürdigkeit des Systems hinsichtlich der Identität beim Versuch, das System herunterzufahren, in diesem Beispiel nur 80 %, würde das System eine zusätzliche Überprüfung verlangen, um den Vertrauenswert der bestätigten Identität zu erhöhen, bevor es die Aktion zulässt.
Kontinuierlich bewerten
Explizite Verifizierung und das Prinzip der geringsten Rechte sind zentrale Konzepte. Der Grundsatz der kontinuierlichen Bewertung trägt jedoch der Tatsache Rechnung, dass diese Prinzipien fortlaufend überprüft werden müssen, und zwar in folgendem Sinne:
- Alle Transaktionen müssen einer Überprüfung und Berechtigungsprüfung unterzogen werden. Mit anderen Worten: Es darf nicht nur eine Teilmenge der Transaktionen überprüft werden – etwa „die erste Transaktion in einer Benutzersitzung“ oder „Transaktionen, die über eine Docker-Container-Workload initiiert werden“. Auch wenn dies selbstverständlich klingen mag, werden bei vielen Zero-Trust-Implementierungen nicht alle Transaktionen validiert, sei es aufgrund eines mangelhaften Designs oder fehlender Transparenz. Häufige Defizite in diesem Bereich entstehen dadurch, dass Zero Trust nur auf externe, nicht aber auf interne Akteure angewendet wird und/oder davon ausgegangen wird, dass eine Zero-Trust-Entscheidung über einen längeren Zeitraum gültig bleibt.
- Die Schlüsselfaktoren bei der Bewertung – das Vertrauen in die Identität des Akteurs und die diesem Akteur gewährten Rechte – müssen als dynamisch und veränderlich betrachtet werden. Beispielsweise kann das Vertrauen in eine Identität im Laufe der Zeit aufgrund beobachteter Verhaltensweisen und zusätzlicher Metadaten steigen oder sinken. Daher müssen sich auch alle vertrauensbasierten Richtlinien dynamisch an das veränderte Vertrauensniveau anpassen. Darüber hinaus kann eine zuvor durch eine Richtlinie gewährte Berechtigungsstufe später widerrufen werden oder sich das für eine bestimmte Aktion erforderliche Mindestvertrauen ändern. Auch wenn die Zeiträume für Richtlinienänderungen variieren – sie können langsam (im Zeitrahmen menschlicher Betriebsprozesse) oder schnell (durch automatisierte Governance-Agenten) erfolgen –, sollte das System in der Lage sein, dynamisch auf diese Änderungen zu reagieren und sie umzusetzen.
Von einer Kompromittierung ausgehen
Das letzte Prinzip beruht auf der Annahme hoch motivierter Angreifer vor dem Hintergrund einer gesunden Paranoia. Konkret lautet die Prämisse: „Gehen Sie davon aus, dass Ihre Systeme bereits kompromittiert wurden.“ Dabei wird eine „Kompromittierung“ als „eine Transaktion, die bei vollständiger Kenntnis und fehlerfreier Ausführung hätte abgelehnt werden müssen, stattdessen aber zugelassen wurde“ definiert. Die Ursache für dieses Durchschlüpfen kann in unvollständigen Informationen liegen (z. B. in einer fälschlicherweise hohen Vertrauensbewertung bei der Authentifizierung aufgrund unentdeckter gefälschter Anmeldedaten), auf Einschränkungen bei der Implementierung zurückzuführen sein (z. B. wenn gewährte Berechtigungen nicht hinreichend granular festgelegt werden können, etwa wenn „Netzwerkverbindung öffnen“ als Berechtigung gilt, ohne dass nach dem geografischen Standort des Netzwerkziels unterschieden werden kann) oder durch eine unvollständige Umsetzung von Zero Trust verursacht werden (z. B. wenn Zero Trust nicht auf anfällige, intern verwendete Open-Source-Komponenten angewendet wird).
Daher muss sich die Zero-Trust-Denkweise auch damit befassen, wie sich die Auswirkungen solcher Sicherheitsverletzungen bestmöglich bewältigen bzw. minimieren lassen.
Die Umsetzung dieses Prinzips ist vielfältiger als die der anderen Prinzipien, äußert sich jedoch im Allgemeinen wie folgt:
- Identifizieren Sie zunächst alle Transaktionen, die zwar technisch gemäß den Richtlinien zulässig, aber dennoch verdächtig sind. Was als „verdächtig“ gilt, hängt häufig stark vom jeweiligen Kontext ab. Übliche Auslegungen sind jedoch: (a) anomale Transaktionen, die sich deutlich von bisher beobachteten Verhaltensweisen unterscheiden, (b) Gruppen von Transaktionen, die einzeln betrachtet normal, in ihrer Gesamtheit jedoch ungewöhnlich sind – beispielsweise kann das Lesen und Schreiben einer Datei üblich sein, während das Lesen und Schreiben von 1.000 Dateien pro Sekunde ungewöhnlich sein kann – oder (c) Aktionen, die mit einer unerwünschten und zuvor nicht beobachteten Auswirkung auf das System korrelieren. Ein Beispiel hierfür wäre ein Muster, bei dem eine bestimmte Transaktion eine Netzwerkverbindung zu einem TOR-Knoten herstellt oder zu einem erheblichen Anstieg der CPU-Auslastung des Systems führt.
- Führen Sie anschließend eine eingehendere Analyse durch – entweder vollständig automatisiert oder mithilfe eines hybriden, von Menschen gesteuerten und durch maschinelles Lernen unterstützten Workflows –, um festzustellen, ob diese Transaktionen unzulässig sind. Werden sie als unzulässig eingestuft, ergreifen Sie Gegenmaßnahmen. Dies kann entweder in Form einer allgemeinen Richtlinienaktualisierung oder als zusätzliche Schutzebene in Form eines „Sicherheitsnetzes“ für die anderen richtlinienbasierten Gegenmaßnahmen erfolgen.
Wenn der gewählte Ansatz richtlinienbasierte Anpassungen vorsieht, können diese mithilfe der verfügbaren statischen Richtlinienwerkzeuge umgesetzt werden. Beispiele für richtlinienbasierte Anpassungen wären die Einschränkung der Zugriffsrechte auf Transaktionsebene (d. h., es wird nicht mehr zugelassen, wer was mit wem tun darf) oder stattdessen die Anwendung eines strengeren „Beweismaßstabs“ (d. h. die Anforderung einer MFA oder eines höheren Konfidenzwerts), damit ein Akteur (oder eine Gruppe von Akteuren) eine bestimmte Aktion ausführen darf.
Wird stattdessen der Ansatz gewählt, eine zusätzliche „Auffangschicht“ einzusetzen, kann diese Strategie ebenfalls entweder fein- oder grobgranular umgesetzt werden. Die feingranularste Strategie bestünde darin, genau und ausschließlich diejenigen Transaktionen zu blockieren, die ein bestimmtes Risiko-Nutzen-Verhältnis überschreiten. Diese Lösung birgt jedoch auch die Gefahr, dass bei einigen zulässigen Transaktionen inakzeptable Latenzen entstehen, wenn die Implementierung zusätzliche Analysen erfordert. Stattdessen könnten gröber granulare Strategien eingesetzt werden, etwa indem künftige Transaktionen dieses Akteurs in einer Sandbox ausgeführt werden oder der Akteur sogar vollständig vom System ausgeschlossen wird. In Extremfällen können noch gröbere Maßnahmen zur Risikominderung – etwa das Deaktivieren der Datei-Ein-/Ausgabe – angemessen sein.
Natürlich sind bei ansonsten gleichen Bedingungen feingranulare Backstop-Schutzmaßnahmen im Allgemeinen vorzuziehen. Aufgrund der Einschränkungen der verfügbaren Lösungstechnologien müssen jedoch häufig Kompromisse eingegangen werden, und ein grobgranularer Backstop ist in der Regel besser als gar keiner. Wenn beispielsweise als grobgranulare Reaktion auf einen mutmaßlichen Ransomware-Angriff die Datei-E/A deaktiviert wird, sind die Nebenwirkungen dieser Maßnahme möglicherweise immer noch der Alternative vorzuziehen – nämlich dem Akteur zu erlauben, weiterhin ungehindert im System zu agieren –, sofern die Untätigkeit zu einem durch Ransomware verschlüsselten Dateisystem führen würde.
Zero Trust: Es beginnt bereits vor dem operativen Betrieb
Der beste Ausgangspunkt für eine sichere Anwendungsentwicklung nach dem Zero-Trust-Prinzip liegt wenig überraschend ganz am Anfang. Die grundlegenden Prinzipien, die eine praktische Umsetzung von Zero Trust ermöglichen, sollten bereits in der Entwurfsphase der Anwendungsentwicklung fest verankert werden. Daher muss jede Diskussion über eine in die CI/CD-Pipeline integrierte operative Zero-Trust-Lösung mit einem Verständnis dieser grundlegenden Elemente beginnen, die bei der Konzeption höchste Priorität haben sollten.
Der Kern dieser grundlegenden Elemente sollte das gewünschte/beabsichtigte Verhalten der Interaktionen zwischen Systemkomponenten erfassen und mit ausreichender Transparenz und Kontrolle verknüpfen, um Abweichungen zu erkennen und darauf zu reagieren. Anhand der beabsichtigten Interaktionen wird die gewünschte Menge von Aktionen (Was) für jeden Akteur (Wer) gegenüber jedem Ziel (Wem) definiert. Allerdings kann es Szenarien und Umgebungen geben, in denen die beabsichtigten Interaktionsmuster unbekannt sind. In solchen Fällen kann eine Organisation durch umfassendere Einblicke die geeigneten Interaktionen „ermitteln“,8 um sie anschließend in Richtlinien festzuschreiben.
Beispielsweise sind bei heutigen ZTNA-Lösungen, die sich auf die identitätsbasierte Zugriffskontrolle für die externen APIs einer Anwendung konzentrieren, Einblick in die Authentifizierungs-APIs und entsprechende Kontrollmöglichkeiten erforderlich. Im Kontext einer Cloud Workload Protection Platform (CWPP) wiederum erfordert die Erkennung einer kompromittierten Container-Workload Einblick in die von jedem Container ausgeführten Aktionen – und zwar in Echtzeit, wenn eine sofortige Behebung erforderlich ist.
Im Folgenden finden Sie eine Liste übergeordneter Kategorien grundlegender Aspekte, die im Designprozess berücksichtigt werden sollten. Zu jedem der wichtigsten Punkte werden zudem konkrete Fragen aufgeführt, mit denen Sie sich näher befassen sollten:
- Welche Blackbox-Schnittstellen – Ein- und Ausgaben – hat das System?
- Welche Benutzergruppen – Administratoren, authentifizierte Benutzer, nicht authentifizierte Benutzer und Partner – interagieren mit der Anwendung, und welche Aufgaben müssen sie ausführen?
- Erfolgt die gesamte Kommunikation über eine definierte API, oder gibt es auch „direkte“ Netzwerkkommunikation bzw. Kommunikation über einen Datenspeicher wie eine Datenbank oder einen Objektspeicher?
- Wie genau ist bei der Kommunikation über eine API festgelegt, welche Benutzer mit ihr interagieren können und welchen Einschränkungen diese Interaktionen unterliegen (z. B. Parameterbeschränkungen, Ratenbegrenzungen usw.)?
- Werden bei jeglicher Netzwerkkommunikation alle übertragenen Daten verschlüsselt?
- Falls es „Rohdaten“-Schnittstellen gibt (z. B. wenn Informationen zwischen dem Client und der Anwendung über einen Objektspeicher oder eine Datenbank ausgetauscht werden), gibt es Audit-Protokolle, anhand derer nachvollzogen werden kann, wer wann auf welche Informationen zugegriffen hat?
- Welche Komponentendienste bilden analog dazu auf der internen „White-Box“-Ebene die Gesamtanwendungen – einschließlich aller extern bereitgestellten Dienste – und wie kommunizieren sie miteinander?
- Wie kommunizieren diese Dienste miteinander – welche API wird verwendet und welche Einschränkungen (Rollen, Zugriffskontrollen, Ratenbegrenzungen, Parameter usw.) gelten für diese Interaktionen?
- Ähnliche Fragen wie die oben genannten stellen sich hinsichtlich des Formalisierungsgrads der API, ihrer Einschränkungen und der Verschlüsselung der Kommunikation.
- „Interne“ Kommunikation (z. B. zwischen Workloads/Containern) nutzt mit größerer Wahrscheinlichkeit gemeinsam verwendeten Speicher und dateisystembasierte Schnittstellen; alle derartigen Schnittstellen sollten identifiziert werden.
- Wie kommunizieren diese Dienste miteinander – welche API wird verwendet und welche Einschränkungen (Rollen, Zugriffskontrollen, Ratenbegrenzungen, Parameter usw.) gelten für diese Interaktionen?
- Welche Kontrollmechanismen stellt das System bereit, um den Zugriff auf die Blackbox-Schnittstellen und internen Kommunikationspfade einzuschränken?
- Gibt es eine Richtlinie, die festlegt, wer – also welche Rollen – bestimmte APIs aufrufen darf und was bei einem Verstoß gegen diese Richtlinie geschieht? Welche Möglichkeiten gibt es außerdem, jeglichen Missbrauch der APIs zu erkennen und einzudämmen, etwa ungültige Parameter oder eine zu hohe Aufrufrate? Können diese Richtlinien auf Grundlage kontextbezogener Eingaben aus anderen Systemen dynamisch aktualisiert werden?
- Gibt es analog dazu Richtlinien, die andere Formen der Kommunikation zwischen Workloads – Dateisysteme, Objektspeicher, Datenbanktabellen – dahingehend einschränken, wer auf welche Dateien, Speicher oder Tabellen zugreifen darf, und die den Missbrauch dieser Ressourcen verhindern (z. B. „SELECT * from <table>“)?
- Welche Einblicke (Dashboards, Protokolle, Statistiken) stellt das System bereit, um den Zugriff sowohl auf die Blackbox-Schnittstellen als auch auf interne Kommunikationspfade einzuschränken?
- Kann das System erkennen, wer zu welchem Zeitpunkt welche API aufruft? Werden diese Daten gespeichert und wenn ja, wie lange? Wie schnell (in Echtzeit, stündlich usw.) werden diese Daten bereitgestellt? Wie gut lassen sich die Daten weiterverarbeiten – handelt es sich um eine unstrukturierte Protokolldatei, strukturierte Daten im Format JavaScript Object Notation (JSON), die an einen Dienst für das Management von Sicherheitsereignissen und -vorfällen (SEIM) gesendet werden können, oder um Daten, die in einer Big-Data-Datenbanktabelle gespeichert werden?
- Wie lauten die Antworten auf dieselben Fragen bei anderen Kommunikationswegen – Arbeitsspeicher, Dateien, Objekte, Datenbanken? Wer tut was? Wie werden diese Daten bereitgestellt?
- Welche weiteren Kontroll- und Transparenzmechanismen bietet das System über die Kommunikationspfade hinaus, um eine Überbelegung oder übermäßige Nutzung von Ressourcen zu verhindern?
- Bietet das System Einblick in Kennzahlen zum Ressourcenverbrauch – CPU, Arbeitsspeicher, Bandbreite, Pod-Skalierung usw.? Falls ja, wie detailliert sind diese Daten und wie gut lassen sie sich nutzen?
- Verfügt das System über Kontrollmechanismen oder Schutzvorkehrungen für den Ressourcenverbrauch – etwa Grenzwerte für Arbeitsspeicher, CPU und Datei-E/A pro Workload, die Überwachung von Systemaufrufen zur Prozesserstellung, Beschränkungen für das Hoch- und Aufskalieren von Pods sowie Ratenbegrenzungen für APIs, die andere Dienste aufrufen?
Wenn Sie diese Fragen ausdrücklich stellen, können Sie Lücken in der Grundlage erkennen, die für die Umsetzung von Zero Trust erforderlich ist. Oft führt bereits das frühzeitige Stellen dieser Fragen während des Entwurfs dazu, dass die Lücke mit minimalem zusätzlichem Entwurfsaufwand geschlossen wird. Sollte eine Lücke bestehen bleiben, hilft schon das Bewusstsein dafür, zusätzliche Sicherheitsmaßnahmen gezielt auszurichten oder anfällige Angriffsflächen zu identifizieren.
Eine solche frühzeitige Analyse der sicheren Entwicklung ist ein entscheidender Bestandteil der Zero-Trust-Denkweise. Dennoch konzentriert sich Zero Trust heute weitgehend darauf, was nach dem ursprünglichen Entwurf geschieht, und die meisten Unternehmen legen ihren Schwerpunkt überwiegend auf die Aspekte von Zero Trust, die erst nach der Entwurfsphase zum Tragen kommen. Werden jedoch bereits in der Entwurfsphase die Anforderungen an eine wirksame Umsetzung von Zero Trust sorgfältig berücksichtigt, lässt sich der erheblich größere zusätzliche Aufwand vermeiden, der andernfalls nötig wäre, um nach der Bereitstellung der Anwendung „die Lücken zu schließen“.
Überlegungen zur Risikominderung: Rechtzeitigkeit, falsch-positive bzw. falsch-negative Ergebnisse und Risiko
Wie die Prämisse „von einer Sicherheitsverletzung ausgehen“ dieses Denkansatzes verdeutlicht, müssen Sicherheitsverantwortliche davon ausgehen, dass es einem hinreichend motivierten Angreifer gelingen wird, eine bösartige Transaktion auszuführen – also einen Fall von „Wer tut was wem gegenüber?“, der zwar den Richtlinien entsprach, in einer perfekten Welt jedoch nicht hätte zugelassen werden dürfen. In solchen Fällen verlagert sich der Schwerpunkt auf einen wirksamen Auffangmechanismus, der solche Fälle erkennen kann. Dies geschieht in der Regel anhand beobachteter Transaktionsmuster und systemseitiger Auswirkungen, wie im vorherigen Abschnitt „Von einer Sicherheitsverletzung ausgehen“ beschrieben.
Doch ebenso wie beim Konzept der Identität lässt sich auch nie mit absoluter Sicherheit feststellen, ob eine bestimmte Transaktion bösartig ist oder nicht. Daher sollte eine ideale Zero-Trust-Lösung – wie bei der Identität – einen „Konfidenzwert“ für die Legitimität der Transaktion ausgeben. Wenn beispielsweise beobachtet wird, dass ein Daemon zehn Sekunden lang Dateien mit der zehnfachen normalen Rate liest und schreibt, könnte dies zu einem Konfidenzwert für die Bösartigkeit von 70 % führen. Steigt die Rate hingegen eine Minute lang auf das Hundertfache, könnte sich der Konfidenzwert auf 95 % erhöhen. In diesem Beispiel besteht bei der Abhilfemaßnahme, künftige Schreibvorgänge auf Dateien zu unterbinden, weiterhin eine gewisse Wahrscheinlichkeit (30 % bzw. 5 %), dass diese Reaktion falsch ist – ein „Fehlalarm“. Bei der Entscheidung, ob Abhilfemaßnahmen ergriffen werden sollen, müssen daher das Risiko von Fehlalarmen und die potenziellen Auswirkungen einer Duldung des möglicherweise bösartigen Verhaltens gegeneinander abgewogen werden.
Das Beispiel soll verdeutlichen, dass jede Entscheidung für eine für den Benutzer sichtbare Abhilfemaßnahme letztlich eine geschäftliche Entscheidung ist, bei der alle Risiken, Kosten und Vorteile im Zusammenhang mit der verdächtigen Aktivität berücksichtigt werden. Zusätzliche Hürden bei der Transaktion erhöhen die Wahrscheinlichkeit, dass der erwartete Nutzen ausbleibt. Wird jedoch nicht eingegriffen bzw. werden keine zusätzlichen Hürden geschaffen, besteht das Risiko einer Kompromittierung. Die Entscheidung, in solchen Fällen Maßnahmen zu ergreifen (oder nicht), hängt daher von drei Faktoren ab:
- Welches Risiko besteht, wenn möglicherweise bösartige Transaktionen weiterhin zugelassen werden?
Dieses Risiko kann unmittelbar finanzieller Natur sein, etwa bei der Überweisung von Bankguthaben, oder indirekte Kosten verursachen – entweder betriebliche (z. B. wenn wichtige Datensätze verschlüsselt und nur gegen Lösegeld wieder freigegeben werden) oder Kosten für das Markenimage (z. B. durch die Verunstaltung einer Website). Darüber hinaus können rechtliche oder Compliance-Kosten entstehen, etwa durch die Offenlegung personenbezogener Kundendaten. Im Wesentlichen ist die Risikobewertung eine Frage der Governance, und eine gute Governance erkennt und quantifiziert die Risiken für die Anwendung. - Welche Nebenwirkungen hat die Durchführung der Abhilfemaßnahme?
Die Nebenwirkungen lassen sich anhand der Dimensionen (a) verursachte Hürden und (b) Auswirkungsbereich beschreiben. Die Hürden geben an, wie viel schwieriger es für eine legitime Transaktion ist, fortzufahren. Dies kann von geringfügig umständlicher (z. B. durch eine zusätzliche Authentifizierungsstufe) bis hin zu unmöglich reichen (wenn die Transaktion schlichtweg nicht zugelassen wird). Der Auswirkungsbereich gibt an, ob und gegebenenfalls wie viele andere, unabhängige Transaktionen ebenfalls betroffen sind. So wirkt sich beispielsweise die Sperrung eines bestimmten Benutzers nur auf diesen Benutzer aus, während die Abschaltung eines Protokollierungsdienstes die Nachvollziehbarkeit für alle Benutzer und Transaktionen beeinträchtigt. - Wie sicher ist die Einschätzung, dass die Transaktion böswillig ist?
Um diese Sicherheit zu erhöhen, müssen in der Regel mehr Datenpunkte erfasst und Informationen aus mehreren Datenquellen miteinander abgeglichen werden. Beides braucht Zeit, sodass sich diese Abwägung in der Praxis häufig auf die Frage reduzieren lässt: „Wie lange sollte ich die Transaktion beobachten, bevor ich mich zum Handeln entscheide?“
Eine Zero-Trust-Strategie muss also zwar der Tatsache Rechnung tragen, dass es zu Sicherheitsverletzungen kommen wird, doch ein durchdachter Ansatz wird bei der Behandlung zulässiger, aber verdächtig erscheinender Transaktionen Risiken und Nutzen gegeneinander abwägen. Dabei werden das Risikoniveau verschiedener Anwendungstransaktionen und die Folgen der jeweiligen Abhilfemaßnahmen berücksichtigt. Diese Maßnahmen werden nur dann ergriffen, wenn das Risikoniveau den erwarteten geschäftlichen Nutzen übersteigt.
1 https://www.whitehouse.gov/wp-content/uploads/2022/01/M-22-09.pdf
2 https://csrc.nist.gov/publications/detail/sp/800-207/final
3 https://www.cisa.gov/zero-trust-maturity-model
4 https://media.defense.gov/2021/Feb/25/2002588479/-1/-1/0/CSI_EMBRACING_ZT_SECURITY_MODEL_UOO115131-21.PDF
5 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
6 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
7 Diese vorausschauende Planung beginnt bereits in der Entwurfsphase, wie später beschrieben.
8 Oder zumindest die Menge der als „angemessen erachteten“ Interaktionen, die das System offenbar benötigt. Es besteht immer das Risiko, dass die aus Beobachtungen abgeleitete Menge von Interaktionen unvollständig ist oder bereits bestehende Risiken birgt. Daher ist eine vorausschauende Planung beim Entwurf stets vorzuziehen.
VERÖFFENTLICHT AM 04. MAI 2022