スケーラブルAIとは、需要と複雑性が増大しても、AIシステム、モデル、データパイプライン、インフラストラクチャ、運用がパフォーマンス、信頼性、コスト効率を維持できる能力を指します。これは、ラボ環境で機能するAIの試験導入と、実環境のエンタープライズワークロードを大規模に処理できるAI機能との違いです。
スケーラブルAIとは
スケーラブルAIでは、パフォーマンスの低下やコストの増大を招くことなく、より多くのデータやユーザー、より大規模なモデル、分散した拠点に対応できるよう拡張可能なシステムを構築します。真のスケーラビリティを実現するには、データパイプライン、モデル、GPUクラスター、ネットワーク、推論、運用を含むAIスタック全体を連携させて拡張する必要があります。
開発環境で動作するモデルでも、本番環境の規模では行き詰まることがよくあります: データパイプラインの準備が整っていない、推論エンドポイントが同時実行の負荷に対応できない、あるいはコンピューティングではなくネットワークがボトルネックになるためです。
スケーラビリティには、主に次のような側面があります。
- データのスケーリング: 単発のデータセットから、リアルタイムかつ高スループットのパイプラインへの移行
- モデルのスケーリング:単一のモデルから、複数のリージョンにデプロイされる多数のモデルやバリエーションへと拡張
- インフラストラクチャのスケーリング: GPU/CPU、ストレージ、ネットワークを成長に合わせて拡張
- 運用のスケーリング: リリースプロセス、オブザーバビリティ、トラフィックエンジニアリング、コスト管理の成熟化
スケーラブルなAIを効果的に実装すれば、ワークロードの増大に伴っても、信頼性の高い一貫したパフォーマンスを実現できます。これにより、AIは試験的な実証段階から、堅牢で全社的に活用できる機能へと進化します。F5が特に注力するトラフィック管理、セキュリティ、可視性の強固な基盤を確立することで、システムの不安定化や見えにくい運用上の負債の蓄積を招くことなく、確信を持って迅速にAIを拡張できます。
スケーラブルAIが重要な理由
スケーラビリティがなければ、AIの取り組みはすぐに限界に達します。組織は概念実証(POC)を作成できますが、1日あたり数千件、数百万件ものリクエストに対応できるよう拡張することは、また別の課題です。
スケーラブルなAIへの対応が重要な理由:
- ビジネス需要が当初のアーキテクチャの処理能力を上回ると、AIの統合によってトラフィックの増加が予測不能な形で加速します。多くのAI導入は、単一のモデル、ワークフロー、チームから始まります。価値が実証されると導入が各部門に広がり、新しいアプリケーションが共有エンドポイントに接続することで、トラフィックが急増します。当初は1時間あたり数千件のリクエストを処理するよう設計されたシステムが、今では1日あたり数百万件を処理しています。スケーラブルなネットワークがなければ、この急速な増加によってインフラストラクチャに過大な負荷がかかる可能性があります。
- AIシステムは大規模環境で目立たない形で障害を起こすことがあり、レイテンシーの急増、GPUの低使用率、モデルの過負荷、データパイプラインの停滞などによって信頼性が損なわれる可能性があります。AIの障害が大規模な停止を引き起こすことはまれで、通常はパフォーマンスの低下として現れます。GPUがアイドル状態になる、負荷が高いときに推論キューが滞留する、ピーク時にレイテンシーが急増するといった事象がよく発生します。トラフィックの誤ったルーティングパターンや処理の遅いデータシャードによって、パイプライン全体が中断する可能性もあります。こうしたシステム全体に関わる問題は通常、実際の負荷がかかったときに顕在化するため、適切なオブザーバビリティとトラフィック管理インテリジェンスがなければ診断が困難です。
- 非効率な推論パス、管理されていない同時実行、適切に制御されていないトラフィックにより、運用コストは急増し、クラウド費用が2倍から3倍に膨らむ可能性があります。トラフィック管理の不備、バッチ処理されていないリクエスト、負荷の偏り、コールド状態のGPUパス、ルーティングの不整合によって推論コストが増加し、不要なスケーリングや過剰なリソース確保につながります。クラウドGPUは高額なため、適切に管理しなければ、アイドル状態のGPUや余分なレプリカにも費用を支払うことになります。多くの企業では、モデルの複雑さではなく、ネットワークの問題が推論コストや費用を押し上げていることが明らかになっています。
- コンプライアンスとガバナンスには、エンタープライズ向けツールが必要です。本番環境のAIには、パイロット段階では不要だったガードレールが求められます。初期のAIパイロットでは、APIセキュリティ、モデルのリネージ追跡、データガバナンスなどの正式な統制が整備されていないことが少なくありません。しかし、AIが顧客データ、規制対象のワークフロー、機密性の高いコンテンツを扱う場合、組織はポリシーの適用、監査証跡、アクセス制御、暗号化、バージョン管理などの保護策を確実に講じる必要があります。これらは、金融、医療、政府機関、グローバル企業でAIを導入するうえで不可欠です。
- 規模の拡大に伴い、競争優位性も高まります。推論の高速化、モデルの反復回数の増加、ユーザー体験の向上が、持続的な差別化につながります。スケーラビリティはシステムを保護し、イノベーションを促進します。モデルの再トレーニング、アップデートのデプロイ、低レイテンシーの推論提供を迅速に行えるチームは、競争上の優位性を獲得できます。ユーザーへの応答性が向上し、機能のリリースが迅速化され、モデルもより頻繁に改良されます。この運用スピードが、競合他社には容易に打ち破れない参入障壁を築きます。
スケーラブルなAIにより、ユーザー数の増加への対応、より複雑なモデルの実装、さまざまな地域やクラウドプラットフォームへのAIの展開など、企業は安心してユースケースを拡大できます。
スケーラブルAIの仕組み
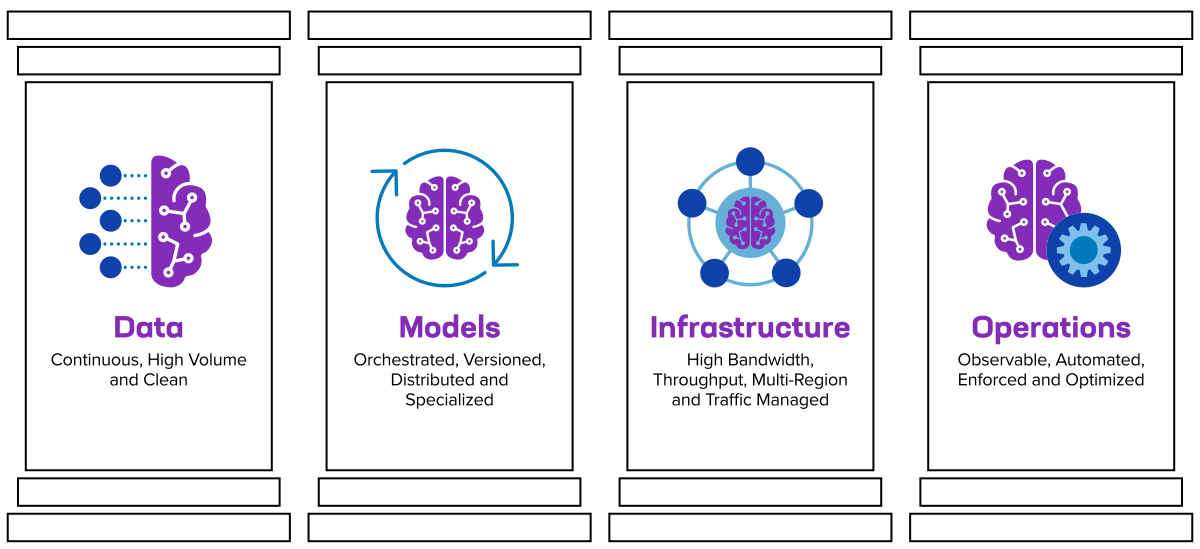
スケーラブルなAIは、データ、モデル、インフラストラクチャ、運用という4つの成長の柱を連携させることで機能します。この4つすべてを整合させる必要があり、1つでも遅れれば、システム全体が制約を受けます。
1. データのスケーリング
多くの場合、データが最初のボトルネックになります。AIシステムでは、データ量が増加してもGPUに過剰な負荷をかけたり、ワークフローを中断したりすることなく、トレーニングと推論を支える、継続的かつクリーンで大容量のデータパイプラインが必要です。
- 継続的なデータ取り込み:モデルが最新かつ正確な入力データを使用できるようにするには、AIパイプラインが複数のソースからリアルタイムデータを確実かつ安全に取得する必要があります。
- 高スループットのデータパイプライン:GPUの稼働率を最大限に維持し、低速または不安定な入力ストリームによるアイドル時間を回避するには、システムがデータを迅速に供給する必要があります。
- 特徴量ストアとベクトルデータベース:これらのシステムは、特徴量や埋め込みを大規模に標準化、保存、提供し、再現性と低レイテンシーの推論を確保します。
- データ品質と一貫性の管理:クリーンで検証済みの、データリネージを把握できるデータは、モデルドリフトを低減し、パイプライン障害を防止するとともに、モデル出力の信頼性を高めます。
- スケーラブルなストレージシステム:基盤となるストレージは、データセットの拡大に合わせて拡張できる必要があります。これにより、データ量が増加しても、並列アクセス、高速な取得、予測可能なパフォーマンスを実現できます。
2. スケーリングモデル
企業では、単一のモデルから、蒸留版、タスク固有のバリアント、ファインチューニング済みモデルなど、数百ものモデルへと急速に移行しています。モデルのスケーラビリティは、単にモデルのパラメーター数を増やすだけではありません。以下の要素も含まれます。
- マルチモデルオーケストレーション:複数のモデルを連携させることで、エンドポイントに過剰な負荷をかけることなく、適切なモデルを適切なタイミングで実行できます。
- バージョン管理、ロールアウト、ロールバック:制御されたロールアウトと即時ロールバックによってモデルのバージョンを管理することで、サービス停止を防ぎ、安全かつ継続的な改善が可能になります。
- 分散推論: ノード間またはリージョン間で推論を実行することで、レイテンシーを低減して負荷を分散し、単一のGPUやクラスターでのボトルネックを防ぎます。
- 地域またはユースケース別のモデル特化:市場やタスクごとに調整したバリアントを導入し、各モデルを最適なコンテキストに適合させることで、パフォーマンスと効率が向上します。
3. インフラストラクチャのスケーリング
AIワークロードには、高性能なコンピューティング、ストレージ、ネットワークが必要です。利用の拡大に伴い、組織はGPU容量を拡張するとともに、以下に対応する必要があります。
- 広帯域ネットワーク:ネットワークには、輻輳したリンクによってGPUへのデータ供給が滞らないよう、低レイテンシかつ高スループットの経路を提供することが求められます。
- 高スループットストレージ:ストレージシステムは、トレーニングおよび推論時のI/Oボトルネックを防ぐため、大規模なデータセットへの継続的かつ並列的なアクセスを提供する必要があります。
- マルチリージョン展開:インフラストラクチャを複数のリージョンに分散し、コンピューティングリソースとモデルをユーザーやデータソースの近くに配置することで、レジリエンスを向上させ、レイテンシを低減します
- ラインレートでのトラフィックステアリングと負荷分散:インテリジェントな高速トラフィックルーティングにより、推論リクエストを均等に分散し、GPUクラスターの稼働率を最大限に維持しながら、ホットスポットを防止します。
インフラストラクチャは、GPU容量のコストが高く、非効率なトラフィックルーティングは無駄につながるため、効率性を維持する必要があります。
4. 運用のスケーリング
どれほど堅牢なハードウェアでも、運用体制が脆弱であれば補うことはできません。エンタープライズAIには、以下が求められます。
- レイテンシ、スループット、推論1回あたりのコストに関するオブザーバビリティ: ボトルネックの検出、パフォーマンスの調整、サイレント障害の防止には、モデルとインフラストラクチャの動作をリアルタイムで把握する必要があります。
- モデル劣化に対するインシデント対応:精度の低下やレイテンシの急増が発生した場合、組織は根本原因を迅速に診断し、ユーザーに影響を与えることなく安定したサービスを復旧する必要があります。
- デプロイ用の自動化パイプライン:信頼性の高い自動化により、手動操作に伴うリスクを回避しながら、モデルの更新を開発環境から本番環境へ安全に移行できます。
- ポリシーの適用とガバナンス:複雑なAI環境でモデルエンドポイントを保護し、アクセスルールを適用して、コンプライアンスを確保するには、強力な制御が必要です
- コストの可視化と最適化:GPU使用量、推論、ルーティング効率を監視することで、チームはコストを管理し、不要なスケーリングの発生を回避できます。
F5は、スケーラブルなAIの中核的な要素にどのように対応するのか
F5は、企業がトラフィックエンジニアリング、セキュリティ、可視性の面で直面する主要な課題という観点から、AIのスケーラビリティを捉えています。豊富なGPUと高度なモデルアーキテクチャを備えた組織であっても、AIワークロードの拡大に伴い、これらのレイヤーがボトルネックになることが少なくありません。
F5は、次の方法で企業におけるAIの拡張を支援します。
- インテリジェントなトラフィックルーティングによるGPU使用率の最大化:AI推論のスループットは、リクエストの分散状況によって変動します。F5 BIG-IP Local Traffic Manager (LTM)は、負荷分散、モデルを考慮したルーティング、レイテンシーを最適化したトラフィックパスを提供します。これにより、低速または不均一なリクエストフローによる待機を回避し、GPUクラスターの稼働率と効率を高く維持します。
- ネットワークのボトルネックを解消:高い同時実行性を伴う推論では、コンピューティングリソースが上限に達するよりもはるかに早く、従来のネットワークスタックが処理能力を超える可能性があります。F5 BIG-IP PlatformとF5 Distributed Cloud App Connectは、極めて高い帯域幅が求められる状況に対応して輻輳を軽減し、すべてのエンドポイントへの推論トラフィックの円滑な流れを確保します。
- 推論エンドポイントとモデルAPIの保護:AIサービスはAPIに依存しており、単なるパケットフィルタリングではなく、アプリケーションL7の本格的な保護が必要です。F5 BIG-IP Advanced WAF、F5 Distributed Cloud Web App and API Protection (WAAP)、F5 BIG-IP SSL Orchestratorは、暗号化トラフィックを含む詳細な検査、ポリシー適用、ボットや不正利用の防止、ランタイム保護を提供し、機密性の高いモデルと推論ルートを保護します。
- ハイブリッドAI環境全体の可視性を確保:AIトラフィックはさまざまな環境で発生し、そのパターンは不明瞭で一貫性に欠けることが少なくありません。F5 Distributed Cloud App Stackは、BIG-IPのテレメトリストリーミング機能と連携し、レイテンシ、スループット、モデルエンドポイントのパフォーマンス、キュー深度、APIの健全性に関するリアルタイムデータをチームに提供します。これにより、運用担当者はパフォーマンスを最適化し、ユーザーに影響が及ぶ前に問題を解決できます。
- 最新のS3互換・高スループットデータパイプラインをサポート:データ集約型のAIトレーニングおよび取り込みパイプラインにおいて、BIG-IPはS3互換オブジェクトストレージへの大容量トラフィックを高速化します。NetApp StorageGRIDなどのパートナーとの連携により、F5は、モデルのトレーニングおよび検索ワークロードに応じてデータパイプラインを円滑に拡張できるようにします。
BIG-IPおよびDistributed Cloud Servicesを通じて提供されるF5のトラフィック、セキュリティ、可視化の各レイヤーは、需要が拡大する中でもAIワークロードの信頼性、効率性、高いパフォーマンスを維持できるように設計されています。
開発初期からスケーラビリティが重要な理由
今日のAIシステムは、それを支えるインフラストラクチャを上回る速さで進化しています。組織がAIを製品、ワークフロー、顧客体験に統合するにつれて、モデルは大規模化し、ユースケースの範囲が広がり、同時実行数も増加します。一方で、コストに対する要求は厳しさを増し、ガバナンス要件によって運用規律に求められる水準も高まっています。
スケーラビリティは単なる最適化の問題ではなく、組織全体でAIを確実かつ再現可能な形で活用するための基本要件です。堅牢で拡張性の高い基盤がなければ、新しいAIアプリケーションを導入するたびに個別対応が必要となり、パフォーマンスのばらつきやコストの増大を招くおそれがあります。
スケーラブルなAIインフラストラクチャをAI運用の基盤として早期に導入した企業が得られるメリット:
- イテレーションサイクルの短縮
- 運用コストの削減
- より安定したパフォーマンス
- 信頼性とセキュリティの向上
- 全社的な導入を持続可能にする道筋
スケーラブルなAIを実現するアーキテクチャとインフラストラクチャ
AIのスケーラビリティは、ワークロードの需要に対応できるインフラストラクチャにかかっています。企業では通常、クラウド、オンプレミス、ハイブリッド、エッジという4つのアーキテクチャオプションを検討します。
- クラウドベースAIのスケーラビリティ:クラウドは実験の迅速化と処理能力の拡張に役立つ一方、大規模環境ではコストやレイテンシーの問題に直面します。制約として、トラフィックエンジニアリング、GPUの可用性、パフォーマンスの予測可能性が挙げられます。
- オンプレミスAIのスケーラビリティ:オンプレミスの選択肢は、予測可能なコスト、厳格なデータガバナンス、安定したパフォーマンスを実現しますが、特に高密度GPUクラスターでは、電力、冷却、ネットワークについて慎重な計画が必要です。
- ハイブリッドAIアーキテクチャ:多くの企業がこの形態を採用しており、トレーニングはクラウド、推論はエッジ、ファインチューニングは専用GPUクラスターで行うのが一般的です。スケーラビリティを確保するには、異なる環境間で信頼性の高いネットワーキング、ルーティング、セキュリティが必要です。
- エッジAIのスケーラビリティ:エッジ推論はコストとレイテンシを低減しますが、モデル蒸留、レプリケーション手法、エッジデバイスとクラウド間の効果的なトラフィック管理が必要です。
スケーラブルなAIを実現する主要テクノロジー:
- コンテナとオーケストレーション
- ベクトルデータベースと特徴量ストア
- 分散学習フレームワーク
- ML向けCI/CD(MLOpsパイプライン)
- モデルレジストリとバージョン管理
- トラフィック管理とL7ルーティング
- S3互換オブジェクトストレージパイプライン
高密度GPUクラスターでは大量の東西トラフィックが発生し、推論タスクにはレジリエンス、低レイテンシ、インテリジェントなルーティングが求められるため、スケーラブルなAIにはネットワークが不可欠です。この点で、F5の機能は重要な役割を果たします。
AIモデルをスケーリングするためのベストプラクティス
AIモデルのスケーリングでは、モデルのチューニングだけでなく、サービス設計が根本的に重要です。信頼性とコスト効率に優れた推論を提供するには、アーキテクチャと運用プロセスを連携させる必要があります。
- ステートレスで水平スケーリング可能なサービスを設計する:モデルのランタイムを状態から分離し、トラフィックに応じてエンドポイントが自動的にスケーリングできるようにします。
- バッチ処理とキャッシュを活用し、データを管理しやすい単位に分割する(シャーディング):これらの手法により、GPUへの負荷を軽減し、同時実行数の急増を平準化できます。多くの組織では、これらのパターンを一貫して適用することで、大幅なコスト削減を実現しています。
- モデルのバージョンを厳格に管理する: ロールアウト、A/Bテスト、ロールバックは、迅速かつセキュアに実施できる必要があります。不適切なバージョン管理は、依然として推論インシデントの主な原因の1つです。
- 主要なメトリクスを監視する: レイテンシ、スループット、推論あたりのコスト、GPU使用率、タイムアウト率、キューの深さをすべてリアルタイムで可視化し、監視する必要があります。
- データの未成熟に早期に対処する:サイロ化されたパイプライン、不正確なラベル、データリネージの欠如といったデータ品質の問題は、規模の拡大に伴って継続的な障害となります。単にデータインフラやGPUを拡張するよりも、データ活用の準備に投資する方が、多くの場合、大きな効果を得られます。
- モデルを考慮したルーティングを統合する:AIトラフィックのパターンは一定ではありません。モデルの種類、サイズ、キューの深さ、ユーザーの地域に基づいてルーティングすることで、パフォーマンスと効率が大幅に向上します。
スケーラブルなAIの実装における課題
AIのスケーリングには、テクノロジー、組織、コストの各面で課題が伴います。
- 技術的なボトルネックには、分断されたインフラストラクチャ、性能不足または構成不備のネットワーク、GPUをサポートできないストレージシステム、負荷の問題が発生しているレイテンシに敏感な推論エンドポイントなどがあります。
- 組織上のギャップには、AIチームとインフラストラクチャチームの分断、MLOpsの成熟度不足、本番環境のAIに対するオーナーシップと説明責任の欠如が含まれます。
- コストとキャパシティの制約には、GPU不足、予測困難な推論トラフィック、クラウドコストの急増、GPU使用率を低下させる非効率なルーティングなどがあります。
- セキュリティとガバナンスは極めて重要です。機密性の高いモデル資産は分離する必要があり、脅威を見えにくくする暗号化トラフィックは検査する必要があります。また、APIアクセスを一貫して管理し、モデルドリフトや不正使用を検出するためのリアルタイムの可視性を確保することが不可欠です。
F5は、ネットワークのボトルネックを解消し、トラフィックとAPIを保護するとともに、可視性を提供します。これにより、チームはその場しのぎのソリューションに頼ることなく、確信を持ってAIを拡張できます。
スケーラブルなAI | よくあるご質問
スケーラブルAIとは、具体的にどのようなものですか?
需要、データ、モデルの複雑さが増大しても、信頼性の高いパフォーマンスを維持できるAI。
スケーラビリティとGPUの追加はどのように異なりますか?
真のスケーラビリティを実現するには、個別のハードウェア強化だけでなく、データパイプライン、ネットワーク、運用、モデルアーキテクチャを連携させて拡張する必要があります。
AIのスケーラビリティに影響を与える要因とは?
データの準備状況、モデルアーキテクチャ、ネットワーク容量、GPU使用率、同時実行管理、ガバナンスは、いずれも重点的に取り組むべき重要な要素です。
組織はクラウドとオンプレミスをどのように捉えるべきか
クラウドは実験を加速させる一方、オンプレミスは予測可能性とガバナンスを高めます。そのため、多くの企業は一般的にハイブリッドアプローチを採用しています。
AIのパイロット導入が本番環境への拡張前に停滞する原因とは?
一般的な原因としては、データの成熟度不足、ネットワークの制約、GPUの活用不足、非効率なルーティング、脆弱な運用プロセス、責任の所在の不明確さなどが挙げられます。
ネットワークはスケーラブルな推論にどのような影響を与えるか
レイテンシ、スループット、GPU使用率は、ルーティング、同時実行の管理、トラフィックエンジニアリングの影響を受けます。
チームは何から始めるべきでしょうか?
可視性の確保に注力します。ネットワーク、データ、GPUの飽和など、現在の制約を特定し、これらのボトルネックに基づいてロードマップを策定します。
F5がどのように支援するか
スケーラブルなAIは、効果的なエンタープライズAIの基盤となります。その実現には、統合されたデータパイプライン、堅牢なモデルアーキテクチャ、高性能なインフラストラクチャ、信頼性の高いネットワーク、強固なガバナンス、規律ある運用が必要です。今から投資することで、パフォーマンスやセキュリティを損なうことなく、AIアプリケーションを確信を持ってコスト効率よく拡張できます。
F5 Application Delivery and Security Platformが組織のAIイニシアチブの拡張をどのように支援するかについて、詳しくはf5.com/solutions/ai-delivery-and-securityをご覧ください。