Fala-se de IA generativa (GenAI) por toda parte. A questão é: o que está ganhando força? Como ela está tornando o mundo um lugar melhor? Onde está o valor para os negócios? Essas perguntas são igualmente relevantes quando consideramos os desafios enfrentados pelas organizações que estão avaliando se e quando devem implementar a GenAI em suas operações (AIOps). Com base em meus experimentos com IA generativa ao longo do último ano e no amplo contato com as tendências do setor durante minhas pesquisas diárias na F5, apresento cinco conclusões para ajudar a orientar as organizações que buscam compreender o impacto da GenAI nas práticas de dados operacionais. Assim, essas organizações estarão mais bem preparadas para alinhar os cronogramas de adoção da tecnologia GenAI aos seus orçamentos, práticas e culturas atuais.
1. Os modelos de GenAI adoram dados semiestruturados e não estruturados
Os dados operacionais são uma mistura de dados semiestruturados (objetos) e conjuntos de dados não estruturados. Os modelos de linguagem de grande escala (LLMs) são bastante flexíveis e eficazes para lidar com essa variedade de formatos de dados. Isso torna os LLMs uma tecnologia ideal para a análise de conjuntos de dados operacionais. As organizações podem realizar internamente diversos experimentos e avaliações para verificar a eficácia, a facilidade de uso e o custo de várias soluções habilitadas por GenAI. O uso da inferência de LLMs para detectar padrões de dados relevantes com menos falsos positivos alinha a velocidade e a escala das máquinas aos objetivos das equipes que consomem fluxos de dados operacionais.
2. As organizações não precisam criar modelos
As organizações que se concentram em entender quais técnicas são usadas por cada modelo para as tarefas específicas em questão não precisam criar seus próprios modelos. Por exemplo, o reconhecimento de entidades nomeadas (NER) é uma área do processamento de linguagem natural (NLP) que vem se mostrando uma técnica eficaz para identificar elementos-chave em dados semiestruturados. Um exemplo de NER poderia ser uma lista que inclua uma categoria, como os dias da semana, ou uma descrição, como números inteiros maiores que 1 e menores que 5. O resultado é uma maior precisão durante a inferência em comparação com técnicas de correspondência de padrões baseadas em regras que não utilizam IA generativa. À medida que a pesquisa e a aplicação de técnicas como NER continuam avançando, as equipes de operações podem concentrar seus esforços no aproveitamento das técnicas que já se mostraram bem-sucedidas, em vez de criar modelos.
Exemplo de NER:
Entidade nomeada: Dias da semana
Lista: domingo, segunda-feira, terça-feira, quarta-feira, quinta-feira, sexta-feira, sábado
Figura 1. O reconhecimento de entidades nomeadas proporciona maior precisão durante a inferência do que a correspondência de padrões baseada em regras.
3. A gravidade dos dados é real
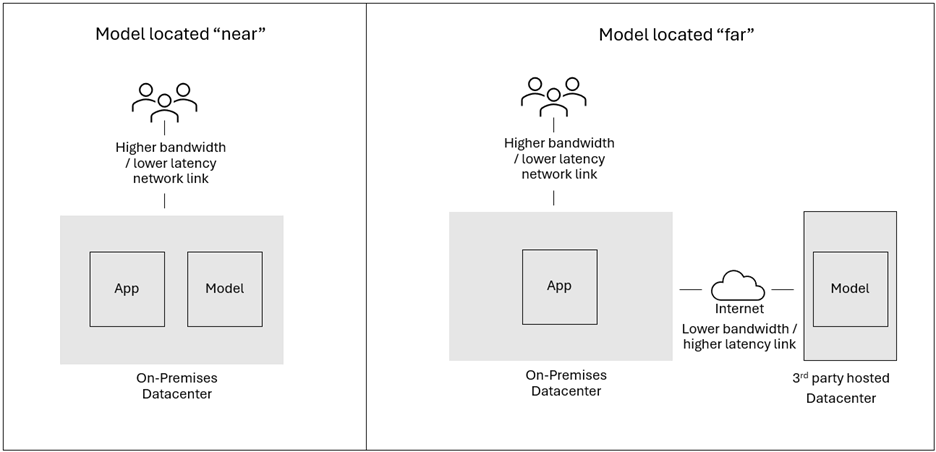
A gravidade dos dados é uma força subjacente que influencia as decisões sobre posicionar os recursos computacionais mais perto de onde os dados são criados ou mover os dados para mais perto de onde esses recursos já estão implantados. Quanto maior o volume de dados, mais forte é a força gravitacional, o que resulta no aumento da capacidade computacional posicionada mais perto deles. Para o treinamento (criação e ajuste de modelos), os dados são agregados e movidos para mais perto dos recursos computacionais. Para a inferência (uso de modelos), o modelo é movido para mais perto de onde o prompt é enviado.
Se um modelo for acessado trazendo uma cópia para o ambiente interno — em vez de chamar a API de uma instância hospedada por terceiros —, faz sentido aproximá-lo do prompt e/ou de qualquer conjunto adicional de dados privados vetorizado como parte do prompt. Por outro lado, se o modelo estiver hospedado por terceiros que disponibilizam sua API pela internet, nem o modelo nem as operações de inferência serão movidos. Nesses casos, a inferência e os vetores de dados privados podem ser transferidos para um local “próximo à rede” por meio de uma interconexão de colocation em data center ou, se possível, buscando alinhar os locais de hospedagem aos do provedor do modelo.
Compreender as forças que aproximam dados e recursos computacionais, bem como aquelas que os afastam, ajuda a tomar decisões bem fundamentadas na busca pelo equilíbrio ideal entre custo e desempenho.
4. Não ignore os silos de dados; lide com eles
Com o processamento por IA generativa, é mais importante do que nunca eliminar os silos de dados para simplificar e agilizar a análise de dados operacionais. No entanto, em um futuro próximo, tudo indica que os silos de dados continuarão existindo, se não aumentarem.
A questão está mais relacionada a como lidar com silos de dados e quais escolhas tecnológicas fazer. Para acessar dados armazenados em vários locais, as opções são copiar e transferir os dados ou implementar uma camada lógica de dados que use consultas federadas sem movimentá-los. Independentemente da opção escolhida, identificar as fontes de dados em streaming existentes e avaliar os casos de uso operacionais quanto às restrições de tempo e atualização dos dados ajudará você a selecionar os elementos necessários para sua pilha de tecnologias de dados, como mecanismos de streaming, mecanismos de consulta, formatos de dados e catálogos. A liberdade de escolha tecnológica permite que as equipes de dados selecionem as tecnologias mais eficazes e fáceis de usar, equilibrando desempenho e custo. O ideal é que as práticas de dados de uma organização amadureçam ao longo do tempo, sempre preservando a flexibilidade para escolher o que funciona melhor em cada estágio de maturidade.
5. A automação é sua amiga — não tenha medo dela
Quando as soluções incorporam automação, elas ganham escala ao transformar o conhecimento tácito de especialistas em privacidade de dados e SecOps em uma prática repetível, viabilizada por AIOps e executável por máquinas. Só então as equipes de dados, segurança e privacidade ficam livres para agregar inteligência. A inteligência aumenta a eficácia das políticas ao definir com mais precisão como dados específicos podem ser usados, por quem, por quanto tempo e para qual finalidade — ao mesmo tempo que monitora onde os dados estão armazenados, quais cópias estão sendo feitas e com quem estão sendo compartilhados. Isso libera tempo para o planejamento estratégico, a avaliação de novas tecnologias e a comunicação com as áreas de negócios, a fim de aprimorar as políticas de acesso a dados e aprovar exceções.
Velocidade, escala e automação são características de uma prática madura de AIOps, resultando em melhores resultados, decisões mais rápidas e capital humano otimizado. A GenAI está abrindo portas que a tecnologia não conseguia abrir… até agora. Os cinco aprendizados acima oferecem alguns pontos de referência para as equipes de operações de TI, segurança e privacidade considerarem ao incorporar a GenAI às suas práticas de AIOps. Modelos de IA, proximidade do processamento aos dados operacionais, dados e automação são componentes essenciais da nova plataforma de AIOps. Nesse rico ambiente de aprendizagem, as organizações podem desenvolver a cultura e as práticas de operações de tecnologia para a geração atual e as futuras.
Para uma análise mais aprofundada do impacto da IA generativa sobre os dados, leia o mais recente relatório Índice de Maturidade das Empresas Digitais da F5.
Sobre o autor
Publicações relacionadas no blog

O estado da maturidade digital empresarial: a transformação digital ainda não terminou
Explore como a IA impacta as empresas, as aplicações da IA generativa, as estratégias para modernizar as operações de TI e os benefícios da maturidade digital com a F5.
Como a IA generativa acelera a transformação digital
Veja como a IA generativa impulsiona a transformação digital nas empresas, acelerando tendências como a integração de APIs, os desafios dos modelos operacionais de TI híbrida e a adoção de AIOps.
Seis capacidades técnicas para acelerar a transformação digital
As arquiteturas empresariais atuais carecem dos fatores necessários de agilidade, escalabilidade, segurança e observabilidade, essenciais para impulsionar a mudança tecnológica. No entanto, estas seis capacidades fundamentais ajudarão as empresas a gerenciar riscos e desafios ao longo de sua transformação digital.
Inverter a API é a transformação digital de que as empresas precisam para participar e competir em uma economia de APIs
As organizações detêm um valor latente — na forma de APIs internas — que precisam explorar para competir em uma economia de APIs. Embora os desafios técnicos e de segurança possam desestimular algumas delas, as empresas precisam reconhecer que inverter suas APIs permitirá liberar o valor da organização como plataforma.
A modernização da TI começa pela infraestrutura
O hardware e o software evoluíram rapidamente desde os primórdios da internet, mas, para aproveitar ao máximo os benefícios resultantes dessa evolução, as organizações precisam avaliar e modernizar sua infraestrutura e a entrega de aplicativos. Acelere os esforços de modernização com a nova F5 rSeries.