Este post do blog é o segundo de uma série sobre entrega de dados para IA.
À medida que o uso de IA se acelera, os pipelines de dados precisam escalar ainda mais rápido para evitar gargalos e manter o desempenho. Pesquisas recentes de empresas como a McKinsey & Company mostram que a demanda por capacidade de data centers preparados para IA deve crescer aproximadamente 33% ao ano até 2030. Isso significa que até mesmo as melhores arquiteturas de modelos ficarão sem dados suficientes se o pipeline de entrega não escalar na mesma proporção.
Mas, à medida que as cargas de trabalho de IA crescem, as organizações estão descobrindo rapidamente uma verdade surpreendente: a lentidão raramente tem origem no próprio processo de treinamento ou ajuste fino dos modelos; ela vem do pipeline de dados nas etapas anteriores, que precisa abastecer continuamente a fábrica de modelos com grandes volumes de dados de alta qualidade.
“Novas inovações permitem que o F5 BIG-IP ofereça o gerenciamento inteligente de tráfego, a otimização do caminho de dados e os controles de segurança necessários para manter os dados de IA fluindo em alto volume e alta velocidade nos fluxos de trabalho de treinamento, geração de embeddings e ajuste fino.”
Os sistemas modernos de IA dependem da movimentação rápida e previsível de dados entre repositórios de objetos, camadas de recuperação, pipelines de atributos e fluxos de trabalho de geração de embeddings — além de endpoints de inferência, quando aplicável. Quando esse “fluxo” fica mais lento, o desempenho despenca, as GPUs ficam ociosas e a empresa leva mais tempo do que o esperado para começar a obter valor.
Uma analogia útil é a do oleoduto, que mencionamos no primeiro post desta série no blog. Você pode ter a refinaria mais avançada do mundo — ou seja, o grande modelo de linguagem (LLM), o mecanismo de busca vetorial ou o cluster de uma fábrica de modelos multimodais usado para treinamento, ajuste fino ou geração de embeddings. Mas, se os dutos que abastecem essa refinaria forem estreitos, tiverem vazamentos ou estiverem congestionados, a produção para. O problema não está no processo de refino, mas no sistema de transporte. Os pipelines de IA atuais seguem o mesmo princípio: o fluxo de dados determina o desempenho do sistema.
Onde realmente surgem os gargalos da IA
Os pipelines de IA raramente falham em um único ponto; eles ficam mais lentos ao longo de uma cadeia de microinterações. Um único fluxo de trabalho pode envolver a obtenção de conjuntos de dados de treinamento, repositórios de conhecimento corporativo ou embeddings a partir do armazenamento de objetos, a transformação desses dados para ingestão, a consulta a um banco de dados vetorial, o acesso a vários microsserviços e, só então, as etapas de ajuste fino ou criação de modelos.
Cada etapa pode introduzir entraves. Isoladamente, os atrasos parecem insignificantes, mas, somados, aumentam o tempo de processamento de ponta a ponta e deixam as GPUs sem os dados de que precisam, especialmente em tarefas de treinamento ou ampliação de dados em grande escala.
É como um oleoduto que sofre com pressão reduzida, válvulas desalinhadas e picos inesperados de pressão. O fluxo se torna irregular, e as instalações nas etapas seguintes nunca recebem um abastecimento constante e previsível. Os sistemas de fábricas de modelos de IA enfrentam o mesmo fenômeno quando os nós de armazenamento ficam lentos, os caminhos de rede se degradam ou as cargas de trabalho apresentam picos imprevisíveis.
As pesquisas disponíveis deixam isso muito claro: os problemas de desempenho da IA geralmente têm origem no pipeline de dados, não no modelo. Em uma pesquisa da Fivetran, 42% das empresas relataram que mais da metade de seus projetos de IA sofreu atrasos, teve desempenho abaixo do esperado ou fracassou porque os dados não estavam prontos ou acessíveis a tempo.
Outro estudo da Broadcom constatou que 96% das organizações afirmam que problemas de desempenho nos pipelines de dados prejudicaram diretamente seus objetivos de IA, causando atrasos nos fluxos de treinamento e preparação, redução da automação e retrabalho dispendioso.
Esses números revelam uma verdade fundamental: quando os dados não conseguem percorrer o pipeline com rapidez ou confiabilidade, nem mesmo as operações mais sofisticadas de fábricas de modelos conseguem entregar resultados consistentes.
Como o F5 BIG-IP moderniza a entrega de dados para IA
Com o lançamento do F5 BIG-IP versão 21, o BIG-IP evoluiu muito além de seu papel como controlador de entrega de aplicações (ADC) tradicional. Agora, atua como um ADC totalmente modernizado, projetado para pipelines de dados orientados por IA, especialmente aqueles baseados em armazenamento de objetos compatível com S3.
Novas inovações permitem que o F5 BIG-IP ofereça o gerenciamento inteligente de tráfego, a otimização do caminho de dados e os controles de segurança necessários para manter os dados de IA em movimento, em grande volume e alta velocidade, nos fluxos de trabalho de treinamento, geração de embeddings e ajuste fino, não apenas de inferência.
Ele foi projetado para estabilizar e acelerar todo o fluxo. Ao atuar como uma camada de entrega entre o armazenamento de objetos e a pilha de aplicações de IA, garante que a entrada, a recuperação e o roteamento de dados permaneçam fluidos, seguros e resilientes, mesmo sob carga intensa.
O BIG-IP monitora continuamente a integridade dos nós de armazenamento e redireciona automaticamente o tráfego para evitar endpoints lentos ou com falhas. Suas otimizações específicas para S3, como perfis TCP/TLS aprimorados para uploads de grande porte em várias partes, ajudam a reduzir a sobrecarga das solicitações e acelerar leituras de alto volume. O tráfego também pode ser direcionado com base em metadados, como tamanho do objeto, prefixo ou bucket, permitindo que as organizações atribuam prioridades distintas a conjuntos de dados de ajuste fino, artefatos de treinamento ou dados de embeddings para RAG, conforme as necessidades operacionais.
Pilares fundamentais: roteamento baseado em localização, cache e segurança
Outro fator significativo para a eficácia do BIG-IP é a forma como ele lida com o roteamento com reconhecimento de localização. Quando uma região de armazenamento apresenta latência ou um cluster passa por manutenção, os fluxos são redirecionados de forma transparente para um local que esteja funcionando normalmente, sem exigir alterações nas próprias aplicações. Isso mantém o pipeline de IA continuamente abastecido com dados, independentemente do que esteja acontecendo na camada de armazenamento subjacente.
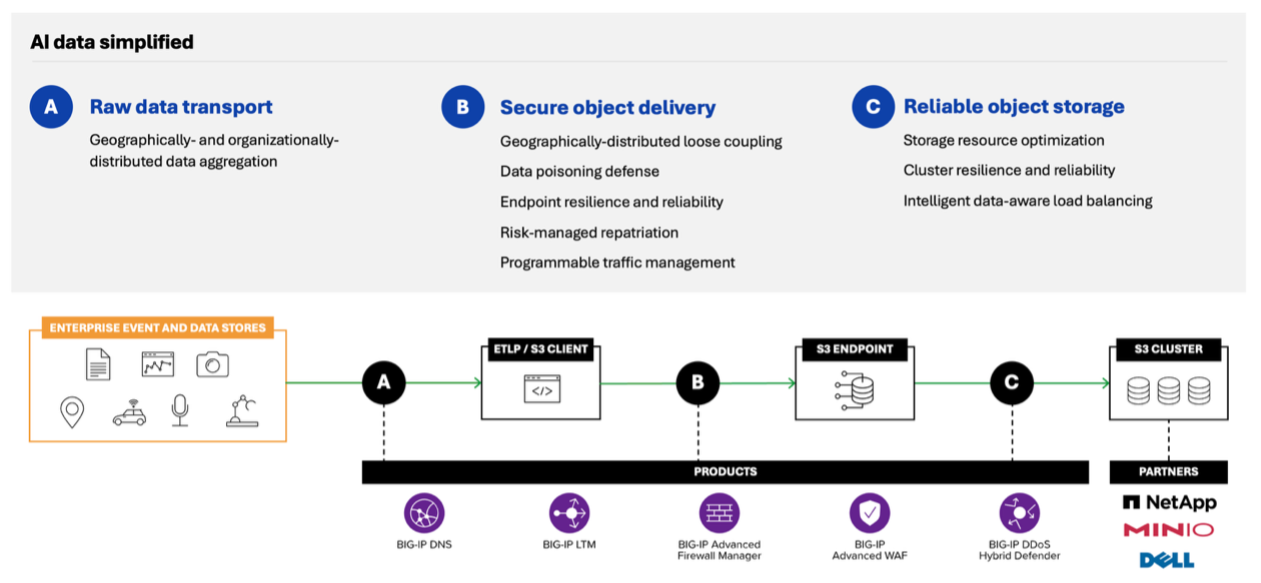
O gerenciamento de tráfego e a segurança devem estar plenamente integrados ao ecossistema de transporte de dados. Os endpoints de dados de IA têm alto custo operacional e são alvos valiosos para os invasores. Como mostra o diagrama abaixo, o BIG-IP oferece recursos essenciais de entrega e segurança para pipelines de dados de IA. A proteção avançada contra DDoS, os recursos de WAF e a governança granular de APIs tornam a segurança parte do pipeline de dados, em vez de um gargalo.
A importância da resiliência e da confiabilidade
Mesmo pipelines otimizados estão sujeitos a interrupções. Picos de tráfego, falhas em nós, surtos de replicação e alterações na rede podem prejudicar o desempenho da IA. Resiliência é a capacidade de manter o fluxo de dados apesar dessas condições. O BIG-IP se destaca nesse aspecto ao oferecer failover ativo, drenagem de tráfego durante eventos de manutenção e políticas de roteamento programáveis que mantêm o pipeline estável.
Na prática, isso significa que os repositórios de dados permanecem disponíveis e acessíveis. Os ciclos de treinamento mantêm o ritmo. Os processos de geração de embeddings para RAG e de aumento de dados são concluídos dentro do prazo. E a empresa evita as falhas em cascata que ocorrem quando uma camada da pilha de IA fica sobrecarregada ou indisponível.
O BIG-IP funciona como um sistema de controle de pressão, balanceamento de fluxo e válvulas de segurança para todo o pipeline de dados de IA. Ele garante que a refinaria, também conhecida como a fábrica de modelos de IA, tenha sempre o fluxo constante de “petróleo” de alta qualidade de que precisa.
A F5 entrega e protege aplicações de IA em qualquer lugar
A otimização do desempenho da IA não se resume à inferência de modelos. Trata-se de garantir que os enormes volumes de dados necessários para os fluxos de trabalho de treinamento, ajuste fino e geração de embeddings sejam transferidos com rapidez, previsibilidade e segurança.
Para obter mais informações sobre nossas soluções de entrega de dados de IA, acesse nossa página Soluções de Entrega de Dados e Infraestrutura de IA na web.
O foco da F5 em IA vai além da entrega de dados. Descubra como a F5 protege e entrega aplicações de IA em qualquer lugar.
Não deixe de conferir os outros posts do blog da nossa série sobre entrega de dados para IA:
Alimentando o pipeline de dados de IA com F5 e armazenamento compatível com S3
Acompanhamento de pipelines de dados de IA, da ingestão à entrega
Por que o armazenamento para IA exige uma nova abordagem de balanceamento de carga
Melhores práticas para otimizar a infraestrutura de IA em escala
Disponibilização de aplicações de IA em escala: o papel dos ADCs
Proteja seu pipeline de dados de IA sem comprometer a velocidade dos pipelines
Sobre o autor
Hunter Smit é gerente sênior de marketing de produtos para soluções e estratégia na F5. Ele lidera o marketing de soluções em todo o portfólio da F5, incluindo infraestrutura de IA e segurança de aplicações, e está conduzindo a entrada da F5 no mercado emergente de entrega de dados para IA. Hunter integra o Conselho Consultivo da Escola de Negócios da Whitworth University e atuou como professor adjunto de marketing de produtos. Ele possui MBA e bacharelado em Administração de Empresas com ênfase em gestão pela Whitworth University.
Mais publicações de Hunter SmitPublicações relacionadas no blog
IA agêntica em cibersegurança: promessas e riscos
Saiba por que o uso de IA agêntica na cibersegurança é essencial para combater ameaças impulsionadas por IA e por que os agentes também criam novos riscos para as empresas.
Como os clientes da F5 no setor financeiro lidam com a soberania digital sem desacelerar a inovação
Como é a soberania digital na prática? Dois projetos recentes da F5 com clientes mostram como diferentes empresas estão enfrentando esses desafios.
Soberania operacional: construindo resiliência em um mundo imprevisível
Para muitas organizações, a questão já não se resume apenas a controlar os dados. Trata-se de manter a capacidade de operar, adaptar-se e se recuperar à medida que as leis e as condições evoluem.
Segurança de IA com evidências: o que levaremos ao Gartner SRM
Antes de sua sessão no Gartner SRM, o vice-presidente sênior de Marketing de Produtos da F5 explica como a F5 ajuda as organizações a proteger a IA em três etapas práticas.
Gestão de riscos de IA: como as proteções podem ajudar a mitigá-los
O risco da IA é impulsionado por comportamentos probabilísticos e pela explicabilidade limitada, não apenas por falhas de segurança. Uma gestão eficaz exige controle operacional contínuo.

Lei de IA do Colorado (SB 205): o que as empresas precisam saber antes de 2026
A SB 205 do Colorado, a lei pioneira do estado sobre inteligência artificial, foi sancionada pelo governador Jared Polis em 17 de maio de 2024. O projeto de lei estabelece requisitos para que as empresas que utilizam IA implementem controles destinados a proteger os cidadãos do Colorado.