Este post do blog é o terceiro de uma série sobre entrega de dados para IA.
A IA generativa pode parecer simples à primeira vista. Mas, por trás de todo modelo bem-sucedido, há um pipeline de dados tão complexo e sensível quanto uma refinaria industrial.
Líderes de IA destacam constantemente que o maior obstáculo para expandir o uso da IA não são os modelos, mas o fluxo de dados que os alimenta. McKinsey & Company estima que a demanda das empresas por infraestrutura de dados preparada para IA cresce mais de 30% ao ano, enquanto os requisitos de dados dos ambientes de treinamento de modelos aumentam ainda mais rápido. Assim, quando esses pipelines falham, até as GPUs mais avançadas ficam ociosas.
Uma breve analogia ajuda a contextualizar o desafio.
“Pense em um pipeline de dados de IA como uma linha de montagem industrial moderna. As matérias-primas (dados empresariais) devem ser coletadas, inspecionadas e preparadas corretamente antes de entrar na linha.”
Em seguida, eles são refinados por meio de uma série de etapas precisas: limpeza, rotulagem, conversão e validação, para que atendam a rigorosos padrões de qualidade. Por fim, os componentes finalizados devem ser encaminhados com eficiência às estações de produção certas, no momento certo. Se qualquer etapa apresentar inconsistências, atrasos ou desalinhamentos, toda a operação fica comprometida — assim como uma linha de montagem para quando uma das estações de trabalho falha.
Assim como as matérias-primas precisam ser coletadas, refinadas e entregues à estação de produção, os dados empresariais precisam passar por ingestão, transformação e entrega antes de serem úteis para o treinamento ou ajuste fino de modelos, ou utilizados na geração aumentada por recuperação (RAG). Se houver contaminação ou atraso em qualquer etapa, todo o sistema de IA fica comprometido, o que impacta negativamente os negócios e reduz o retorno sobre o investimento (ROI).
Este artigo analisa essas três etapas e explica como o F5 BIG-IP e o armazenamento de objetos compatível com S3 dão suporte aos fluxos de trabalho de fábricas de modelos dos quais as empresas dependem atualmente.
Fase 1: Ingestão — captura e consolidação da matéria-prima
A ingestão é o momento em que os dados entram no ecossistema de IA. As empresas raramente têm uma única fonte de verdade; suas “matérias-primas” estão distribuídas entre sistemas departamentais, serviços de nuvem, repositórios de objetos, ferramentas SaaS, logs, APIs e até mesmo dados externos de terceiros. Grande parte desses dados chega em formatos distintos, em ritmos diferentes e com níveis variados de integridade.
Durante essa fase, os dados devem ser identificados, autenticados, normalizados e validados à medida que são encaminhados para armazenamentos de objetos centralizados ou distribuídos. Metadados são anexados, esquemas são mapeados e verificações iniciais de qualidade são realizadas. Se a ingestão for descuidada, o restante do pipeline herdará esse descuido. O desvio de modelo, ou seja, a degradação dos modelos ao longo do tempo, as alucinações e as tarefas de treinamento instáveis costumam ter origem em uma ingestão inconsistente ou com governança inadequada.
É também nessa etapa que a fragilidade das conexões se torna uma preocupação real. Em muitos ambientes altamente distribuídos, conexões de longa duração com sistemas remotos são interrompidas inesperadamente. Sem as devidas proteções, essas falhas deixam sessões abandonadas abertas no ambiente de armazenamento de objetos, consumindo recursos aos poucos e comprometendo a confiabilidade do ambiente.
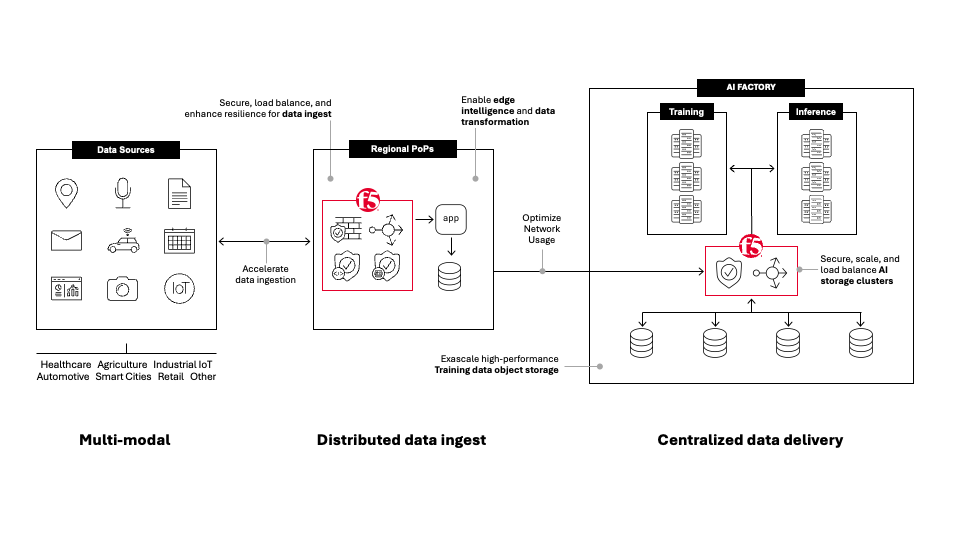
O F5 BIG-IP oferece estabilidade nesse cenário ao gerenciar essas conexões, evitar o consumo descontrolado de recursos e garantir que as transferências de dados sejam concluídas de forma previsível, mesmo quando a rede de origem é instável. Os recursos consolidados do BIG-IP — autenticação integrada (incluindo validação de tokens, integração de identidades e TLS mútuo), gerenciamento de tráfego, proteção de APIs e defesa contra ataques DDoS — também protegem os dados sensíveis que estão sendo transferidos para a organização.
Com essas medidas de proteção implementadas, os dados chegam de forma confiável aos sistemas de armazenamento compatíveis com S3 que alimentam a próxima etapa.
Fase 2: Transformação — refinando dados para uso em modelos
Se a ingestão carrega a matéria-prima, a transformação é a refinaria que a converte em ativos de dados de alta qualidade, prontos para uso em modelos. O trabalho realizado nessa etapa é muito mais complexo do que muitas equipes imaginam, e um número surpreendente de projetos de IA enfrenta dificuldades nesse ponto. Ambientes de produção de modelos dependem de dados consistentes e bem governados; quando os dados contêm ruído, são inconsistentes, estão mal formatados ou mal rotulados, o treinamento se torna instável e a qualidade dos modelos cai.
A transformação envolve a limpeza, a conversão e a preparação dos dados para que possam ser usados no treinamento de modelos, no ajuste fino ou na geração aumentada por recuperação (RAG).
Documentos e PDFs são convertidos em texto estruturado ou embeddings vetoriais. Imagens e logs são processados em formatos padronizados. Valores ausentes são corrigidos. Informações sensíveis são ocultadas ou criptografadas. A linhagem dos dados é registrada para que os órgãos reguladores possam rastrear como ativos específicos foram produzidos ou modificados. Nos pipelines de RAG, é também nessa etapa que ocorrem a definição da estratégia de divisão em blocos, a geração de embeddings e as atualizações dos índices.
Tradicionalmente, a transformação ocorria em um ambiente centralizado, mas esse padrão está mudando. Com o crescimento explosivo dos volumes de dados, faz cada vez mais sentido realizar parte da transformação na borda ou próximo às fontes de dados.
O F5 BIG-IP permite o enriquecimento e o refinamento distribuídos com opções flexíveis de implantação que podem ficar mais próximas dos pontos de origem dos dados. Quando combinado com um armazenamento de objetos flexível, compatível com S3 e implantado na borda, permite que as organizações filtrem e refinem os dados antes de enviá-los de volta ao pipeline central. Isso reduz os custos de tráfego e minimiza o risco de transferir conteúdo desnecessário ou que não esteja em conformidade.
Ao final da transformação, a organização dispõe de ativos limpos, confiáveis e seguros, prontos para os sistemas computacionais das etapas seguintes.
Fase 3: Entrega — levando dados otimizados aos recursos computacionais certos no momento certo
A entrega é o momento em que os dados refinados chegam aos clusters de GPU, às tarefas de ajuste fino, aos bancos de dados vetoriais ou aos pipelines de RAG que dependem deles.
A qualidade da entrega é percebida imediatamente por usuários e operadores. Se os dados chegam muito devagar, as GPUs ficam ociosas. Se o roteamento é ineficiente, as tarefas ficam na fila por mais tempo do que o esperado. Se os controles de acesso são fracos, conjuntos de dados sensíveis ficam expostos.
Uma etapa de entrega bem projetada garante que os dados sejam transferidos com rapidez e consistência do armazenamento para os recursos de computação. Caminhos de acesso com alta taxa de transferência permitem que tarefas de treinamento distribuído leiam dados do armazenamento de objetos em paralelo. O uso inteligente de cache melhora o desempenho.
Fluxos de trabalho automatizados agendam execuções de treinamento, ajustam a escala dos recursos e encaminham consultas de busca semântica. Ferramentas de monitoramento acompanham a latência, a taxa de transferência e as anomalias de desempenho.
A segurança continua sendo fundamental aqui. O acesso deve ser controlado no momento do uso, não apenas na ingestão, garantindo que cada conjunto de dados esteja disponível apenas para os modelos, tarefas ou usuários apropriados.
O F5 BIG-IP contribui para isso aplicando políticas, validando tokens e monitorando padrões de requisições. Ele também otimiza a distribuição do tráfego para que os dados fluam até os recursos computacionais da forma mais eficiente possível.
Quando combinados com armazenamento escalável compatível com S3, esses recursos criam um ambiente que mantém as tarefas de treinamento e ajuste fino continuamente abastecidas com dados, reduzindo o tempo de ociosidade das GPUs e mantendo um desempenho previsível.
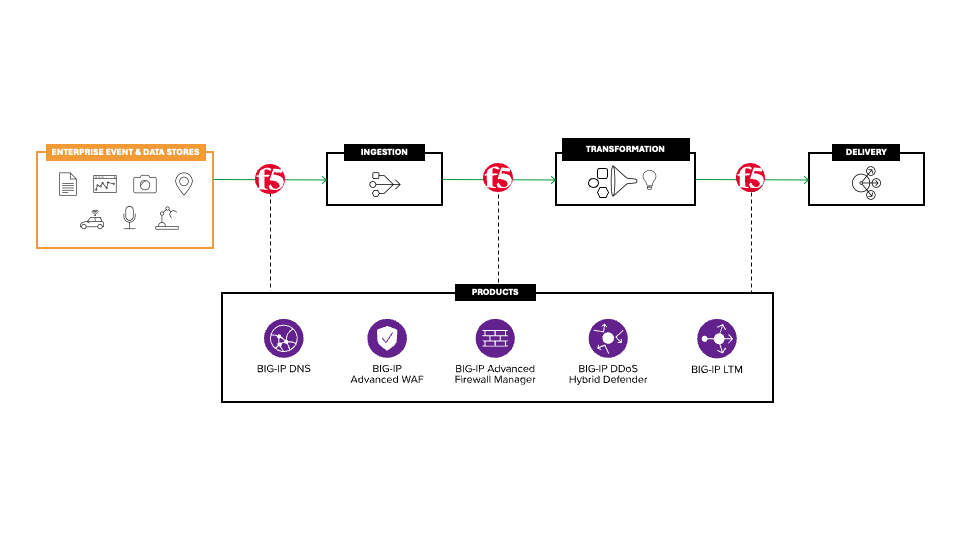
Como as três etapas se conectam
Embora a ingestão, a transformação e a entrega sejam processos distintos, elas funcionam como um ciclo contínuo.
A ingestão garante que dados atualizados e sujeitos à governança entrem no sistema a partir de toda a empresa. A transformação refina esses dados, convertendo-os em ativos de alta qualidade adequados para treinamento, indexação RAG ou ajuste fino. A entrega transfere esses ativos para os recursos computacionais apropriados com rapidez e integridade.
Uma deficiência em qualquer uma das áreas torna toda a operação mais lenta. Além disso, falhas nos pipelines são generalizadas. No geral, mais de 80% dos projetos de IA empresariais fracassam, segundo diversas fontes, muitas das quais também relatam que pelo menos 70% a 80% desses fracassos são atribuídos à baixa qualidade dos dados ou à qualidade insuficiente deles.
Mas, quando o pipeline flui sem problemas de ponta a ponta, com o suporte de serviços de rede seguros e resilientes, como o BIG-IP, e de armazenamento escalável compatível com S3, as organizações podem treinar modelos mais rapidamente, realizar ajustes finos com mais confiança e operar ambientes de fábricas de modelos em escala industrial.
A F5 entrega e protege aplicações de IA em qualquer lugar
Para obter mais informações sobre nossas soluções de entrega de dados para IA, acesse nossa página de Soluções de Entrega de Dados e Infraestrutura para IA na web.
O foco da F5 em IA vai além da entrega de dados. Saiba como a F5 protege e entrega aplicações de IA em qualquer lugar.
Não deixe de conferir os outros posts do blog da nossa série sobre entrega de dados para IA:
Impulsionando o pipeline de dados de IA com F5 e armazenamento compatível com S3
Otimizando a IA ao eliminar gargalos nas cargas de trabalho modernas
Por que o armazenamento para IA exige uma nova abordagem de balanceamento de carga
Melhores práticas para otimizar a infraestrutura de IA em larga escala
Disponibilização de aplicações de IA em escala: o papel dos ADCs
Proteja seu pipeline de dados de IA sem comprometer a velocidade dos pipelines
Sobre os autores
Mark Menger é arquiteto de soluções na F5, especializado em parcerias de tecnologia de IA e segurança. Ele lidera o desenvolvimento da Arquitetura de Referência de IA da F5, promovendo soluções de IA seguras e escaláveis. Com experiência como arquiteto de soluções globais e engenheiro de soluções, Mark contribuiu para a Arquitetura de Nuvem Segura da F5 e participou do desenvolvimento de sua Arquitetura Distribuída em Quatro Camadas. Coautor de Solving IT Complexity, ele tem ampla experiência na resolução de desafios de TI. Anteriormente, atuou como desenvolvedor de aplicações e arquiteto corporativo, com foco em aplicações modernas, automação e aceleração do retorno sobre investimentos em IA.
Mais publicações de Mark MengerPublicações relacionadas no blog
IA agêntica em cibersegurança: promessas e riscos
Saiba por que o uso de IA agêntica na cibersegurança é essencial para combater ameaças impulsionadas por IA e por que os agentes também criam novos riscos para as empresas.
Como os clientes da F5 no setor financeiro lidam com a soberania digital sem desacelerar a inovação
Como é a soberania digital na prática? Dois projetos recentes da F5 com clientes mostram como diferentes empresas estão enfrentando esses desafios.
Soberania operacional: construindo resiliência em um mundo imprevisível
Para muitas organizações, a questão já não se resume apenas a controlar os dados. Trata-se de manter a capacidade de operar, adaptar-se e se recuperar à medida que as leis e as condições evoluem.
Segurança de IA com evidências: o que levaremos ao Gartner SRM
Antes de sua sessão no Gartner SRM, o vice-presidente sênior de Marketing de Produtos da F5 explica como a F5 ajuda as organizações a proteger a IA em três etapas práticas.
Gestão de riscos de IA: como as proteções podem ajudar a mitigá-los
O risco da IA é impulsionado por comportamentos probabilísticos e pela explicabilidade limitada, não apenas por falhas de segurança. Uma gestão eficaz exige controle operacional contínuo.

Lei de IA do Colorado (SB 205): o que as empresas precisam saber antes de 2026
A SB 205 do Colorado, a lei pioneira do estado sobre inteligência artificial, foi sancionada pelo governador Jared Polis em 17 de maio de 2024. O projeto de lei estabelece requisitos para que as empresas que utilizam IA implementem controles destinados a proteger os cidadãos do Colorado.