Was ist KI-Datensicherheit?
KI-Datensicherheit schützt die von KI-Systemen verwendeten Daten, Modelle und Schnittstellen vor Missbrauch, Datenlecks und Angriffen.
KI-Datensicherheit schützt die Daten, Modelle und Schnittstellen, die KI-Systeme nutzen, vor Missbrauch, Datenlecks und Angriffen.
KI-Datensicherheit umfasst Praktiken, Kontrollen und innovative Technologien, die gemeinsam Daten, Modelle und KI-APIs während des gesamten KI-Lebenszyklus vor unbefugtem Zugriff, Missbrauch, Manipulation und Datenlecks schützen. Sie erweitert die herkömmliche Datensicherheit um den Schutz von Modellen, die Sicherheit bei der Inferenz und den Schutz KI-gestützter Entscheidungsprozesse.
KI-Datensicherheit vs. traditionelle Datensicherheit
Herkömmliche Datensicherheitstools konzentrieren sich auf den Schutz von Ressourcen, Speicherumgebungen und Datenübertragungsmethoden. Sie eignen sich zwar gut dazu, den Datenzugriff zu kontrollieren, bestimmte Bedrohungen abzuwehren und Unbefugte am Lesen von Daten zu hindern, können KI-Systeme jedoch nicht angemessen schützen.
KI-Systeme sind dynamisch und probabilistisch. Identische Prompts können bei einer generativen KI je nach Kontext und Absicht des Prompts zu unterschiedlichen Ergebnissen führen. Herkömmliche Tools können diesen Kontext oder diese Absicht nicht bewerten. Daher sind sie weder in der Lage, in Prompts verborgene Bedrohungen zu erkennen oder manipulierte Trainingsdaten aufzuspüren, noch können sie Versuche aufdecken, die interne Entscheidungsfindung eines KI-Systems zu manipulieren.
KI-Datensicherheit analysiert Kontext und Absicht, um potenziell böswillige Handlungen zu erkennen. Diese Tools schützen die Ein- und Ausgaben von KI-Systemen durch Leitplanken, um eingehende Daten zu bereinigen, Prompts für KI-Systeme genau zu prüfen und Ausgaben bei Bedarf zu schwärzen. Außerdem können sie Grenzen für Agenten festlegen, um unbeabsichtigtes Verhalten zu verhindern.
Warum KI-Datensicherheit gerade jetzt wichtig ist
KI-Systeme und Infrastrukturen bringen neue Sicherheitsherausforderungen mit sich, die über den herkömmlichen Datenschutz hinausgehen. Unternehmen müssen Modelle, API-Schnittstellen sowie Ein- und Ausgaben schützen, durch die vertrauliche Informationen offengelegt oder das System getäuscht werden könnten. Schutzmaßnahmen erhöhen die allgemeine Sicherheit.
Generative KI, LLM-Anwendungen und autonome Systeme sind auf große Datensätze und einen kontinuierlichen Datenfluss angewiesen. Dadurch entstehen Schwachstellen wie Datenvergiftung, Modelldiebstahl, Prompt-Injection und die Offenlegung vertraulicher Informationen. Da KI in Kundenanwendungen, Arbeitsabläufe und Entscheidungsprozesse eingebettet wird, ist die Sicherheit von KI-Daten für geschäftskritische Ziele wie Vertrauen, Kontinuität und Compliance von entscheidender Bedeutung.
Wie führen KI-Systeme zu neuen Risiken? Hier sind einige häufige Beispiele:
- KI-Systeme können über Modellausgaben vertrauliche Informationen preisgeben.
- KI-APIs schaffen neue Angriffsflächen und ermöglichen Angriffsmuster mit deutlich höherer Frequenz.
- Modelle können durch bösartige Prompts oder gezielt manipulierte Eingaben beeinflusst werden.
- Modell-Snapshots (Checkpoints), Vektordarstellungen (Embeddings) und Trainingsdaten werden zu schützenswertem geistigem Eigentum.
- Inferenzendpunkte müssen unter strengen Vorgaben hinsichtlich Latenz, Skalierbarkeit und Richtlinien betrieben werden.
Schatten-KI und Datenoffenlegung eindämmen
KI-Risiken durch Insider stellen den Datenschutz vor erhebliche Herausforderungen. Mitarbeitende könnten unbeabsichtigt Daten offenlegen, indem sie nicht autorisierte KI-Tools verwenden, bei denen keine Schutzmechanismen vorhanden sind. Beispielsweise könnten sie Kundendaten, vertrauliches geistiges Eigentum oder Quellcode in ein KI-System eingeben, ohne zu wissen, dass diese Daten zum Trainieren des Modells eines KI-Unternehmens verwendet werden könnten. Auch die Eingabe sensibler Daten in eine generative KI-Engine oder ein KI-gestütztes Softwareentwicklungstool könnte dazu führen, dass diese Daten externen Bedrohungen ausgesetzt sind.
KI-Datensicherheit über den gesamten Lebenszyklus hinweg
Die Sicherheit von KI-Daten muss die Daten und das Modell über alle Phasen des KI-Lebenszyklus hinweg begleiten. Herkömmliche Ansätze, die ausschließlich auf Perimetersicherheit setzen, greifen zu kurz, da KI-Ressourcen zwischen verschiedenen Umgebungen wechseln und dynamisch mit Benutzern, Anwendungen und anderen Modellen interagieren. Die Sicherheit muss kontinuierlich, integriert und auf das jeweilige Modell abgestimmt sein.
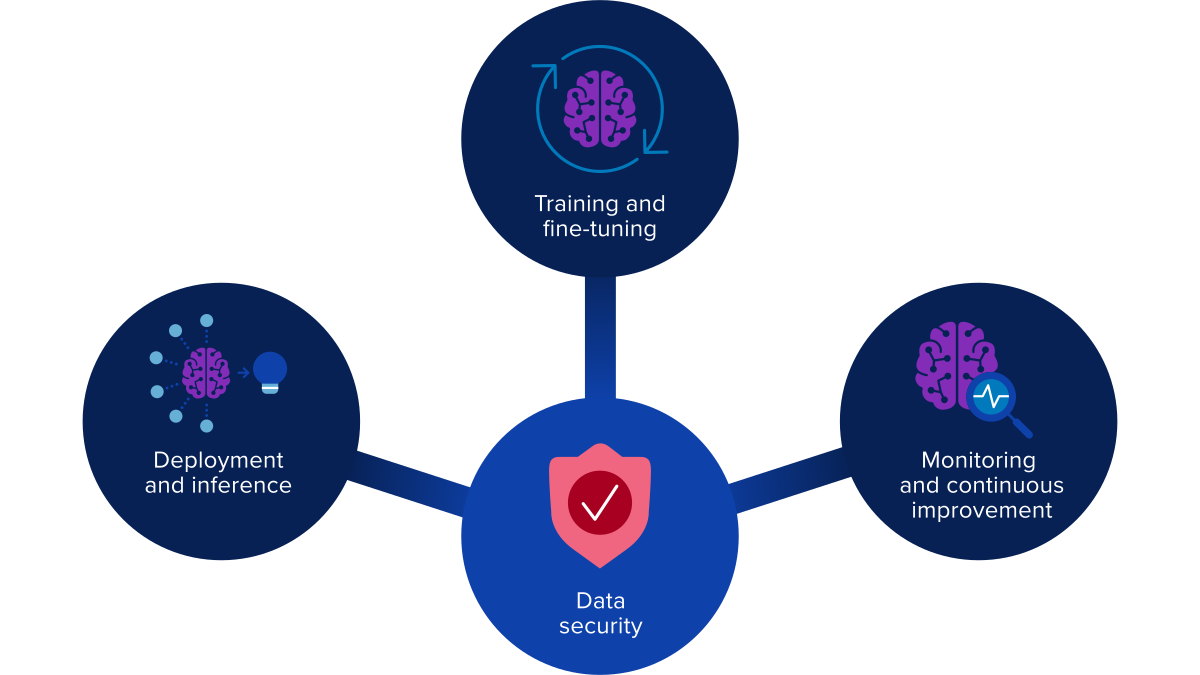
- Datenerfassung und -aufbereitung: KI-Sicherheit beginnt bereits vor dem Training. Bei der Datenerfassung, Kennzeichnung und Merkmalsextraktion besteht das Risiko, dass sensible Informationen durch Diebstahl, unbefugten Zugriff oder Datenvergiftung offengelegt werden. Bei Letzterer schleusen Angreifer manipulierte Daten ein, um das Modell zu verzerren oder seine Leistung zu beeinträchtigen. Eine solide Governance sowie wirksame Validierungs- und Zugriffskontrollen sind unerlässlich, bevor Daten in eine KI-Pipeline gelangen.
- Training und Feinabstimmung: Trainingsdaten, Modell-Checkpoints, Einbettungen und Gradienten enthalten sensible Informationen. Eine Kompromittierung während des Trainings und der Feinabstimmung kann zu Manipulationen am Modell, zum Verlust geistigen Eigentums, zur Offenlegung regulierter Daten und zu adversarialen Manipulationen führen, die das Verhalten des Modells dauerhaft verändern.
- Bereitstellung und Inferenz: Inferenz-APIs sind bevorzugte Ziele für Prompt-Injection, die Manipulation von Ausgaben, die Extraktion von Modellen, das Abschöpfen von Daten und Überlastungsangriffe. Der Zugriff muss authentifiziert und streng kontrolliert werden, und Eingaben müssen auf Anzeichen schädlicher Payloads untersucht werden.
- Überwachung und kontinuierliche Verbesserung: Modelldrift, Verzerrungen, schädliches Verhalten und unbefugte Nutzung müssen fortlaufend überwacht, protokolliert und kontrolliert werden. Betreiber müssen Anomalien, Zugriffsmuster sowie Sicherheits- und Compliance-Probleme erkennen.
Warum reine Perimetersicherheit diese Umgebung nicht bewältigen kann
KI-Workloads erstrecken sich über Data Lakes, Cluster, Registrys, Gateways, Edge-Knoten und Endgeräte. Daher kann sich die Sicherheit nicht auf einen einzigen Perimeter stützen. Der Schutz muss Daten und Modelle über ihren gesamten Lebenszyklus hinweg begleiten und an allen Interaktionspunkten mit Benutzern, Anwendungen oder Diensten eine einheitliche Authentifizierung, Überprüfung und Durchsetzung von Richtlinien gewährleisten.
Grundprinzipien und Kontrollmaßnahmen für die Sicherheit von KI-Daten
Effektive KI-Datensicherheit beruht auf einer Kombination aus Sicherheits-, Datenschutz- und betrieblichen Kontrollen:
- Daten-Governance und Folgenabschätzungen: Prüfen Sie die Rechtmäßigkeit, Datenqualität, Herkunft und Datenschutzfolgen, bevor Daten für die KI-Entwicklung verwendet werden.
- Zero Trust und geringstmögliche Berechtigungen: Setzen Sie Authentifizierung und Autorisierung an jeder Grenze durch, einschließlich Daten-Repositorys, Modellartefakten und Inferenz-APIs.
- Datenminimierung und Anonymisierung: Reduzieren Sie die Offenlegung vertraulicher Informationen und versehen Sie Datensätze mit Vertraulichkeitskennzeichnungen, damit nachgelagerte Schutzmaßnahmen durchgesetzt werden können.
- Schutzmaßnahmen auf Modellebene: Sichern Sie Checkpoints, Embeddings, Trainingsartefakte und Beschleunigerumgebungen.
- Laufzeitprüfung von Ein- und Ausgaben: Erkennen Sie Prompt-Injection-Angriffe, schädliche Payloads, toxische Inhalte oder unbeabsichtigte Datenlecks.
- Kontinuierliche Überwachung und menschliche Aufsicht: Erforderlich für KI-Entscheidungen mit weitreichenden Folgen und in regulierten Branchen.
- API- und Traffic-Governance: Sicherstellen, dass nur validierte Anfragen die Inferenz-Endpunkte erreichen.
Governance-Entscheidungen werden zwar außerhalb des Netzwerks getroffen, doch F5 setzt sie in der Praxis durch, indem sichergestellt wird, dass nur genehmigte Datenquellen, Identitäten und Dienste auf KI-Systeme zugreifen können. F5 Distributed Cloud Services und F5 BIG-IP wenden richtlinienbasierte Zugriffskontrollen, ein die Datenklassifizierung berücksichtigendes Routing und Positivlisten für APIs an, damit die Datenflüsse für Training und Inferenz den genehmigten Governance-Regeln entsprechen.
Schutz von KI-Daten bei der Übertragung und im Ruhezustand
KI-Pipelines sind auf einen kontinuierlichen Datenfluss von der Aufnahme über Feature Stores bis hin zu Inferenzendpunkten angewiesen. Zur Absicherung dieser Datenflüsse sind folgende Maßnahmen erforderlich:
- Verschlüsselung von Daten während der Übertragung und im Ruhezustand.
- Authentifizierung und Autorisierung für alle API-Zugriffe.
- Sicheres API-Design mit Schemavalidierung, Ratenbegrenzung und Bedrohungserkennung.
- Web Application Firewall (WAF), Schutz vor Distributed-Denial-of-Service-Angriffen (DDoS) und Bot-Schutz als erste Durchsetzungsebene.
- Segmentierte Umgebungen zur Isolierung von Trainingsdaten, Inferenz-Endpunkten und Modellartefakten.
- Datenverkehrsanalyse zur Erkennung von Anomalien oder verborgenen Bedrohungen in verschlüsselten Kanälen.
F5 schützt KI-Datenpipelines durch eine Inline-Durchsetzungsebene vor Gateways und Modellendpunkten. Lösungen wie F5 Distributed Cloud Web App and API Protection (WAAP), F5 Distributed Cloud API Security, F5 BIG-IP Advanced WAF, F5 BIG-IP Access Policy Manager (APM), F5 BIG-IP SSL Orchestrator und F5 NGINX App Protect übernehmen Transport Layer Security (TLS), Authentifizierung, Validierung, Ratenbegrenzung, WAF, Schutz vor DDoS-Angriffen, Bot-Abwehr und die Überprüfung verschlüsselten Datenverkehrs. So wird sichergestellt, dass nur verifizierte Anfragen die KI-Modelle erreichen. Dies trägt dazu bei, KI-Datenpipelines vor schädlichen Nutzdaten, unbefugtem Zugriff, ungewöhnlichen Aktivitäten und der Offenlegung von Daten zu schützen.
Bei der Inferenz und in der gesamten KI-Umgebung kombiniert F5 Infrastrukturkontrollen mit KI-spezifischen Kontrollen, um die Interaktionen zwischen Modellen, Anwendungen, Agenten und Benutzern abzusichern. F5 NGINX Ingress Controller, F5 Distributed Cloud Mesh und F5 BIG-IP Next Kubernetes können dabei helfen, Mandanten zu isolieren, Umgebungen zu segmentieren sowie Datenverkehrs- und Zugriffsrichtlinien für Inferenz-Workloads durchzusetzen. F5 AI Guardrails ergänzt KI-spezifische Laufzeitprüfungen und die Durchsetzung von Richtlinien für Prompts, Antworten, Agentenaktionen und die Nutzung von Tools. F5 AI Gateway steuert den Zugriff auf Modelle, Agenten und Tools, während F5 AI Red Team Modelle, Anwendungen und Agenten adversarialen Tests unterzieht, um Schwachstellen zu identifizieren. F5 Workforce AI Security sorgt für Transparenz und Governance bei der genehmigten und nicht genehmigten KI-Nutzung.
Erweiterte Datenschutzeinstellungen und Schutz personenbezogener Daten
Verschiedene fortschrittliche Maßnahmen können Unternehmen dabei helfen, den Datenschutz und die Sicherheit sensibler Daten während des Modelltrainings und der Echtzeit-Inferenz zu gewährleisten.
Während des Modelltrainings müssen Unternehmen sicherstellen, dass die Rohdaten für das Training vertraulich bleiben und die Modelle später nicht durch Reverse Engineering zur Rekonstruktion sensibler Daten verwendet werden können. Dazu können folgende Maßnahmen gehören:
- Datenmaskierung und synthetische Daten: Trainiert Modelle anhand computergenerierter Datensätze, die Daten simulieren, ohne echte Kundendatensätze zu verwenden.
- Mathematisch fundierter (differenzieller) Datenschutz: Fügt beim Training sorgfältig kalibriertes mathematisches Rauschen hinzu, um das Risiko zu verringern, dass sensible Informationen über einzelne Datensätze später aus dem Modell abgeleitet werden können
- Föderiertes Lernen: Schützt die tatsächlichen Daten auf lokalen Servern und sendet lediglich Aktualisierungen der Modellparameter an einen zentralen Server.
Um Daten während der Echtzeit-Inferenz zu schützen, sollten Unternehmen Maßnahmen ergreifen, die eine mögliche Offenlegung unverschlüsselter Informationen begrenzen. Dazu gehören:
- Echtzeit-Datenschwärzung: Entfernt automatisch vertrauliche Angaben aus Benutzereingaben, bevor diese das KI-System erreichen, und stellt sie bei der Rückgabe einer Antwort lokal wieder her.
- Hardware-Tresore: Verarbeitet KI-Anfragen in hardwareverschlüsselten Chips und verhindert so, dass unbefugte Dritte darauf zugreifen können.
- Fortschrittliche Kryptografie: Ermöglicht es KI-Modellen, ausschließlich vollständig verschlüsselte Daten zu analysieren und Antworten zu liefern, ohne die zugrunde liegende Datei zu entschlüsseln.
Modelle, Eingaben und Ausgaben absichern
KI-Modelle bringen besondere Sicherheitsanforderungen mit sich, etwa die Sicherheit von Modellen und Ausgaben sowie ein kontextbezogenes Sicherheitsverständnis.
Modellsicherheit umfasst den Schutz von Checkpoints, Einbettungen und Modellgewichten (erlernten numerischen Werten) vor Diebstahl, Manipulation oder unbefugter Vervielfältigung. Die Eingabesicherheit mit KI-Firewalls muss Eingabeaufforderungen und Nutzdaten filtern und auf Prompt-Injection-Angriffe, adversariale Eingaben, eingeschleusten Schadcode sowie übergroße oder fehlerhaft formatierte Eingaben prüfen, die darauf abzielen, Systeme zu überlasten und zum Absturz zu bringen.
Ausgabesicherheit umfasst die Verhinderung der Offenlegung sensibler Daten, geistigen Eigentums oder schädlicher Inhalte durch KI-Ausgaben.
Herkömmlichen Sicherheitslösungen fehlt das Bewusstsein für spezifische KI-Bedrohungen. Daher sollten Verfahren wie das AI Security Posture Management (AI-SPM) eingesetzt werden, um Konfigurationen, Richtlinien und das Laufzeitverhalten in Multicloud- und Hybridumgebungen kontinuierlich zu überwachen und Abweichungen oder Fehlkonfigurationen zu erkennen.
F5 bietet mehrschichtige Kontrollen, um KI-Modelle, Eingaben, Ausgaben sowie die umgebende Anwendungs- und API-Infrastruktur abzusichern. BIG-IP Advanced WAF, Distributed Cloud WAAP, Distributed Cloud API Security und NGINX App Protect können vor KI-Gateways und Inferenz-Endpunkten eingesetzt werden, um Aufrufer zu authentifizieren, den Datenverkehr zu prüfen und Sicherheitsrichtlinien für Anwendungen und APIs rund um KI-Workloads durchzusetzen. F5 AI Guardrails ergänzt KI-spezifische Laufzeitprüfungen und die Durchsetzung von Richtlinien für Prompts, Antworten, Agentenaktionen und die Nutzung von Tools; F5 AI Gateway steuert den Zugriff auf Modelle, Agenten und Tools; F5 AI Red Team unterzieht Modelle, Anwendungen und Agenten adversarialen Tests, um Schwachstellen zu identifizieren; und F5 Workforce AI Security sorgt für Transparenz und Governance bei der genehmigten und nicht genehmigten Nutzung von KI.
AI Guardrails und Workforce AI Security ergänzen KI-spezifische Prüf- und Richtliniendurchsetzungsfunktionen, um Prompt-Injection, die Offenlegung sensibler Daten, schädliche Inhalte und andere riskante Aktivitäten zu blockieren. Workforce AI Security erweitert zudem die Transparenz und Governance sowohl bei genehmigter als auch bei nicht genehmigter KI-Nutzung. So können Unternehmen nachvollziehen, welche KI-Tools wie eingesetzt werden und wo möglicherweise sensible Daten offengelegt oder Richtlinien verletzt werden.
KI-Datensicherheit in die Praxis umsetzen
Unternehmen müssen KI-Sicherheit in bestehende Prozesse integrieren:
- Integration von DevSecOps und MLOps: Umfasst die Einbettung von Sicherheitsprüfungen in Trainings- und Bereitstellungspipelines. Dieser Ansatz stellt sicher, dass Schwachstellen, Fehlkonfigurationen und riskante Datenflüsse frühzeitig erkannt werden, sodass sie nicht in produktive KI-Systeme gelangen.
- Klare interne Richtlinien: Sie regeln die sichere Nutzung interner und externer KI-Tools. Diese Richtlinien schaffen Leitplanken, die dazu beitragen, eine unbeabsichtigte Offenlegung von Daten zu minimieren und den Missbrauch generativer KI oder KI-Dienste von Drittanbietern zu verhindern.
- Regulatorische Konformität: Umfasst die Einhaltung der Datenschutz-Grundverordnung (DSGVO), des Health Insurance Portability and Accountability Act (HIPAA), des California Consumer Privacy Act (CCPA), branchenspezifischer Vorschriften und neuer KI-Regulierungen. Unternehmen müssen KI-Datenflüsse und das Modellverhalten regelmäßig überwachen, um diese Vorschriften einzuhalten und dadurch Bußgelder, betriebliche Risiken und eine schleichende Abweichung von Compliance-Vorgaben zu vermeiden.
- Modell der geteilten Verantwortung: Die Gewährleistung der KI-Sicherheit erfordert die Zusammenarbeit von Netzwerk-, Daten-, Anwendungssicherheits- und KI-Plattformteams. Ein wirksamer Schutz setzt eine koordinierte Verantwortungsübernahme voraus, damit kein einzelnes Team zum Engpass oder blinden Fleck in der KI-Pipeline wird.
- Mitarbeiterschulung: Stellen Sie sicher, dass die Teams mit sicheren Prompt-Techniken, dem Umgang mit Daten und den Richtlinien zur Modellnutzung vertraut sind. Gut geschulte Mitarbeitende sind entscheidend, um menschliche Fehler zu minimieren, die eine der Hauptursachen für KI-bezogene Datenlecks und missbräuchliche Nutzung darstellen.
Abschließende Gedanken
Die Sicherheit von KI-Daten ist eine wesentliche Voraussetzung dafür, den Einsatz von KI im gesamten Unternehmen vertrauensvoll auszuweiten. Der Schutz der Daten, Modelle und Schnittstellen, auf denen KI-Systeme basieren, erfordert kontinuierliche Kontrollen, intelligente Prüfmechanismen und eine robuste Governance in jeder Phase der KI-Nutzung. Durch die direkte Integration intelligenter Sicherheits- und Traffic-Management-Funktionen in KI-Gateways und Inferenzendpunkte unterstützt F5 Unternehmen dabei, Zero Trust durchzusetzen, Datenlecks zu verhindern, schädliche Eingaben zu blockieren und einen reibungslosen, regelkonformen KI-Betrieb in Hybrid- und Multicloud-Umgebungen sicherzustellen.
Häufig gestellte Fragen
Wie unterscheidet sich die Datensicherheit bei KI von der herkömmlichen Datensicherheit?
KI-Datensicherheit unterscheidet sich von herkömmlicher Datensicherheit durch einen dynamischen Ansatz, der auf kontextbezogene KI-Systeme zugeschnitten ist. Herkömmliche Datensicherheit schützt statische Ressourcen, Datenspeicher und Verfahren zur Datenübertragung. Diese Lösungen können weder den Kontext noch die Absicht analysieren, die für die Erkennung von Bedrohungen innerhalb von KI-Systemen entscheidend sind. KI-Datensicherheit analysiert diese Inhalte und Absichten, versieht die Ein- und Ausgaben von KI-Systemen mit Schutzmechanismen und legt Grenzen für KI-Agenten fest.
Was ist Datenvergiftung und wie können Unternehmen sie beim KI-Training verhindern?
Unter Data Poisoning versteht man den Versuch, die Trainingsdaten eines KI-Modells so zu manipulieren, dass das Modell bei der Inferenz ungenaue oder verzerrte Ergebnisse liefert. Um Data Poisoning zu verhindern, sollten Unternehmen die Daten vor dem Training analysieren, den Zugriff auf die Trainingsdaten kontrollieren, Änderungen an diesen Daten nachverfolgen und Lösungen zum Schutz der Trainingsinfrastruktur sowie der Daten während der Übertragung einsetzen.
Wie schützen Inline-KI-Firewalls LLMs vor Prompt-Injection und Datenlecks?
Inline-KI-Firewalls schützen vor Prompt-Injection und Datenlecks, indem sie als Reverse-Proxy den Large Language Models (LLMs) vorgeschaltet werden. Sie verhindern Prompt-Injection, indem sie die Absicht hinter Eingaben prüfen, die Handlungsmöglichkeiten des KI-Systems einschränken und Antworten kontrollieren. Ebenso schützen sie vor Datenlecks, indem sie Eingabedaten maskieren, den Abruf auf autorisierte Dateien beschränken und Ausgaben auf vertrauliche Informationen prüfen.
Was ist eine KI-Stückliste (AI-BOM) und warum ist sie für die Unternehmenssicherheit von entscheidender Bedeutung?
Eine AI-BOM ist eine Auflistung aller Komponenten eines KI-Systems. Sie sollte nicht nur Informationen zu Modellen und Datensätzen enthalten, sondern auch zu Abhängigkeiten, Einbettungen, Prompts und Datenabrufquellen. Die AI-BOM schafft Transparenz über die KI-Lieferkette und hilft Unternehmen dabei, potenzielle Sicherheitslücken zu erkennen und zu beheben.
Wie trägt F5 dazu bei, Vektordatenbanken und Architekturen für Retrieval-Augmented Generation (RAG) abzusichern?
F5 schützt Vektordatenbanken und RAG-Architekturen durch Inline-Schutz entlang der gesamten KI-Pipeline mithilfe von F5 Distributed Cloud. Anstatt sich auf die in Datenbanken oder RAG-Umgebungen integrierten Zugriffskontrollen zu verlassen, können Unternehmen mit F5 Sicherheitsmaßnahmen, Datenverkehrsmanagement und Identitätskontrollen an den Eingangspunkten, API-Gateways und Netzwerkschichten implementieren, die die Datenbanken und Architekturen umgeben.
Welche Funktionen von F5 unterstützen die Sicherheit von KI in Unternehmen?
Die F5 AI Security Platform vereint AI Guardrails, Workforce AI Security, AI Gateway und AI Red Team, damit Unternehmen KI-Systeme verwalten, testen und schützen können.
AI Guardrails unterstützt die Durchsetzung von Laufzeitrichtlinien und schützt vor Risiken wie Prompt-Injection, der Offenlegung sensibler Daten, schädlichen Inhalten und unsicheren Aktionen von Agenten. Workforce AI Security sorgt für Transparenz und Governance bei der genehmigten und nicht genehmigten KI-Nutzung und kann KI-Interaktionen überprüfen sowie Richtlinien dafür durchsetzen. AI Gateway bietet einen zentralen Kontrollpunkt zur Steuerung des Zugriffs auf Modelle, Agenten und Tools, während AI Red Team mithilfe adversarialer Tests Schwachstellen und Sicherheitslücken in Modellen, Anwendungen und Agenten identifiziert.
Für einen umfassenderen Schutz von Anwendungen, APIs und verteilten Umgebungen bietet die F5 Application Delivery and Security Platform (ADSP) unter anderem Funktionen zum Schutz von Webanwendungen und APIs, zur Bot-Abwehr, zur DDoS-Abwehr und zur Anwendungsbereitstellung.
