アプリとAPIのスケーリングに対応するアプリケーションデリバリーパターン
今日、アプリとAPIをスケーリングするうえで重要なのは、適切な負荷分散アルゴリズムを選ぶことではありません。アプリケーションデリバリが進化してきた20年以上の間、ほぼ変わらなかったものの1つが負荷分散アルゴリズムです。その主な利点は、可用性の維持にあります。パフォーマンスへの影響は、よく見積もってもごくわずかです。
だからといって、アルゴリズムの選択が重要でないわけではありません。結局のところ、ラウンドロビンがAPIやアプリケーションにとって最適な選択肢となることはほとんどありません。しかし、最小接続数と最速応答のどちらを選ぶかよりも、アーキテクチャの方がデジタルサービス全体のパフォーマンスと可用性に影響を及ぼす可能性が高いと言えます。
ここでは、デジタルサービスの設計と運用に必要な6つの主要機能の1つとしてアプリケーションデリバリの重要性が高まっていることを踏まえ、アーキテクチャの観点からアプリケーションデリバリを考察します。
負荷分散アルゴリズムとは
負荷分散アルゴリズムとは、リソースプール全体に負荷を分散し、可用性の確保とパフォーマンスの向上を図るためのプログラムによる手法です。
負荷分散アルゴリズムでは、特定のリソースを選択する方法と、考慮する変数を指定します。
ラウンドロビンは最も単純なアルゴリズムで、既知のリソース群を順番に選択します。リソースがA、B、Cの3つある場合、ラウンドロビンでは最初のリクエストをA、2番目をB、3番目をCにルーティングします。その後、選択プロセスが最初から繰り返されます。
最小接続数は、「負荷が増加すると、パフォーマンスが低下する」という第2の運用上の原則に基づくアルゴリズムです。そのため、最小接続数アルゴリズムは、接続数(負荷)が最も少ないリソースを選択します。このアルゴリズムにはいくつかのバリエーションがあり、代表的なものに重み付き最小接続数があります。これは、リソース間の処理能力の違いを考慮できる方式です。
最速応答時間は、パフォーマンスを最優先する場合に使用します。ロードバランサーは、各リソースの応答時間をパッシブまたはアクティブに測定し、リクエストごとに最も応答が速いリソースを選択します。このアルゴリズムは、ユーザーの応答時間を保証するものではありません。ラストマイルやユーザーネットワークの状態には影響を及ぼさないためです。
送信元IPは、ネットワーク負荷分散の名残であるアルゴリズムです。送信元(クライアント)IPの単純なハッシュ値を使用してリソースを選択します。このアルゴリズムでは、特定の送信元IPに対して常に同じリソースが選択されます。単一のプロキシ/IPアドレスを経由するすべてのユーザーが同じリソースに振り分けられる「メガプロキシ」問題の影響を受けるため、現在ではあまり使用されていません。その結果、対象リソースに過剰な負荷がかかり、パフォーマンスが低下して、最終的には障害に至る傾向があります。
ロードバランシングアルゴリズムは、アプリケーションデリバリーアーキテクチャの重要な要素ですが、アプリケーションやデジタルサービスのパフォーマンスとスケーラビリティに与える影響は、アーキテクチャ全体のアプローチほど大きくありません。
アプリデリバリーとは
アプリケーションデリバリとは、アプリケーション、API、デジタルサービス向けに、拡張性と高いパフォーマンスを備えたアーキテクチャを設計するための手法です。中核コンポーネントとしてロードバランシングを重視しつつ、レイヤー7ルーティングなどの最新機能を取り入れ、一般的なアーキテクチャパターンを活用することで、パフォーマンスとリソース利用効率を最適化します。
「アプリケーションデリバリー」という用語は、実装の詳細である負荷分散と、設計プロセスであるアーキテクチャを明確に区別するために使用しています。
なぜスケーリングするのか?
スケーリングは、ビジネス成果を実現するための技術的な対応です。具体的には、顧客満足度、コンバージョン率、収益創出を向上させるために、デジタルサービスを構成するワークロードの可用性とパフォーマンスを維持する必要があります。特に収益創出は重要です。F5の調査によると、現在、企業の過半数(58%)が収益の半分以上をデジタルサービスから得ています。
また、たとえばパブリッククラウドを事業継続(BC)に利用するケースも考えてみましょう。BCはパブリッククラウドの主要な用途の1つであり、その中核となるのがグローバル規模の実装、すなわちグローバル負荷分散です。フェイルオーバーはアプリケーションデリバリの中核機能です。これをサイト全体に適用することで、リクエストをあるロケーションから別のロケーションへ迅速にリダイレクトできます。企業のデジタルプレゼンスを継続的に利用可能にするというビジネス成果は、こうした技術的対応によって実現します。
どのようにスケールするのか?
この問いへの回答から、アプリケーションデリバリーアーキテクチャを技術的に掘り下げていきます。スケーリングには、垂直(スケールアップ)と水平(スケールアウト)の2つのモデルがあります。
垂直スケーリングは、システムの処理能力を増強することで容量が拡大するという原則に基づいています。このスケーリング方式は、主にモノリシックアプリケーションや自己完結型システムに適しています。インフラストラクチャを除けば、垂直スケーリングにはCPUやRAMの追加、ネットワーク容量の拡張といった物理環境の変更が必要なため、現在ではほとんどの組織がこの方式に依存していません。特にパブリッククラウド環境では、仮想化によって垂直スケーリングを大幅に迅速化できますが、新しい仮想マシンへの移行であっても、ソフトウェアやシステムの移行が必要となり、業務に支障をきたす可能性があります。
水平スケーリングは、利用可能なリソースの総量を増やすことで処理能力を高めるアーキテクチャアプローチです。これは、アプリケーション、サービス、またはシステムの複数のインスタンスに処理能力を分散することで実現します。リソースを移行するのではなく複製するため、現在最も一般的なスケーリング手法です。さらに、水平スケーリングでは、垂直スケーリングよりも多様なアーキテクチャを選択できるため、あらゆるアプリケーションとAPIに適しています。
したがって、最新のアプリケーションデリバリーパターンが水平スケーリングの原則に基づいているのは当然です。
アプリケーションデリバリーのパターン
単に「水平スケーリング」を選択すれば、それで検討が終わるわけではありません。
この方針を選択した後(通常はデフォルトで選択されます)、実装アーキテクチャについては、さらに別の要素も考慮して決定する必要があります。この判断を行う最も簡単な方法は、書籍『スケールキューブ』で説明されている「The Art of Scalability」の観点から検討することです。
簡単に言えば、スケールキューブにはx、y、zの3つの軸があります。それぞれがロードバランシングのアーキテクチャパターンに対応しています。各パターンは、アプリケーションやAPIの種類に応じて、パフォーマンスと可用性に関する特定の成果を達成するのに適しています。
デジタルサービスでは、パフォーマンスとリソース消費を同時に最適化するため、複数のパターンを組み合わせたアーキテクチャが採用される可能性があります。このアプローチには、すべてのコンポーネント、その相互作用、ユーザーからアプリケーションへ、そしてユーザーへ戻るリクエストの流れを考慮するシステム思考が必要です。
X軸スケール
X軸パターンは、最も基本的なパターンです。水平方向の複製を基盤とし、処理の大部分は負荷分散アルゴリズムによって実行されます。最もシンプルなパターンであり、私が「Plain Old Load Balancing(POLB)」と呼ぶ構成になります。
このように呼ぶのは、アーキテクチャが単純であり、アプリケーション層でリクエストやレスポンスを処理する最新のロードバランサーの高度な機能をまったく活用していないためです。
このパターンでは、アプリケーションを複製し、設定された負荷分散アルゴリズムの判定に基づいて、リクエストをいずれかのインスタンスに転送します。
このパターンはTCP(レイヤー4)と併用されることが多いため、HTTP(レイヤー7)の検査に依存する他のパターンよりもパフォーマンス面で優れています。主に、接続をプロキシするのではなく相互に結合できるため、最初の接続後はロードバランサーが実質的にネットワークホップとして機能します。その結果、全体的なパフォーマンスは向上しますが、最初の接続後にロードバランサーがリクエストやレスポンスを検査したり、それらに対して処理を実行したりすることはできなくなります。X軸アーキテクチャは可用性の確保に優れ、高いパフォーマンスを発揮できるため、ファイアウォールやアプリケーションゲートウェイなどのインフラストラクチャおよびセキュリティサービスのスケーリングによく使用されます。
従来型のさまざまなアプリケーション(モノリス、3層Web、クライアントサーバー)は、最新のアプリケーションデリバリーアーキテクチャで活用できる、より独立したコンポーネントに分割されることが少ないため、このパターンを使用してスケーリングされる傾向があります。
Y軸スケーリング
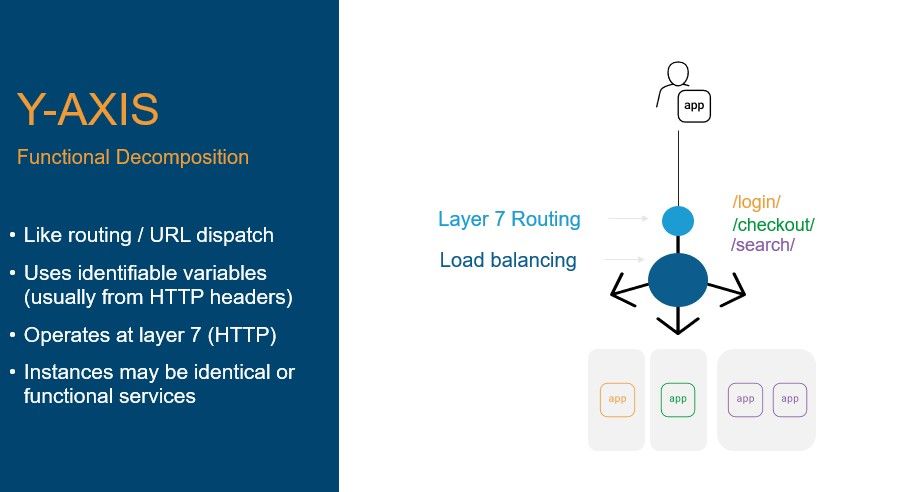
このパターンは機能分解に基づき、アプリケーションデリバリのアプリケーション層(レイヤー7)の機能を活用して、システム全体ではなく機能単位でスケールします。Y軸パターンは、レイヤー7ルーティングがアプリケーションデリバリアーキテクチャの主要な手段となる最初のパターンです。
一般に、yおよびzベースのパターンでは、レイヤー7ルーティングを利用してプールを選択し、その後、負荷分散アルゴリズムを使用して特定のリソースを選択します。これは、レイヤー7ルーティングを使用しない基本的なxパターンとは異なります。
このパターンは、通常はHTTPであるレイヤー7での動作を前提とし、何らかの変数を使用して、アプリケーションまたはサービスの特定のインスタンスにトラフィックを分散します。たとえば、URI内にパターン「/login」が見つかった場合、ロードバランサーは、ログイン要求のみを処理するアプリケーションインスタンスのプールから、設定された負荷分散アルゴリズムに基づいてインスタンスを選択します。変数には、リクエストヘッダーまたはリクエストペイロード内の任意の値を使用できます。これにより、エージェントベースのルーティング、APIルーティング、コンテンツベースのルーティング(画像、スクリプトなど)が可能になります。
アプリケーションインスタンスは複製である場合があります。これは、リクエスト内の変数によって識別できるアプリケーションの利用状況に偏りがある場合によく見られます。たとえば、ログイン機能とチェックアウト機能は、URI、HTTPヘッダー内の値、またはリクエストペイロード内の値に基づいて、リクエストから判別できます。Y軸パターンを適用すると、従来型アプリケーションを機能単位でスケールできます。これにより、他の機能に期待されるパフォーマンスを維持しながら、利用量の多い機能の処理により多くのリソースを割り当てられるため、リソース利用効率が向上します。
従来型アプリケーションを機能別にスケールするためのY軸パターンは、現在ではアプリケーションを機能別に分割するマイクロサービスが普及する以前から使用されていました。Y軸パターンは今もマイクロサービスに適用でき、実際に現在のIngress Controllerで実装されています。HTTP(レイヤー7)の構成要素に依存するAPIにもこのパターンを適用できるため、APIゲートウェイがこの基本パターンを活用しているのも当然だと、鋭い読者ならお気づきでしょう。
このパターンは、eBayによって広く普及しました。Web 2.0の黎明期のことです。当時のスケーラビリティアーキテクチャでは、機能を個別のアプリケーションプールに分割していました。販売機能、入札機能、検索機能は、それぞれ異なるアプリケーションサーバー群で処理されていました。合計で約16,000台のアプリケーションサーバーが、220の異なるプールに編成されていました。これにより、各プールを、その機能に対する需要とリソース消費量に応じて個別にスケールできました。さらに、リソースの依存関係を分離して合理化することも可能になりました。たとえば、販売プールが通信する必要があるのは、バックエンドリソースのうち比較的少数のサブセットだけでした。
y軸パターンは、画像などのコンテンツリクエストを1つのリソースプールに、その他の種類のコンテンツリクエストを別のプールに振り分けるためにも使用できます。
y軸を使用して負荷を分散すると、デジタルサービスの各コンポーネントを個別にスケールできるため、x軸パターンよりもはるかに効率的にリソースを利用できます。また、サービス層またはアプリケーション層で構成を最適化できます。具体的には、Webサーバーまたはアプリサーバーの特定の変数を調整して所定のコンテンツタイプに最適化することで、パフォーマンスを向上できる可能性があります。
Z軸スケーリング
Z軸パターンは、ソーシャルメディアやインターネット全体の爆発的な成長に対応する必要性から普及しました。基本的には、Y軸スケーリングパターンに追加のセグメンテーションを適用したもので、通常はユーザー名やデバイス識別子などの特定の変数に基づいて分割します。
このパターンでは、データシャーディングから派生した手法を用いて、アーキテクチャを差別化できます。
“データベースシャード(単にシャードとも呼ばれます)とは、データベースまたは検索エンジン内のデータを水平方向に分割したものです。負荷を分散するため、各シャードは個別のデータベースサーバーインスタンスに保持されます。データベース内の一部のデータはすべてのシャードに存在しますが、単一のシャードにのみ存在するデータもあります。”
Wikipedia1
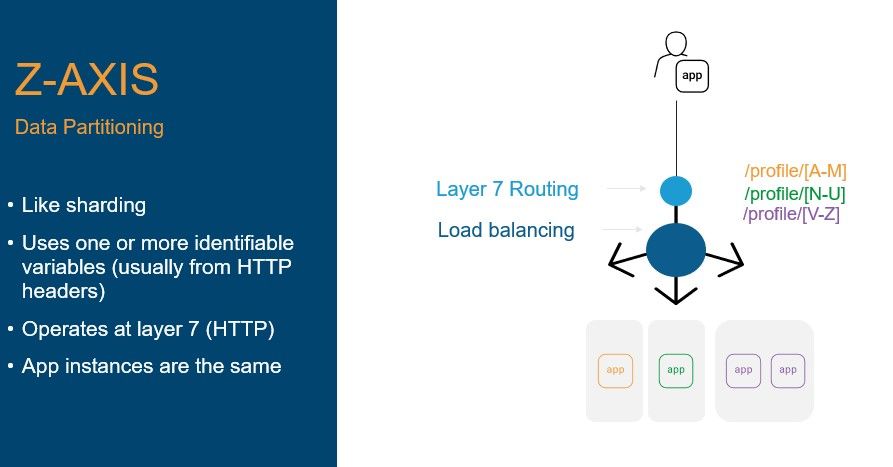
このパターンでは、データベースで用いられる原則を適用し、リクエストに含まれる特定のデータに基づいてリクエストを分散します。データレイヤーのボトルネックへの対処を支援するほか、データ主権に関する規則への準拠を確保する手段としても利用できます。識別可能で、通常は一意の変数を使用して、水平スケーリングされたリソースプール全体にリクエストをルーティングします。このパターンは通常、特定のサービスやアプリケーションに対する大量のリクエストを処理する場合など、高いスループットが必要なときに使用されます。
Z軸パターンは、数百万台に及ぶこともあるエッジデバイスやIoTデバイスの管理に特に有用です。デバイス識別子を基準にリクエストをシャーディングすることで、データ転送速度を大幅に向上できます。構成情報をリモート環境(クラウドまたはデータセンター)に保存するデバイスでは、このデータがデバイス固有であり、安全にシャーディングできるため、特に効果的です。
高負荷時のデータアクセスはパフォーマンスを大幅に低下させる可能性があるため、このパターンはパフォーマンスの向上につながる傾向があります。データアクセスをより多くのインスタンスに分散することで負荷が軽減され、それに伴ってパフォーマンスも向上します。ただし、データの整合性に細心の注意を払う必要があり、共有データのシャーディングに使用すると、一貫性の問題が生じる可能性があります。Metaはシャーディングへの注目を高めました。これは、全体的なアーキテクチャの一環としてサービスシャーディングを開発した際のことです。高いパフォーマンスとスケーラビリティを備えたアプリケーションデリバリーアーキテクチャの開発に細心の注意を払った同社の取り組みは、より大規模なアーキテクチャ内でアプリケーションデリバリーを正式な階層として位置付けることにより、大きなメリットを得られることを示す好例です。
非プライマリデータソースにアクセスするサービスでは、z軸パターンにより、システム全体のデータ品質に大きな影響を与えることなく、スループットを向上できます。このアプローチでは、インスタンスレベルでのデータコネクターの構成とアプリケーションデリバリーのルーティングを組み合わせて適切なデータソースが使用されるようにするため、アプリケーションまたはAPIの特定のインスタンスをデータソースに関連付けるコードを追加する必要性が軽減されます。
スケーリングの鍵はアプリケーションデリバリーアーキテクチャ
デジタルサービスが提供される今日、単一のアプリデリバリーパターンだけで、高性能かつ信頼性の高いデジタルサービスを設計することはまれです。その理由は、デジタルサービス自体が複雑であることに加え、デバイス、人、ソフトウェアにまで及ぶ「ユーザー」がますます多様化しているためです。
したがって、アーキテクチャの観点から、デジタルサービス全体でアプリケーションデリバリーパターンを最適に活用し、ユーザーに最適なエクスペリエンスを提供する方法を検討します。
デジタルサービスを構成するサービスやアプリケーションによって大きく異なるため、アーキテクチャソリューションに「正解」や「不正解」はありません。ただし、ロードバランシングアルゴリズムのみに基づくべきではありません。
実際、ここまでアルゴリズムの選択には触れていません。これは、ロードバランシングパターン内で負荷をどのように分散するかよりも、特定のアプリやAPIに適したアーキテクチャを選択することの方が重要だからです。
これは、アプリケーションデリバリを専門分野として発展させている要因の1つです。今日のアプリケーションデリバリとセキュリティの活用および実装は、単なるWebサーバーのスケーリングをはるかに超えています。その実装は、パフォーマンスや可用性に影響を及ぼし、最終的にはビジネス成果を左右する可能性があります。そのため、組織にとって、アプリケーションデリバリを設計ツール群の中の戦略的なアーキテクチャツールとして捉えることが重要です。
スケールを実現するうえで、ロードバランシングは今なお中核となる技術要件です。アプリケーションデリバリーのパターンと、そこでロードバランシングがどのように活用されるかを理解することで、デジタルサービスのスケールとパフォーマンスを考慮したアーキテクチャ設計について、より的確な視点を得られます。特に、デジタルサービスがハイブリッド構成となり、API、モダンアプリ、従来型アプリが混在する可能性が高い場合に重要です。
脚注