Sie sind ein moderner Platform-Ops- oder DevOps-Engineer. Sie nutzen eine Sammlung von Open-Source-Tools (und möglicherweise auch einige kommerzielle Tools), um neue Anwendungen und Container für Ihr Entwicklungsteam zu testen, bereitzustellen und zu verwalten. Sie haben sich für Kubernetes entschieden, um diese Container und Pods in Entwicklungs-, Test-, Staging- und Produktionsumgebungen auszuführen. Sie setzen auf die Architekturen und Konzepte von Microservices, und größtenteils funktioniert das ziemlich gut. Allerdings sind Sie auf diesem Weg auch auf einige Hindernisse gestoßen.
Wie können Sie beispielsweise beim Aufbau und bei der Einführung neuer Cluster, Dienste und Anwendungen diese neuen Ressourcen einfach in die Produktionsumgebung integrieren oder dorthin migrieren, ohne dass dabei Datenverkehr verloren geht? Herkömmliche Netzwerk-Appliances müssen neu geladen oder neu gestartet werden, wenn Konfigurationsänderungen an DNS-Einträgen, Load Balancern, Firewalls und Proxys vorgenommen werden. Diese Anpassungen lassen sich nicht ohne Ausfallzeiten vornehmen, da für die Aktualisierung von DNS-, Load-Balancer- und Firewall-Regeln eine „Dienstunterbrechung“ oder ein „Wartungsfenster“ erforderlich ist. Meistens müssen Sie ein ungeliebtes Service-Ticket einreichen und darauf warten, dass ein anderes Team die Änderungen genehmigt und durchführt.
Wartungsfenster können Ihr Team ausbremsen, die Anwendungsbereitstellung ins Stocken bringen und Sie zu dem Ausruf veranlassen: „Es muss doch einen besseren Weg geben, den Datenverkehr zu verwalten!“ Sehen wir uns also eine Lösung an, mit der Sie wieder auf die Überholspur kommen.
Aktiv-Aktiv-Lastverteilung über mehrere Cluster
Wenn Sie mehrere Kubernetes-Cluster betreiben, empfiehlt es sich, den Datenverkehr gleichzeitig an beide Cluster weiterzuleiten. Noch besser ist es, den Datenverkehr mithilfe von A/B-, Canary- oder Blue-Green-Verfahren aufzuteilen und einen kleinen Prozentsatz Ihres Datenverkehrs testweise weiterzuleiten. Hierzu können Sie NGINX Plus mit ngx_http_split_clients_module.
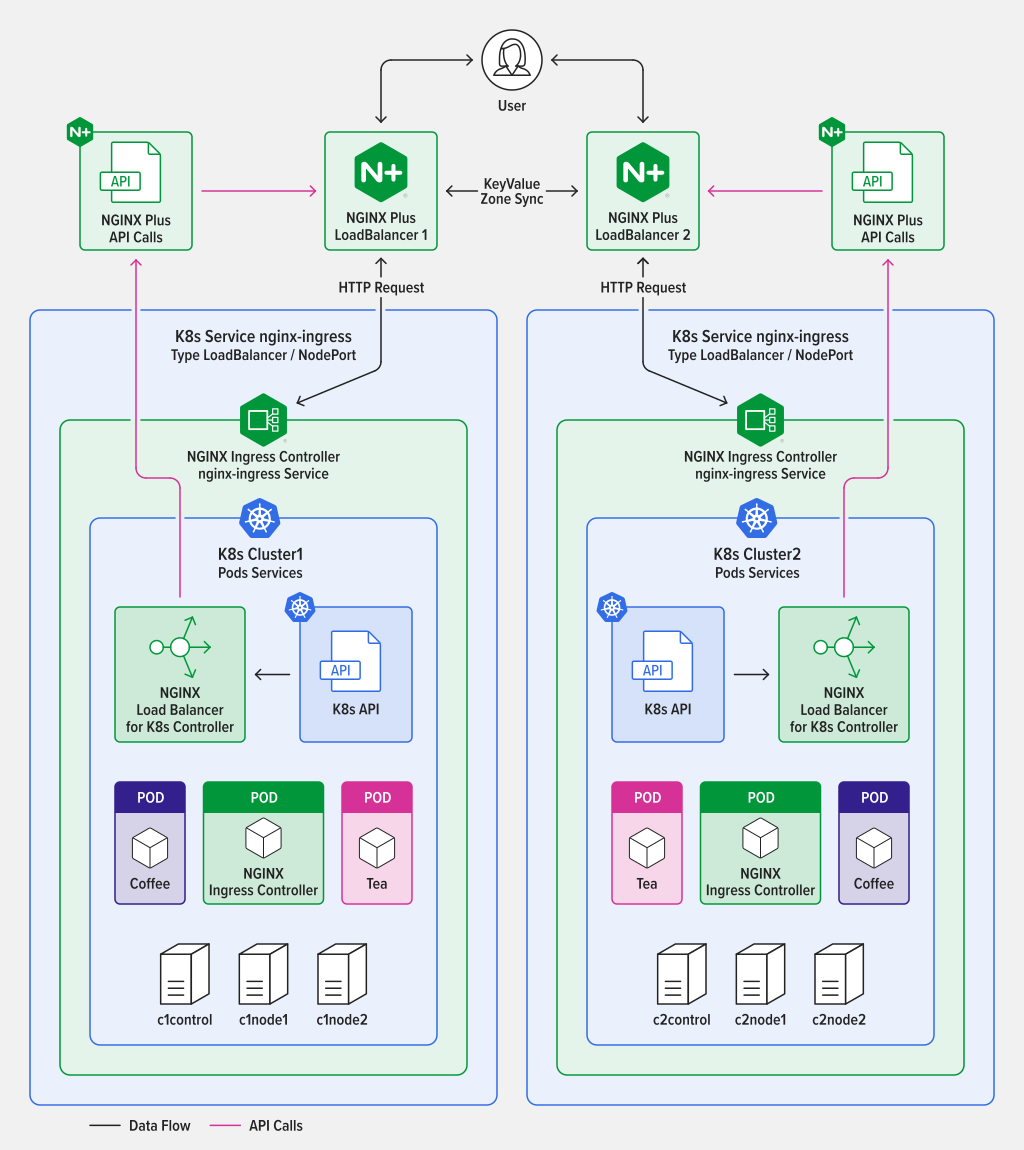
Das HTTP-Split-Clients-Modul wurde von NGINX Open Source entwickelt und ermöglicht es, Anfragen anhand eines Schlüssels in einem bestimmten Verhältnis zu verteilen. In diesem Anwendungsfall sind die Cluster die „Upstreams“ von NGINX. Wenn also Clientanfragen eingehen, wird der Datenverkehr auf zwei Cluster aufgeteilt. Als Schlüssel zur Zuordnung der Clientanfrage kann jede verfügbare NGINX-Clientvariable $variable verwendet werden. Um dies jedoch für jede Anfrage zu steuern, verwenden Sie die Variable $request_id. Dabei handelt es sich um eine eindeutige Nummer, die NGINX jeder eingehenden Anfrage zuweist.
Um die Aufteilungsverhältnisse zu konfigurieren, legen Sie fest, welcher Prozentsatz an den jeweiligen Cluster weitergeleitet werden soll. In diesem Beispiel verwenden wir K8s Cluster1 als „großen Cluster“ für die Produktion und Cluster2 als „kleinen Cluster“ für Vorproduktionstests. Wenn Sie einen kleinen Cluster für das Staging verwenden, könnten Sie ein Verhältnis von 90:10 festlegen und 10 % Ihres Datenverkehrs auf dem kleinen Cluster testen. So können Sie sicherstellen, dass alles funktioniert, bevor Sie neue Änderungen auf dem großen Cluster bereitstellen. Falls Ihnen das zu riskant erscheint, können Sie das Verhältnis auf 95:5 ändern. Grundsätzlich können Sie jedes beliebige Verhältnis zwischen 0 und 100 % wählen.
Für den meisten Echtzeit-Produktivdatenverkehr empfiehlt sich wahrscheinlich ein Verhältnis von 50:50, bei dem Ihre beiden Cluster gleich groß sind. Sie können jedoch problemlos andere Verhältnisse festlegen, etwa abhängig von der Clustergröße oder anderen Faktoren. Ebenso können Sie das Verhältnis einfach auf 0:100 (oder 100:0) setzen und einen gesamten Cluster ohne Ausfallzeit aktualisieren, patchen, reparieren oder sogar ersetzen. Lassen Sie NGINX split_clients die Anfragen an den aktiven Cluster weiterleiten, während Sie die Probleme auf dem anderen beheben.
# Nginx Multi Cluster Load Balancing
# HTTP Split Clients Configuration for Cluster1:Cluster2 ratios
# Provide 100, 99, 50, 1, 0% ratios  (add/change as needed)
# Based on
# https://www.nginx.com/blog/dynamic-a-b-testing-with-nginx-plus/
# Chris Akker – Jan 2024
#

split_clients $request_id $split100 {
   * cluster1-cafe;                     # All traffic to cluster1
   }

split_clients $request_id $split99 {
   99% cluster1-cafe;                   # 99% cluster1, 1% cluster2
   * cluster2-cafe;
   }

split_clients $request_id $split50 {
   50% cluster1-cafe;                   # 50% cluster1, 50% cluster2
   * cluster2-cafe;
   }

split_clients $request_id $split1 {
   1.0% cluster1-cafe;                  # 1% to cluster1, 99% to cluster2
   * cluster2-cafe;
   }

split_clients $request_id $split0 {
   * cluster2-cafe;                     # All traffic to cluster2
   }

# Choose which cluster upstream based on the ratio

map $split_level $upstream {
   100 $split100;
   99 $split99;
   50 $split50;
   1.0 $split1;
   0 $split0;
   default $split50;
}
Sie können die obige Konfiguration ergänzen oder bearbeiten, um sie an die von Ihnen benötigten Verhältnisse anzupassen (z. B. 90:10, 80:20, 60:40 usw.).
Hinweis: NGINX verfügt außerdem über ein Split-Clients-Modul für TCP-Verbindungen im Stream-Kontext, das für Nicht-HTTP-Datenverkehr verwendet werden kann. Dabei wird der Datenverkehr anhand neuer TCP-Verbindungen statt anhand von HTTP-Anfragen aufgeteilt.
NGINX Plus Schlüssel-Wert-Speicher
Die nächste Funktion, die Sie verwenden können, ist der Schlüssel-Wert-Speicher. Dabei handelt es sich um ein Schlüssel-Wert-Objekt in einer gemeinsam genutzten Speicherzone von NGINX, das sich für viele verschiedene Anwendungsfälle der Datenspeicherung einsetzen lässt. Hier verwenden wir es, um den im vorherigen Abschnitt erwähnten Wert für das Aufteilungsverhältnis zu speichern. Mit NGINX Plus können Sie jeden Schlüssel-Wert-Eintrag ändern, ohne NGINX neu zu laden. Dadurch können Sie diesen Aufteilungswert über einen API-Aufruf ändern und so die dynamische Aufteilungsfunktion realisieren.
In unserem Beispiel sieht das so aus:
{“cafe.example.com”:90}
Dieser KeyVal-Eintrag lautet:
Der Schlüssel ist der Hostname „cafe.example.com“
Der Wert für das Aufteilungsverhältnis ist „90“
Anstatt das Aufteilungsverhältnis in den NGINX-Konfigurationsdateien fest zu codieren, können Sie den Schlüssel-Wert-Speicher verwenden. Dadurch entfällt das Neuladen von NGINX, das zum Ändern eines statischen Aufteilungswerts in NGINX erforderlich wäre.
In diesem Beispiel ist NGINX so konfiguriert, dass für das Aufteilungsverhältnis 90:10 verwendet wird, wobei der große Cluster1 90 % und der kleine Cluster2 die verbleibenden 10 % erhält. Da es sich hierbei um einen Schlüssel-Wert-Eintrag handelt, können Sie dieses Verhältnis über die NGINX Plus API dynamisch ändern, ohne die Konfiguration neu laden zu müssen! Das Split-Clients-Modul verwendet den neuen Verhältniswert unmittelbar nach der Änderung, also bereits bei der nächsten Anfrage.
Erstellen Sie den KV-Datensatz zunächst mit einem Verhältnis von 50:50:
Fügen Sie dem KeyValue-Speicher einen neuen Eintrag hinzu, indem Sie einen API-Befehl an NGINX Plus senden:
curl -iX POST -d '{"cafe.example.com":50}' http://nginxlb:9000/api/8/http/keyvals/split
Ändern Sie den KV-Eintrag und stellen Sie das Verhältnis auf 90/10 um:
Ändern Sie das KeyVal-Aufteilungsverhältnis auf 90, indem Sie den KeyVal-Datensatz im Arbeitsspeicher mit einer HTTP-PATCH-Methode aktualisieren:
curl -iX PATCH -d '{"cafe.example.com":90}' http://nginxlb:9000/api/8/http/keyvals/split
Anschließend bestätigt das Team für Vorproduktionstests, dass der neue Anwendungscode einsatzbereit ist. Sie stellen ihn im großen Cluster1 bereit und ändern das Verhältnis auf 100 %. Dadurch wird der gesamte Datenverkehr sofort an Cluster1 weitergeleitet und Ihre neue Anwendung geht ohne jegliche Beeinträchtigung des Datenverkehrs „live“ – ohne Dienstausfälle, Wartungsfenster, Neustarts, Neuladevorgänge oder eine Vielzahl von Tickets. Sie benötigen lediglich einen API-Aufruf, um dieses Aufteilungsverhältnis zu einem von Ihnen gewählten Zeitpunkt zu ändern.
Da der Wechsel von 90 % auf 100 % so einfach ist, können Sie das Verhältnis natürlich ebenso problemlos von 100:0 auf 50:50 (oder sogar 0:100) ändern. So können Sie einen betriebsbereiten Backup-Cluster vorhalten oder Ihre Cluster mit neuen Ressourcen horizontal skalieren. Sie können sogar einen komplett neuen Cluster mit der neuesten Software, Hardware und den neuesten Software-Patches aufbauen, die Anwendung bereitstellen und den Datenverkehr nach und nach migrieren, ohne dass dabei auch nur eine einzige Verbindung unterbrochen wird!
Anwendungsfälle
Durch die Verwendung des HTTP-Moduls zur Client-Aufteilung mit dem dynamischen Schlüssel-Wert-Speicher lassen sich die folgenden Anwendungsfälle umsetzen:
- Aktiv-Aktiv-Lastverteilung – Zur Lastverteilung auf mehrere Cluster.
- Aktiv-Passiv-Lastverteilung – Für die Lastverteilung auf Primär-, Backup- und Disaster-Recovery-Cluster sowie entsprechende Anwendungen.
- A/B-, Blue-Green- und Canary-Tests – Für neue Kubernetes-Anwendungen.
- Horizontale Clusterskalierung – Fügt dem Cluster weitere Ressourcen hinzu und ändert das Verhältnis, sobald Sie bereit sind.
- Unterbrechungsfreie Cluster-Upgrades – Möglichkeit, einen Cluster zu verwenden, während der andere aktualisiert, gepatcht oder repariert wird.
- Sofortige Ausfallsicherung – Wenn bei einem Cluster ein schwerwiegendes Problem auftritt, können Sie das Verhältnis so ändern, dass Ihr anderer Cluster verwendet wird.
Konfigurationsbeispiele
Hier ist ein Beispiel für die Schlüssel-Wert-Konfiguration:
# Define Key Value store, backup state file, timeout, and enable sync
keyval_zone zone=split:1m state=/var/lib/nginx/state/split.keyval timeout=365d sync;

keyval $host $split_level zone=split;
Und dies ist ein Beispiel für die Konfiguration der Anwendung cafe.example.com:
# Define server and location blocks for cafe.example.com, with TLS
server {
   listen 443 ssl;
   server_name cafe.example.com;

   status_zone https://cafe.example.com;

   ssl_certificate /etc/ssl/nginx/cafe.example.com.crt;
   ssl_certificate_key /etc/ssl/nginx/cafe.example.com.key;

   location / {
   status_zone /;

   proxy_set_header Host $host;
   proxy_http_version 1.1;
   proxy_set_header "Connection" "";
   proxy_pass https://$upstream;   # traffic split to upstream blocks

   }

# Define 2 upstream blocks – one for each cluster
# Servers managed dynamically by NLK, state file backup

# Cluster1 upstreams

upstream cluster1-cafe {
   zone cluster1-cafe 256k;
   least_time last_byte;
   keepalive 16;
   #servers managed by NLK Controller
   state /var/lib/nginx/state/cluster1-cafe.state;
}

# Cluster2 upstreams

upstream cluster2-cafe {
   zone cluster2-cafe 256k;
   least_time last_byte;
   keepalive 16;
   #servers managed by NLK Controller
   state /var/lib/nginx/state/cluster2-cafe.state;
}
Die IP-Adressen und Ports der Upstream-Server werden von NGINX Loadbalancer for Kubernetes verwaltet, einem neuen Controller, der auch die NGINX Plus API verwendet, um NGINX Plus dynamisch zu konfigurieren. Weitere Informationen finden Sie im nächsten Abschnitt.
Sehen wir uns den zeitlichen Verlauf des aufgeteilten HTTP-Datenverkehrs mit Grafana an, einem beliebten Tool für Monitoring und Visualisierung. Mit dem NGINX Prometheus Exporter (basierend auf njs) exportieren Sie alle Ihre NGINX Plus-Metriken, die anschließend von Grafana erfasst und grafisch dargestellt werden. Einzelheiten zur Konfiguration von Prometheus und Grafana finden Sie hier.
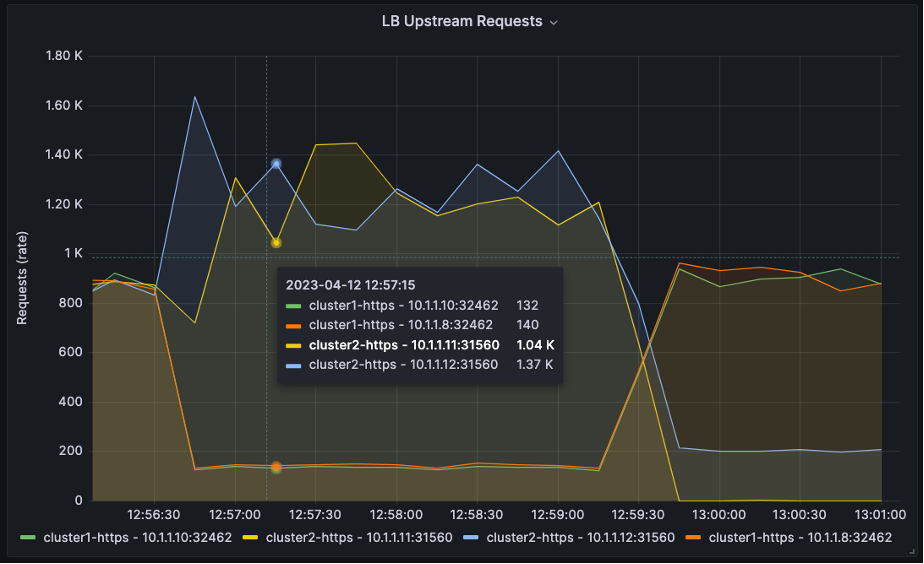
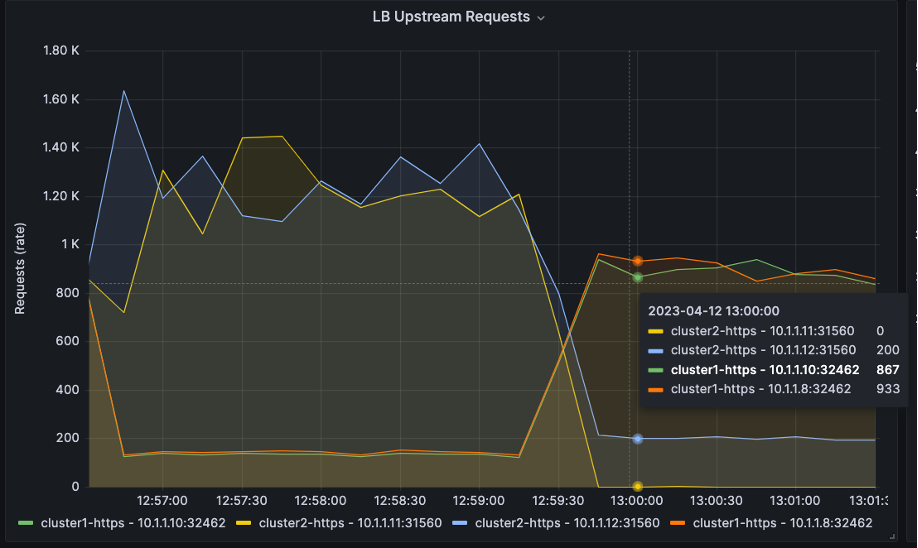
Im Diagramm sind vier Upstream-Server dargestellt: zwei für Cluster1 und zwei für Cluster2. Wir verwenden ein Tool zur Generierung von HTTP-Last, um HTTP-Anfragen zu erzeugen und an NGINX Plus zu senden.
In den drei folgenden Diagrammen sehen Sie, dass das Verteilungsverhältnis zu Beginn des Diagramms bei 50:50 liegt.
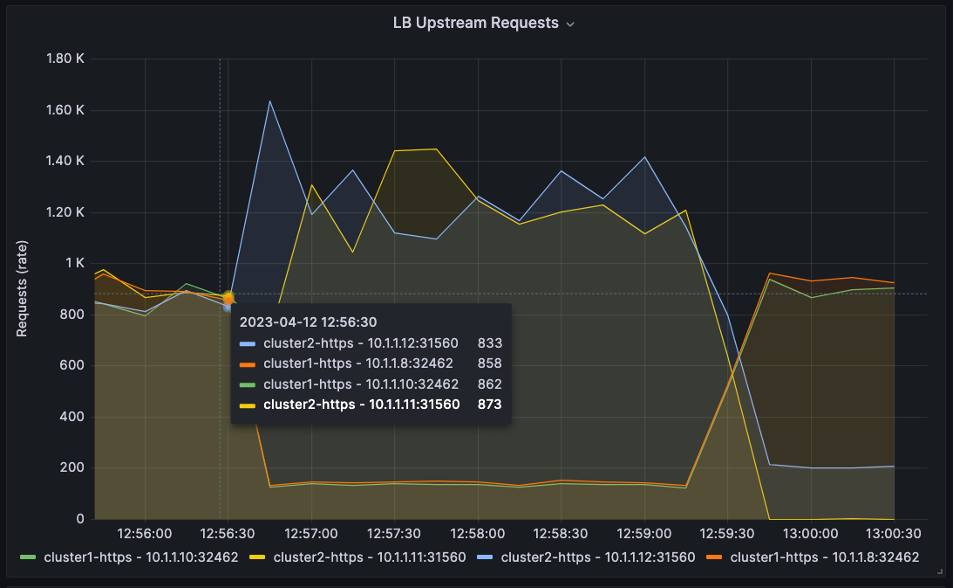
Anschließend ändert sich das Verhältnis um 12:56:30 Uhr auf 10:90.
Dann ändert sich das Verhältnis um 13:00:00 Uhr auf 90:10.
Funktionierende Konfigurationen für Prometheus und Grafana finden Sie im GitHub-Repository „NGINX Loadbalancer for Kubernetes“.
Dynamische HTTP-Upstreams: NGINX Loadbalancer für Kubernetes
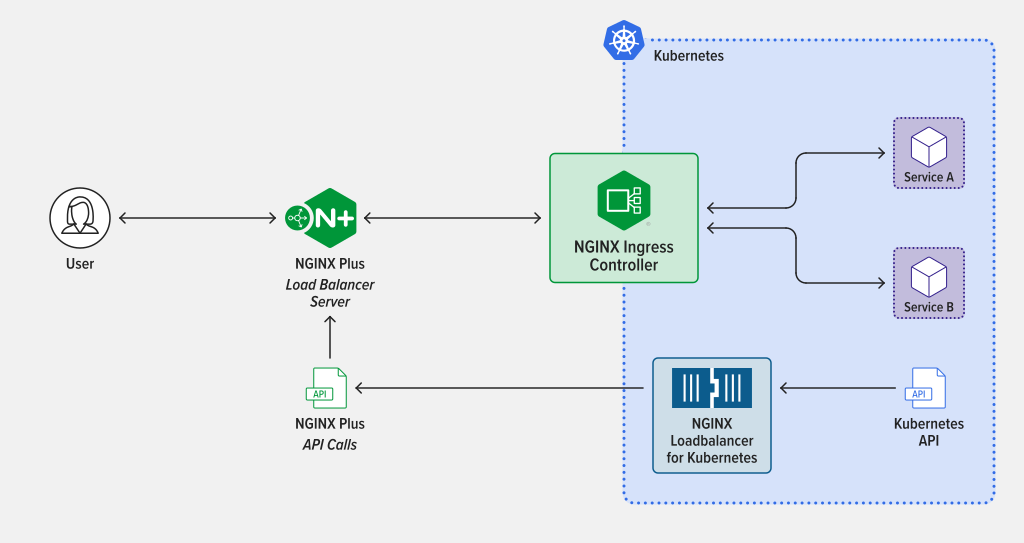
Sie können die statische NGINX-Upstream-Konfiguration mithilfe der NGINX Plus API und des NGINX Loadbalancer for Kubernetes-Controllers in dynamische Cluster-Upstreams umwandeln. Dieses kostenlose Projekt ist ein Kubernetes-Controller, der den NGINX Ingress Controller überwacht und automatisch eine externe NGINX Plus-Instanz aktualisiert, die für den TCP/HTTP-Lastenausgleich konfiguriert ist. Das Projekt ist sehr geradlinig konzipiert und lässt sich einfach installieren und betreiben. Mit dieser Lösung können Sie den TCP/HTTP-Lastenausgleich in Kubernetes-Umgebungen implementieren und sicherstellen, dass neue Anwendungen und Dienste sofort erkannt werden und für den Datenverkehr verfügbar sind – ohne dass ein Neuladen erforderlich ist.
Architektur und Ablauf
NGINX Loadbalancer for Kubernetes wird innerhalb eines Kubernetes-Clusters ausgeführt. Er ist bei Kubernetes registriert, um den Dienst des NGINX Ingress Controllers (nginx-ingress) zu überwachen. Wenn sich die Ingress-Controller ändern, erfasst NGINX Loadbalancer for Kubernetes die IP-Adressen der Worker und die TCP-Portnummern von NodePort und sendet anschließend die IP-Adressen und Ports über die NGINX Plus API an NGINX Plus.
Die NGINX-Upstream-Server werden aktualisiert, ohne dass ein Neuladen erforderlich ist, und NGINX Plus verteilt den Datenverkehr auf die richtigen Upstream-Server und Kubernetes-NodePorts. Zusätzliche NGINX Plus-Instanzen können hinzugefügt werden, um Hochverfügbarkeit zu erreichen.
Ein Einblick in den NGINX Loadbalancer für Kubernetes im Einsatz
Im folgenden Screenshot sind zwei Fenster zu sehen, die den bereitgestellten NGINX Loadbalancer für Kubernetes bei der Arbeit zeigen:
- Diensttyp –
LoadBalancerfürnginx-ingress - Externe IP-Adresse – Stellt eine Verbindung zu den NGINX Plus-Servern her
- Ports – NodePort ordnet 443:30158 den entsprechenden NGINX-Upstream-Servern zu (wie im NGINX Plus Echtzeit-Dashboard dargestellt)
- Protokolle – Zeigt an, dass der NGINX Loadbalancer für Kubernetes erfolgreich Daten an NGINX Plus sendet
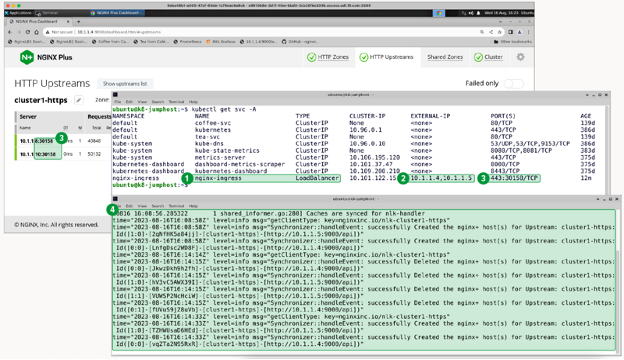
Hinweis: In diesem Beispiel lauten die Kubernetes-Worker-Knoten 10.1.1.8 und 10.1.1.10
NGINX Plus-Sicherheitsfunktionen hinzufügen
Da immer mehr in Kubernetes ausgeführte Anwendungen dem offenen Internet zugänglich gemacht werden, sind Sicherheitsmaßnahmen unerlässlich. Glücklicherweise bietet NGINX Plus Sicherheitsfunktionen auf Enterprise-Niveau, mit denen sich eine mehrschichtige Sicherheitsarchitektur nach dem Defense-in-Depth-Prinzip aufbauen lässt.
Wenn NGINX Plus Ihren Clustern vorgeschaltet ist und die Funktion split_clients ausführt, können Sie diese Präsenz nutzen und einige hilfreiche Sicherheitsfunktionen hinzufügen. Im Folgenden finden Sie einige Funktionen von NGINX Plus, mit denen sich die Sicherheit verbessern lässt, sowie Links und Verweise auf weitere Dokumentationen, die Sie bei der Konfiguration, beim Testen und bei der Bereitstellung unterstützen.
- IP-Sperr-/Zulassungslisten – Steuern den Zugriff anhand der Quell-IP-Adresse. Eine Konfigurationsanleitung zur Verwendung des Schlüssel-Wert-Speichers von NGINX Plus für dynamische IP-Sperr-/Zulassungslisten mithilfe der Plus API finden Sie auf der Seite Dynamisches Sperren von IP-Adressen in der NGINX-Dokumentation.
- Ratenbegrenzung – Steuert die Anzahl der TCP-Verbindungen und HTTP-Anfragen sowie die Bandbreitennutzung für Anwendungen, API-Endpunkte und Mediendownloads. Weitere Informationen zur Ratenbegrenzung mit NGINX finden Sie unter Beschränken des Zugriffs auf über Proxy bereitgestellte HTTP-Ressourcen in der NGINX-Dokumentation sowie in den Blogbeiträgen Ratenbegrenzung mit NGINX und NGINX Plus und Dynamische Bandbreitenbegrenzung mit dem Schlüssel-Wert-Speicher von NGINX Plus.
- Dynamisches GeoIP2-Modul – Erfasst Standortmetadaten anhand der Quell-IP-Adresse. Weitere Informationen hierzu finden Sie auf der Seite Einschränken des Zugriffs nach geografischem Standort in der NGINX-Dokumentation.
- JWT- und OpenID-Connect-Modul (OIDC) – Steuert den Benutzerzugriff mithilfe branchenüblicher Protokolle. Weitere Informationen hierzu finden Sie auf der Seite „JWT-Authentifizierung einrichten“ in der NGINX-Dokumentation.
- NGINX App Protect – Eine schlanke Web Application Firewall mit geringer Latenz, die vor bestehenden und neuen Bedrohungen schützt.
Legen Sie noch heute los
Wenn Sie mit Netzwerkproblemen am Rand Ihres Kubernetes-Clusters zu kämpfen haben, sollten Sie diese NGINX-Multi-Cluster-Lösung ausprobieren. Testen Sie die Software NGINX Loadbalancer for Kubernetes und teilen Sie uns Ihre Meinung mit. Der Quellcode ist Open Source (unter der Apache-2.0-Lizenz), und sämtliche Installationsanweisungen sind auf GitHub verfügbar.
Wenn Sie uns Feedback geben möchten, hinterlassen Sie einen Kommentar im Repository oder schreiben Sie uns im NGINX Community Slack.
Über den Autor
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.