Redaktion – Dies ist der zweite Teil einer Reihe über Caching mit hoher Kapazität und hoher Verfügbarkeit:
- Gemeinsam genutzte Caches mit NGINX Plus-Cache-Clustern, Teil 1
- Gemeinsam genutzte Caches mit NGINX Plus-Cache-Clustern, Teil 2 (dieser Beitrag)
Wie können Sie mit NGINX oder NGINX Plus einen hochverfügbaren Cache-Cluster mit großer Kapazität aufbauen? Dieser Beitrag beschreibt, wie Sie mit zwei oder mehr NGINX- oder NGINX Plus-Cache-Servern einen hochverfügbaren Cache-Cluster erstellen. (Sofern nicht anders angegeben, gilt die hier beschriebene Methode gleichermaßen für NGINX Open Source und NGINX Plus. Der Kürze halber beziehen wir uns jedoch nur auf NGINX Plus.)
Rückblick – Die Sharded-Cache-Lösung
Im ersten Teil dieser Reihe wurde ein Muster für die Erstellung sehr großer, in Shards aufgeteilter Cache-Cluster beschrieben.
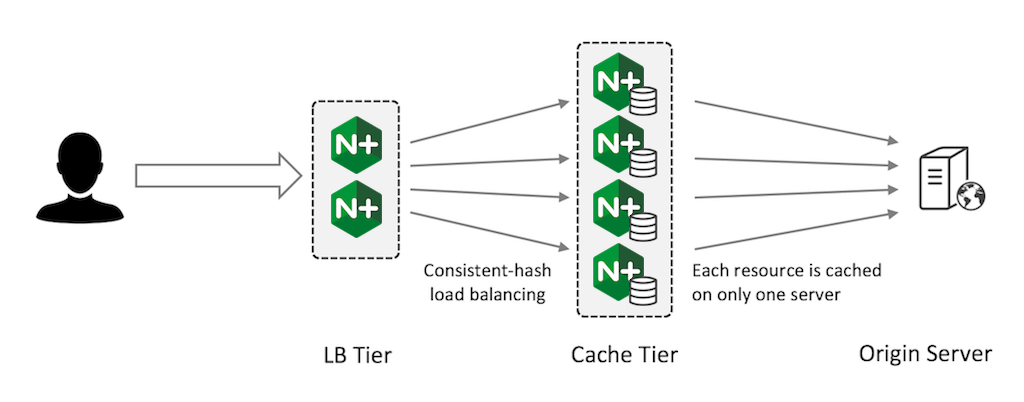
Dieses Muster eignet sich, wenn Sie einen Cache mit sehr großer Kapazität erstellen müssen, der sich nach Bedarf skalieren lässt. Da jede Ressource nur auf einem Server zwischengespeichert wird, ist der Cache nicht vollständig ausfallsicher. Der Lastausgleich mittels konsistentem Hashing stellt jedoch sicher, dass beim Ausfall eines Servers nur dessen Anteil der zwischengespeicherten Inhalte ungültig wird.
Erstellen eines hochverfügbaren Cache-Clusters
Wenn Ihr oberstes Ziel darin besteht, die Anzahl der Anfragen an Ihre Ursprungsserver um jeden Preis zu minimieren, ist die Cache-Sharding-Lösung nicht die beste Option. Stattdessen kann eine Lösung mit sorgfältig konfigurierten primären und sekundären NGINX Plus-Instanzen Ihre Anforderungen erfüllen:
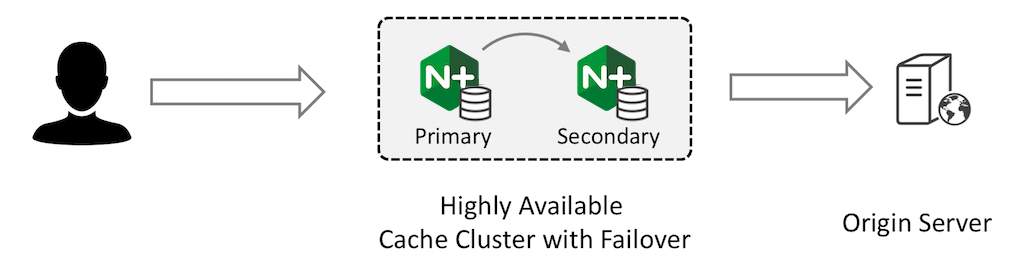
Die primäre NGINX Plus-Instanz empfängt den gesamten Datenverkehr und leitet Anfragen an die sekundäre Instanz weiter. Die sekundäre Instanz ruft die Inhalte vom Ursprungsserver ab und speichert sie im Cache. Die primäre Instanz speichert außerdem die Antwort der sekundären Instanz im Cache und sendet sie an den Client zurück.
Beide Geräte verfügen über vollständig gefüllte Caches, die gemäß den von Ihnen konfigurierten Zeitüberschreitungen aktualisiert werden.
Konfigurieren des primären Cache-Servers
Konfigurieren Sie den primären Cache-Server so, dass er alle Anfragen an den sekundären Server weiterleitet und die Antworten zwischenspeichert. Wie durch den Parameter backup der Direktive server in der Upstream-Gruppe festgelegt, leitet der primäre Server Anfragen direkt an den Ursprungsserver weiter, falls der sekundäre Server ausfällt:
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://secondary;
    }
}

upstream secondary {
    zone secondary 128k;          # for NGINX Plus extended status

    server 192.168.56.11;         # secondary
    server 192.168.56.12 backup;  # origin
}
Konfigurieren des sekundären Cache-Servers
Konfigurieren Sie den sekundären Cache-Server so, dass er Anfragen an den Ursprungsserver weiterleitet und Antworten zwischenspeichert.
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://origin;
    }
}

upstream origin {
    zone origin 128k;            # for NGINX Plus extended status

    server 192.168.56.12;        # origin
}
Hochverfügbarkeit konfigurieren
Abschließend müssen Sie Hochverfügbarkeit (HA) konfigurieren, damit der sekundäre Server bei einem Ausfall des primären Servers den eingehenden Datenverkehr übernimmt. Sobald der primäre Server wieder verfügbar ist, übernimmt er den Datenverkehr erneut.
In diesem Beispiel verwenden wir die Aktiv-Passiv-HA-Lösung für NGINX Plus. Die extern bekannt gegebene virtuelle IP-Adresse lautet 192.168.56.20, und der primäre Cache-Server fungiert als primärer HA-Knoten im Cluster. Wenn Sie NGINX Open Source verwenden, können Sie keepalived oder eine andere HA-Lösung manuell installieren und konfigurieren.
Failover-Szenarien
Zur Erinnerung: Wir möchten einen hochverfügbaren Cache-Cluster erstellen, der auch beim Ausfall eines Cache-Servers weiterarbeitet. Die Last auf dem Ursprungsserver soll weder beim Ausfall eines Cache-Servers noch bei dessen Wiederherstellung steigen, wenn veraltete Inhalte aktualisiert werden müssen.
Angenommen, der primäre Server fällt aus und die NGINX Plus HA-Lösung überträgt die externe IP-Adresse auf den sekundären Server.
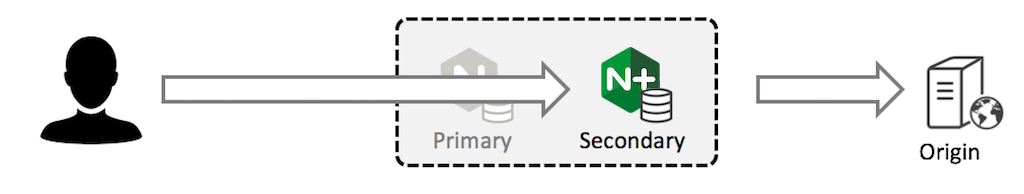
Der sekundäre Cache-Server verfügt über einen vollständigen Cache und arbeitet wie gewohnt weiter. Der Ursprungsserver wird dadurch nicht zusätzlich belastet.
Wenn der primäre Cache-Server wieder verfügbar ist und Client-Datenverkehr empfängt, ist sein Cache veraltet und viele Einträge sind abgelaufen. Der primäre Server aktualisiert seinen lokalen Cache über den sekundären Cache-Server. Da der Cache auf dem sekundären Server bereits auf dem neuesten Stand ist, erhöht sich der Datenverkehr zum Ursprungsserver nicht.
Nehmen wir nun an, dass der sekundäre Cache-Server ausfällt. Der primäre Cache-Server erkennt dies (mithilfe einer Integritätsprüfung, die als Teil der Hochverfügbarkeitslösung konfiguriert ist) und leitet den Datenverkehr direkt an den Backup-Server (den Ursprungsserver) weiter.
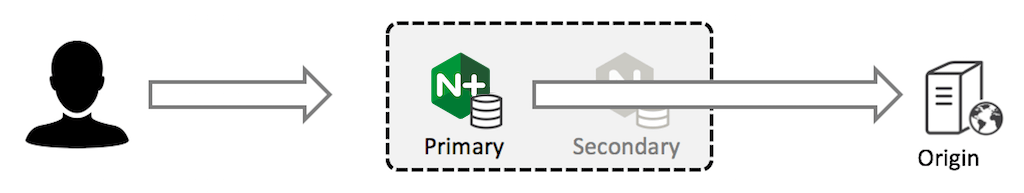
Der primäre Server verfügt über einen vollständigen Cache und arbeitet weiterhin wie gewohnt. Auch hier entsteht keine zusätzliche Last auf dem Ursprungsserver.
Wenn der Sekundärserver wieder verfügbar ist, ist sein Cache veraltet. Er erhält jedoch erst dann Anfragen vom Primärserver, wenn dessen Cache abläuft. Zu diesem Zeitpunkt ist auch die Kopie auf dem Sekundärserver abgelaufen. Obwohl der Sekundärserver Inhalte vom Ursprungsserver anfordern muss, erhöht sich dadurch nicht die Häufigkeit der Anfragen an den Ursprungsserver. Der Ursprungsserver wird dadurch nicht beeinträchtigt.
Testen des Failover-Verhaltens
Um unsere HA-Lösung zu testen, konfigurieren wir den Ursprungsserver so, dass er Anfragen protokolliert und für jede Anfrage die aktuelle Uhrzeit zurückgibt. Das bedeutet, dass sich die Antwort des Ursprungsservers jede Sekunde ändert:
access_log /var/log/nginx/access.log;
location / {
    return 200 "It's now $time_localn";
}
Die primären und sekundären Cache-Server sind bereits so konfiguriert, dass sie Antworten mit dem Statuscode 200 15 Sekunden lang zwischenspeichern. Dadurch wird der Cache in der Regel alle 15 oder 16 Sekunden aktualisiert.
proxy_cache_valid 200 15s;Cache-Verhalten überprüfen
Einmal pro Sekunde senden wir eine HTTP-Anfrage an die hochverfügbare virtuelle IP-Adresse des Cache-Clusters. Die Antwort ändert sich erst, wenn die Caches auf dem primären und dem sekundären Server ablaufen und die Antwort vom Ursprungsserver aktualisiert wird. Dies geschieht alle 15 oder 16 Sekunden.
$ while sleep 1 ; do curl http://192.168.56.20/ ; done
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:19 -0800
It's now 9/Feb/2017:06:35:19 -0800
^C
Wir können auch die Protokolle auf dem Ursprungsserver überprüfen, um zu bestätigen, dass er nur alle 15 oder 16 Sekunden eine Anfrage erhält.
Failover überprüfen
Wir können überprüfen, ob das Failover ordnungsgemäß funktioniert, indem wir entweder den primären oder den sekundären Server anhalten, beispielsweise durch Beenden der nginx-Prozesse. Der Test mit konstanter Last läuft weiter, und die Antwort wird durchgehend zwischengespeichert.
Eine Überprüfung des Zugriffsprotokolls auf dem Ursprungsserver bestätigt, dass dieser nur alle 15 bis 16 Sekunden eine Anfrage erhält – unabhängig davon, welcher der Cache-Server ausfällt oder wieder verfügbar ist.
Zeitpunkt der Cache-Aktualisierungen
Unter stabilen Bedingungen werden die zwischengespeicherten Inhalte normalerweise alle 15 bis 16 Sekunden aktualisiert. Die Inhalte laufen nach 15 Sekunden ab. Bis zum Eingang der nächsten Anfrage, die eine Aktualisierung des Caches auslöst, kann es bis zu 1 Sekunde dauern.
Gelegentlich scheint der Cache langsamer aktualisiert zu werden (zwischen Inhaltsänderungen können bis zu 30 Sekunden liegen). Dies geschieht, wenn der Inhalt des primären Cache-Servers abläuft und dieser zwischengespeicherte Inhalte vom sekundären Server abruft, die ebenfalls kurz vor dem Ablauf stehen. Falls dies ein Problem darstellt, können Sie auf dem sekundären Server ein kürzeres Cache-Timeout konfigurieren.
Zusammenfassung
Die hier beschriebene hierarchische Anordnung von Caches auf zwei oder mehr NGINX-Cache-Servern ist eine effektive Möglichkeit, einen hochverfügbaren Cache-Cluster zu erstellen, der die Last auf den Ursprungsservern minimiert und sie vor Lastspitzen schützt, wenn einer der Cache-Server ausfällt oder wieder verfügbar wird.
Die Gesamtkapazität des Caches ist auf die Kapazität eines einzelnen Cache-Servers begrenzt. Der erste Teil dieser Reihe beschreibt ein alternatives Sharding-Muster für Caches, bei dem ein Cache auf einen Cluster von Cache-Servern verteilt wird. In diesem Fall entspricht die Gesamtkapazität der Summe der Kapazitäten aller Cache-Server. Die Inhalte werden jedoch nicht repliziert, sodass der Ursprungsserver bei Ausfall eines Cache-Servers nicht vor Lastspitzen geschützt ist.
Testen Sie hochverfügbares Caching auf Ihren eigenen Servern – starten Sie noch heute Ihre kostenlose 30-Tage-Testversion oder kontaktieren Sie uns, um Ihre Anwendungsfälle zu besprechen.
Über den Autor

Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.