Im April schrieb ich darüber, warum das alte Modell der Softwaresicherheit nicht mehr funktioniert. In diesem Beitrag ging es um das Problem und die Grundsätze. In diesem geht es um die Maßnahmen, die wir bei F5 ergreifen, um unseren Code abzusichern.
Vor etwa neun Monaten begannen wir damit, modernste KI-Modelle einzusetzen, um unseren eigenen Quellcode systematisch auf Schwachstellen zu untersuchen. Was als erste Erkundung der Möglichkeiten dieser Modelle bei einer realen, produktiv eingesetzten Codebasis begann, hat sich inzwischen zu einer der bedeutendsten Investitionen in unserer Produktorganisation entwickelt. Wir haben eine eigene Infrastruktur aufgebaut, Entwicklungsressourcen aus dem gesamten Unternehmen zusammengezogen und dies auf allen Ebenen der Organisation zur obersten Priorität gemacht.
Mehr als 80 % der Unternehmen der Global Fortune 500 vertrauen auf F5. Wir unterstützen mehr als die Hälfte aller Application-Delivery-Controller-Umgebungen (ADC) weltweit. Alle 15 der 15 größten Banken weltweit, alle 30 der 30 größten US-Geschäftsbanken, alle 10 der 10 größten Versicherungsunternehmen weltweit, alle 10 der 10 größten Telekommunikationsunternehmen weltweit sowie alle 15 der 15 US-Bundesministerien setzen F5 in ihrer Infrastruktur ein.
Wir stellen an uns selbst höhere Ansprüche, weil Unternehmen uns an ihren kritischsten Schnittstellen einsetzen: zwischen ihren Benutzern und Anwendungen sowie ihren Agenten und APIs.
Die Modelle waren anfangs nicht besonders gut. Inzwischen sind sie es.
Als wir im Herbst 2025 diesen Weg einschlugen, waren die uns zur Verfügung stehenden Spitzenmodelle vielversprechend, aber noch eingeschränkt. Sie konnten oberflächliche Probleme erkennen, doch komplexe Codebasen zu analysieren, modulübergreifende Zusammenhänge zu verstehen und echte Sicherheitslücken von Fehlalarmen zu unterscheiden, gelang ihnen nicht zuverlässig.
Die Rate der Fehlalarme war hoch. Sehr hoch.
Wir mussten uns vieles von Grund auf aneignen:
- Wie man ein effektives Testsystem entwickelt
- Wie man Prompts so strukturiert, dass sie genügend Kontext bieten, um über echten Code nachzudenken
- Wie man Verifizierungspipelines entwickelt, die in großem Maßstab relevante Signale vom Rauschen trennen können
- Wie sich die Ausgabe eines Modells als Eingabe für ein anderes verwenden lässt, um Ergebnisse zu bestätigen oder zu verwerfen
Es gab keinen allgemeingültigen Leitfaden, den wir auf F5 anwenden konnten, also mussten wir selbst einen entwickeln.
Das Tempo, mit dem sich diese Modelle verbessern, ist erstaunlich. Die führenden Modelle von Anthropic und OpenAI, darunter Claude Mythos und GPT Cyber, können inzwischen echte Schwachstellen aufdecken, zeigen, wie sie ausgenutzt werden können, und Entwickler bei deren Behebung unterstützen. In einigen Fällen funktionieren diese Modelle nicht nur bei Quellcode, sondern auch bei Binärdateien und kompiliertem Code außergewöhnlich gut. Im vergangenen Herbst war das noch nicht der Fall.
Nicht nur wir beobachten diese Verbesserung. Wir arbeiten eng mit einigen der größten Organisationen der Welt zusammen, darunter auch den am Project Glasswing beteiligten. Diese Institutionen setzen F5 in ihren kritischsten Bereichen ein und stehen vor demselben Wandel wie wir.
Einige Dinge sind deutlich geworden:
- Die Vorschau- und Forschungsmodelle sind bemerkenswert leistungsfähig. Die neuesten Modelle von Anthropic und OpenAI können kompilierten Code analysieren, komplexe Schwachstellenketten erkennen und ausgefeilte Machbarkeitsnachweise erstellen.
- Die Geschwindigkeit, mit der sich die Modelle verbessern, nimmt nicht linear, sondern immer schneller zu. Jede neue Modellgeneration bringt einen deutlichen Leistungssprung mit sich. Unternehmen, die ihren Code nicht mit den neuesten Modellen prüfen, geraten ins Hintertreffen.
- Anfangs waren falsch-positive Ergebnisse der Engpass, nicht die Modelle selbst. Zu Beginn war das Signal-Rausch-Verhältnis äußerst ungünstig. Wir mussten erheblich in den Aufbau von Prüfmechanismen, die Automatisierung der Triage und Feedbackschleifen investieren, die das System darin trainieren, echte Probleme von irrelevanten Meldungen zu unterscheiden. Dadurch konnten wir die Rate falsch-positiver Ergebnisse senken und Entwicklerinnen und Entwicklern tatsächliche Sicherheitsprobleme und Fehler zur Behebung bereitstellen.
- Die sichere Handhabung und Kontrolle der von hochentwickelten KI-Modellen ausgegebenen Schwachstellen hat höchste Sicherheitspriorität. Wenn ein Modell eine kritische Schwachstelle entdeckt, etwa eine Möglichkeit zur Remotecodeausführung, wird der Umgang mit diesen Informationen selbst zu einer sicherheitsrelevanten Aufgabe. Wir haben viel darüber gelernt, wie sich dies verantwortungsvoll handhaben lässt.
All dies bestätigt einen Gedanken, auf den ich immer wieder zurückkomme: Dieselben Modelle, die wir zum Aufspüren von Schwachstellen einsetzen, werden letztlich auch von Angreifern gegen uns verwendet werden. Die einzige verantwortungsvolle spieltheoretische Strategie besteht darin, unseren Code kontinuierlich mit führenden KI-Modellen zu überprüfen und zu verbessern, bevor ein Angreifer es tut.
Tools, Testumgebungen und Prozesse entwickeln
Wir haben interne Tools entwickelt, die einen grundlegend anderen Ansatz für die Fehleranalyse und das Schwachstellenmanagement verfolgen.
Unsere Codebasis umfasst mehrere zehn Millionen Codezeilen in C, C++, Python, Tcl, Java, Go und hardwarenaher C-Programmierung für FPGAs. Die Probleme, nach denen wir suchen, stecken in Code, der seit Jahren produktiv eingesetzt wird, und erstrecken sich über Module, die auf unterschiedliche Weise miteinander interagieren. Eine Testumgebung zu entwickeln, die diesen gesamten Bereich über Sprach- und Abstraktionsebenen hinweg analysieren kann, war eine erhebliche technische Herausforderung.
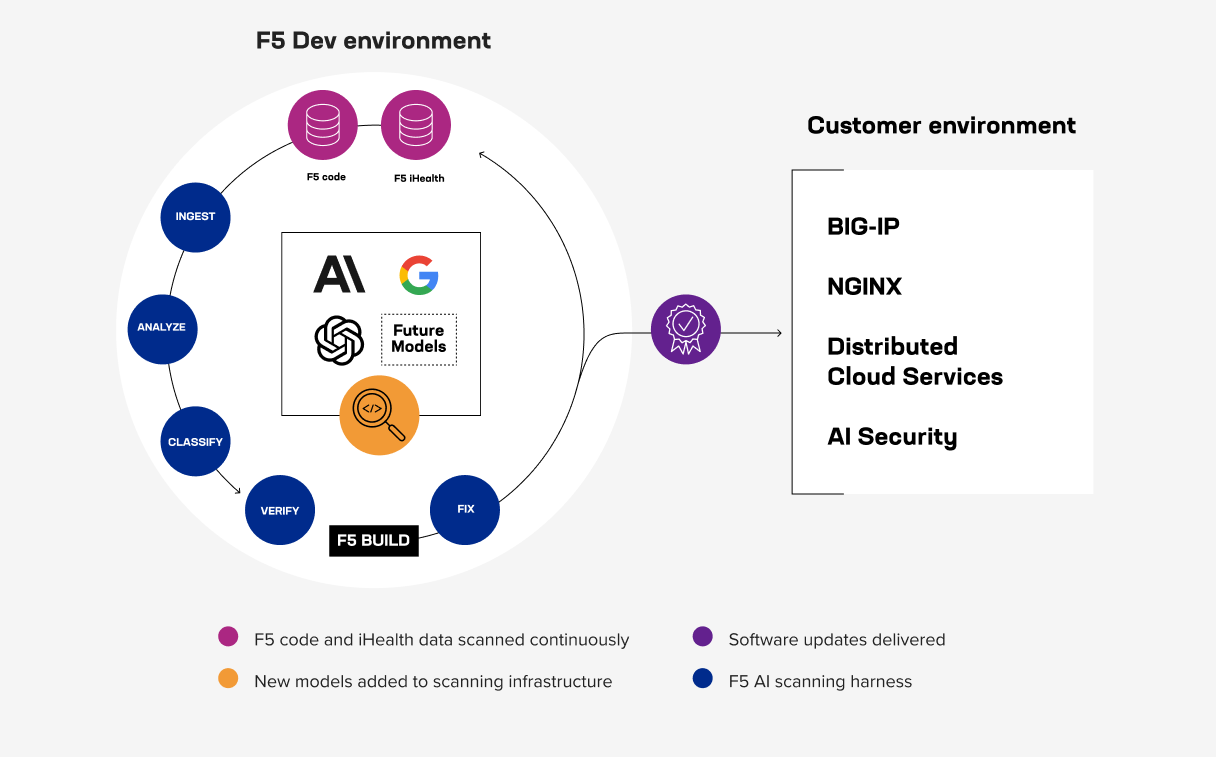
Eines der von uns entwickelten Tools bindet neue Modelle beliebiger Anbieter ein, sobald sie verfügbar werden, und testet sie kontinuierlich anhand unserer Codebasis. Wir arbeiten aktiv mit führenden KI-Laboren zusammen und haben Zugang zu einigen der fortschrittlichsten Modelle, darunter Vorschau- und Forschungsmodelle. Das Tool nutzt diese Modelle in Kombination mit Graphentheorie, statischer Kompositionsanalyse und weiteren Verfahren. Darüber hinaus speisen wir Bedrohungsinformationen ein, darunter öffentliche Datensätze zu Sicherheitslücken und Schwachstellen.
Dies ist nicht das einzige Werkzeug in unserem Arsenal. Unsere Teams haben weitere Tools entwickelt, die gezielt nach bestimmten Fehlerklassen suchen und dabei die Arbeit anderer Organisationen nutzen. Darüber hinaus verfügen viele der führenden KI-Labore über äußerst leistungsfähige Frameworks, die darauf ausgelegt sind, das Potenzial der zugrunde liegenden Modelle voll auszuschöpfen.
Unabhängig vom verwendeten Tool folgt die Scan-Infrastruktur einem strengen, mehrstufigen Prozess, der folgendermaßen aussieht:
- Einlesen. Wir speisen die Codebasis aus den wichtigsten Modulen und Programmiersprachen ein, damit die Modelle konkrete Implementierungsdetails analysieren können – statt lediglich Zusammenfassungen oder Abstraktionen.
- Analysieren. Wir führen KI-gestützte statische Analysen durch, um Fehler, riskante Muster und verdächtige Abläufe zu erkennen: fehlerhafte Authentifizierungslogik, unsichere Kryptografie, Probleme mit der Speichersicherheit und mehr.
- Klassifizieren. Wir extrahieren strukturierte Erkenntnisse, darunter CWE-Zuordnungen, Schweregradbewertungen, Datei- und Zeilenangaben sowie Informationen zur Ausnutzbarkeit.
- Überprüfen. Ein zweites Modell bestätigt, stuft die Ergebnisse herab oder verwirft sie, bevor sie in den Entwicklungsprozess einfließen. In diesem Schritt wird das Problem der falsch positiven Ergebnisse angegangen. Anfangs gab es diesen Schritt in keiner nennenswerten Form, und die Flut irrelevanter Meldungen war überwältigend. Heute ist er einer der wichtigsten Bestandteile des Systems.
- Beheben. Validierte Befunde werden priorisiert zur Behebung weitergeleitet. Korrekturen werden entwickelt, getestet und bereitgestellt.
Jeder Zyklus erweitert eine Wissensbasis, die den nächsten Zyklus schneller und präziser macht. Mit der Zeit wird die Codebasis selbst widerstandsfähiger. Die Modelle finden weniger, weil es weniger zu finden gibt. In diesen sich verstärkenden Effekt investieren wir.
Unsere Erkenntnisse
Wir finden Probleme, die in praktisch jeder ausgereiften Codebasis vorkommen: Lücken bei der Absicherung der Konfiguration, Standardeinstellungen, die restriktiver gestaltet werden sollten, Probleme mit der Speichersicherheit (Pufferüberläufe, Ganzzahlüberläufe), Race Conditions und Lücken bei der Eingabevalidierung.
Genau diese Arten von Problemen wollen wir finden und beheben. In einer Welt, in der KI-Modelle nachvollziehen können, wie sich Schwachstellen zu Angriffsketten verknüpfen lassen, macht ihre systematische Beseitigung die gesamte Codebasis deutlich widerstandsfähiger gegen Ausnutzung. Sie sind die Bausteine von Angriffsketten, und wenn sie beseitigt werden, lässt sich Software schwerer angreifen.
Eine neue Routine: scannen, priorisieren, beheben, testen, veröffentlichen, wiederholen
Eines der wichtigsten Ergebnisse dieser Arbeit ist die operative Kompetenz, die unsere Entwicklungsorganisation in den vergangenen Monaten aufgebaut hat. Das Scannen ist nur ein Teil einer durchgängigen Fähigkeit, die wir neu geschaffen haben.
Wir gehen von einem vierteljährlichen Veröffentlichungszyklus zu häufigeren, sicherheitsgehärteten Releases für unsere gesamte Software über. Dies ist eine tiefgreifende betriebliche Umstellung. Ein Beispiel dafür ist die Gründlichkeit unseres BIG-IP-Entwicklungsteams: Es testet alle bei unseren Kunden eingesetzten Kombinationen aus F5OS und TMOS. Jede Kombination erfordert eine eigene Testumgebung. Jedes Release durchläuft eine strenge Zweigkontrolle sowie Regressions- und Langzeittests. Wir dokumentieren die Dauer von Upgrades und Neustarts und ordnen jede Fehlerbehebung – ob Pufferüberlauf, Absicherung der Eingabeverarbeitung oder CVE – dem jeweiligen Release zu.
Seit Jahren setzen wir auf strenge Scan- und Testverfahren. Neu ist der KI-gestützte Zyklus aus Scannen, Priorisieren, Beheben, Testen, Veröffentlichen und Wiederholen.
Wie geht es weiter?
Rechnen Sie mit weiteren Releases, da KI-gestützte Scans zusätzliche Schwachstellen aufdecken werden. Dies ist ein Zeichen für höhere Sicherheit, nicht für weniger zuverlässige Software. Wir werden unsere Erkenntnisse offenlegen, nachdem wir entsprechend abgesicherte Releases veröffentlicht haben.
Da die Häufigkeit von Patches in der gesamten Branche zunimmt, müssen unsere Kunden häufiger mehr Updates von allen Anbietern einspielen. Wir setzen alles daran, dies einfacher und nicht schwieriger zu gestalten. Deshalb haben wir die Arbeiten an der Flottenverwaltung, an automatisierten Updates und an vereinfachten Upgrade-Prozessen beschleunigt, denn diese Funktionen sind unverzichtbar.
Darüber hinaus muss die Laufzeitsicherheit mit dieser Entwicklung Schritt halten. KI-gestützte Funktionen zur Erkennung und Abwehr werden eine entscheidende Verteidigungslinie bilden, um Bedrohungen zu identifizieren und zu stoppen, ohne auf bekannte Signaturen angewiesen zu sein oder auf einen Patch warten zu müssen. Wir entwickeln diese Funktionen, weil die Bedrohungslage es erfordert. Schon sehr bald werden Sie hierzu mehr von uns erfahren.
Vor neun Monaten begannen wir zu untersuchen, ob hochmoderne KI-Modelle die Art und Weise, wie wir Schwachstellen in unserem eigenen Code finden und beheben, grundlegend verändern könnten. Das können sie. Die Modelle sind besser als erwartet. Unsere operativen Fähigkeiten sind stärker als angenommen, und die Dringlichkeit hat seitdem nur noch zugenommen.
Die Organisationen, die uns ihre kritischste Infrastruktur anvertrauen, verdienen nichts Geringeres.
Weitere Informationen finden Sie in meinem vorherigen Blogbeitrag „Das Zeitfenster für Patches ist geschlossen. So ist F5 für das gerüstet, was als Nächstes kommt“.
Über den Autor

Kunal Anand leitet als Chief Product Officer die Produktorganisation von F5. Er ist für Produktvision, Strategie und Umsetzung verantwortlich und stellt die Entwicklung wegweisender Lösungen sicher, die kritische Herausforderungen bewältigen und außergewöhnliche Kundenerlebnisse schaffen. In seiner vorherigen Funktion als Chief Technology and AI Officer bestimmte Kunal die Technologie- und KI-Strategie sowie die entsprechende Vision des Unternehmens. Vor seiner Zeit bei F5 hatte Kunal bei Imperva die Doppelfunktion des Chief Technology Officer und Chief Information Security Officer inne. Sein Weg zu Imperva begann 2018 mit der Übernahme von Prevoty, einem 2013 von ihm mitgegründeten Start-up für Anwendungssicherheit. Vor seinem Wechsel zu Prevoty war er Director of Technology bei BBC Worldwide. Kunal verfügt über langjährige Innovations- und umfassende technische Erfahrung und leitete bei Gravity, MySpace und dem NASA Jet Propulsion Lab Teams in den Bereichen Sicherheit, Daten, Technologie und Engineering. Kunal verfügt über mehr als 15 Jahre Erfahrung in den Bereichen KI und maschinelles Lernen – von Modelltraining und dem Einsatz KI-gestützter Algorithmen zur Produktoptimierung bis hin zur Konzeption und Implementierung von KI-Architekturen. Kunal hat einen Bachelor-of-Science-Abschluss in Informatik vom Babson College.
Weitere Blogbeiträge von Kunal AnandÄhnliche Blogbeiträge

Vier Gründe, warum Sie den F5 Post-Mythos Security Summit nicht verpassen sollten
Holen Sie sich Expertenrat, um Ihre Apps, APIs und Modelle in der Post-Mythos-Welt zu schützen.

Von einer App zu einer ganzen Agentenflotte: Ein 90-Tage-Framework für KI-Sicherheit
Vermeiden Sie den kostspieligen Ansatz „Jetzt bereitstellen, später absichern“ – mit einem umfassenden Framework zum Schutz von KI-Modellen, Anwendungen und autonomen Agenten.

Fünf Stufen antifragiler Cyberresilienz verwandeln Praxis in Ergebnisse
Erfahren Sie, wie fünf Stufen antifragiler Resilienz Störungen in adaptive Verhaltensweisen überführen, die Ausfälle begrenzen und hybride Multicloud-Architekturen stärken.

Warum Ihre KI-Richtlinien, Governance und Leitplanken nicht warten können
KI-Richtlinien und -Governance dürfen nicht länger als reine Formalitäten oder Zukunftsthemen betrachtet werden. Sie müssen durch praktische, durchsetzbare Leitplanken ergänzt werden.

Wenn „privat“ nicht privat ist: Wie ChatGPT-Unterhaltungen öffentlich wurden
KI verändert die Arbeitsabläufe in Unternehmen, doch eine übersehene Einstellung hat bereits Tausende vertraulicher Unterhaltungen öffentlich zugänglich gemacht
KI-Nutzung verstehen: Warum Unternehmen Transparenz brauchen
Anstatt einen zu laxen oder zu strengen Ansatz zu verfolgen, können Unternehmen durch mehr Transparenz bei der KI-Nutzung fundierte und durchsetzbare Entscheidungen treffen.