Skalierbare KI
KI-Systeme, die auch bei wachsenden Datensätzen, Modellen, Nutzerzahlen und Arbeitslasten weiterhin zuverlässig funktionieren.
Skalierbare KI bezeichnet die Fähigkeit von KI-Systemen, Modellen, Datenpipelines, Infrastrukturen und Betriebsprozessen, auch bei steigender Nachfrage und Komplexität leistungsfähig, zuverlässig und kosteneffizient zu bleiben. Darin liegt der Unterschied zwischen einem KI-Pilotprojekt, das im Labor funktioniert, und einer KI-Lösung, die reale Unternehmensworkloads in großem Maßstab bewältigt.
Was ist skalierbare KI?
Skalierbare KI schafft Systeme, die erweitert werden können, um mehr Daten, mehr Nutzer, größere Modelle und verteilte Standorte ohne Leistungseinbußen oder hohe Kosten zu bewältigen. Echte Skalierbarkeit erfordert ein synchronisiertes Wachstum über den gesamten KI-Stack hinweg, einschließlich Datenpipelines, Modellen, GPU-Clustern, Netzwerken, Inferenz und Betrieb.
Ein Modell, das in der Entwicklungsumgebung funktioniert, gerät im großen Produktivbetrieb oft ins Stocken: Datenpipelines sind noch nicht einsatzbereit, Inferenz-Endpunkte haben Probleme mit parallelen Anfragen oder das Netzwerk wird anstelle der Rechenleistung zum Engpass.
Skalierbarkeit zeigt sich in mehreren zentralen Dimensionen:
- Datenskalierung: Umstellung von einmalig verwendeten Datensätzen auf Echtzeit-Pipelines mit hohem Durchsatz
- Modellskalierung: Erweiterung von einem einzelnen Modell auf zahlreiche Modelle und Varianten, die in verschiedenen Regionen bereitgestellt werden
- Skalierung der Infrastruktur: Sicherstellen, dass GPU-/CPU-Ressourcen, Speicher und Netzwerkinfrastruktur mit dem Wachstum Schritt halten
- Operative Skalierung: Weiterentwicklung von Release-Prozessen, Observability, Traffic Engineering und Kostenmanagement
Bei effektiver Implementierung bietet skalierbare KI auch bei wachsenden Workloads eine zuverlässige, gleichbleibende Leistung. Durch diesen Wandel entwickelt sich KI von Pilotprojekten zu robusten, unternehmensweiten Lösungen. Mit einer soliden Grundlage für Traffic-Management, Sicherheit und Transparenz – Bereiche, auf die sich F5 besonders konzentriert – können Unternehmen KI schnell und zuverlässig skalieren, ohne die Systemstabilität zu gefährden oder versteckte betriebliche Altlasten anzuhäufen.
Warum ist skalierbare KI wichtig?
Ohne Skalierbarkeit stoßen KI-Initiativen schnell an ihre Grenzen. Unternehmen können Machbarkeitsnachweise (Proofs of Concept, POCs) erstellen, doch die Skalierung zur Unterstützung von Tausenden oder Millionen von Anfragen pro Tag stellt eine ganz andere Herausforderung dar.
Skalierbare KI ist ein entscheidendes Thema, weil:
- Die geschäftliche Nachfrage übersteigt die Kapazität der ursprünglichen Architekturen, und die Integration von KI beschleunigt das Datenverkehrswachstum auf unvorhersehbare Weise. Die meisten KI-Implementierungen beginnen mit einem einzelnen Modell, Workflow und Team. Sobald sich der Nutzen gezeigt hat, breitet sich die Nutzung auf weitere Geschäftsbereiche aus. Dadurch kommt es zu Lastspitzen, wenn neue Anwendungen eine Verbindung zu gemeinsam genutzten Endpunkten herstellen. Systeme, die ursprünglich für Tausende von Anfragen pro Stunde ausgelegt waren, verarbeiten nun Millionen pro Tag. Ohne skalierbare Netzwerkinfrastruktur kann dieses rasante Wachstum die Infrastruktur überlasten.
- KI-Systeme können im großen Maßstab auf schwer erkennbare Weise versagen, was zu Latenzspitzen, einer unzureichenden GPU-Auslastung, einer Überlastung von Modellen oder zu Stockungen in Datenpipelines führen und so die Zuverlässigkeit beeinträchtigen kann. KI-Fehler verursachen nur selten größere Ausfälle; meist führen sie zu Leistungseinbußen. GPUs bleiben häufig ungenutzt, Inferenzwarteschlangen stauen sich bei hoher Last oder die Latenz steigt zu Spitzenzeiten sprunghaft an. Eine fehlerhafte Weiterleitung des Datenverkehrs oder ein langsamer Daten-Shard kann die gesamte Pipeline beeinträchtigen. Diese systemischen Probleme treten in der Regel erst unter realer Last auf und sind ohne angemessene Observability und intelligente Funktionen für das Traffic-Management nur schwer zu diagnostizieren.
- Die Betriebskosten steigen aufgrund ineffizienter Inferenzpfade, unkontrollierter Parallelität und ungünstig gesteuerter Datenströme rapide an, wodurch sich die Cloud-Ausgaben verdoppeln oder verdreifachen können. Schlechtes Datenverkehrsmanagement, nicht gebündelte Anfragen, ungleichmäßige Auslastung, nicht vorgewärmte GPU-Pfade oder eine ungeeignete Weiterleitung erhöhen die Inferenzkosten und führen zu unnötiger Skalierung und Überprovisionierung. Cloud-GPUs sind teuer; ohne angemessenes Management zahlen Teams letztlich für ungenutzte GPUs oder überzählige Replikate. Viele Unternehmen stellen fest, dass Netzwerkprobleme und nicht die Komplexität der Modelle die Inferenzkosten und Ausgaben in die Höhe treiben.
- Compliance und Governance erfordern Enterprise-Tools. Produktiv eingesetzte KI benötigt Schutzmechanismen, die bei Pilotprojekten nicht erforderlich sind. Frühen KI-Pilotprojekten fehlen häufig formale Kontrollen wie API-Sicherheit, die Nachverfolgung der Modellherkunft und Data Governance. Wenn KI jedoch Kundendaten, regulierte Arbeitsabläufe oder sensible Inhalte verarbeitet, müssen Unternehmen Schutzmaßnahmen wie die Durchsetzung von Richtlinien, Audit-Trails, Zugriffskontrollen, Verschlüsselung und Versionsverwaltung gewährleisten. Diese sind für den Einsatz von KI im Finanz- und Gesundheitswesen, in Behörden oder in global tätigen Unternehmen unerlässlich.
- Der Wettbewerbsvorteil wächst mit zunehmender Skalierung. Schnellere Inferenz, häufigere Modelliterationen und eine verbesserte Benutzererfahrung sorgen für eine dauerhafte Differenzierung. Skalierbarkeit schützt das System und fördert Innovationen. Teams, die Modelle schnell neu trainieren, Updates bereitstellen oder Inferenz mit geringer Latenz ermöglichen, verschaffen sich Wettbewerbsvorteile. Nutzer profitieren von kürzeren Reaktionszeiten, Funktionen werden schneller veröffentlicht und Modelle häufiger optimiert. Diese operative Geschwindigkeit schafft einen Wettbewerbsvorsprung, den Konkurrenten nur schwer aufholen können.
Skalierbare KI ermöglicht es Unternehmen, ihre Anwendungsfälle zuverlässig auszubauen – sei es durch die Unterstützung einer wachsenden Zahl von Nutzern, die Implementierung komplexerer Modelle oder den Einsatz von KI in verschiedenen Regionen und auf unterschiedlichen Cloud-Plattformen.
Wie funktioniert skalierbare KI?
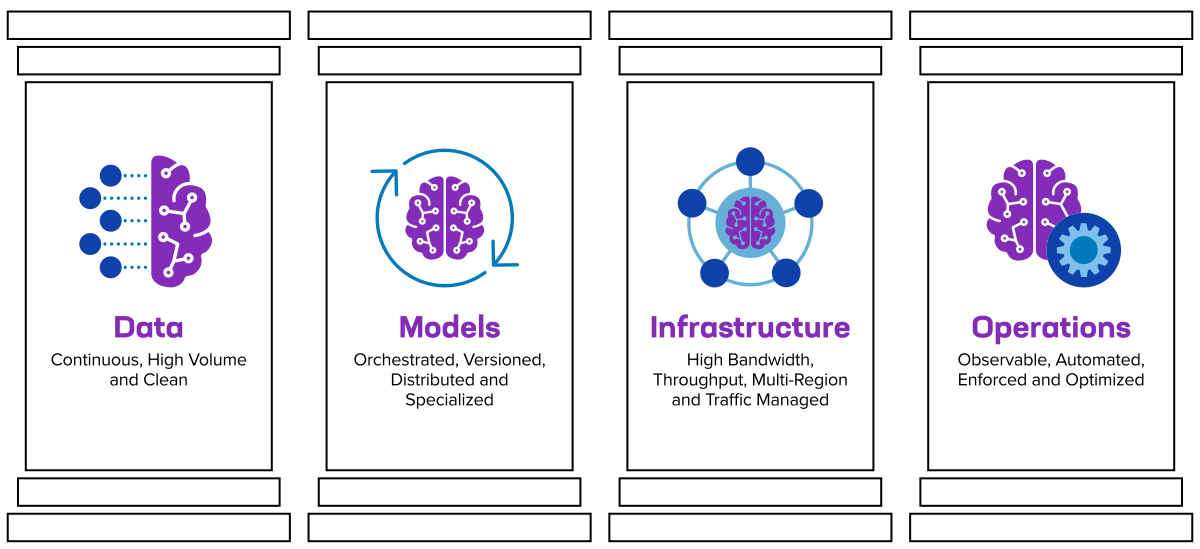
Skalierbare KI funktioniert durch die Koordination von vier Wachstumssäulen: Daten, Modelle, Infrastruktur und Betrieb. Alle vier müssen aufeinander abgestimmt sein. Bleibt auch nur eine davon zurück, wird das gesamte System ausgebremst.
1. Datenskalierung
Daten stellen häufig den ersten Engpass dar. KI-Systeme benötigen kontinuierliche, bereinigte Datenpipelines mit hohem Durchsatz, um Training und Inferenz zu unterstützen, ohne GPUs zu überlasten oder Arbeitsabläufe zu beeinträchtigen – selbst bei wachsenden Datenmengen.
- Kontinuierliche Datenaufnahme: KI-Pipelines müssen zuverlässig und sicher Echtzeitdaten aus mehreren Quellen abrufen, damit die Modelle stets aktuelle und präzise Eingabedaten verwenden.
- Datenpipelines mit hohem Durchsatz: Systeme müssen Daten schnell bereitstellen, damit GPUs vollständig ausgelastet bleiben und Leerlaufzeiten aufgrund langsamer oder unregelmäßiger Datenströme vermieden werden.
- Feature Stores und Vektordatenbanken: Diese Systeme standardisieren, speichern und stellen Features oder Embeddings in großem Maßstab bereit und gewährleisten dabei Reproduzierbarkeit und Inferenz mit geringer Latenz.
- Kontrollen für Datenqualität und -konsistenz: Bereinigte, validierte Daten mit nachvollziehbarer Herkunft reduzieren Modelldrift, verhindern Pipeline-Ausfälle und stärken das Vertrauen in die Modellergebnisse.
- Skalierbare Speichersysteme: Der zugrunde liegende Speicher muss mit dem Datensatz wachsen und bei zunehmendem Datenvolumen parallelen Zugriff, schnellen Abruf und eine vorhersehbare Leistung ermöglichen.
2. Skalierungsmodelle
Unternehmen gehen rasch von einem einzelnen Modell zu Hunderten von Modellen über, darunter destillierte Versionen, aufgabenspezifische Varianten und feinabgestimmte Modelle. Die Skalierbarkeit von Modellen bedeutet mehr als nur eine Erhöhung der Modellparameter; sie umfasst:
- Orchestrierung mehrerer Modelle: Durch die Koordination mehrerer Modelle wird sichergestellt, dass das richtige Modell zum richtigen Zeitpunkt ausgeführt wird, ohne den Endpunkt zu überlasten.
- Versionierung, Rollouts und Rollbacks: Die Verwaltung von Modellversionen mit kontrollierten Rollouts und sofortigen Rollbacks verhindert Ausfälle und ermöglicht sichere, kontinuierliche Verbesserungen.
- Verteilte Inferenz: Die Ausführung von Inferenzen über mehrere Knoten oder Regionen hinweg reduziert die Latenz und verteilt die Last, sodass Engpässe auf einzelnen GPUs oder Clustern vermieden werden.
- Modellspezialisierung nach Region oder Anwendungsfall: Der Einsatz maßgeschneiderter Varianten für unterschiedliche Märkte oder Aufgaben steigert Leistung und Effizienz, da jedes Modell in seinem optimalen Kontext eingesetzt wird.
3. Skalierung der Infrastruktur
KI-Workloads erfordern leistungsstarke Rechen-, Speicher- und Netzwerkressourcen. Mit zunehmender Nutzung müssen Unternehmen ihre GPU-Kapazitäten skalieren und:
- Netzwerke mit hoher Bandbreite: Netzwerke müssen Verbindungen mit geringer Latenz und hohem Durchsatz bereitstellen, damit GPUs kontinuierlich mit Daten versorgt werden, anstatt durch überlastete Verbindungen ausgebremst zu werden.
- Speicher mit hohem Durchsatz: Speichersysteme müssen einen kontinuierlichen, parallelen Zugriff auf riesige Datensätze ermöglichen, um E/A-Engpässe beim Training und bei der Inferenz zu vermeiden.
- Bereitstellung in mehreren Regionen: Die Verteilung der Infrastruktur auf mehrere Regionen erhöht die Ausfallsicherheit und reduziert die Latenz, da Rechenressourcen und Modelle näher an den Nutzern und Datenquellen platziert werden
- Datenverkehrssteuerung und Lastverteilung mit Leitungsgeschwindigkeit: Eine intelligente Hochgeschwindigkeits-Datenverkehrssteuerung sorgt dafür, dass Inferenzanfragen gleichmäßig verteilt werden, sodass GPU-Cluster vollständig ausgelastet bleiben und Überlastungspunkte vermieden werden.
Die Infrastruktur muss effizient bleiben, da GPU-Kapazitäten kostspielig sind und eine ineffiziente Weiterleitung des Datenverkehrs zu Verschwendung führt.
4. Skalierung des Betriebs
Selbst die leistungsfähigste Hardware kann schwache Betriebsprozesse nicht ausgleichen. KI im Unternehmenseinsatz erfordert:
- Observability für Latenz, Durchsatz und Kosten pro Inferenz: Teams benötigen Echtzeiteinblicke in das Verhalten von Modellen und Infrastruktur, um Engpässe zu erkennen, die Leistung zu optimieren und unbemerkte Ausfälle zu verhindern.
- Störungsbehebung bei nachlassender Modellleistung: Wenn die Genauigkeit sinkt oder die Latenz sprunghaft ansteigt, müssen Unternehmen die Ursachen schnell ermitteln und einen stabilen Betrieb wiederherstellen, ohne die Nutzer zu beeinträchtigen.
- Automatisierte Bereitstellungspipelines: Eine zuverlässige Automatisierung gewährleistet, dass Modellaktualisierungen sicher von der Entwicklung in die Produktion überführt werden, ohne die mit manuellen Schritten verbundenen Risiken.
- Richtliniendurchsetzung und Governance: Strenge Kontrollen sind erforderlich, um Modellschnittstellen zu schützen, Zugriffsregeln durchzusetzen und die Einhaltung von Vorschriften in komplexen KI-Umgebungen sicherzustellen
- Kostentransparenz und -optimierung: Die Überwachung der GPU-Auslastung sowie der Effizienz von Inferenz und Routing hilft Teams, Kosten zu kontrollieren und unnötige Skalierungsvorgänge zu vermeiden.
Wie adressiert F5 die zentralen Dimensionen skalierbarer KI?
F5 betrachtet skalierbare KI vor dem Hintergrund der zentralen Herausforderungen, denen Unternehmen bei der Datenverkehrssteuerung, Sicherheit und Transparenz gegenüberstehen. Diese Ebenen werden bei zunehmenden KI-Workloads häufig zum Engpass – selbst in Unternehmen, die über zahlreiche GPUs und fortschrittliche Modellarchitekturen verfügen.
F5 unterstützt Unternehmen bei der Skalierung von KI durch:
- Maximierung der GPU-Auslastung durch intelligente Datenverkehrssteuerung: Der Durchsatz bei der KI-Inferenz variiert je nach Verteilung der Anfragen. F5 BIG-IP Local Traffic Manager (LTM) bietet Lastverteilung, modellabhängige Weiterleitung und latenzoptimierte Datenverkehrspfade, sodass GPU-Cluster dauerhaft ausgelastet und effizient bleiben, anstatt durch langsame oder ungleichmäßige Anfrageströme ausgebremst zu werden.
- Beseitigung von Netzwerkengpässen: Inferenzvorgänge mit hoher Parallelität können herkömmliche Netzwerk-Stacks bereits lange vor dem Erreichen der Rechenkapazitätsgrenze überlasten. Die F5 BIG-IP Plattform und F5 Distributed Cloud App Connect bewältigen Situationen mit extrem hohem Bandbreitenbedarf und reduzieren Überlastungen, sodass der Inferenzdatenverkehr reibungslos zu allen Endpunkten fließt.
- Absicherung von Inferenz-Endpunkten und Modell-APIs: KI-Dienste sind auf APIs angewiesen, die einen echten Schutz auf Anwendungsebene (Layer 7) benötigen und nicht nur eine Paketfilterung. F5 BIG-IP Advanced WAF, F5 Distributed Cloud Web App and API Protection (WAAP) und F5 BIG-IP SSL Orchestrator bieten umfassende Prüfungen (einschließlich verschlüsselten Datenverkehrs), Richtliniendurchsetzung, Schutz vor Bots und Missbrauch sowie Laufzeitschutz, um sensible Modelle und Inferenzrouten zu schützen.
- Transparenz in hybriden KI-Umgebungen schaffen: KI-Datenverkehr findet in verschiedenen Umgebungen statt, häufig mit unklaren, uneinheitlichen Mustern. F5 Distributed Cloud App Stack stellt Teams zusammen mit der Telemetrie-Streaming-Funktion von BIG-IP Echtzeitdaten zu Latenz, Durchsatz, Leistung der Modellendpunkte, Warteschlangentiefe und API-Zustand bereit. So können Betreiber die Leistung optimieren und Probleme beheben, bevor sie sich auf die Benutzer auswirken.
- Unterstützung moderner, S3-kompatibler Datenpipelines mit hohem Durchsatz: Bei datenintensiven KI-Trainings- und Ingest-Pipelines beschleunigt BIG-IP den Datenverkehr mit hohem Volumen zu S3-kompatiblem Objektspeicher. Gemeinsam mit Partnern wie NetApp StorageGRID stellt F5 sicher, dass Datenpipelines reibungslos mit den Arbeitslasten für Modelltraining und Datenabruf skalieren.
Die über BIG-IP und Distributed Cloud Services bereitgestellten F5-Ebenen für Datenverkehr, Sicherheit und Transparenz sind darauf ausgelegt, sicherzustellen, dass KI-Workloads auch bei steigender Nachfrage zuverlässig, effizient und leistungsstark bleiben.
Warum Skalierbarkeit bereits in der frühen Entwicklungsphase wichtig ist
KI-Systeme entwickeln sich heute schneller als die Infrastruktur, die sie unterstützt. Modelle werden größer, Anwendungsfälle umfangreicher und die Zahl gleichzeitiger Zugriffe steigt, da Unternehmen KI in Produkte, Arbeitsabläufe und Kundenerlebnisse integrieren. Gleichzeitig werden die Kostenvorgaben strenger, und Governance-Anforderungen erhöhen die Standards für die betriebliche Disziplin.
Skalierbarkeit ist nicht nur eine Frage der Optimierung, sondern eine Grundvoraussetzung dafür, KI im gesamten Unternehmen zuverlässig und reproduzierbar einzusetzen. Ohne eine solide, skalierbare Basis besteht bei jeder neuen KI-Anwendung die Gefahr, dass sie zu einem individuellen Projekt mit uneinheitlicher Leistung und steigenden Kosten wird.
Unternehmen, die frühzeitig in eine skalierbare KI-Infrastruktur als operatives Rückgrat ihrer KI investieren, profitieren von:
- Schnellere Iterationszyklen
- Niedrigere Betriebskosten
- Konstantere Leistung
- Höhere Zuverlässigkeit und Sicherheit
- Ein nachhaltiger Weg zur unternehmensweiten Einführung
Architektur und Infrastruktur für skalierbare KI
Die Skalierbarkeit von KI hängt von einer Infrastruktur ab, die den jeweiligen Workload-Anforderungen gerecht wird. Unternehmen ziehen in der Regel vier Architekturoptionen in Betracht: Cloud, On-Premises, Hybrid und Edge.
- Skalierbarkeit cloudbasierter KI: Die Cloud beschleunigt Experimente und die Bereitstellung von Kapazitäten, bringt bei der Skalierung jedoch Kosten- und Latenzprobleme mit sich. Zu den Einschränkungen zählen die Steuerung des Datenverkehrs, die Verfügbarkeit von GPUs und die Vorhersagbarkeit der Leistung.
- Skalierbarkeit von KI in lokalen Umgebungen: Lokale Lösungen bieten planbare Kosten, eine strenge Daten-Governance und eine stabile Leistung, erfordern jedoch eine sorgfältige Planung von Stromversorgung, Kühlung und Netzwerkinfrastruktur, insbesondere bei dicht bestückten GPU-Clustern.
- Hybride KI-Architekturen: Die meisten Unternehmen setzen auf diesen Ansatz: Das Training erfolgt häufig in der Cloud, die Inferenz am Edge und das Fine-Tuning auf einem dedizierten GPU-Cluster. Die Skalierbarkeit hängt von einer zuverlässigen Vernetzung, einem zuverlässigen Routing und einer zuverlässigen Sicherheit über verschiedene Umgebungen hinweg ab.
- Edge-KI-Skalierbarkeit: Edge-Inferenz senkt Kosten und Latenz, erfordert jedoch Modelldestillation, Replikationsansätze und ein effektives Datenverkehrsmanagement zwischen Edge-Geräten und der Cloud.
Schlüsseltechnologien, die skalierbare KI ermöglichen:
- Container und Orchestrierung
- Vektordatenbanken und Feature Stores
- Frameworks für verteiltes Training
- CI/CD für ML (MLOps-Pipelines)
- Modellregister und Versionierung
- Traffic-Management und L7-Routing
- Pipelines für S3-kompatiblen Objektspeicher
Netzwerke sind für skalierbare KI von zentraler Bedeutung, da dichte GPU-Cluster ein hohes Ost-West-Datenverkehrsaufkommen erzeugen und Inferenzaufgaben Ausfallsicherheit, geringe Latenz und intelligentes Routing erfordern. Die Funktionen von F5 sind in diesem Zusammenhang von grundlegender Bedeutung.
Best Practices für die Skalierung von KI-Modellen
Bei der Skalierung von KI-Modellen geht es im Kern um das Design von Diensten und nicht nur um die Optimierung der Modelle. Um zuverlässige und kosteneffiziente Inferenz zu gewährleisten, müssen Unternehmen ihre Architektur und ihre Betriebsprozesse aufeinander abstimmen.
- Entwerfen Sie zustandslose, horizontal skalierbare Dienste: Trennen Sie die Modelllaufzeit vom Zustand und stellen Sie sicher, dass Endpunkte automatisch mit dem Datenverkehr skalieren können.
- Nutzen Sie Batching und Caching und teilen Sie Daten in überschaubare Einheiten auf (Sharding): Diese Maßnahmen reduzieren die GPU-Auslastung und gleichen Lastspitzen bei gleichzeitigen Anfragen aus. Viele Unternehmen erzielen erhebliche Kosteneinsparungen, indem sie diese Verfahren konsequent anwenden.
- Modellversionen konsequent verwalten: Rollouts, A/B-Tests und Rollbacks müssen schnell und sicher erfolgen. Ein unzureichendes Versionsmanagement ist nach wie vor eine der häufigsten Ursachen für Störungen bei der Inferenz.
- Überwachen Sie zentrale Metriken: Latenz, Durchsatz, Kosten pro Inferenz, GPU-Auslastung, Zeitüberschreitungsrate und Warteschlangentiefe sollten allesamt in Echtzeit überwacht werden.
- Mangelnde Datenreife frühzeitig angehen: Probleme mit der Datenqualität, etwa isolierte Pipelines, fehlerhafte Labels und eine fehlende Datenherkunft, werden mit zunehmender Skalierung zu dauerhaften Hindernissen. Investitionen in die Datenreife bringen häufig größere Vorteile als eine bloße Erweiterung der Dateninfrastruktur und der GPU-Kapazitäten.
- Modellbewusstes Routing integrieren: KI-Datenverkehrsmuster sind nicht einheitlich. Ein Routing nach Modelltyp, Größe, Warteschlangentiefe oder Nutzerregion verbessert Leistung und Effizienz erheblich.
Herausforderungen bei der Implementierung skalierbarer KI
Die Skalierung von KI bringt Herausforderungen in den Bereichen Technologie, Organisation und Kosten mit sich.
- Technische Engpässe umfassen fragmentierte Infrastrukturen, leistungsschwache oder falsch konfigurierte Netzwerke, Speichersysteme, die GPUs nicht unterstützen können, sowie latenzempfindliche Inferenz-Endpunkte, bei denen unter Last Probleme auftreten.
- Organisatorische Defizite umfassen isoliert arbeitende KI- und Infrastrukturteams, einen geringen MLOps-Reifegrad sowie fehlende Zuständigkeit und Verantwortlichkeit für den produktiven KI-Einsatz.
- Kosten- und Kapazitätsengpässe umfassen die begrenzte Verfügbarkeit von GPUs, unvorhersehbaren Inferenzdatenverkehr, sprunghaft steigende Cloud-Kosten und ineffizientes Routing, das die GPU-Auslastung verringert.
- Sicherheit und Governance sind von entscheidender Bedeutung. Sensible Modellressourcen müssen isoliert und verschlüsselter Datenverkehr (der Bedrohungen verschleiert) muss überprüft werden, API-Zugriffe müssen einheitlich verwaltet werden, und Echtzeittransparenz ist unerlässlich, um Modelldrift und Missbrauch zu erkennen.
Hier bietet F5 einen entscheidenden Vorteil: F5 beseitigt Netzwerkengpässe, schützt Datenverkehr und APIs und sorgt für die nötige Transparenz, damit Teams ihre KI zuverlässig skalieren können, anstatt auf Behelfslösungen angewiesen zu sein.
Skalierbare KI | FAQ
Was bedeutet skalierbare KI in der Praxis?
KI, die auch bei steigender Nachfrage, wachsenden Datenmengen und zunehmender Modellkomplexität zuverlässig leistungsfähig bleibt.
Worin unterscheidet sich Skalierbarkeit vom Hinzufügen weiterer GPUs?
Echte Skalierbarkeit setzt ein abgestimmtes Wachstum von Datenpipelines, Netzwerken, Betriebsprozessen und Modellarchitekturen voraus – nicht nur punktuelle Hardwareverbesserungen.
Welche Faktoren beeinflussen die Skalierbarkeit von KI?
Datenverfügbarkeit, Modellarchitektur, Netzwerkkapazität, GPU-Auslastung, Parallelitätsmanagement und Governance sind zentrale Aspekte, auf die man sich konzentrieren sollte.
Wie sollten Unternehmen Cloud- und On-Premises-Lösungen gegeneinander abwägen?
Die Cloud beschleunigt Experimente, während On-Premises-Lösungen die Planbarkeit und Governance verbessern. Daher setzen die meisten Unternehmen in der Regel auf einen hybriden Ansatz.
Warum kommen KI-Pilotprojekte nicht über die Pilotphase hinaus und schaffen es nicht in den Produktivbetrieb?
Häufige Ursachen sind ein unzureichender Reifegrad der Daten, begrenzte Netzwerkkapazitäten, nicht ausgelastete GPUs, ineffizientes Routing, schwache Betriebsprozesse und unklare Zuständigkeiten.
Wie wirkt sich die Vernetzung auf skalierbare Inferenz aus?
Latenz, Durchsatz und GPU-Auslastung werden durch Routing, die Verwaltung gleichzeitiger Anfragen und Traffic Engineering beeinflusst.
Wo sollten Teams anfangen?
Konzentrieren Sie sich auf Transparenz. Ermitteln Sie aktuelle Engpässe, etwa bei der Netzwerkinfrastruktur, den Daten und der GPU-Auslastung, und entwickeln Sie anschließend auf Grundlage dieser Engpässe eine Roadmap.
Wie F5 hilft
Skalierbare KI bildet die Grundlage für den erfolgreichen Einsatz von KI in Unternehmen. Sie erfordert integrierte Datenpipelines, robuste Modellarchitekturen, eine leistungsstarke Infrastruktur, zuverlässige Netzwerke, solide Governance und disziplinierte Betriebsabläufe. Unternehmen, die jetzt investieren, können KI-Anwendungen zuverlässig und kosteneffizient ausweiten, ohne Abstriche bei Leistung oder Sicherheit zu machen.
Erfahren Sie mehr darüber, wie die F5 Application Delivery and Security Platform Unternehmen dabei unterstützt, ihre KI-Initiativen zu skalieren: f5.com/solutions/ai-delivery-and-security.