
Aufbau einer Enterprise-Cloud mit F5 und IBM
Einführung
Einigen Schätzungen zufolge setzt sich die Enterprise Cloud – auch als Private Cloud bezeichnet – schneller durch als die Public Cloud. Das Unternehmensberatungsunternehmen Accenture beziffert den Verbreitungsgrad der Private Cloud in Unternehmen bis Ende 2011 auf 77 Prozent.1 Dieser rasche Trend hin zur Schaffung einer agilen Infrastruktur vor Ort ist größtenteils darauf zurückzuführen, dass die IT-Abteilungen großer wie kleiner Unternehmen sowohl die Infrastruktur als auch die Daten intern kontrollieren und verwalten müssen.
Sobald die Entscheidung für eine Cloud-Infrastruktur gefallen ist, hängt die Wahl zwischen einer internen/privaten und einer externen/öffentlichen Cloud von einer Analyse der Kosten, Risiken und des Nutzens ab. Eine öffentliche Cloud bietet in der Regel einen flexiblen Ansatz und die größten Kosteneinsparungen, birgt jedoch Risiken in Bezug auf Sicherheit, Service-Level-Agreements (SLAs), Verfügbarkeit und Verwaltung. Die IT kann nahezu unbegrenzte Skalierbarkeit bei geringen Einstiegskosten nutzen, gibt dafür aber Kontrolle ab. Der Wechsel von einem herkömmlichen lokalen oder gehosteten Rechenzentrum zu einer externen öffentlichen Cloud ist im Grunde so, als würde man sein gesamtes Rechenzentrum in fremde Hände geben.
Mit einer Enterprise Cloud verfügt die IT über das erforderliche Maß an Kontrolle und vermeidet die mit einer Public Cloud verbundenen Risiken. Eine Private Cloud ist jedoch teurer in der Bereitstellung, erfordert zusätzliche Kenntnisse und Fachkompetenz der Mitarbeiter und erhöht die Komplexität des lokalen Rechenzentrums. Die Enterprise-Cloud-Infrastruktur lässt sich nach Bedarf skalieren und ermöglicht eine dynamische Bereitstellung sowie hohe Agilität. Diese Skalierbarkeit und Kontrolle gehen jedoch häufig mit höheren Anfangsinvestitionen einher.
F5 Networks® und IBM haben gemeinsam eine Referenzarchitektur für die Enterprise Cloud entwickelt, die viele der mit der Komplexität verbundenen Herausforderungen bewältigt. Sie überträgt zahlreiche Architektur- und Skalierungskomponenten einer Public Cloud in die lokale Infrastruktur und senkt so die Kosten für den Aufbau eines internen Systems aus Einzellösungen erheblich. Durch die Vorabdefinition der erforderlichen Komponenten und die Beschreibung ihres Zusammenspiels haben F5 und IBM eine vollständige, dynamische und agile Enterprise-Cloud-Infrastruktur geschaffen.
Arbeitsablauf
Das wichtigste Element eines Systems zur bedarfsgesteuerten Bereitstellung ist die Fähigkeit, auf der Grundlage von Ereignissen Entscheidungen zu treffen und Maßnahmen zu ergreifen. Ein Ereignis an einer beliebigen Stelle im System erzeugt eine Warnung oder Nachricht, die von einer Komponente empfangen wird (entweder von einer Komponente, die den Nachrichtenbus abonniert hat, oder von einer, die direkt über einen API-Aufruf angesprochen wurde) und daraufhin entsprechend reagiert. Der Workflow bezeichnet den Prozess und die Reihenfolge, in der Komponenten auf Systemnachrichten reagieren.
In einer Enterprise-Cloud gliedert sich der Workflow in der Regel in Bereitstellungskomponenten, die Ressourcen entweder anfordern oder freigeben, sowie in die zur Verwaltung der Ressourcenzuweisung erforderlichen Schritte. Benötigt eine virtuelle Maschine (VM) zusätzliche CPU-Ressourcen, wird ein Workflow gestartet, um zu ermitteln, woher diese CPU-Ressourcen bezogen werden, eine neue VM zu starten, eine IP-Adresse zuzuweisen und so weiter.
Workflow-Architektur
Die Enterprise-Cloud-Architektur von F5 und IBM basiert auf zwei wesentlichen Grundprinzipien:
- Es gibt einen zentralen Nachrichtenbus zur Übertragung von Ereignisbenachrichtigungen, an den alle Komponenten angebunden sind, die auf Ereignisse reagieren müssen.
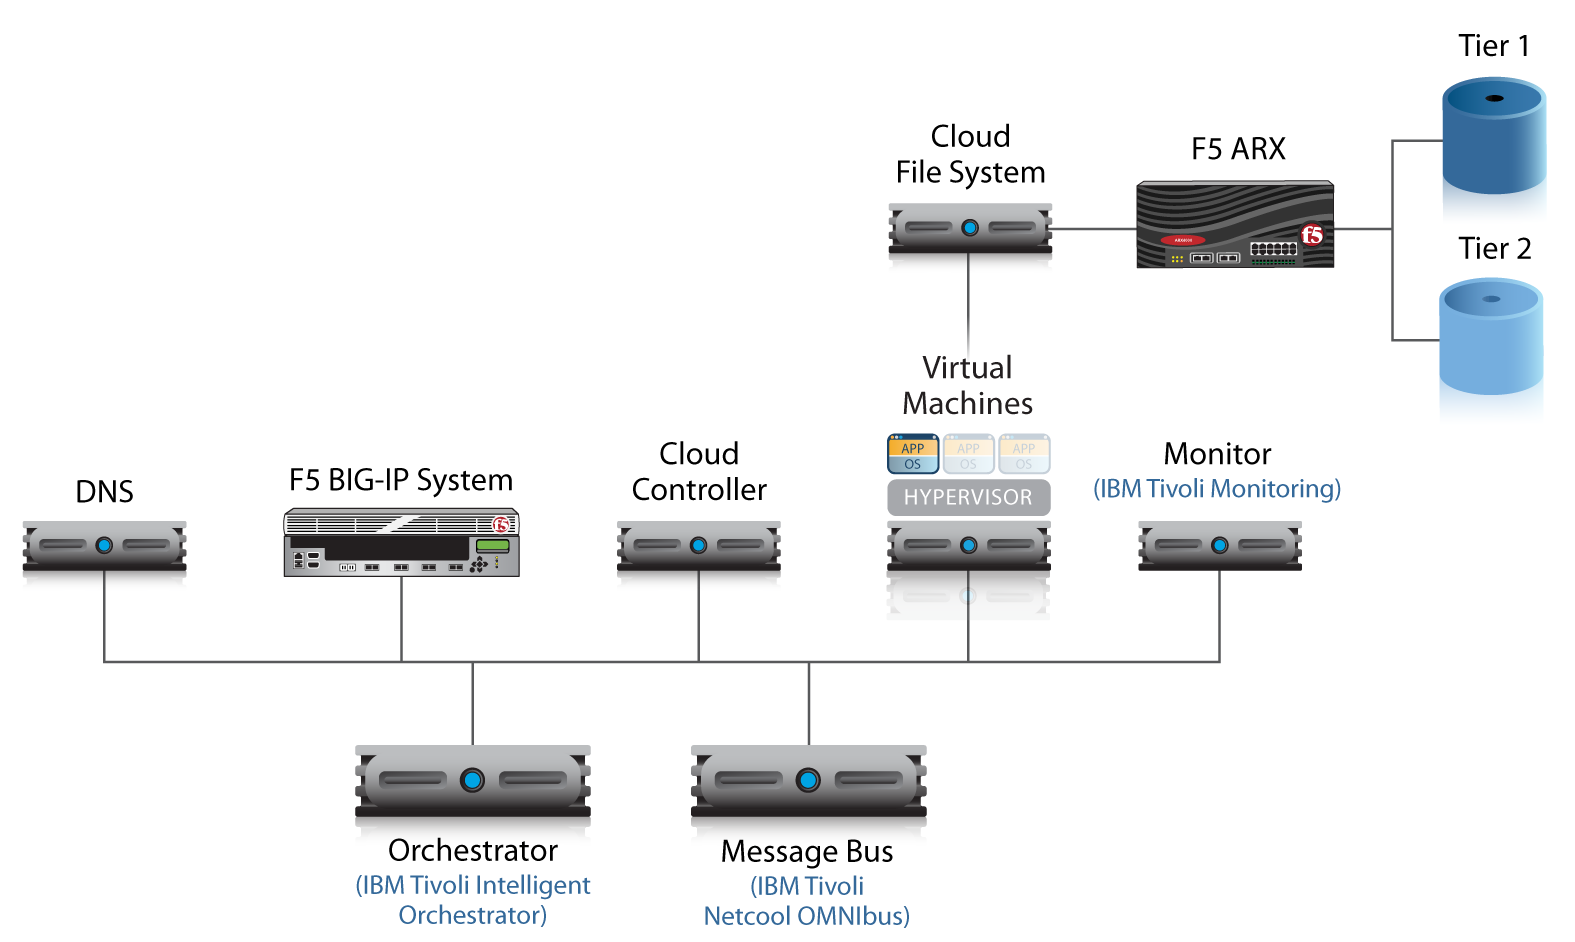
Über diese beiden Prinzipien hinaus ist die Referenzarchitektur von F5 und IBM äußerst flexibel und lässt sich daher in jede bestehende Rechenzentrums- oder Cloud-Architektur integrieren. Ist beispielsweise bereits eine Orchestrierungs-Engine zur Verwaltung der Bereitstellung virtueller Maschinen vorhanden, kann diese Referenzarchitektur so angepasst werden, dass die bestehende Engine weiterhin genutzt werden kann. Ein weitverbreiteter Irrtum beim Aufbau einer Enterprise Cloud besteht darin, dass die gesamte Infrastruktur ersetzt werden müsse. Die Lösung von F5 und IBM wurde jedoch so konzipiert, dass sie sich bei jedem möglichen Schritt in bestehende Komponenten integrieren lässt.
Workflow-Komponenten
Unabhängig davon, welche Komponenten bereits vorhanden und welche neu sind, besteht der Enterprise-Cloud-Workflow aus bestimmten Komponenten, die jeweils spezifische Aufgaben erfüllen. Das gesamte Cloud-System setzt sich aus diesen einzelnen Komponenten zusammen, die gemeinsam die vollständige Cloud-Infrastruktur bereitstellen. Diese Infrastruktur wird durch Komponenten-Workflows betrieben und gesteuert – koordinierte Aufgaben, die ein Cloud-Ereignis verwalten.
Nachrichtenbus
Der Message Bus ist das System, das auf Ereignissen und Warnmeldungen basierende Nachrichten an alle betroffenen Komponenten übermittelt. Wenn ein Ereignis eine Nachricht auslöst, wird diese über den Message Bus an eine bestimmte Komponente gesendet, für die Regeln zur Verarbeitung dieser Nachricht festgelegt sind. Der Message Bus ist außerdem dafür verantwortlich, Nachrichten anhand der für bestimmte Komponenten geltenden Regeln zu normalisieren.
Die Referenz-Cloud-Architektur von F5 und IBM verwendet die Lösung IBM Tivoli Netcool OMNIbus als zentralen Nachrichtenbus. Es kann jedoch jeder beliebige Enterprise-Nachrichtenbus eingesetzt werden, um Ereignisbenachrichtigungen im gesamten System zu übertragen.
Orchestrator
Der Orchestrator kann als das Gehirn der Enterprise-Cloud betrachtet werden – die Komponente, die auf Grundlage der über den Bus empfangenen Nachrichten die meisten übergeordneten Bereitstellungsentscheidungen trifft. Der Orchestrator stößt wichtige Ereignisse und Workflows in der Cloud-Architektur an, beispielsweise den Workflow „Neue virtuelle Maschine bereitstellen“. Darüber hinaus ist der Orchestrator dafür verantwortlich, die für jeden Workflow erforderlichen Daten abzurufen und den entsprechenden Komponenten bereitzustellen. So würde er beispielsweise die IP-Adressinformationen bereitstellen, die für die Bereitstellung einer neuen VM benötigt werden.
Für die Referenzarchitektur wird der Orchestrator mithilfe einer Reihe interpretierter Skripte erstellt, die auf Nachrichten vom Bus reagieren und Workflow-Ereignisse auslösen. Es kann jede Art von Orchestrator verwendet werden, beispielsweise IBM Tivoli Intelligent Orchestrator, HP Operations Orchestration oder VMware vCenter Orchestrator.
Cloud-Controller
Der Cloud Controller ist das Frontend-System, das für die Erfassung und Zusammenführung der vorläufigen Daten zuständig ist, die zum Starten eines Bereitstellungsprozesses erforderlich sind. Diese Informationen werden zunächst im Rahmen des Erstellungsprozesses von einem Administrator bereitgestellt und sind spezifisch für die jeweilige Art des zur Bereitstellung verwendeten Workflows. Der Cloud Controller erfasst beispielsweise Informationen wie den Standort der VM, die Anwendungsklasse (Webserver, Datenbankserver, Mailserver usw.) und die Mindestanforderungen an die Ressourcen.
Während eines automatisierten Bereitstellungsvorgangs fordert der Orchestrator, sobald diese vorläufigen Daten bereits im System gespeichert wurden, die vorhandenen Informationen an und extrahiert sie, um den Bereitstellungsworkflow zu initialisieren. Beispiele für Cloud-Controller sind Eucalyptus Cloud Controller, VMware vCloud Director und Amazon EC2. Im Hinblick auf zukünftiges Wachstum und die Erweiterbarkeit auf andere Cloud-Plattformen empfiehlt es sich, einen Cloud-Controller zu wählen, der sich entweder integrieren lässt oder mit einem Standardsatz von Cloud-APIs kommunizieren kann. Dadurch kann der Cloud-Controller auf einen Public- oder Hybrid-Cloud-Anbieter ausgeweitet werden, ohne dass die Enterprise-Cloud-Plattform neu konzipiert werden muss.
Cluster-Controller/Hypervisor
Der Cluster-Controller ist die Komponente in der Enterprise-Cloud, die für die Verwaltung der bereitgestellten virtuellen Maschine sowie des für den Betrieb der VM erforderlichen Speichers und der Metadaten zuständig ist. Als Laufzeitumgebung der VM umfasst der Cluster-Controller den Hypervisor der virtuellen Plattform und kann darüber hinaus eine umfassendere Hypervisor-Verwaltungsumgebung beinhalten. So kann der Cluster-Controller beispielsweise ein einfacher Hypervisor wie VMware ESXi oder eine größere Sammlung verteilter Hypervisor-Systeme wie VMware vSphere oder VMware vCloud sein.
Überwachung
Die Überwachung von Systemzustand und Status ist ein wesentlicher Bestandteil jeder Bereitstellung von Unternehmensanwendungen. Die Überwachung liefert außerdem Statusaktualisierungen für Bereitstellungssysteme, beispielsweise wenn eine virtuelle Maschine betriebsbereit ist und auf Verbindungen im Netzwerk reagiert. Durch die kontinuierliche Überwachung des Systems können Echtzeitwarnungen ausgegeben werden, die letztlich in neue Workflows einfließen und Bereitstellungsentscheidungen beeinflussen. Für die Bereitstellung in der Enterprise-Cloud kann jede Komponente verwendet werden, die den Status von Anwendungen und Netzwerken überwachen kann. In der Referenzarchitektur von F5 und IBM kommt jedoch die Software IBM Tivoli Monitoring zum Einsatz.
DNS
Das Domain Name System (DNS) spielt in der Referenzarchitektur für Enterprise-Clouds von F5 und IBM eine entscheidende Rolle: Es speichert nicht nur IP- und Domänennameninformationen für IPv4 und IPv6, sondern auch Systemmetadaten, beispielsweise die vom Cloud-Controller erfassten Informationen und eindeutige Informationen zur Identifizierung von Maschinen. Für diese Referenzarchitektur wurde DNS als Speicherort für Metadaten gewählt, da es sich um ein standardbasiertes System handelt, das bereits in den meisten Netzwerken vorhanden ist, allen Cloud-Komponenten zur Verfügung steht und die Notwendigkeit beseitigt, die Infrastruktur um zusätzlichen datenbankähnlichen Speicher zu erweitern. Es kann jede von der IT verwaltete DNS-Lösung verwendet werden, die das Hinzufügen weiterer Zonen und Zonendateien ermöglicht.
Speicher
In der Referenzarchitektur von F5 und IBM führt der Cluster-Controller die virtuelle Maschine auf lokalem Speicher aus. Wenn sie jedoch nicht ausgeführt wird, befindet sich die virtuelle Festplatte der VM auf virtualisiertem Speicher. Während eines Workflow-Bereitstellungsereignisses fordert der Cluster-Controller die virtuelle Festplatte über das Network File System (NFS) vom virtuellen Speichergerät an.
Application Delivery Controller
Die letzte Komponente in der Enterprise-Cloud ist der Application Delivery Controller (auch als Lastverteiler bezeichnet), bei dem es sich in der Referenzarchitektur von F5 und IBM um den F5® BIG-IP® Local Traffic Manager™ (LTM) handelt. BIG-IP LTM verwaltet Verbindungen, Dienste und die Bereitstellung der von der virtuellen Maschine stammenden Anwendungsdaten. Letztlich ist BIG-IP LTM der letzte Teil des Systems, der auf ein Workflow-Bereitstellungsereignis reagiert.
Schritt-für-Schritt-Anleitungen: Manuelle und automatisierte Bereitstellung
Ziel der Referenzarchitektur für die Enterprise Cloud von F5 und IBM ist es, eine praxisnahe, ressourcenbasierte Plattform für die dynamische Bereitstellung von Anwendungen zu schaffen. Sobald alle Komponenten eingerichtet sind, arbeiten sie über verschiedene Workflows zusammen, um bei Bedarf neue Anwendungsdienste bereitzustellen. Für die Bereitstellung von Systemen in der Enterprise Cloud gibt es zwei Möglichkeiten: die manuelle und die automatisierte Bereitstellung.
Manuelle Bereitstellung
In der Regel wird der erste Workflow in der Enterprise-Cloud durch einen manuellen Prozess angestoßen, der auf Eingaben des Systemadministrators oder des Anwendungsanforderers basiert. Das bedeutet nicht, dass der Workflow manuell abläuft; lediglich die erstmalige Eingabe von Informationen in das System erfolgt manuell. Sobald die Daten des Administrators erfasst wurden, startet das System vordefinierte automatisierte Workflow-Ereignisse für die Anwendungsbereitstellung.
Schritt 1: Dateneingabe im Cloud-Controller
Über die grafische Benutzeroberfläche des Cloud-Controllers gibt der Administrator (oder der Anwendungsanforderer, je nachdem, wer für das Starten eines neuen Bereitstellungsvorgangs verantwortlich ist) die erforderlichen Informationen ein, um eine neue virtuelle Maschine zu starten und eine Anwendung online zu schalten. Bei diesen Informationen handelt es sich in der Regel um übergeordnete Infrastrukturdaten, wie zum Beispiel:
- Anwendungstyp: Eine vordefinierte Liste verfügbarer Anwendungstypen, z. B. Microsoft SharePoint, ein Webserver, ein Mailserver, eine Oracle-Datenbank usw.
- Netzwerkinformationen: Cluster-IP-Adresse, Front-End-URL, Angabe, ob diese Anwendung öffentlich zugänglich oder nur intern verfügbar sein soll, usw.
- Bereitstellungsinformationen: Alle zusätzlichen Informationen, die für das Bereitstellungssystem erforderlich sind, wie etwa der Netzwerkstandort (häufig eine geografische Angabe, die einem physischen Rechenzentrum zugeordnet ist, zum Beispiel „Europa – Rechenzentrum Kopenhagen“), sowie etwaige Einschränkungen hinsichtlich der minimal und maximal zulässigen Anzahl von Instanzen eines bestimmten Anwendungstyps.
Diese Informationen werden als Metadaten für die automatisierte Bereitstellung in der gesamten Unternehmens-Cloud verwendet.
Schritt 2: Bereitstellungsworkflow starten; Metadaten verteilen
Nachdem der Administrator die erforderlichen Daten übermittelt hat, fasst der Cloud-Controller diese Informationen im nächsten Schritt zusammen mit einer dynamisch erstellten, eindeutigen Instanz-ID – beispielsweise „vm12345“, die im gesamten System zur Identifizierung dieser Instanz für die Bereitstellung verwendet wird – zu einem Paket zusammen und übermittelt es über den Nachrichtenbus an den Orchestrator.
Alle im ersten Schritt bereitgestellten Informationen werden vom Nachrichtenbus normalisiert, bevor sie an den Orchestrator übermittelt werden.
Parallel dazu übermittelt der Cloud-Controller dem Hypervisor über eine API dieselben Metadaten und die eindeutige Instanz-ID und weist ihn an, das erforderliche Anwendungs-Image bereitzustellen. Daraufhin fordert der Hypervisor das entsprechende Festplatten-Image der virtuellen Maschine aus dem Cloud-Speicher an. Das Speichergerät ruft das entsprechende Festplatten-Image über NFS ab und beginnt, es in den lokalen Speicher zu kopieren.
Schritt 3: Der Orchestrator verteilt Metadaten
Nachdem der Orchestrator die normalisierten Ereignisinformationen und Metadaten vom Nachrichtenbus empfangen hat, startet er zwei verschiedene Workflows, die die Metadaten gleichzeitig an das bzw. die Überwachungssysteme und das DNS übertragen. Das bzw. die Überwachungssysteme verwenden diese Informationen, um einen automatisierten Überwachungsplan für die Anwendung zu konfigurieren, und beginnen mit der Überwachung, sobald sie benachrichtigt wurden, dass die Anwendung betriebsbereit ist. In diesem Schritt legt der Orchestrator außerdem Schwellenwerte für die Ereignisse des Überwachungssystems fest. Beispielsweise kann er das Überwachungssystem anweisen, eine Ereignisbenachrichtigung zu senden, wenn die CPU-Auslastung dieser virtuellen Instanz 75 Prozent überschreitet.
Der Orchestrator überträgt außerdem die Metadaten der virtuellen Instanz an das DNS, wo diese Daten zur Verwendung in der gesamten Unternehmens-Cloud gespeichert werden. Der Orchestrator ist dafür verantwortlich, die Metadaten im entsprechenden DNS-Zonenformat zu übermitteln. Dazu muss er auf Grundlage der Instanz-ID Domänennamen erstellen, IPv4- und IPv6-DNS-Einträge anlegen, Instanzinformationen aus dem Cloud-Controller hinzufügen und die Informationen zur neuen Instanz in die entsprechende Zone aufnehmen. Beispielsweise verwendet der Orchestrator die eindeutige Instanz-ID, erstellt einen DNS-Eintrag für „vm12345.vm.cloud.example.com“ und fügt diesen der bestehenden Zone example.com hinzu.
Der letzte Schritt bei der Verteilung von Metadaten in der gesamten Enterprise-Cloud besteht darin, den BIG-IP LTM Application Delivery Controller mit den Informationen zur neuen Instanz zu befüllen, beispielsweise mit Hostname, IP-Adresse, Anwendungstyp (oder Pool auf BIG-IP LTM) und Überwachungsinformationen.
Schritt 4: Benachrichtigung der virtuellen Maschine
In Schritt 2 hat der Cloud-Controller den Hypervisor angewiesen, die der neu bereitgestellten Instanz zugeordnete virtuelle Maschine zu starten. Sobald diese VM wie erwartet ausgeführt wird und für Verbindungen verfügbar ist, benachrichtigt sie den Orchestrator über eine Ereignismeldung auf dem Message Bus. Der Orchestrator verarbeitet diese Ereignismeldung und startet einen Workflow, der BIG-IP LTM anweist, die neue VM im Pool als verfügbar zu kennzeichnen und neue Verbindungen gemäß dem Lastverteilungsverfahren an die virtuelle Instanz zu senden und zu verteilen. BIG-IP LTM beginnt außerdem damit, die neue Instanz mithilfe des zuvor konfigurierten und dem Anwendungspool zugewiesenen Anwendungsmonitors zu überwachen.
Die Ereignismeldung der neu gestarteten VM veranlasst den Orchestrator außerdem, das zentrale Überwachungssystem der Enterprise Cloud zu benachrichtigen, damit es mit der Überwachung der virtuellen Instanz beginnt. Zu diesem Zeitpunkt ist die neu bereitgestellte virtuelle Instanz in der Enterprise Cloud betriebsbereit und verarbeitet Anfragen an Anwendungsdienste. Dies ist der normale Betriebsmodus aller Dienste, die Teil der Enterprise Cloud sind.
Automatisierte Bereitstellung
Die manuelle Bereitstellung ist der erste Schritt im Workflow zur Bereitstellung von Diensten innerhalb der Enterprise Cloud, jedoch nicht die häufigste Form der Bereitstellung. In einem reibungslos funktionierenden System entwickelt sich die Enterprise Cloud hin zu einem dynamischeren und flexibleren System mit Selbstüberwachung, das neue Dienste bei Bedarf und abhängig von der Nachfrage selbstständig bereitstellt. Diese agile Selbstbereitstellung bildet das Herzstück jeder Cloud-Plattform und erfordert zusätzliche automatisierte Bereitstellungsereignisse und Workflows, um Echtzeitereignisse zu überwachen und darauf zu reagieren.
Schritt 1: Überwachung und Warnmeldungen
Der erste Schritt eines jeden Systems zur automatischen Bereitstellung ist die Überwachung, also das systemweite Erfassen und Erkennen von Ereignissen. Bei der ersten manuellen Bereitstellung wurden die Überwachungssysteme mit Informationen zu den virtuellen Instanzen befüllt, beispielsweise mit Name, Standort, Art der Überwachung und Ereignisschwellenwerten. Anhand dieser Informationen werden die Verfügbarkeit und Leistung der Anwendungen und virtuellen Instanzen automatisch überwacht. Sobald das Überwachungssystem ein Ereignis erkennt – beispielsweise, dass eine bestimmte virtuelle Instanz mehr als 75 Prozent der verfügbaren CPU-Ressourcen beansprucht –, erzeugt es auf dem Nachrichtenbus ein Ereignis, das den Orchestrator auf die knappen Ressourcen hinweist.
Schritt 2: Datenerfassung
In einem typischen Szenario für die automatisierte Bereitstellung ist der Orchestrator dafür verantwortlich, eine neue virtuelle Instanz zu erstellen, um die aktuelle Instanz zu entlasten. Zwei oder mehr virtuelle Instanzen werden verwendet, um die Rechen- und Netzwerklast der Anwendung zu verteilen.
Um einen automatisierten Bereitstellungsworkflow zu starten, muss der Orchestrator Komponentenereignisse erfassen und die für die Bereitstellung einer neuen virtuellen Instanz erforderlichen Metadaten anfordern. In der Referenzarchitektur von F5 und IBM werden die Metadaten im DNS gespeichert und im Rahmen des ursprünglichen manuellen Bereitstellungsworkflows eingetragen. Das DNS liefert dem Orchestrator Informationen wie beispielsweise Anwendungstyp, geografischen Standort und Bereitstellungsschwellenwerte.
Schritt 3: Starten des Workflows
Im letzten Schritt eines automatisierten Bereitstellungsworkflows übermittelt der Orchestrator die vom DNS abgerufenen Metadaten über den Nachrichtenbus an den Cloud-Controller. Im Wesentlichen simuliert dieser automatisierte Schritt den Vorgang, bei dem ein Administrator die Rechnerinformationen eingibt und den Bereitstellungsworkflow manuell startet. Der Cloud-Controller übernimmt diese Informationen (genau wie bei einer manuellen Bereitstellung durch den Administrator) und startet einen neuen Workflow zur Bereitstellung einer virtuellen Instanz. Ab diesem Punkt werden die oben beschriebenen Bereitstellungsschritte und Workflows wiederholt, bis die neue virtuelle Instanz eingerichtet und betriebsbereit ist und neue Verbindungen annimmt.
Eine typische Enterprise-Cloud-Bereitstellung umfasst sowohl manuelle als auch automatisierte Provisionierungsabläufe. Neue Dienste oder Anwendungen werden zunächst mithilfe eines manuellen Ablaufs bereitgestellt, damit ein Administrator steuern kann, wie und wo der Dienst bereitgestellt wird. Sobald ein Dienst betriebsbereit ist, übernehmen die automatisierten Provisionierungsabläufe die bedarfs- und verfügbarkeitsabhängige Bereitstellung von Ressourcen.
Fazit
Die Entscheidung für die Bereitstellung einer privaten Enterprise-Cloud sollte nicht mit erhöhter Komplexität oder mangelnder Interoperabilität einhergehen. Ziel jeder Cloud-Bereitstellung ist es, die Hürden für die Entwicklung neuer Dienste zu senken und eine flexiblere IT-Infrastruktur bereitzustellen. Eine Enterprise-Cloud bringt diese Flexibilität in das Rechenzentrum und verbessert dadurch die Verwaltbarkeit und Kontrolle erheblich.
Gemeinsam mit IBM hat F5 eine Referenzarchitektur für eine automatisch bereitgestellte Enterprise Cloud entwickelt. Diese Architektur ist modular und flexibel konzipiert, sodass vorhandene Komponenten nach Bedarf integriert und die gesamte Enterprise Cloud über APIs und eine gemeinsame Messaging-Infrastruktur mit jeder anderen Cloud-Plattform verbunden werden kann. Keine private Enterprise Cloud gleicht der anderen. Die Architektur von F5 und IBM lässt sich jedoch an unterschiedliche Umgebungen anpassen und bietet die Vorteile einer agilen Infrastruktur für jede Anwendungsbereitstellung und jedes Rechenzentrum.
1 Babcock, Charles (18. Januar 2011). „Private Clouds im Aufwind.“ Information Week. Online.
VERÖFFENTLICHT AM 10. JANUAR 2012