アプリケーションパフォーマンス管理での変数の使用
変数はNGINXの設定において重要でありながら、見落とされることもある要素です。約150個の変数が用意されており、設定のあらゆる部分を強化できます。このブログ記事では、アプリケーションのパフォーマンス上のボトルネックを特定することに重点を置き、アプリケーショントレーシングとアプリケーションパフォーマンス管理(APM)にNGINX変数を使用する方法を解説します。この記事はNGINX Open SourceとNGINX Plusの両方に適用されます。簡潔にするため、両者に違いがある場合を除き、以降はNGINX Plusと表記します。
アプリケーションデリバリー環境
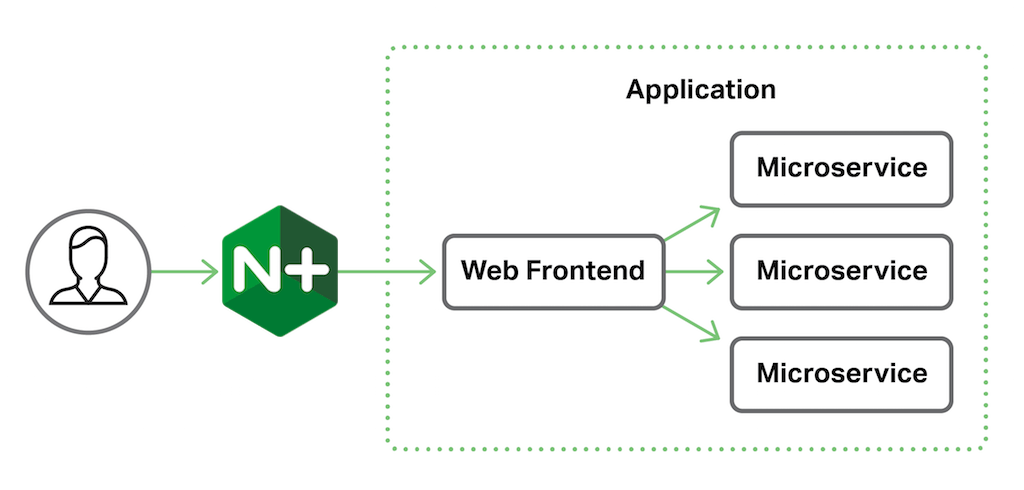
このサンプルアプリケーションデリバリー環境では、NGINX Plusがアプリケーションのリバースプロキシとして機能します。アプリケーション自体はWebフロントエンドと、その背後に配置された複数のマイクロサービスで構成されています。
リクエストのエンドツーエンドトレース
NGINX Plus R10(およびNGINX 1.11.0)では、$request_id変数が導入されました。この変数は、各HTTPリクエストの到着時に自動的に割り当てられる、ランダムに生成された32桁の16進数文字列です(例:444535f9378a3dfa1b8604bc9e05a303)。一見単純なこの仕組みにより、トレースとトラブルシューティングに役立つ強力なツールを利用できます。NGINX Plusとすべてのバックエンドサービスで$request_idの値を受け渡すように設定すると、各リクエストをエンドツーエンドでトレースできます。以下は、フロントエンドのNGINX Plusサーバー用の設定例です。
upstream app_server {    server 10.0.0.1:80;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id; # Pass to app server
    }
}
リクエストトレーシング用にNGINX Plusを構成するには、まずアプリケーションサーバーのネットワーク上の場所をupstreamブロックで定義します。ここでは簡略化のため、アプリケーションserverを1台だけ示していますが、通常は高可用性と負荷分散を実現するために複数台を使用します。
アプリケーションのserverブロックでは、NGINX Plusが受信HTTPリクエストを処理する方法を定義します。listenディレクティブは、HTTPトラフィックのデフォルトであるポート80でリッスンするようNGINX Plusに指示します。ただし、本番環境の構成では通常、転送中のデータを保護するためにSSL/TLSを使用します。
The add_headerディレクティブは、$request_idの値をレスポンス内のカスタムヘッダーとしてクライアントに返します。これはテストに役立つほか、モバイルアプリなど、独自のログを生成するクライアントアプリケーションにも有用です。クライアント側のエラーをサーバーログと正確に照合できるようになります。
最後に、locationブロックはアプリケーション空間全体(/)に適用され、proxy_passディレクティブはすべてのリクエストをそのままアプリケーションサーバーにプロキシします。proxy_set_headerディレクティブは、アプリケーションに渡されるHTTPヘッダーを追加して、プロキシされたリクエストを変更します。この例では、X-Request-IDという新しいヘッダーを作成し、$request_id変数の値を割り当てます。これにより、アプリケーションはNGINX Plusが生成したリクエストIDを受け取ります。
エンドツーエンドでのログ記録:$request_id End‑to‑End
アプリケーショントレーシングの目的は、アプリケーションパフォーマンス管理の一環として、リクエスト処理のライフサイクルにおけるパフォーマンス上のボトルネックを特定することです。そのために、処理中の重要なイベントをログに記録し、後から分析して、予期しない遅延や許容できない遅延がないかを確認します。
NGINX Plusの設定
まず、フロントエンドのNGINX Plusサーバーを設定し、カスタムログ形式「$request_id」にtraceを含めます。この形式はaccess_trace.logファイルで使用されます。
log_format trace '$remote_addr - $remote_user [$time_local] "$request" '                 '$status $body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id';

upstream app_server {
    server 10.0.0.1;
}

server {
    listen 80;
    add_header X-Request-ID $request_id; # Return to client
    location / {
        proxy_pass http://app_server;
        proxy_set_header X-Request-ID $request_id;        # Pass to app server
        access_log /var/log/nginx/access_trace.log trace; # Log $request_id
    }
}
バックエンドアプリケーションの設定
Request IDをアプリケーションに渡すだけでは、アプリケーション側でそれを利用しない限り、アプリケーショントレーシングには役立ちません。この例では、uWSGIで管理されるPythonアプリケーションを使用します。アプリケーションのエントリーポイントを変更し、Request IDをログ変数として取得できるようにします。
from uwsgi import set_logvar
def main(environ, start_response):
    set_logvar('requestid', environ['X_REQUEST_ID'])
次に、標準ログファイルにRequest IDが含まれるように、uWSGIの設定を変更します。
log-format = %(addr) - %(user) [%(ltime)] "%(method) %(uri) %(proto)" %(status) %(size) "%(referer)" "%(uagent)" %(requestid)この設定により、複数のシステムにまたがる単一のリクエストに関連付けられるログファイルを生成できるようになりました。
NGINXのログエントリ:
172.17.0.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.1" 200 90 "-" "-" "-" 5f222ae5938482c32a822dbf15e19f0fアプリケーションのログエントリ:
192.168.91.1 - - [02/Aug/2016:14:26:50 +0000] "GET / HTTP/1.0" 200 123 "-" "-" 5f222ae5938482c32a822dbf15e19f0fトランザクションをRequest IDフィールドと照合することで、SplunkやKibanaなどのツールを使用して、アプリケーションサーバーのパフォーマンス上のボトルネックを特定できます。たとえば、完了までに2秒を超えたリクエストを検索できます。ただし、通常のタイムスタンプではデフォルトの時間分解能が1秒であるため、実際の環境における大半の分析には不十分です。
高精度タイミング
リクエストをエンドツーエンドで正確に測定するには、ミリ秒レベルの精度を持つタイムスタンプが必要です。ログエントリに$msec変数を含めることで、各エントリのタイムスタンプをミリ秒単位で取得できます。アプリケーションログにミリ秒単位のタイムスタンプを追加すると、完了までに2秒ではなく200ミリ秒を超えたリクエストを特定できます。
しかし、それでも全体像を把握することはできません。NGINX Plusが$msecタイムスタンプを書き込むのは、各リクエストの処理が完了した時点に限られるためです。幸い、NGINX Plusにはミリ秒精度のタイミング変数がほかにもいくつかあり、処理自体をより詳しく把握できます。
$request_time– リクエスト全体の処理時間。NGINX Plusがクライアントから最初のバイトを読み取ってから、レスポンス本文の最後のバイトを送信するまで$upstream_connect_time– アップストリームサーバーとの接続確立に要した時間$upstream_header_time– アップストリームサーバーへの接続を確立してから、レスポンスヘッダーの最初のバイトを受信するまでの時間$upstream_response_time– アップストリームサーバーへの接続を確立してから、レスポンス本文の最後のバイトを受信するまでの時間
これらのタイミング変数の詳細については、「Using NGINX Logging for Application Performance Monitoring」を参照してください。
ここでは、log_formatディレクティブを拡張し、これらの高精度なタイミング変数をすべてtraceログ形式に含めます。
log_format trace '$remote_addr - $remote_user [$time_local] "$request" $status '                 '$body_bytes_sent "$http_referer" "$http_user_agent" '
                 '"$http_x_forwarded_for" $request_id $msec $request_time '
                 '$upstream_connect_time $upstream_header_time $upstream_response_time';
任意のログ分析ツールを使用して変数の値を抽出し、次の計算を行うことで、NGINX Plusがアプリケーションサーバーに接続する前にリクエストの処理に要した時間を確認できます。
NGINX Plus processing time = $request_time - $upstream_connect_time - $upstream_response_timeまた、$upstream_response_timeの最大値を検索し、特定のURIやアップストリームサーバーに関連しているかどうかを確認できます。その後、同じリクエストIDを持つアプリケーションログエントリと照合して、さらに詳しく確認できます。
まとめ
新しい「$request_id」変数と、ミリ秒精度の変数の一部またはすべてを活用することで、アプリケーションのパフォーマンス上のボトルネックを詳細に把握でき、負荷の大きいエージェントやプラグインに頼ることなく、アプリケーションパフォーマンス管理を改善できます。
NGINX Plusのアプリケーショントレーシングをぜひお試しください。今すぐ30日間の無料トライアルを開始するか、ユースケースについてご相談ください。
著者について

関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります