NGINX PlusとNGINX Open Sourceを使用してWebサイトやアプリの負荷を分散し、可用性と信頼性を最適化する方法については、これまで数多くの記事で紹介してきました。負荷分散は、アプリのパフォーマンス向上、大規模なアプリ配信、コンテナとマイクロサービスのデプロイを実現するための基本的な手段です。
これまで、NGINX Plusをデータセンター(従来のアプリケーションデリバリーコントローラーと併用する場合もあります)や、コンテナ、さらに、Amazon Web Services(AWS)、Google Cloud Platform、Microsoft Azureなどのクラウド環境に導入する方法を説明してきました。
本記事では、NGINX PlusとNGINXの負荷分散技術(負荷分散の方式またはアルゴリズムとも呼ばれます)に焦点を当て、ユースケースに応じた適切な方式の選び方をご紹介します。NGINXは4つの負荷分散技術(Round Robin、Hash、IP Hash、Least Connections)を提供し、NGINX Plusではさらに1つ(Least Time)が加わります。HTTPトラフィック向けの方式は、IP Hashを除き、すべてTCPでも利用できます(NGINX Plus Release 9以降ではUDPでも利用できます)。
[編集部注:NGINX Plus R16とNGINX Open Source 1.15.1では、負荷分散アルゴリズムとしてRandom with Two Choicesが追加されました。詳しくは、ブログ記事「NGINXと「Power of Two Choices」負荷分散アルゴリズム」をご覧ください。]
負荷分散手法の確認
ロードバランシングの基本的な設定方法をご存じであることを前提に説明します。復習したい場合は、以下のリソースをご覧ください。
- 「NGINX Plus Admin Guide」の記事では、全体像を網羅的に解説しています。
- 高性能ロードバランシングでは、負荷分散方式の効率をさらに高めることができるNGINX Plusの拡張機能について、詳しく解説した記事へのリンクを紹介しています。
- NGINXとNGINX Plusによる負荷分散のパート1とパート2では、NGINX Plusの拡張機能を活用して、シンプルなリバースプロキシを包括的な負荷分散ソリューションへと発展させる手順を解説しています。
- The 負荷分散ソリューションのページには、電子書籍、ウェビナー、ホワイトペーパーなどのその他のリソースへのリンクが掲載されています。
ここでは説明を簡単にするため、HTTPロードバランシングに焦点を当てます。HTTPロードバランシングは、httpコンテキストで設定します。一方、TCPロードバランシングは、streamコンテキストで設定します(NGINX Plus Release 9以降のUDPロードバランシングも同様です)。HTTPとTCP/UDPのロードバランサーは同等の機能を備えていますが、プロトコル固有の違いにより、利用できるディレクティブやパラメーターには多少の違いがあります。詳細については、HTTPおよびTCP/UDPのUpstreamモジュールに関するドキュメントを参照してください。
負荷分散を有効にするには、2つの設定ブロックを使用します。以下に、オプションのパラメーターや補助機能を含まない基本的な形式を示します。
- The
serverブロックは、指定した特性を持つトラフィックを待ち受け、名前付きのアップストリームサーバーグループにプロキシする仮想サーバーを定義します。ここで示す例では、仮想サーバーはデフォルトのポート(80)で、www.example.com宛てのHTTPトラフィックを待ち受け、backendというアップストリームサーバーグループにプロキシします。このブロックは、すべての例で共通です。
server {    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}- (NGINX PlusとNGINXは、FastCGI、memcached、SCGI、uwsgiのバックエンドサーバーの負荷分散も可能です。
proxy_passを適切なディレクティブ(fastcgi_pass、memcached_pass、scgi_pass、またはuwsgi_pass)に置き換えてください。) - The
upstreamブロックでは、アップストリームグループに名前を付け、そのグループに属するサーバーをホスト名、IPアドレス、またはUNIXドメインソケットのパスで指定して列挙します。この例では、backendというアップストリームグループに、web1、web2、web3の3台のサーバーが含まれています。upstreamブロックでは負荷分散方式を指定するため、以降のセクションではこのブロックに注目します。例として、デフォルトの方式であるラウンドロビンのブロックを以下に示します。
upstream backend {    server web1;
    server web2;
    server web3;
}
ラウンドロビン
ラウンドロビンは、NGINX PlusとNGINXの両方でデフォルトの負荷分散方式です。ロードバランサーはアップストリームサーバーのリストを順にたどり、接続リクエストを各サーバーに順番に割り当てます。
以下のbackendアップストリーム グループの設定例では、ロードバランサーは最初の3件の接続リクエストを、web1、web2、web3の順に送信し、4件目をweb1、5件目をweb2に送信します。以降もこの順序を繰り返します。
upstream backend {    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
ハッシュ
Hash方式では、ロードバランサーはリクエストごとに、指定されたテキストとNGINX変数の組み合わせに基づいてハッシュを計算し、いずれかのサーバーに関連付けます。同じハッシュを持つすべてのリクエストをそのサーバーに送信するため、この方式で基本的なセッション永続性が実現します。
次の例では、hashディレクティブは、リクエストのスキーム(httpまたはhttps)と完全なURIを基にハッシュを計算します。
upstream backend {    hash $scheme$request_uri;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
IPハッシュ
IP Hash(HTTPでのみ利用可能)は、クライアントのIPアドレスに基づいてハッシュ値を生成する、Hash方式の定義済みのバリエーションです。ip_hashディレクティブで設定します。
upstream backend {    ip_hash;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
クライアントのIPアドレスがIPv6の場合、アドレス全体に基づいてハッシュが計算されます。IPv4の場合は、アドレスの最初の3オクテットのみに基づいてハッシュが計算されます。これは、サブネット(/24)の範囲からIPアドレスが動的に割り当てられるISPのクライアント向けに最適化するための設計です。再起動や再接続の際には、クライアントのアドレスが同じ/24ネットワーク範囲内の別のアドレスに変わることがよくありますが、接続元は依然として同じクライアントであるため、サーバーへのマッピングを変更する理由はありません。
ただし、サイトへのトラフィックの大半が同じ/24ネットワーク上のクライアントからの場合、IP Hashはすべてのクライアントを同じサーバーにマッピングするため、適していません。その場合(または別の理由で4つのオクテットすべてに基づいてハッシュ値を計算したい場合)は、代わりにHash方式を使用し、$remote_addr変数を指定してください。
hash $remote_addr;最少接続数
Least Connections方式では、ロードバランサーが各サーバーとの現在のアクティブ接続数を比較し、接続数が最も少ないサーバーにリクエストを送信します。この方式は、least_connディレクティブで設定します。
upstream backend {
    least_conn;

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
Least Time
Least Time方式(NGINX Plusでのみ利用可能)では、ロードバランサーが各サーバーの2つの指標(現在のアクティブ接続数と過去のリクエストに対する応答時間の加重平均)を数式で組み合わせ、算出した値が最も小さいサーバーにリクエストを送信します。
Your choice of parameter on the least_timeディレクティブで指定するパラメーターによって、追跡する応答時間が決まります。応答ヘッダーを受信するまでの時間(header)、または応答全体を受信するまでの時間(last_byte)のいずれかを選択できます。
upstream backend {    least_time (header | last_byte);

    server web1;
    server web2;
    server web3;
}

server {
    server_name www.example.com;

    location / {
       proxy_pass http://backend;
    }
}
注記:
- TCPおよびUDPの負荷分散(
streamコンテキスト内)では、least_timeディレクティブに以下のパラメーターを指定することで、3種類の応答時間から選択できます。connect– アップストリームサーバーへの接続にかかる時間first_byte– 応答データの最初のバイトを受信するまでの時間last_byte– 応答データの最後のバイトを受信するまでの時間
- HTTPとTCP/UDPのどちらのトラフィックでも、NGINX Plus R12以降では、
inflightパラメーターを追加すると、未完了の接続が各メトリックに含まれます。それより前のリリースでは、こうした接続はデフォルトで含まれます。
負荷分散方式の選択
では、Webサイトやアプリに最適な負荷分散手法は、どのように選べばよいのでしょうか。
トラフィックのパターンはサイトごとに大きく異なり、同じサイトでも時間帯によって変化します。そのため、トラフィックが突発的に増えるか安定しているか、接続時間が短いか長いかといった単一の特性だけで負荷分散方式を選ぶのは適切ではありません。こうした点を踏まえ、検討する選択肢を絞り込めるよう、各方式の長所と短所を見ていきます。
各方式を比較するためのテストの実施
どの負荷分散方式を候補にする場合でも、実際にテストを行い、トラフィックに最も適した方式を確認することをお勧めします。「最も適した方式」とは通常、クライアントにレスポンスを返すまでの時間が最も短い方式を指しますが、別の基準で評価する場合もあるでしょう。
アプリケーションパフォーマンス管理ツールは、このようなテストに非常に役立ちます。アップストリームグループ内の各サーバーのグラフを表示するカスタム画面を作成できるため、テスト中に変化する値をリアルタイムで比較できます。NGINX PlusとNGINX向けのカスタムプラグインを提供しているAPMには、AppDynamics、Datadog、Dynatrace、New Relicなどがあります。
すべてのサーバーの処理能力が同じであれば、テストは最も簡単です。異なる場合は、処理能力の高いマシンがより多くのリクエストを受信するように、サーバーの重みを設定する必要があります。以下の「サーバーの処理能力が異なる場合の重みの設定」を参照してください。
テスト中に確認する主な指標は次のとおりです。
- CPUとメモリの負荷:CPUとメモリそれぞれについて、総容量に対する使用率を確認します。すべてのサーバーに均等に負荷がかかっていない場合、トラフィックが効率的に分散されていません。
- サーバーの応答時間:一部のサーバーで応答時間が他のサーバーよりも常に長い場合は、何らかの理由で「負荷の高い」リクエスト(より多くの計算処理や、データベースまたは他のサービスへの呼び出しを必要とするリクエスト)が、そのサーバーに偏って振り分けられています。負荷分散方式の問題ではなく、重み付けが適切でないことが偏りの原因である可能性があるため、重み付けを調整してみてください。
- クライアントへの応答にかかる合計時間 – これも、一部のサーバーで一貫して長い場合は、処理に時間のかかるリクエストが偏って割り振られていることを示唆しています。この場合も、重みを調整して問題が解消するかどうかを確認できます。
- エラーと失敗したリクエスト — テスト中に発生するリクエストの失敗やその他のエラーの件数が、サイトの通常時よりも多くなっていないことを確認する必要があります。そうしないと、実際のトラフィックではなく、エラーが発生している状況に基づいて判断することになります。エラーによっては、リクエストが成功した場合よりもサーバーが速く応答できることがあります。たとえば、HTTPレスポンスコード
404(FileNotFound)の場合、ファイルが実際に存在していてそれを配信する場合よりも、サーバーははるかに速くエラーを返すと考えられます。Least ConnectionsおよびLeast Timeロードバランシングアルゴリズムでは、このためにロードバランサーが、実際には正常に動作していないサーバーを優先する可能性があります。
長所、短所、ユースケース
それでは、各負荷分散手法の利点と欠点、特に適したユースケースを見ていきましょう。大半のユースケースに対する適合度が低い手法から順に説明します。先に結論を述べると、最も幅広いユースケースで最適な選択肢となるのはLeast Connections(NGINX PlusではLeast Timeも含む)と考えています。
HashとIP Hash
HashおよびIP Hashの負荷分散手法では、クライアントリクエストの種類(ハッシュ値に反映されます)と特定のサーバーの間に固定の関連付けを作成します。これはセッション永続性としてご存じかもしれません。同じハッシュ値を持つリクエストは、すべて常に同じサーバーに送信されます。
これらの方式の最大の欠点は、サーバー間でリクエスト数を均等に分散できる保証がなく、まして負荷を均等に分散できる保証もないことです。ハッシュアルゴリズムは、取り得るすべてのハッシュ値の集合を、アップストリームグループ内の各サーバーに対応する「バケット」に均等に分割します。しかし、実際に発生するリクエストのハッシュ値が均等に分布するかどうかは予測できません。たとえば、10台のクライアントがサイトにアクセスしていて、IP Hashアルゴリズムが、たまたま7個のIPアドレスのハッシュ値をweb1に、1個をweb2に、2個をweb3に関連付けたとします。この場合、web1サーバーは、他のサーバーが受信するリクエストの合計の2倍を超える数のリクエストを受信することになります。
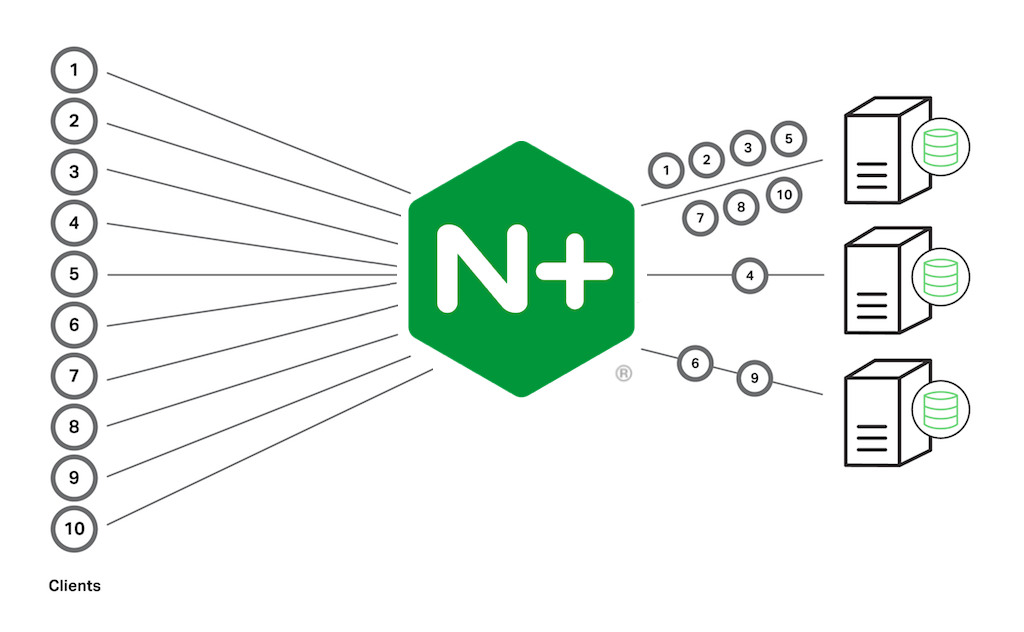
そのため、セッションを維持するメリットが負荷の偏りによる悪影響の可能性を上回る場合は、HashまたはIP Hashを使用するのが合理的です。NGINXで利用できるセッション永続化の方式は、この2つのみです。NGINX Plusには、このほかに3つのセッション永続化の仕組みが用意されています。これらはより高度で、実際の負荷分散と組み合わせて機能します(設定にはstickyディレクティブを使用します)。ただし、次の場合にはこれら3つの仕組みが機能しないため、NGINX PlusでもHashまたはIP Hashを選択することがあります。
- ブラウザーまたはクライアントアプリがCookieを受け入れず、アプリケーションにもCookieなしでセッション維持の仕組みを利用する方法がありません。この場合は、IP Hash方式を使用して、各クライアント(具体的にはそのIPアドレス)を特定のサーバーに関連付けます。
- サーバー自体のキャッシュを活用するために、特定のURLへのリクエストを毎回同じサーバーに送信したい場合です。Hash方式で
$request_uri変数を使用すると、毎回同じサーバーからファイルを取得できます。たとえば、ある.phpファイルを配信するには時間のかかるデータベース呼び出しが複数回必要であるものの、取得したデータはあまり変化せず、キャッシュできるとします。そのファイルへのすべてのリクエストを同じサーバーに送信すれば、データベース呼び出しによる長い待ち時間が発生するのは最初のクライアントだけです。それ以降のクライアントに対しては、キャッシュからデータをすばやく取得できます。また、そのデータセットをキャッシュする必要があるのは1台のサーバーだけという利点もあります。すべてのサーバーで同じデータを重複してキャッシュせずに済むため、キャッシュサイズを小さくできます。
IP Hash、およびクライアントIPアドレスをキーに含むHashが機能しないケースがいくつかあります。
- モバイルクライアントがWiFiネットワークから携帯電話ネットワークに切り替わる場合など、セッション中にクライアントのIPアドレスが変わる可能性がある場合。
- 多数のクライアントからのリクエストがフォワードプロキシを経由する場合。すべてのリクエストでプロキシのIPアドレスが使用されるためです。
ハッシュは決定的です(ハッシュアルゴリズムは毎回同じ結果を返します)。これには、2つの利点があります。デプロイ内のすべてのNGINX PlusまたはNGINXインスタンスがまったく同じ方法でリクエストを負荷分散し、ロードバランサーを再起動してもハッシュとサーバーの対応関係が維持されます。(実際には再起動後に再計算されますが、結果は常に同じであるため、実質的に維持されます。)
一方、アップストリームサーバーの構成を変更すると、通常は少なくとも一部のマッピングの再計算が必要になり、セッションの永続性が失われます。再計算するマッピングの数は、次の方法である程度減らすことができます。
- Hash方式では、
consistentパラメーターをhashディレクティブに追加します。NGINX Plusはketamaハッシュアルゴリズムを使用するため、再マッピングが少なくなります。 - IP Hash方式では、アップストリームグループからサーバーを一時的に削除する前に、そのサーバーの設定に
downパラメーターを追加します。追加先はserverディレクティブです。次の例のweb2を参照してください。サーバーがまもなくサービスに復帰することを前提として、マッピングは再計算されません。
upstream backend {    ip_hash;

    server web1;
    server web2 down;
    server web3;
}
ラウンドロビン
前述のとおり、ラウンドロビンはNGINX PlusとNGINXのデフォルトの負荷分散方式です。アップストリームグループ自体の設定以外に追加の設定は不要なため、最も手軽に選べる方式です。
一般的に、ラウンドロビンが最も効果的に機能するのは、サーバーやリクエストの特性によって、一部のサーバーに他のサーバーよりも負荷が集中し、過負荷になる可能性が低い場合とされています。その条件として、次のようなものが挙げられます。
- すべてのサーバーの処理能力がほぼ同じであること。サーバー間の違いがサーバーの重み付けに正確に反映されている場合、この要件の重要性は低くなります。
- すべてのサーバーが同じコンテンツをホストしています。
- 各リクエストに必要な時間や処理能力は、ほぼ同程度です。リクエストの処理負荷に大きなばらつきがあると、ロードバランサーがたまたま負荷の高いリクエストを短時間に多数、同じサーバーに送信し、そのサーバーが過負荷になる可能性があります。
- トラフィック量が、サーバーの処理能力の上限近くに頻繁に達するほど多くないこと。サーバーにすでに高い負荷がかかっている場合、ラウンドロビン方式で機械的にリクエストを振り分けると、前の項目で説明したように、一部のサーバーが限界を超えて過負荷状態になる可能性が高まります。
ラウンドロビンは、すべてのサーバーにリクエストを同数ずつ(または適切に重み付けされた比率で)確実に分散するため、特にテスト用途に適しています。他の方式では、トラフィック量が少ない場合に必ずしも均等に分散されず、テスト結果に偏りが生じることがあります。
均等に分散されることで、キャッシュが正常に機能し、容量を十分に活用しているかどうかも確認できます。ラウンドロビンでは、特定のファイルへのリクエストを同じサーバーに送ることができないため、各サーバーが幅広いファイルを配信してキャッシュする傾向があります(通常、その多くは他のサーバーでも配信・キャッシュされるファイルです)。その結果、キャッシュがいっぱいになりやすくなります。
最後に、初期の均等な分散は、NGINX Plusのセッション永続性(stickyディレクティブで設定)に関する問題の発見に役立ちます。
最小接続数と最短時間
前述のとおり、Least Connectionsは、最も幅広いユースケース、特に本番環境のトラフィックに最適な負荷分散手法です。お客さまから寄せられた経験談も、これを裏付けています。パフォーマンスは安定しており、予測可能です。
Least Connectionsは、各サーバーの処理能力に応じてワークロードを効果的に分散します。処理能力の高いサーバーはリクエストをより迅速に処理するため、どの時点でも、処理中(または処理の開始待ち)の接続数は、処理能力の低いサーバーより少ない傾向にあります。Least Connectionsは、現在の接続数が最も少ないサーバーに各リクエストを送信するため、処理能力の高いサーバーにリクエストを送信する可能性が高くなります。(ただし、後述の「サーバーの処理能力が異なる場合の重みの設定」で説明するように、重みを設定すると、リクエストをさらに効率的に分散できます。)
Least Time(NGINX Plusのみ)は、Least Connectionsよりもサーバーの状態にきめ細かく反応する方式と考えることができます。平均応答時間を判断に含めることで、サーバーの直近のパフォーマンス履歴を考慮します(実際には指数加重移動平均を使用するため、古い応答時間が平均値に与える影響は、最近の応答時間よりも小さくなります)。
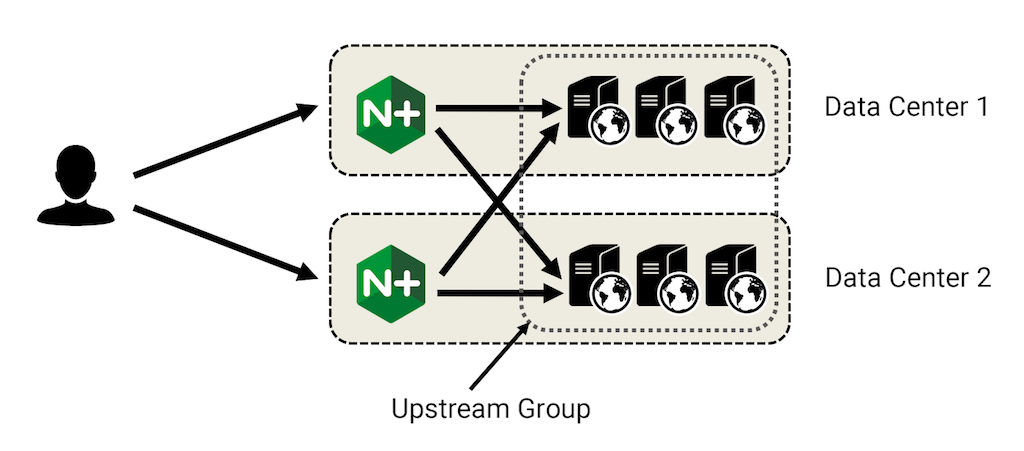
Least Timeは、アップストリームサーバー間で平均応答時間が大きく異なる場合に特に適しています。たとえば、ディザスターリカバリーのために異なるデータセンターにサーバーを配置している場合、Least Timeは応答の速いローカルサーバーにより多くのリクエストを送信する傾向があります。また、サーバーのパフォーマンスが非常に予測しにくいことの多いクラウド環境にも適しています。
サーバーの性能が異なる場合の重みの設定
アップストリームグループ内のサーバーの処理能力が異なる場合に、サーバーの重みを設定することの重要性については、これまで何度か説明してきました。特にラウンドロビン方式のロードバランサーでは、重みを設定しないと各サーバーに同じ数のリクエストが送信されるため、この設定が重要です。重みを設定しない場合、処理能力の高いサーバーに余力がある一方で、処理能力の低いサーバーに過剰な負荷がかかる可能性が高くなります。
重みを設定するには、weightパラメーターを1つ以上のserverディレクティブに指定します。これらのディレクティブはupstreamブロック内にあります。デフォルト値は1です。
各負荷分散方式で重みを設定した場合の効果は、以下のように考えることができます。ただし、これらの説明は概念的には正しいものの、NGINX Plusのコード実装で、説明に示した数学的演算が必ずしも使用されているわけではない点にご注意ください。以下は、説明の例で使用するupstreamグループです。
upstream backend {    server web1 weight=6;
    server web2 weight=3;
    server web3;
}- ラウンドロビン – 各サーバーには、そのサーバーの重みをすべてのサーバーの重みの合計で割った比率で、受信リクエストが振り分けられます。この例では、10件のリクエストごとに、web1には6件(60%)、web2には3件(30%)、web3には1件(10%)が振り分けられます。
- HashとIP Hash – 重みを設定しない場合、ハッシュアルゴリズムは、取り得るすべてのハッシュ値を、アップストリームグループ内の各サーバーに1つずつ割り当てた「バケット」に均等に分割します。重みを設定した場合は、重みの合計と同じ数のバケットにハッシュ値を均等に分割し、各サーバーにその重みと同じ数のバケットを関連付けます。この例では、バケットは10個あり、それぞれに取り得るハッシュ値の10%が含まれます。6個のバケット(取り得るハッシュ値の60%)がweb1に、3個のバケット(30%)がweb2に、1個のバケット(10%)がweb3に関連付けられます。
- Least ConnectionsとLeast Time:前述のとおり、これらのアルゴリズムは、重みを設定しなくても、各サーバーの処理能力に応じてワークロードを効果的に分散します。重みを設定すると、この点での性能がさらに向上します。Least ConnectionsとLeast Timeは、それぞれ「スコア」(前者は接続数、後者は接続数と時間を数式で組み合わせた値)が最も低いサーバーに各リクエストを送信します。重みを設定した場合、ロードバランサーは各サーバーのスコアをその重みで割り、その結果が最も低いサーバーにリクエストを送信します。ここでは、例として示した重みとアクティブ接続数を使って、Least Connectionsの動作を説明します。web1のスコアは100で最も低いため、このサーバーにリクエストが送信されます。接続数は600で、web2の1.5倍、web3の4倍超であっても、結果は変わりません。
- web1 – アクティブな接続数600 ÷ 6 = 100
- web2 – アクティブな接続数400 ÷ 3 = 133
- web3 – アクティブな接続数125 ÷ 1 = 125
まとめ
NGINX PlusとNGINXで利用可能な負荷分散手法の長所と短所を検討した結果、最も幅広いユースケースに適しているのはLeast Connections(NGINX PlusではLeast Timeも含む)と考えます。ただし、実際の環境で複数の手法をテストすることが重要です。トラフィックとサーバーの特性の組み合わせは環境ごとに異なるため、別の手法のほうが適している可能性があります。
NGINX Plusのロードバランシングを実際にお試しいただくには、30日間の無料トライアルを本日開始するか、ユースケースについてお問い合わせください。
さまざまなユースケースでの負荷分散のご経験を、ぜひお聞かせください。以下のコメント欄にご投稿ください。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。
SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります