著者注 – このブログ記事はシリーズの第6回です:
- NGINXのマイクロサービスリファレンスアーキテクチャのご紹介
- MRA、第2部:プロキシモデル
- MRA、第3部:ルーターメッシュモデル
- MRA、第4部:ファブリックモデル
- MRA、第5部:Twelve-Factor Appをマイクロサービス向けに適応
- MRA、第6部:NGINX Plusによるサーキットブレーカーパターンの実装(本記事)
全6回のブログ記事に、「マイクロサービスアプリケーション向けWebフロントエンド<.htmla>」に関する記事を加え、無料のeBookとしてまとめました。
マイクロサービスに関する以下のNGINXリソースもご覧ください。
- Chris Richardson氏による、非常に有用で人気の高いシリーズ:マイクロサービスアプリケーションの設計
- Chris Richardson氏の記事をまとめた無料の電子書籍。NGINXおよびNGINX Plusを使用してマイクロサービスを実装するための追加のヒントも収録しています
- その他のマイクロサービスに関するブログ記事
- マイクロサービスに関するウェビナー
マイクロサービスを採用したアプリケーション設計により、アプリケーションの動作の仕組みは根本から変わりました。マイクロサービスアーキテクチャにおける「アプリケーション」は、相互に依存しながらタスクを実行し、機能を提供するサービスの集合体です。複雑なアプリケーションでは、サービスグラフが非常に深くなり、各サービス間に複数の相互依存関係が生じることがあります。
たとえば、ユーザーサービスは、そのサービスが提供するデータに依存する他の多くのサービスにとって不可欠な場合があります。この場合、ユーザーサービスに障害が発生すると、アプリケーション全体で障害が連鎖する可能性があります。
The Circuit Breakerパターンは、Martin Fowlerによって広く知られるようになった用語で、サービス障害の連鎖を回避するためのアプリケーション設計パターンとして、マイクロサービスアーキテクトの間で普及しつつあります。Circuit Breakerパターンでは、アプリケーションサービスとサービス間のトラフィックを監視することで障害を防ぎ、障害が発生した場合にはアプリケーションへの影響を最小限に抑えます。
マイクロサービスにとって、Circuit Breakerパターンは特に有用であり、ボトムアップのレジリエンスを実現します。適切に実装すれば、サービスが利用できない場合でもサービスの継続性を確保し、連鎖的な障害の回避に役立ちます。Circuit Breakerパターンは、Netflixが採用したことで特に広く知られており、同社のアプリケーション設計思想における重要な要素となっています。
障害を避けるのではなく、受け入れる
モダンアプリケーション設計の重要な原則の1つは、障害は発生するものだと考えることです。モダンアプリケーションは、クラウドでホストされる仮想マシンから、コンテナ、アプリケーションライブラリ、動的ネットワーキングに至るまで、多層構造に依存しているため、あらゆるアプリケーションに非常に多くの可動要素が存在します。アプリケーションを構成する1つ以上の要素が、いつか何らかの形で機能しなくなることを前提にする必要があります。障害を想定し、その影響を軽減する仕組みを組み込むことで、アプリケーションのレジリエンスを大幅に高めることができます。
サーキットブレーカーパターンの最も重要な目標の1つは、障害を未然に防ぐことです。メモリ不足など、一部のエラー状態では、障害が差し迫っていることを検知し、予防措置を講じることができます。通常は、サービスが異常な状態であることを通知し、サーキットブレーカーがリクエスト数を抑制するか、リクエストをすべて別の経路に切り替えることで、サービスに復旧の機会を与えます。サービスの復旧後も、すぐに過負荷となって再び異常な状態に陥るリスクを避けるため、サーキットブレーカーでサービスへのリクエストを徐々に増やすことが賢明です。
In the NGINX Microservices Reference Architectureには、resizerというサービスがあります。大きな写真がシステムにアップロードされると、resizerは写真を展開し、向きを補正してから2段階で縮小し、補正済みの元画像とサイズ変更後の2つの画像をオブジェクトストアに保存します。このような処理の性質上、resizerはアプリケーション内でプロセッサーとメモリを最も多く使用する部分です。
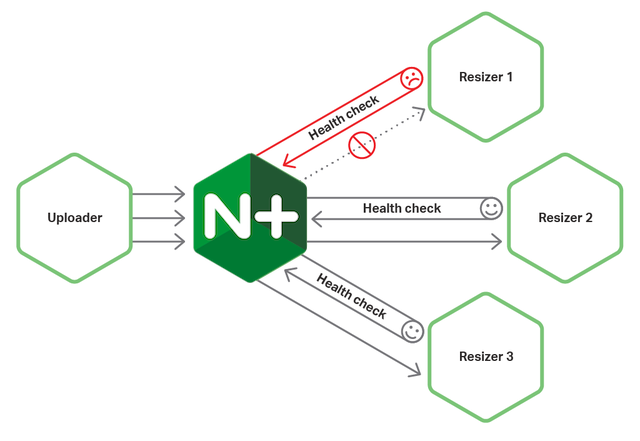
多数の画像を同時にサイズ変更すると、resizerのメモリが不足し、場合によっては完全に停止することがあります。この問題を回避するため、resizerサービスのインスタンスと、そこに画像を送るuploaderサービスの間にサーキットブレーカーを配置します。uploaderは、resizerインスタンスの正常性ステータスを定期的に照会します。この照会を受けると、resizerは利用可能なメモリの80%を超えて使用していないかなどの正常性チェックを実行し、その正常性ステータスをuploaderに返します。
リサイザーインスタンスが異常な状態であることを示した場合、アップローダーは、図1に示すようにリクエストを他のインスタンスにルーティングする一方で、そのリサイザーインスタンスが復旧したかどうかを継続的に確認します。リサイザーインスタンスが再び正常な状態であることを示すと、ロードバランシング対象のプールに戻され、アップローダーはそのインスタンスへのトラフィックを徐々に増やして最大処理能力まで引き上げます。この設計により、リサイザーインスタンスの完全な停止や、処理が開始されたまま完了しない事態を防ぎ、本来であれば処理に失敗するユーザーが過度に待たされることを回避するとともに、システムが受信するリクエストストリームを可能な限り効率的に処理できるようにします。
サーキットブレーカーパターンで一貫性を向上
NGINXレベルでサーキットブレーカーを実装する利点の1つは、マイクロサービスアプリケーション全体のサーキットブレーカーを管理するための、汎用的で一貫性があり、柔軟性の高いレイヤーを構築できることです。この汎用性と一貫性により、言語ごとに異なるサーキットブレーカーライブラリの細かな仕様や不整合に対応するための管理や実装が不要になります。
サーキットブレーカー機能の大部分を各サービスのコードに組み込まず、代わりにNGINX Plusに実装することで、次のような多くのメリットが得られます。
- たとえば、Javaで記述されたサービスにもPHPで記述されたサービスにも同じサーキットブレーカーを使用でき、必要に応じてサーキットブレーカー自体をさらに別の言語で記述することもできます
- 各サービスで使用する言語やサポートライブラリが異なっていても、サーキットブレーカー機能をそれぞれ再実装する必要がありません
- サーキットブレーカーのコードを組み込む必要がなくなるため、各サービスが簡素化され、実行速度が向上するほか、作成、デバッグ、運用、保守も容易になります
- 各サービスのサポートコードが簡素化され、使用するライブラリとシステムの組み合わせを、そのサービスの中核機能に必要なものだけに絞ることができます
- サーキットブレーカーのコードは1か所にのみ存在するため、各所のコンテキストに対応する必要がなく、必要不可欠な要素だけに絞って簡素化できます
- サーキットブレーカーのコードでは、キャッシュなどのNGINX Plusの機能を活用できるため、はるかに強力になります
- NGINX Plusレベルのサーキットブレーカーコードを細かく調整し、他のアプリケーションや、オンプレミス、各種クラウドプラットフォーム、ハイブリッド環境などのさまざまなデプロイプラットフォームで再利用できます
ただし、NGINX Plusだけではサーキットブレーカーを実装できない点に注意が必要です。真のサーキットブレーカーを実現するには、指定されたURI(通常は/health)で、サービスが自身の内部状態を確認するアクティブヘルスチェックを提供する必要があります。このヘルスチェックは、そのサービス固有の要件に適したものでなければなりません。
ヘルスチェックを開発する際は、サービスの障害特性と、データベース接続エラー、メモリ不足、ディスク容量不足、CPUの過負荷など、障害を引き起こす可能性のある条件を把握する必要があります。ヘルスチェックではこれらの条件を評価し、正常または異常のいずれかのステータスを返します。
サーキットブレーカーパターンがもたらす柔軟性
ここで説明するように、NGINXレベルでサーキットブレーカーパターンを実装した場合、サービスインスタンスから異常な状態であることが通知された際の処理はNGINX Plusが担います。これには複数の選択肢があります。
1つ目の選択肢は、リクエストを正常な他のインスタンスにリダイレクトし、異常なインスタンスが回復したかどうかを確認するために問い合わせを継続することです。2つ目は、サービスをリクエストしたクライアントにキャッシュ済みのレスポンスを提供し、サービスが利用できない場合でも安定性を維持する方法です。このソリューションは、コンテンツサービスなど、読み取り中心のサービスに適しています。
もう1つの選択肢は、代替データソースを用意することです。たとえば、F5のお客さまは、プロファイルデータを使用してユーザーにターゲティング広告を配信するパーソナライズ広告サーバーを運用しています。このサーバーが停止した場合、ユーザーのリクエストはバックアップサーバーにリダイレクトされ、すべてのユーザーに適した一般的な広告が配信されます。この代替データソースを利用するアプローチは、非常に有効です。
最後に、サービスの障害特性を明確に把握している場合は、サーキットブレーカーにレート制限を追加することで、障害を軽減できます。サービスへのリクエストは、そのサービスが処理可能なレートに限って通過します。これにより、サーキットブレーカー内にバッファーが設けられ、トラフィックの急増を吸収できるようになります。
レート制限は、Router Mesh Modelのような一元型の負荷分散シナリオで特に効果を発揮します。このシナリオでは、アプリケーショントラフィックが限られた数のロードバランサーを経由するため、サイト全体の総トラフィック使用量を的確に把握できます。
NGINX Plusでのサーキットブレーカーパターンの実装
前述のとおり、サーキットブレーカーパターンでは、異常なサービスへのトラフィックを減らすか、リクエストを別のサービスにルーティングすることで、障害を未然に防ぐことができます。そのためには、各サービスの内部状態を監視するヘルスモニターと連携したアクティブヘルスチェックが必要です。残念ながら、パッシブヘルスチェックでは障害が発生してから検出するため、予防措置を講じるには手遅れであり、この役割を果たせません。このため、パッシブヘルスチェックのみをサポートするNGINX Open Sourceでは、サーキットブレーカーパターンを実装できません。
一方、NGINX Plusは堅牢なアクティブヘルスチェックシステムを備えており、正常性の問題を確認して対応するための多様なオプションを提供します。Microservices Reference Architectureにおけるいくつかのサービスタイプの実装を見ると、サーキットブレーカーを実装する際のオプションとユースケースを具体的に把握できます。
まず、resizerに接続するuploaderサービスから見ていきます。uploaderは画像をオブジェクトストアに格納した後、resizerに画像を開いて補正し、サイズを変更するよう指示します。この処理では、コンピューティングリソースとメモリを大量に消費します。resizerは稼働中のホストを実際に停止させる可能性があるため、uploaderはresizerの健全性を監視し、過負荷を回避する必要があります。
まず、リサイザーのヘルスチェック専用のlocationブロックを作成します。このブロックはinternalロケーションであるため、サーバーの標準URL(http://example.com/health-check-resizer)へのリクエストではアクセスできません。代わりに、ヘルスチェック情報のプレースホルダーとして機能します。health_checkディレクティブは3秒ごとに/health URIへヘルスチェックを送信し、conditionsという名前のmatchブロックで定義されたテストを使用して、サービスインスタンスの正常性を確認します。サービスインスタンスは、チェックに1回失敗すると異常と判定されます。proxy_*ディレクティブは、指定されたHTTPヘッダーをnullに設定し、HTTP 1.1上のTLS 1.2を使用して、resizerアップストリームグループにヘルスチェックを送信します。
location /health-check-resizer {    internal;
    health_check uri=/health match=conditions fails=1 interval=3s;


    proxy_pass                        https://resizer;
    proxy_ssl_session_reuse           on;
    proxy_ssl_protocols               TLSv1.2;
    proxy_http_version                1.1;
    proxy_set_header Connection       "";
    proxy_set_header Accept-Encoding  "";
}次に、正常および異常な状態を示すレスポンスを指定するため、conditionsのmatchブロックを作成します。最初にレスポンスのステータスコードを確認します。ステータスコードが200~399の範囲内であれば、次の評価ステートメントに進みます。2つ目に、Content-Typeがapplication/jsonであることを確認します。最後に、deadlocks、Disk、Memoryの各メトリクスの値が正規表現に一致するかを確認します。すべて正常であれば、サービスは正常と判定されます。
match conditions {    status 200-399;
    header Content-Type ~ "application/json";
    body ~ '{
        "deadlocks":{"healthy":true},
        "Disk":{"healthy":true},
        "Memory":{"healthy":true}
    }';
}
NGINX Plusのサーキットブレーカー/ヘルスチェックシステムには、スロースタート機能もあります。リサイザーサービスのslow_startパラメーターをserverディレクティブに指定すると、upstreamブロック内で、異常な状態から復帰したリサイザーインスタンスへのトラフィック量をNGINX Plusが調整します。正常なサービスと同じ数のリクエストを復旧中のサービスへ一度に送信するのではなく、slow_startパラメーターで指定した期間(この場合は30秒)をかけて、トラフィックを通常のレートまで徐々に増やします。スロースタートにより、サービスが完全な処理能力を取り戻す可能性が高まるとともに、完全に復旧しなかった場合の影響を軽減できます。
upstream resizer {    server        resizer slow_start=30s;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}
リクエスト制限は、サービスへのリクエストの流れを管理し、適切に調整します。アプリケーションの障害特性を十分に把握し、任意の時点で処理できるリクエスト数がわかっている場合、リクエスト制限を実装すると処理の大幅な改善につながります。ただし、この機能が動作するのは、サービスに渡される接続の総数をNGINX Plusが完全に把握している場合に限られます。そのため、リクエスト制限サーキットブレーカーは、Fabric Modelのようにサービス自体と同じコンテナで実行されるNGINX Plusインスタンス、またはクラスター内のすべてのトラフィックを管理する一元化されたロードバランサーに実装するのが最も効果的です。
次の設定コードスニペットでは、コンテナ内のresizerサービスインスタンスに適用するリクエストのレート制限を定義しています。limit_req_zoneディレクティブでは、レート制限を1秒あたり100リクエストに設定します。$server_addr変数をキーとして使用するため、resizerコンテナへのすべてのリクエストが制限の対象としてカウントされます。ゾーン名はmoderateReqsで、リクエスト数の保持期間は1分です。limit_reqディレクティブにより、NGINX Plusは最大150リクエストのバーストをバッファリングできます。この数を超えると、クライアントには503エラーコードが返されます。これはlimit_req_statusディレクティブで指定されており、サービスが利用できないことを示します。
http {    # Moderated delivery
    limit_req_zone $server_addr zone=moderateReqs:1m rate=100r/s;
    # ...
    server {
        # ...
        limit_req zone=moderateReqs burst=150;
        limit_req_status 503;
        # ...
    }
}
NGINX Plus内でサーキットブレーカーを実行するもう1つの大きなメリットは、キャッシュを組み込み、システム全体で利用できるようにキャッシュデータを一元管理できることです。これは、バックエンドから読み取るデータが頻繁には変更されないコンテンツサーバーなど、読み取り中心のサービスで特に有用です。
proxy_cache_path /app/cache levels=1:2 keys_zone=oauth_cache:10m max_size=10m inactive=15s use_temp_path=off;
upstream user-manager {
    server        user-manager;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}

server {
    listen 443 ssl;
    location /v1/users {
        proxy_pass http://user-manager;
        proxy_cache            oauth_cache;
        proxy_cache_valid      200  30s;
        proxy_cache_use_stale  error timeout invalid_header updating
                               http_500 http_502 http_503 http_504;
    }
}
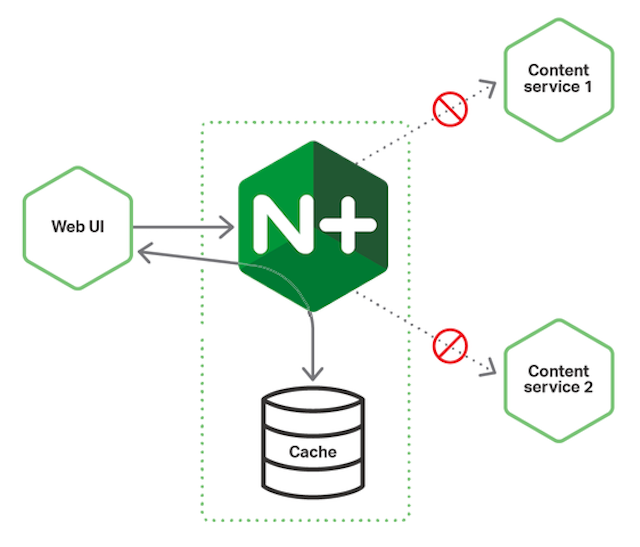
図2に示すように、データをキャッシュすることで、多くの顧客データ要求がマイクロサービスインスタンスに到達しなくなるため、これまで受信していない要求を処理するためのキャパシティを確保できます。
ただし、ユーザー管理サービスなど、データが変更される可能性のあるサービスでは、キャッシュを慎重に管理する必要があります。そうしないと、ユーザーがプロフィールを変更しても、データがキャッシュされているため、一部の状況では古いデータが表示されることがあります。適切なタイムアウトを設定し、結果整合性を前提とした高可用性の原則を受け入れることで、この問題を解決できます。
NGINXキャッシュの便利な機能の1つは、サービスが完全に利用できない場合でも、キャッシュされたデータの提供を継続できることです。上記のスニペットでは、サービスが最も一般的な4つの500番台エラーコードのいずれかを返している場合が該当します。
サーバーが停止している場合でもクライアントに応答する方法は、キャッシュだけではありません。「サーキットブレーカーパターンによる柔軟性の確保」で説明したように、あるお客さまは、パーソナライズド広告サーバーが停止した場合に備えてレジリエントなソリューションを必要としていましたが、キャッシュされた応答は適切ではありませんでした。そこで、パーソナライズド広告サーバーが復旧するまで、汎用広告サーバーから一般的な広告を配信することを希望していました。これは、backupパラメーターをserverディレクティブに指定することで簡単に実現できます。次のスニペットでは、personal-ad-serverドメインに定義されたすべてのサーバーが利用できない場合に、代わりにgeneric-ad-serverドメインに定義されたサーバーを使用するよう指定しています。
upstream personal-ad-server {    server        personal-ad-server;
    server        generic-ad-server backup;
    zone backend  64k;
    least_time    last_byte;
    keepalive     300;
}最後に、NGINXでサービスからのレスポンスコードを評価し、コードごとに処理することもできます。次のスニペットでは、サービスから503エラーが返された場合、NGINX Plusはリクエストを代替サービスに転送します。たとえば、リサイザーにこの機能があり、ローカルインスタンスが過負荷になるか動作を停止した場合、リクエストはリサイザーの別のインスタンスに転送されます。
location / {    error_page 503 = @fallback;
}

location @fallback {
    proxy_pass http://alternative-backend;
}
まとめ
サーキットブレーカーパターンは、マイクロサービスアプリケーションのレジリエンスと制御性を高めるための強力な手段です。NGINX Plusには、環境にサーキットブレーカーを実装するためのさまざまな機能とオプションが用意されています。サーキットブレーカーパターンを実装するうえで重要なのは、保護対象サービスの障害特性を把握したうえで、可能な限り障害を防止し、障害が発生した場合にはその影響を最小限に抑えるために最適なオプションを選択することです。
NGINX Plusをお試しいただくには、今すぐ30日間の無料トライアルを開始するか、ユースケースについてお問い合わせください。
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。

SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります