Heutzutage vergeht kaum ein Moment, ohne dass jemand seine DevOps-unterstützende Toolchain erwähnt. Jeder hat eine (ja, auch wir), und sie alle werden durch die (andere) API-Ökonomie ermöglicht. Laut Wikipedia, ist eine DevOps-Toolchain „eine Reihe oder Kombination von Tools, die bei der Bereitstellung, Entwicklung und Verwaltung von Anwendungen während des gesamten Softwareentwicklungszyklus helfen und von einer Organisation koordiniert werden, die DevOps-Praktiken anwendet“.
Nun konzentriert sich das hauptsächlich auf die Anwendung, aber es gibt auch die Produktionsseite – wo Software im Allgemeinen einen beträchtlichen Teil ihres Lebens verbringt (zumindest hofft man das). Dieselbe Definition gilt auch dafür, allerdings mit der Einschränkung, dass der Schwerpunkt (aus meiner Sicht) auf der „Bereitstellung, Konfiguration und Verwaltung von Netzwerk- und Anwendungsdiensten während des gesamten Anwendungslebenszyklus liegt, koordiniert durch eine Organisation, die DevOps-Praktiken anwendet“. Im Kontext traditioneller DevOps erweitert dieser Schwerpunkt die Phase „Release“ im Zyklus und umfasst „Release-bezogene Aktivitäten“, darunter die Bereitstellung und Überführung von Software in die Produktionsumgebung. Dazu gehören zwangsläufig (oder sollten zumindest gehören) die Netzwerk- und Anwendungsdienste, die erforderlich sind, um Anwendungen sicher und geschützt für die vorgesehenen Benutzer bereitzustellen.
Tatsache ist, dass kein einzelner Anbieter und kein einzelnes Open-Source-Projekt alle Tools bereitstellt, die nötig sind, um den utopischen Traum vom Continuous Deployment zu verwirklichen (das ist übrigens die Produktionsseite). Einige der Tools, die auf der Seite der App-Entwicklung eingesetzt werden, kommen tatsächlich auch in der Produktion zum Einsatz. Zunehmend beobachten wir Überschneidungen zwischen beiden Welten. Das ist ein gutes Zeichen für „DevOps“ im Allgemeinen, denn es deutet auf eine gewisse Annäherung zweier traditionell stark verfestigter Organisationen hin, die außer der App nur wenig gemeinsam haben.
So könnten Sie Puppet oder Chef in Kombination mit VMware und Cisco einsetzen, um einen vollständigen Stack aus Netzwerk- und Anwendungsdiensten zu automatisieren, der die Anforderungen einer Anwendung an Sicherheit, Identitätsverwaltung und Skalierbarkeit erfüllt. Sie haben die dafür erforderlichen Vorlagen und Skripte erstellt und deren Korrektheit überprüft, beispielsweise indem Sie mit Postman und dessen Skriptfunktionen Tests gegen eine virtuelle Infrastruktur im Labor durchgeführt haben. Sie haben entschieden, dass git eine gute Wahl als Repository für Konfigurationsartefakte ist, da die Anwendungsentwicklung es bereits nutzt und Hilfestellung geben oder vielleicht sogar die eine oder andere Schulung abhalten kann. Und möglicherweise gehen Sie noch einen Schritt weiter und beginnen mit der Entwicklung einer Anwendung (oder richten eine OpenStack-Implementierung ein), um den Prozess zu orchestrieren und die einzelnen Dienste zur Selbstbedienung bereitzustellen. Im Wesentlichen definieren Sie damit die Deployment-Toolchain.
Und genau hier zeigt das Axiom vom schwächsten Glied seine hässliche Fratze. Sie kennen die Grundannahme: Eine Kette ist nur so stark wie ihr schwächstes Glied. „Stark“ wird hier hervorgehoben, weil wir es durch andere Eigenschaften wie „zuverlässig“, „sicher“ oder „skalierbar“ ersetzen können und das Axiom weiterhin genauso zutrifft. Das ist wichtig, denn sobald Sie damit beginnen, die Toolchain zu definieren, die Continuous Deployment unterstützt, kann jedes „Glied“ dieser Kette zu einer Schwachstelle werden, an der Sicherheit, Skalierbarkeit oder Verfügbarkeit beeinträchtigt werden.
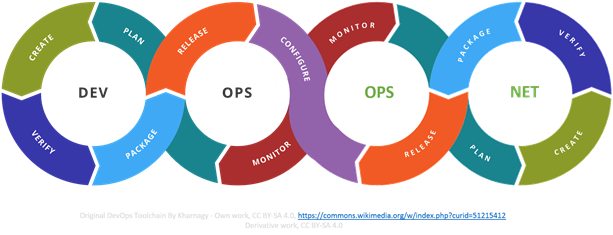
So wie Planung, Verifizierung und Monitoring entscheidende Glieder der DevOps-Toolchain sind, müssen sie dies auch in der NetOps-Toolchain sein. Dies gilt insbesondere für das Monitoring, da sich Anwendungen und Infrastruktur (Netzwerk- und Anwendungsdienste) in Produktionsumgebungen hier am häufigsten überschneiden. Durch Monitoring (Transparenz) lässt sich im Fehlerfall ein umfassendes Bild gewinnen, das von Geschäftstransaktionen bis hin zu einzelnen Anfragen und Antworten reicht.
Auch die Konfiguration verbindet die Toolchains zwangsläufig miteinander, da die Konfiguration von Netzwerk- und Anwendungsdiensten auf eine bestimmte Anwendung zugeschnitten sein kann (und dies häufig auch ist).
Auch wenn für die Paketierungs- und Freigabemechanismen ähnliche Tools zum Einsatz kommen können, handelt es sich dabei um getrennte Aufgabenbereiche, deren Anforderungen sich häufig stark unterscheiden. Da Netzwerk- und Anwendungsdienste auf einer gemeinsam genutzten Infrastruktur bereitgestellt werden können, eignen sich Tools, die von einem einheitlichen Systemansatz ausgehen, möglicherweise nicht für NetOps. Umgekehrt werden Vorlagen immer häufiger eingesetzt, um standardisierte Dienste schnell in der Produktionsumgebung bereitzustellen. Für DevOps sind sie jedoch nur selten geeignet, da Anwendungen ein hohes Maß an Individualität aufweisen.
Unabhängig davon haben beide Toolchains eines gemeinsam: Die Schwäche eines einzelnen Glieds beeinträchtigt die gesamte Kette. Selbst wenn Sie sich auf weitgehend manuelle Bereitstellungen mithilfe von Skripten verlassen, gibt es dennoch eine Toolchain, die den gesamten Prozess der Auslieferung und Bereitstellung abbildet. Auch Menschen können Glieder in den Toolchains sein – und sind es heute auch –, mit denen Software ausgeliefert und bereitgestellt wird. Fehlt ein entscheidendes Glied – weil Bob gerade mit der neuesten Grippewelle ausfällt –, bricht der Prozess zusammen. Die Toolchain kann die Software nicht mehr ausliefern (oder bereitstellen).
Während Sie Ihre interne digitale Transformation weiter vorantreiben, ist es wichtig, die Bedeutung der DevOps- und NetOps-Toolchains zu erkennen und keines ihrer Glieder zu übersehen. Wenn auf dem Weg zum Ziel einer kontinuierlichen Bereitstellung auch nur einem dieser Glieder nicht genügend Aufmerksamkeit geschenkt wird, schwächt dies die gesamte Kette. Da Unternehmen zunehmend auf diese miteinander verknüpften Ketten angewiesen sind, bringt ein schwaches Glied nicht nur einen Prozess zum Erliegen, sondern beeinträchtigt auch das gesamte Geschäft.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...