Ausfälle sind teuer. Ob sie letztlich auf einen Angriff oder einen Software- bzw. Hardwarefehler zurückzuführen sind, spielt dabei kaum eine Rolle. Da die moderne digitale Wirtschaft zunehmend auf APIs und Web-Apps angewiesen ist, steigen die Kosten pro Ausfallminute.
Für manche sind diese Kosten schwindelerregend. Schätzungen zufolge kosteten Amazons 40 Minuten Ausfallzeit im Jahr 2013das Unternehmen 2,64 Mio. $. Das sind 1.100 $ pro Sekunde – für alle, die nicht selbst nachrechnen möchten. Wenn Sie das erschreckend finden, denken Sie an Google: Dort verursachte ein fünfminütiger Ausfall im selben Jahr Kosten von 109.000 $ pro Minute (oder 1.816,67 $ pro Sekunde) und damit insgesamt unglaubliche 545.000 $. Für fünf Minuten. Wenn dies tatsächlich der einzige Ausfall war, entspricht das technisch gesehen den viel gepriesenen „fünf Neunen“, die die IT erreichen soll.
Wie häufig kommt es zu Ausfällen? Offenbar zu häufig. Falls Sie diese Karte noch nie gesehen haben, werfen Sie einen Blick auf die Live-Ausfallkarte von pingdom. Sie basiert auf Daten von mehr als 700.000 Nutzern weltweit. Diese auf morbide Weise faszinierende Karte zeigt Ausfälle, die in der vergangenen Stunde rund um den Globus aufgetreten sind. Die hellen Lichtblitze, die Ausfälle darstellen, sind eine nette Idee – sie verdeutlichen eindrucksvoll, welche Wellen sie bei den Nutzern schlagen.
Mit anderen Worten: einen unerwünschten.
Die digitale Wirtschaft verschärft dieses Problem. Anfang dieses Jahres legte ein S3-Ausfall bei Amazon eine ganze Reihe von Apps und Websites der Kunden lahm. Doch bevor Sie dieses Problem den Anbietern öffentlicher Clouds anlasten: Ein kurzer Blick auf die Website builtwith.com wird Sie schnell eines Besseren belehren. Der Anteil der Websites, die CDNs und APIs nutzen, ist möglicherweise alarmierend hoch, wenn man bedenkt, wie stark sie dadurch von der Verfügbarkeit anderer abhängig sind. Es ist schwer, eine Website zu finden, die nicht auf mindestens eine externe API oder einen externen Dienst angewiesen ist. Das erhöht das Risiko von Ausfallzeiten, denn wenn dieser externe Dienst ausfällt, ist auch Ihre Website nicht erreichbar.
Im Grunde hat sich die IT auf „fünf Neunen“ festgelegt, weil eine Verfügbarkeit von 100 % unmöglich zu erreichen ist. Angesichts der rasant steigenden Kosten pro Sekunde infolge der Verlagerung der Wirtschaft in den digitalen Raum kommt es heute vor allem darauf an, Ausfallzeiten zu minimieren . Mit anderen Worten: Ziele festzulegen, die eine kurze mittlere Lösungszeit (Mean Time to Resolution, MTTR) vorsehen, ist ebenso wichtig – vielleicht sogar wichtiger – wie der Versuch, Ausfallzeiten vollständig zu vermeiden.
Eine der wichtigsten Kennzahlen für „leistungsstarke Unternehmen“ im State of DevOps Report 2016 von Puppet Labs ist die MTTR. Sie bezeichnet die Zeit, die benötigt wird, um den Betrieb nach einem Servicevorfall (z. B. einem ungeplanten Ausfall oder einer Servicebeeinträchtigung) wiederherzustellen. Bei den leistungsstärksten Unternehmen (gemäß der Bewertung des Berichts) dauert dies weniger als eine Stunde, während Unternehmen mit mittlerer oder geringer Leistung „weniger als einen Tag“ benötigen. „Mit anderen Worten“, so der Bericht, „war die MTTR bei leistungsstarken Unternehmen 24-mal kürzer als bei leistungsschwachen Unternehmen.“
Wie Sie sehen, lautete die Frage nicht, „ob“ es zu einer Dienststörung kommt, sondern „wann“. Es wird davon ausgegangen, dass eine Störung auftreten wird. Entscheidend ist daher, die Zeit bis zur Behebung zu minimieren. Eine IHS-Umfrage aus dem Jahr 2016 ergab dass die Befragten „im Durchschnitt fünf Ausfallereignisse pro Monat und 27 Stunden Ausfallzeit pro Monat“ verzeichnen. Dies kostet ein durchschnittliches mittelständisches Unternehmen 1 Mio. US-Dollar und größere Unternehmen bis zu 60 Mio. US-Dollar.
Wenn wir davon ausgehen, dass Murphys Gesetz weiterhin über den Gesetzen von Moore und Conway steht, besteht die Lösung darin, die MTTR möglichst gering zu halten, um den mit unvermeidlichen Ausfallzeiten verbundenen Zeitaufwand (und die Kosten) zu reduzieren.
Das bedeutet, dass Transparenz entscheidend ist – und dafür braucht es Monitoring. Sehr viel Monitoring. Aber nicht nur für die Website, die Web-App oder die API – wir müssen den gesamten Stack überwachen. Vom Netzwerk über die App-Dienste bis hin zur Anwendung selbst. Das macht nicht jeder, und wenn es gemacht wird, dann offenbar nicht konsequent.
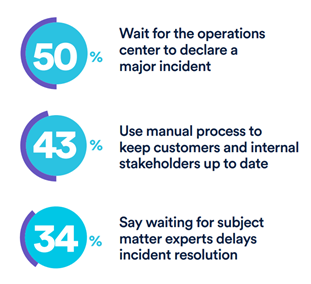
Betrachten wir die 2017 durchgeführte xMatters|Atlassian-Umfrage zum DevOps-Reifegrad, in der 50 % der Befragten angaben, dass sie „warten, bis das Betriebsteam einen schwerwiegenden Vorfall meldet“, bevor sie reagieren. Erschreckenderweise erfährt ein Drittel der Unternehmen „von seinen Kunden von Serviceunterbrechungen“.
In einer digitalen Wirtschaft zählt jede Sekunde. Nicht nur, weil sie Geld kostet, sondern auch, weil sie sich negativ auf künftige Umsätze auswirkt. Sinkendes Markenvertrauen und schwindendes Kundenvertrauen führen zu weniger Käufen und Nutzern und schließlich zu stagnierendem Wachstum. Diesen Weg sollten Unternehmen nicht einschlagen.
Monitoring ist der erste Schritt, um Probleme zu erkennen, die zu Ausfällen führen. Doch Monitoring allein trägt nicht dazu bei, die MTTR zu verkürzen. Kommunikation hingegen schon. Wenn die relevanten Beteiligten so schnell wie möglich benachrichtigt und mit den Informationen versorgt werden, die sie zur Fehlerbehebung benötigen, lässt sich die Lösungszeit verkürzen. Das bedeutet: Austausch – eine der vier zentralen Säulen von DevOps – ist entscheidend für die Verbesserung der MTTR. Selbst wenn Sie andere Aspekte von DevOps auf Unternehmensebene noch nicht umsetzen, sollten Sie erwägen, den Austausch zu einer Initiative mit höchster Priorität zu machen. Ob über ChatOps, per E-Mail, über eine mobile App oder eine dynamisch aktualisierte Wiki-Seite: Es ist unerlässlich, dass die durch das Monitoring gewonnenen Informationen im gesamten Unternehmen umfassend geteilt werden.
Eine Störung in einem Switch oder Server mag harmlos erscheinen, doch wenn sie nicht behoben wird, kann sie letztlich die Hälfte der Dienste lahmlegen, von denen eine kritische Anwendung abhängt. In der von Viavi durchgeführten Studie „State of the Network 2017“ nennen 65 % der Netzwerk- und Systemadministratoren die „Feststellung, ob ein Problem durch das Netzwerk, das System oder Anwendungen verursacht wird“ als ihre größte Herausforderung bei der Behebung von Anwendungsproblemen. Mehr Transparenz und ein Full-Stack-Monitoring können dazu beitragen, diese Herausforderung zu bewältigen, indem sichergestellt wird, dass den für die Ursachenanalyse Verantwortlichen möglichst viele Informationen über den Status und Zustand aller Komponenten im Datenpfad zur Verfügung stehen.
Transparenz ist der Schlüssel zur Zukunft der IT. Ohne sie können wir nicht den Automatisierungsgrad erreichen, der erforderlich ist, um Ausfälle zu beheben, bevor sie auftreten. Ohne Transparenz können wir die mittlere Reparaturzeit (MTTR) nicht nennenswert verkürzen. Ohne sie können wir das Unternehmenswachstum nicht wirklich auf einem nachhaltigen Niveau halten.
Transparenz sollte ebenso wie Sicherheit einen zentralen Stellenwert im strategischen Fundament einnehmen, das die IT voranbringt. Denn Ausfälle lassen sich nicht immer vermeiden – und Transparenz ermöglicht es Unternehmen, sich schnell und effizient davon zu erholen und dabei den Schaden für ihre Marke und ihr Geschäftsergebnis so gering wie möglich zu halten.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...