
Dieser Blogbeitrag ist der zweite in einer Reihe von Beiträgen, die verschiedene Aspekte dessen beleuchten, was erforderlich war, um unseren SaaS-Dienst aufzubauen und zu betreiben:
- Steuerungsebene für eine verteilte Kubernetes-PaaS
- Globales Service Mesh für verteilte Anwendungen
- Plattformsicherheit für verteilte Infrastruktur, Anwendungen und Daten
- Anwendungs- und Netzwerksicherheit verteilter Cluster
- Observability auf einer global verteilten Plattform
- Betrieb und SRE einer global verteilten Plattform
- Golang-Service-Framework für verteilte Microservices
In einem früheren Blogbeitrag haben wir einige Hintergründe zu unseren Anforderungen erläutert, die uns dazu veranlasst haben, eine neue Plattform zu entwickeln. Mit dieser Plattform ermöglichen wir unseren Kunden, eine komplexe und vielfältige Palette von Anwendungen zu entwickeln – etwa für intelligente Fertigung, Video-Forensik im Bereich der öffentlichen Sicherheit, algorithmischen Handel und 5G-Mobilfunknetze.
Der erste Blogbeitrag dieser Reihe befasste sich mit einer verteilten Steuerungsebene zur Bereitstellung mehrerer mandantenfähiger, Kubernetes-basierter Anwendungscluster in der Public Cloud, unseren privaten Netzwerk-PoPs und an Edge-Standorten.
Dieser Blog befasst sich mit den Herausforderungen bei der Vernetzung und Absicherung dieser verteilten Anwendungscluster aus drei Perspektiven: Anwendung zu Anwendung, Benutzer/Maschine zu Anwendung und Anwendung zum öffentlichen Internet. Wir stellen einen völlig neuen und vollständig integrierten L3-L7+-Datenpfad, eine global verteilte Steuerungsebene und unser leistungsstarkes globales Netzwerk vor. Zusammen bieten diese drei Komponenten ein umfassendes Spektrum an Netzwerk- und Sicherheitsdiensten am Edge, innerhalb einer beliebigen Cloud-VPC oder in unseren globalen Netzwerk-PoPs. Nachdem die Lösung seit über einem Jahr bei mehr als 35 Kunden produktiv im Einsatz ist, haben wir mit der Skalierung der Bereitstellung begonnen und halten nun den richtigen Zeitpunkt für gekommen, unsere Erfahrungen zu teilen.
Kurzfassung (Zusammenfassung)
- Um eine leistungsstarke, zuverlässige und sichere Konnektivität für verteilte Anwendungscluster bereitzustellen, mussten wir ein neues globales Netzwerk aufbauen. Zwar gibt es zahlreiche Dienstanbieter, die Verbraucher mit Anwendungen verbinden und diese Verbindungen absichern (Akamai, Cloudflare usw.), sowie Anbieter, die dasselbe für Mitarbeiter und Anwendungen leisten (z. B. Zscaler, Netskope usw.), doch es gibt keinen Dienstanbieter, der den Anforderungen an die Konnektivität und Sicherheit zwischen Anwendungen gerecht wird.
- Zusätzlich zu einem globalen Netzwerk für die Verbindung verteilter Anwendungen benötigen diese Anwendungscluster Netzwerk-, Zuverlässigkeits- und Sicherheitsdienste – API-Routing, Lastverteilung, Sicherheitsfunktionen und Netzwerk-Routing – mit einem einheitlichen Konfigurations- und Betriebsmodell. Diese Dienste müssen an mehreren Standorten von Cloud-Anbietern, an ressourcenbeschränkten Edge-Standorten und/oder in unserem globalen Netzwerk ausgeführt werden.
- Um diese Netzwerk- und Sicherheitsdienste bereitzustellen, entschieden wir uns für die Entwicklung eines neuen, vollständig integrierten L3-L7+-Netzwerkdatenpfads mit einheitlicher Konfiguration, Richtlinienverwaltung und Beobachtbarkeit – unabhängig davon, ob er in unserem Netzwerk, in zahlreichen Public Clouds oder an Edge-Standorten ausgeführt wird. Da viele dieser Datenpfade standortübergreifend bereitgestellt werden können, mussten wir außerdem eine global verteilte Steuerungsebene entwickeln, um sie zu orchestrieren.
- Die Kombination aus einem globalen Netzwerk, einem neuen Netzwerk-Datenpfad und einer verteilten Steuerungsebene hat uns ein „global verteiltes Anwendungs-Gateway“ ermöglicht, das Zero-Trust-Sicherheit, Anwendungskonnektivität und Cluster-Zuverlässigkeit bietet, ohne Zugriff auf dieses globale Netzwerk zu gewähren – ein „globales Service Mesh“, das die Arbeit unseres Sicherheits- und Compliance-Teams vereinfacht.
Wo sind die Kabel? Warum haben wir ein globales Netzwerk aufgebaut?
Da unsere Kunden recht komplexe und geschäftskritische Anwendungen entwickeln – etwa für die intelligente Fertigung, die forensische Videoanalyse im Bereich der öffentlichen Sicherheit, den algorithmischen Handel oder die 5G-Umstellung bei Telekommunikationsanbietern –, müssen wir sowohl für die Anwendungen als auch für deren Endnutzer ein durchgehend verfügbares, vernetztes und zuverlässiges Nutzungserlebnis gewährleisten. Einige dieser Anwendungen betreiben Datenpipelines über mehrere Cluster innerhalb einer Cloud hinweg, müssen Daten über verschiedene Cloud-Anbieter hinweg sichern, benötigen eine zuverlässige Weiterleitung von Anfragen einer globalen Nutzerbasis an die Anwendungs-Backends oder eine leistungsstarke Verbindung zwischen ihren Systemen und den in zentralisierten Clouds betriebenen Backends.
Um diese Anforderungen zu erfüllen, musste das physische Netzwerk zwei Voraussetzungen erfüllen:
R1 — Cloud-zu-Cloud — Leistungsstarke On-Demand-Konnektivität von Anwendungen über öffentliche oder private Cloud-Standorte weltweit hinweg
R2 — Internet zur Cloud — Damit Geräte und Maschinen an Edge-Standorten zuverlässig eine Verbindung zum Anwendungs-Backend herstellen können, mussten wir mehrere redundante Pfade bereitstellen und die Verbindungen so nah wie möglich an diesen Nutzern terminieren, anstatt den Datenverkehr über das Internet bis zu den Backends zurückzuführen.
Wir hätten die Anforderungen R1 und R2 mithilfe eines Netzwerkdienstleisters wie AT&T erfüllen können, doch dieser hätte uns weder ein nahtloses Netzwerkerlebnis noch eine reibungslose Integration in unsere Anwendungsdienste bieten können – etwa API-basierte Konfiguration, Streaming-Telemetrie, die Möglichkeit, eigene IP-Präfixe oder die unserer Kunden einfach hinzuzufügen, API-basierte Netzwerkdienste usw. Darüber hinaus ist es sehr schwierig oder unerschwinglich teuer, über Dienstleister eine globale Abdeckung zu erreichen. Wir hätten zwei oder drei verschiedene Dienstleister beauftragen können, um all diese Probleme zu lösen. Dann hätten wir jedoch ein unübersichtliches Sammelsurium unterschiedlicher Systeme erhalten, die sich jeweils anders verhalten und unterschiedliche Ausfallarten, SLAs und Supportsysteme sowie unterschiedliche oder gar keine APIs aufweisen.
Letztendlich mussten wir also unser eigenes Netzwerk aufbauen, und das bedeutete, dass es drei Eigenschaften aufweisen musste:
- Um R1 zu erfüllen, mussten wir ein privates Netzwerk aufbauen, das sich über mehrere Cloud-Anbieter und den gesamten Globus erstreckt, um alle Regionen miteinander zu verbinden. Der beste Ansatz hierfür besteht darin, in wichtigen Cloud-Regionen Peering mit Cloud-Anbietern einzurichten und zusätzlich eine Kombination aus Direct-Connect-Verbindungen in großen Colocation-Rechenzentren zu nutzen. Peering garantiert nicht die besten SLAs, während Direct-Connect-Verbindungen innerhalb einer Cloud-Region SLA-Garantien bieten.
- Um R2 für Maschinen an Edge-Standorten zu erfüllen, mussten wir mehrere Active-Active-Verbindungen von jedem Edge-Standort unterstützen. Dabei kann es sich um kostengünstige Internetverbindungen (über Mobilfunk oder Kabel/Glasfaser) und/oder teurere dedizierte Verbindungen (über Glasfaser/Ethernet) handeln. Um eine hohe Leistung und Zuverlässigkeit zu erreichen, muss der Datenverkehr möglichst nah am Edge-Standort lastverteilt und terminiert werden, anstatt ihn über das unzuverlässige Internet zu leiten. In der Fachsprache wird diese Funktion auch als SD-WAN bezeichnet.
- Die Umsetzung von R2 für Internetnutzer und Edge-Anwendungen erforderte, dass wir den TLS-Datenverkehr am Netzwerkrand terminieren – und zwar so nah wie möglich am Nutzer. Daher mussten wir Netzwerk-Edge-Standorte mit einer hohen Peering-Dichte zu Mobilfunkbetreibern und Inhaltsanbietern aufbauen und den Datenverkehr zudem über mehrere Transit-Provider leiten, um ein möglichst optimales Routing zu gewährleisten.
Um diese drei Eigenschaften zu erfüllen, mussten wir viele Maßnahmen ergreifen. Wir möchten jedoch fünf große Themenbereiche hervorheben:
- Globale Netzwerk-PoPs mit unserer eigenen Netzwerkausrüstung — letztlich mussten wir mehrere Netzwerk-PoPs in großen Ballungsräumen aufbauen. In der Anfangsphase des Aufbaus unserer Plattform starteten wir in Europa mit mehreren Städten – Paris, London, Amsterdam und Luxemburg – sowie mit einem PoP in New York City in den USA. Anschließend expandierten wir nach Seattle, San Jose, Ashburn, Frankfurt, Singapur und Tokio. So erreichten wir eine globale Abdeckung und befanden uns in unmittelbarer Nähe zu allen großen Cloud-Anbietern. Wir entschieden uns für Equinix als globalen Partner und ergänzten unser Netzwerk an Standorten, an denen Equinix nicht die optimale Wahl war, durch Interxion, Telehouse/KDDI und Westin. Da wir auf Automatisierung setzen, entschieden wir uns schließlich für Juniper Networks bei der Switching- und Routing-Ausrüstung sowie für Adva zur Glasfaservernetzung innerhalb der Ballungsräume mit 400G- und 100G-Verbindungen.
- Privates Backbone — Um all diese PoPs mit hoher Leistung und Zuverlässigkeit zu verbinden, entschieden wir uns gegen den Aufbau eines Overlay-Netzwerks über mehrere Transit-Anbieter und stattdessen für ein globales privates Backbone, das mehrere 100G-Wellenlängen von Anbietern wie Zayo, Centurylink, EuNetworks usw. kombiniert. Während viele CDN- (z. B. Cloudflare, Fastly) und Sicherheitsanbieter (z. B. Zscaler) vollständig auf Transit- und Peering-Verbindungen setzen, da sie nachgelagerten Datenverkehr bereitstellen, gibt es unserer Ansicht nach gute Gründe für eine Kombination aus privatem Backbone und Transit, da wir es mit Ost-West-Datenverkehr zwischen Anwendungen zu tun haben. Damit sind wir nicht allein — alle großen Cloud-Anbieter verfügen über ein globales privates Backbone, das ihre Cloud-Standorte miteinander verbindet.
- Internet-Peering- und Transit-Anbieter — Um die Vielfalt zu erhöhen und die bestmögliche Performance bei der Anbindung von Nutzern sowie Content- oder SaaS-Anbietern zu erzielen, ist es ideal, direktes Peering mit möglichst vielen Netzbetreibern und Content-Anbietern zu betreiben. Wie in PeeringDB aufgeführt, betreiben wir Peering an mehreren Internetknoten (ASN-35280 in PeeringDB). Nicht der gesamte Datenverkehr kann über Peering-Verbindungen abgewickelt werden; hier kommen Transit-Verbindungen ins Spiel. Transit-Verbindungen und Peering-Ports müssen sehr sorgfältig überwacht werden, um die Qualität aufrechtzuerhalten. Daher haben wir uns für führende Tier-1-Anbieter wie NTT, CenturyLink und Telia entschieden, die uns an verschiedenen Standorten weltweit versorgen.
- Cloud-Peering und Interconnects — Seit Kurzem betreiben wir direktes Peering mit Cloud-Anbietern, die für diese Verbindungen jedoch keine SLAs garantieren. Über unsere Peering-Verbindung in Seattle (Westin-Rechenzentrum) können wir beispielsweise alle drei großen Cloud-Anbieter direkt erreichen. Obwohl diese Verbindungen besser sind als eine reine Anbindung über Transit-Provider, haben wir begonnen, unser Netzwerk durch Direktverbindungen zu diesen Cloud-Anbietern zu ergänzen (AWS Direct Connect, Azure Express Route und GCP Dedicated Interconnect), da diese SLAs und zusätzliche Funktionen bieten. Diese Verbindungen sind zwar teuer und ermöglichen nur den Zugriff auf interne VPC-/VNET-Subnetze, bieten dafür aber die bestmögliche Konnektivität.
- Software-Gateways — An Cloud- oder Edge-Standorten, die nicht direkt mit unseren PoP-Standorten verbunden sind, installieren wir unsere Software-Gateways. Auf die erweiterten Funktionen dieser Gateways gehen wir in einem späteren Abschnitt dieses Blogbeitrags ein. Eine für die Transportschicht relevante Funktion besteht darin, dass diese Gateways automatisch sichere VPN-Tunnel (IPsec oder SSL) zu mehreren Netzwerk-PoPs aufbauen, um Redundanz zu gewährleisten und den Datenverkehr auf die PoPs zu verteilen. Darüber hinaus stellen diese Gateways bei einer Cloud-Bereitstellung über die NAT-Gateways der Cloud-Anbieter eine ausgehende Verbindung zu unserem nächstgelegenen PoP und damit einen Zugang zu unserem globalen privaten Netzwerk her. Dadurch müssen weder öffentliche Netzwerke durchlaufen noch Anwendungscluster an verschiedenen Cloud-Standorten über öffentliche IP-Adressen miteinander verbunden werden.
Wir erkannten bereits sehr früh in unserer Entwicklung, dass der Aufbau und Betrieb eines globalen Netzwerks Zeit und Fachwissen erfordert und wir uns diese Expertise ins Unternehmen holen mussten. Nach monatelangen Gesprächen mit den Gründern von Acorus Networks, einem Sicherheitsanbieter mit Sitz in Paris, Frankreich, fusionierten wir schließlich Acorus mit Volterra. Dadurch konnten wir die Herausforderungen beim Aufbau unserer globalen Infrastruktur und der Einführung unseres Netzwerks bewältigen. Acorus hatte bereits ein hervorragendes Netzwerk und ein Betriebsteam aufgebaut, das die Konfiguration der physischen Netzwerkinfrastruktur mithilfe von Ansible vollständig automatisiert und externe APIs für Telemetrie und Konfiguration entwickelt hatte, die von unserem Softwareteam genutzt werden konnten.
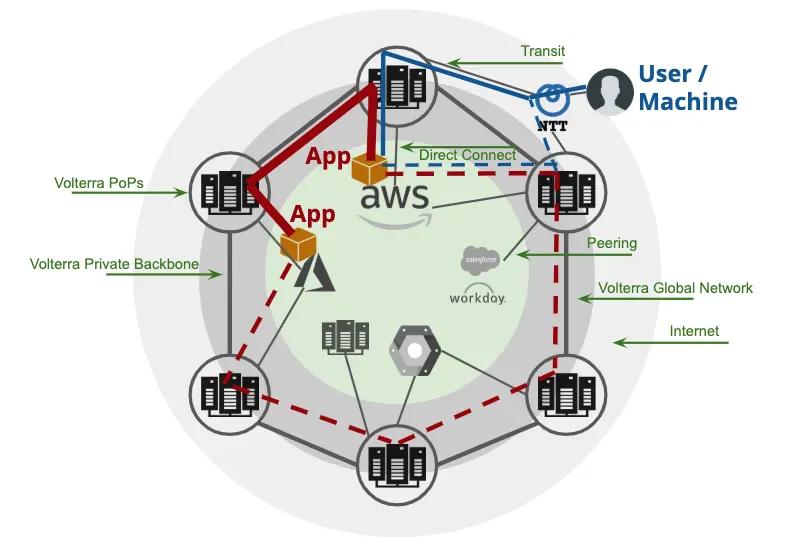
Da wir nun über ein Team verfügten, das sich auf den Aufbau eines hochzuverlässigen und leistungsfähigen globalen privaten Netzwerks konzentrierte, konnten wir die Herausforderungen sowohl beim Datenverkehr zwischen Anwendungen als auch beim Datenverkehr von Benutzern bzw. Geräten zu Anwendungen über Edge- oder Cloud-Standorte hinweg problemlos lösen, wie in Abbildung 1 dargestellt. Darüber hinaus ermöglichte uns die Rechen- und Speicherinfrastruktur in unseren Netzwerk-PoPs, unser Netzwerk um API-Terminierung, Anwendungssicherheit und die Auslagerung von Workloads (von der Edge oder aus der Cloud) zu erweitern. So können wir unsere Funktionen auch langfristig kontinuierlich weiterentwickeln und unsere Netzwerkpräsenz sowie unser Serviceangebot je nach Bedarf problemlos ausbauen.
Netzwerkdienste für Anwendungen – Multi-Cloud, Private Cloud oder Edge?
Nachdem wir ein funktionsfähiges globales Netzwerk eingerichtet hatten, mussten wir damit beginnen, Anwendungscluster und unsere Workloads hinzuzufügen. Diese Workloads benötigen eigene Konnektivitäts- und Sicherheitsdienste auf Anwendungsebene.
Wie wir in unserem früheren Blogbeitrag erläutert haben, bestand unser Ziel mit der Plattform darin, die Produktivität zu steigern und die Komplexität für unsere Teams zu reduzieren, die Workloads in mehreren Umgebungen (Cloud, Edge und unseren Netzwerk-PoPs) verwalten.
Jeder Cloud-Anbieter erfordert die Konfiguration, Verwaltung und Überwachung zahlreicher unterschiedlicher Cloud-Ressourcen, um eine sichere Verbindung zu Anwendungsclustern zu gewährleisten. Um beispielsweise in Google Cloud einen durchgängigen Netzwerkdienst für einen Anwendungscluster zu konfigurieren, müssen wir viele verschiedene Gruppen von Diensten verwalten:
Weitverkehrsnetzdienste (WAN)
Anwendungsnetzwerkdienste
- Application Load Balancer, Network Load Balancer (öffentliche APIs)
- Application Load Balancer, Network Load Balancer (intern)
- Service Mesh (App-zu-App)
Dienste für Netzwerk-Routing und -Isolation
- Virtuelles privates Cloud-Netzwerk (VPC-Netzwerk)
- Subnetze, IP-Adressbereiche, Routen
- NAT-Gateways, Firewallregeln
Natürlich hätten wir uns trotz der großen Herausforderung dafür entscheiden können, dieses Problem durch den Aufbau einer Konfigurations- und Betriebsebene zu lösen, die eine einheitliche Verwaltung über alle Cloud-Anbieter hinweg ermöglicht. Wir wussten jedoch, dass dies unsere Probleme nicht gelöst hätte, da die Dienste der Cloud-Anbieter nicht alle unsere Anforderungen erfüllten (z. B. bieten CSPs keine Möglichkeit zur Absicherung von Anwendungen und APIs), nicht zu den besten am Markt gehören und sich ständig verändern.
Und was ist darüber hinaus mit unseren Netzwerk-PoPs und Edge-Standorten? Wir müssten vergleichbare Funktionen von Hardware- oder Softwareanbietern beziehen und sie alle miteinander integrieren – z. B. Cisco/Juniper für Routing+NAT+VPN, F5 für Lastverteilung und Firewall usw. An den Edge-Standorten verschärft sich das Problem, da weder die Cloud-Anbieter noch die großen Netzwerkausrüster die Anforderungen an Netzwerkdienste in einer ressourcenbeschränkten Umgebung erfüllen konnten. Eine weitere mögliche Option für die Edge-Standorte wäre gewesen, sämtliche Dienste für Anwendungskonnektivität, Sicherheit und Netzwerk in unser globales Netzwerk zu verlagern – doch es war klar, dass dies nicht funktionieren würde, da auch der Datenverkehr zwischen Anwendungen am selben Edge-Standort einige dieser Dienste benötigte.
Nach zahlreichen Gesprächen und einer umfassenden Marktanalyse wurde uns klar, dass die Integration zahlreicher Dienstanbieter und Hersteller – einschließlich Konfiguration, Telemetrie, Überwachung und Alarmierung – sowie die laufende Anpassung an deren Roadmaps und API-Änderungen unserem Ziel von Einfachheit und Schnelligkeit zuwiderlief.
Ein weiteres Problem, das wir plattformübergreifend lösen mussten, war die Mandantenfähigkeit. Bei WAN-Diensten und dem Netzwerk-Routing ließ sich diese leichter umsetzen, bei Netzwerkdiensten für Anwendungen war dies jedoch eine Herausforderung, da die meisten auf dem Markt erhältlichen Load Balancer Mandantenfähigkeit gar nicht oder nur sehr eingeschränkt unterstützen.
Ein neuer Netzwerk-Datenpfad für L3–L7+
Daher haben wir uns entschieden, diese Herausforderung anzunehmen und einen leistungsstarken Netzwerkdatenpfad zu entwickeln, der nicht nur Netzwerk-Routing, sondern auch Anwendungs-, Sicherheits- und Weitverkehrsdienste bereitstellt. So könnten wir das Serviceportfolio in unserer hybriden und verteilten Cloud-Umgebung vereinheitlichen und wären nur auf ein Minimum an nativen Diensten in Public Clouds angewiesen.
Da das Team über umfassende Netzwerkerfahrung verfügte und wir uns bereits in früheren Tätigkeiten bei Contrail/Juniper mit ähnlichen Problemen befasst hatten, hielten wir es für den besten Lösungsweg, ganz von vorn anzufangen und eine völlig neue Netzwerklösung zu entwickeln. Diese sollte Dienste von L3 bis L7+ in einem einzigen Datenpfad integrieren, der in jeder Cloud- oder Edge-Umgebung ausgeführt und zugleich zentral über unsere Plattform verwaltet werden kann.
Für den Entwurf dieses neuen Datenpfads wählten wir die besten Projekte als Ausgangspunkt aus: OpenContrail vRouter (für L3–L4), in dessen Entwicklung wir bereits sechs Jahre investiert hatten, und Envoy für L7, das von einer großen Community unterstützt wird. Allerdings mussten wir mehrere Änderungen und Erweiterungen vornehmen, um einen neuen, einheitlichen L3–L7+-Datenpfad zu entwickeln: Mandantenfähigkeit für Envoy, dpdk für Envoy, einen dpdk-TCP-Stack im User-Space, Netzwerkrichtlinien, SSL-/IPSec-VPNs, http connect, einen dynamischen Reverse-Proxy, einen transparenten Forward-Proxy, ein API-Gateway, programmierbare Anwendungsrichtlinien, schnelle ACLs zum DDoS-Schutz, PKI-Identitätsintegration, die Chrome-v8-Engine, Anwendungs- und Netzwerksicherheit usw.
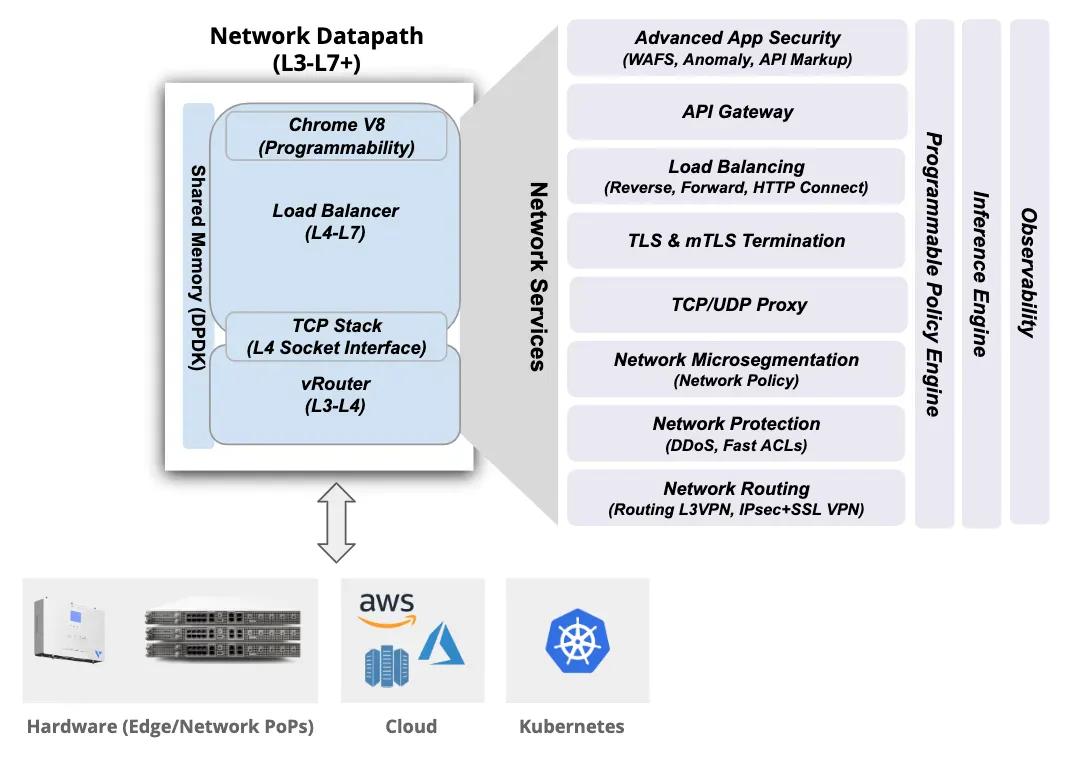
Dieser Datenpfad (wie in Abbildung 2 dargestellt) wird als Ingress-/Egress-Gateway für unsere Anwendungscluster und als Software-Gateway am Netzwerkrand eingesetzt, stellt Service-Mesh-Funktionen innerhalb eines Clusters oder über mehrere Cluster hinweg bereit oder ermöglicht die Bereitstellung von Netzwerkdiensten über unsere globalen PoPs.
Um unserem Bedarf an Mandantenfähigkeit für die Plattform gerecht zu werden (der im vorherigen Blogbeitrag behandelt wurde), mussten wir auch für diesen Netzwerkdatenpfad vollständige Mandantenfähigkeit bereitstellen. Für die Routing-Schicht war dies relativ unkompliziert, da der vRouter bereits VRFs unterstützte. Allerdings mussten wir Envoy anpassen, um es mandantenfähig zu machen. Da wir den TCP-Stack des Kernels nicht verwendeten, änderten wir die TCP-Socket-Schnittstelle von Envoy und ergänzten sie um VRF-Unterstützung.
Dieser Datenpfad musste außerdem für API-Sicherheit, Anwendungsfirewalls und Netzwerksicherheit sorgen. Hierfür nutzten wir eine Kombination aus algorithmischen Verfahren und maschineller Inferenz. Auf dieses Thema werden wir in einem kommenden Blogbeitrag näher eingehen.
Der Aufbau dieses Netzwerkdatenpfads brachte uns viele Vorteile:
Umfassende L3–L7+-Funktionen mit einheitlicher Konfiguration, Steuerung und Beobachtbarkeit
Die Unterstützung für horizontale Skalierung innerhalb eines einzelnen Clusters ermöglicht es uns, ein breites Spektrum abzudecken – von Edge-Geräten mit sehr geringem Platzbedarf und niedrigerer Leistung bis hin zu Kapazitäten von 100 Gbit/s und mehr in unserem Netzwerk oder an Standorten in der Public Cloud.
Fügen Sie dem Netzwerkdatenpfad schnell neue Funktionen hinzu, ohne von einem Netzwerkanbieter und/oder Cloud-Anbieter abhängig zu sein.
Einheitliche Lösung mit vergleichbarem Ausfall- und Leistungsverhalten in jeder Umgebung – äußerst wichtig für unsere Betriebsteams.
Da wir nun mehrere App-Cluster mit diesem neuen Netzwerk-Datenpfad bereitstellen konnten, war es entscheidend, eine global verteilte Steuerungsebene zu entwickeln, um sie zu konfigurieren, zu steuern und zu überwachen.
Speziell entwickelte Steuerungsebene für verteilte Netzwerke
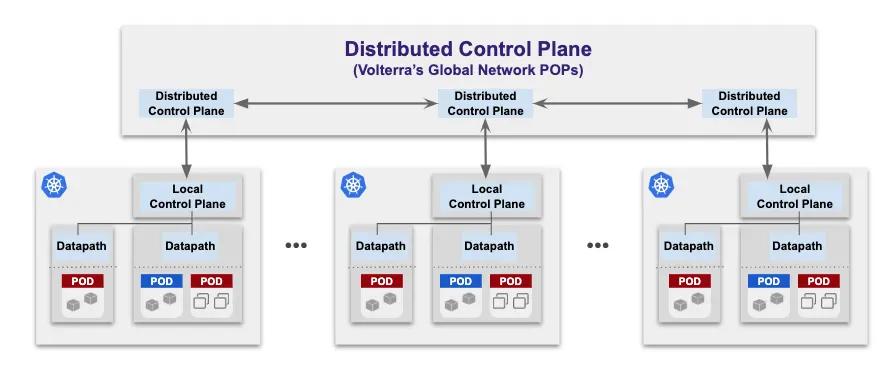
Unser Plattformteam musste beim Aufbau einer verteilten Steuerungsebene zur Verwaltung einer großen Anzahl verteilter Datenpfad-Verarbeitungsknoten mehrere Herausforderungen bewältigen. Da wir einen neuen Datenpfad entwickelt hatten, gab es keine sofort einsetzbare Steuerungsebene, auf die wir zurückgreifen konnten, sodass wir eine eigene entwickeln mussten: eine lokale Steuerungsebene zur Verwaltung mehrerer Datenpfade innerhalb eines einzelnen Clusters (Cloud, Edge oder Netzwerk-PoP). Diese Datenpfadknoten benötigten eine lokale Steuerungsebene, um Konfigurationsänderungen und Routenaktualisierungen zu verwalten, Zustandsprüfungen und Diensterkennung durchzuführen, über ein Protokoll wie BGP Peering-Verbindungen mit anderen Netzwerkgeräten aufzubauen, Metriken und Zugriffsprotokolle zu aggregieren usw. Verteilte Steuerungsebene zur Verwaltung mehrerer lokaler Steuerungsebenen – In unseren globalen Netzwerk-PoPs wird eine verteilte Steuerungsebene betrieben (Abbildung 3). Diese Steuerungsebene ist für das Konfigurationsmanagement der lokalen Steuerungsebenen, die Verteilung des Betriebszustands auf die einzelnen lokalen Steuerungsebenen sowie die Datenerfassung von jedem Knoten verantwortlich. Für die Verteilung des Betriebszustands entschieden wir uns für BGP, da es letztlich konsistent und robust ist. Da wir im Rahmen von OpenContrail bereits eine hochskalierbare, Multithreading-fähige BGP-Implementierung entwickelt hatten, nutzten wir diese und ergänzten sie um Erweiterungen für den Lastenausgleich, darunter die Verteilung von Zustandsprüfungen, http/api-Endpunkte, die Weitergabe von Richtlinien usw.
Darüber hinaus gibt es eine zentrale Verwaltungsebene, die in zwei Cloud-Regionen – AWS und Azure – betrieben und zusammen mit der verteilten Steuerungsebene eingesetzt wird, um Mandantenfähigkeit bereitzustellen, wie in Abbildung 4 dargestellt. Unser SRE-Team kann mehrere Mandanten erstellen, wobei jeder Mandant in unserem globalen Netzwerk vollständig von den anderen isoliert ist. Die Kommunikation zwischen Mandanten ist nur über das „öffentliche Netzwerk“ möglich. Innerhalb eines Mandanten können Dienste über verschiedene Namespaces hinweg auf Grundlage von HTTP-/API-/Netzwerk-Routing- und Sicherheitsregeln miteinander kommunizieren.
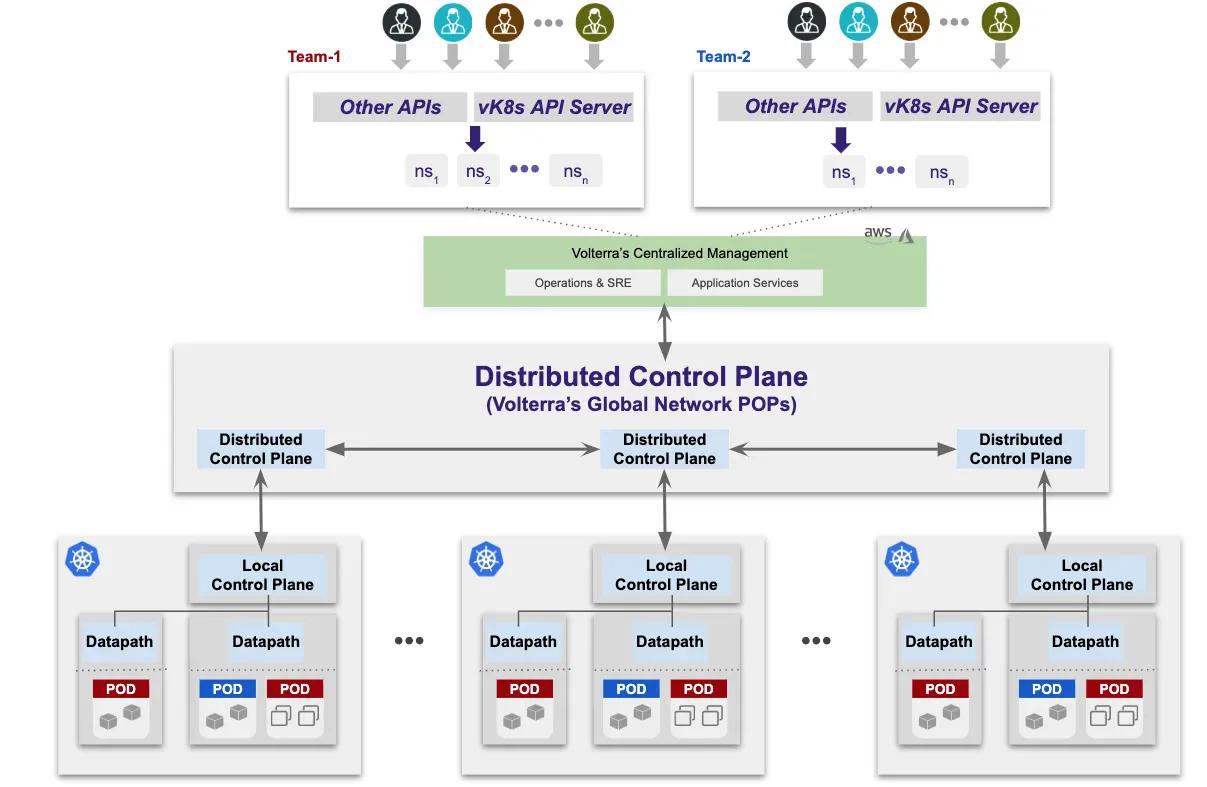
Die Steuerungsebenen werden als Kubernetes-Workloads in einem separaten Mandanten und einem isolierten Namespace ausgeführt, der ausschließlich von unseren SRE-Teams verwaltet wird. Dadurch können weder Entwickler noch Kunden diesen Dienst beeinträchtigen. Da die Steuerungsebene zudem verteilt ist, wirkt sich der Ausfall einer Steuerungsebene an einem Standort nicht auf den gesamten Dienst aus.
Global verteiltes Application Gateway?
Nachdem wir die Anforderungen an unser globales Netzwerk ermittelt und die Anforderungen an L3-L7+-Netzwerkdienste für App-Cluster (einen neuen Datenpfad und eine verteilte Steuerungsebene) definiert hatten, stellte unser Produktteam weitere Anforderungen, die unsere Arbeit noch spannender machten. Im Wesentlichen sollten wir ein globales, clusterübergreifendes Service Mesh mit den folgenden Funktionen bereitstellen:
- Anwendungskonnektivität (Routing, Steuerung und Beobachtbarkeit) über das globale Netzwerk hinweg bereitstellen, jedoch keine Netzwerkkonnektivität (zumindest nicht standardmäßig) – der Grund war einfach: Die Verbindung von Netzwerken schafft alle möglichen Sicherheitslücken, die sich nur durch komplexe Firewall-Regeln schließen lassen, was wiederum das Änderungsmanagement erschwert.
- Verbesserung der Edge-Load-Balancer in den Netzwerk-PoPs durch Berücksichtigung des Zustands und der Zuverlässigkeit der Endpunkte — Derzeit basiert bei Edge-Load-Balancern (z. B. AWS Global Accelerator oder Akamai Global Load Balancer) die Routing-Entscheidung vom Edge-Standort zum Backend auf dem Zustand des Ursprungsservers (in den meisten Fällen ist der Ursprungsserver lediglich ein weiterer Load-Balancer und nicht der tatsächlich bereitstellende Endpunkt). Unser Team wollte, dass jeder unserer Edge-Load-Balancer den Datenverkehr anhand des Zustands sämtlicher Endpunkte in allen Clustern steuern kann und nicht nur anhand des Zustands der Ursprungs-Load-Balancer.
- Auswahl des Edge-Standorts (Netzwerk-PoP) im Rahmen der GSLB-Entscheidungsfindung verbessern — Derzeit leiten Anycast oder GSLB den Benutzer/Client für den eingehenden Datenverkehr an den nächstgelegenen Edge-Standort weiter. Aus verschiedenen Gründen (Auslastung des Backbones und/oder der Transit-Provider) kann es jedoch sinnvoller sein, den Benutzer an einen anderen Edge-Standort für den eingehenden Datenverkehr weiterzuleiten.
Mit den Anforderungen Nr. 2 und 3 sollte die Reaktionszeit und Leistung der Client-Server-Verbindung verbessert werden. Dies ist insbesondere für die Kommunikation zwischen Anwendungen oder für groß angelegte SaaS-Anwendungen von entscheidender Bedeutung. Um die Anforderungen Nr. 2 und 3 zu erfüllen, war klar, dass der beste Ansatz darin bestand, einen verteilten Proxy (Abbildung 5) aufzubauen – bestehend aus einem Ingress- und einem Egress-Proxy – und das Routing anhand der Anwendungsadressierung statt der Netzwerkadressierung vorzunehmen. Darüber hinaus beschlossen wir, den Integritätsstatus der bereitstellenden Endpunkte (oder Server) mithilfe der verteilten Steuerungsebene und BGP-Erweiterungen (wie zuvor beschrieben) zu verteilen. Die folgende Abbildung zeigt diese Implementierung des verteilten Proxys.
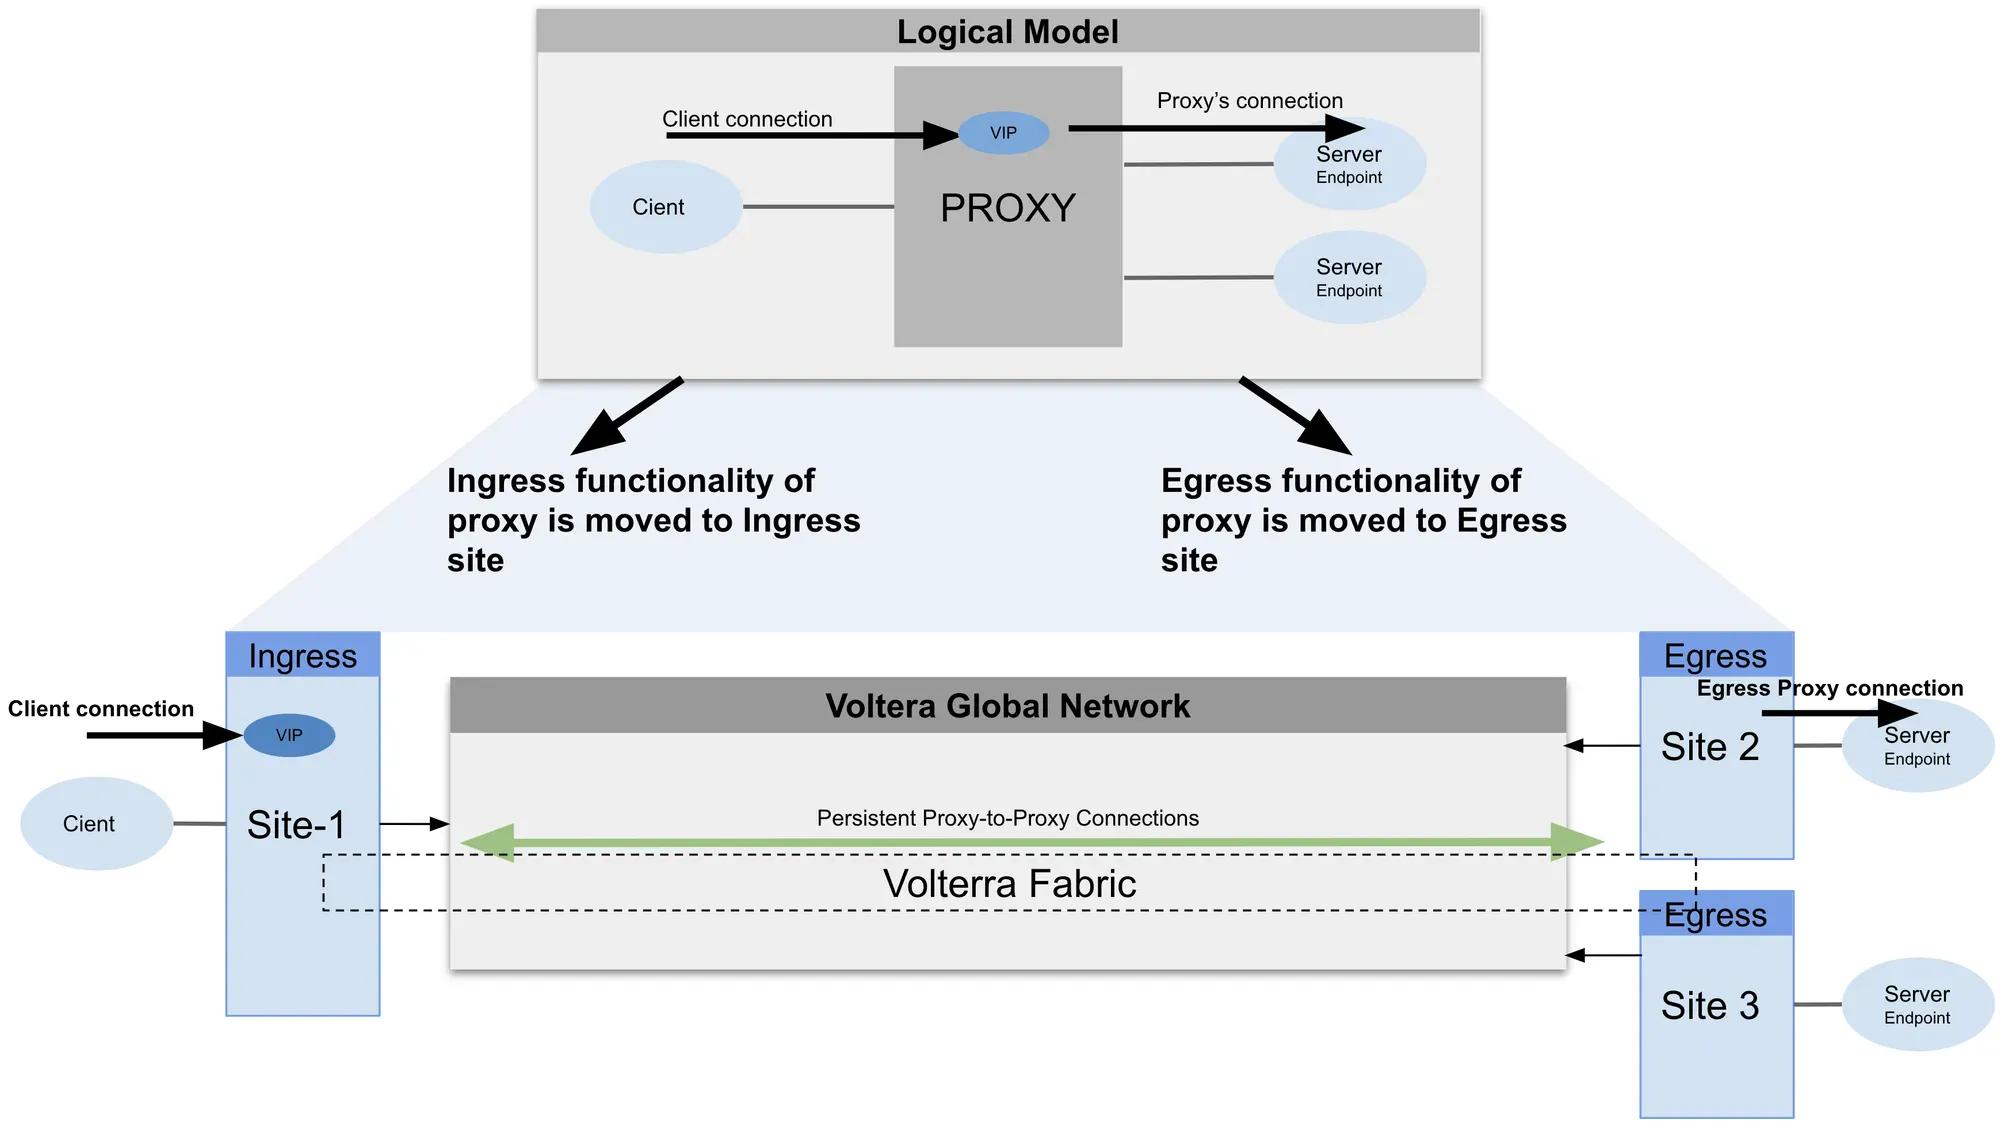
Da es sich zu einem verteilten Proxy mit einem vollständigen L3-L7+-Netzwerk-Stack entwickelt hat, bezeichnen wir es als global verteiltes Anwendungs-Gateway. Sämtliche Funktionen, die in unserem Netzwerk-Datenpfad verfügbar sind, stehen nun in unserem gesamten globalen Netzwerk zur Verfügung – beispielsweise Lastverteilung und Routing auf Basis von HTTP oder APIs, Richtliniendurchsetzung am Netzwerkrand, API-Transformation, TLS-Terminierung näher am Benutzer usw.
Vorteile des Distributed Application Gateway
Durch die Implementierung eines global verteilten Application Gateways konnte das Team zahlreiche Vorteile erzielen. Diese betrafen die Bereiche betriebliche Optimierung, Sicherheit, Performance und Gesamtbetriebskosten (TCO):
- Sicherheit und Compliance — Die Möglichkeit, standortübergreifend Anwendungszugriff ohne Netzwerkzugriff bereitzustellen, hat die Sicherheit und Compliance von Anwendungsclustern an Edge- oder Cloud-Standorten erheblich verbessert. Dadurch hat sich auch der Bedarf an einer komplexen Verwaltung von Firewall-Konfigurationen verringert, da kein standortübergreifender Netzwerkzugriff besteht und die Anwendungscluster miteinander verbunden werden können, während sie an jedem Standort vollständig hinter NAT verbleiben.
- Betriebsaufwand — Ein einheitlicher Satz von Netzwerkdiensten an unseren Netzwerk-PoPs und Edge-/Cloud-Standorten macht es für unsere SRE- oder DevOps-Teams überflüssig, Konfiguration und Observability über verschiedene Dienste hinweg zu integrieren.
- Verbesserungen bei Leistung und Zuverlässigkeit — Da wir den Datenverkehr von unserem Netzwerk-PoP zum optimalsten verfügbaren und fehlerfrei funktionierenden Endpunkt und nicht zum optimalsten Load Balancer leiten, kann die Plattform für den Datenverkehr zwischen Anwendungen oder zwischen Benutzern und Anwendungen eine deutlich höhere Leistung bieten als jede andere Lösung auf dem Markt.
- TCO-Vorteile — Bei großen SaaS-Anwendungen werden häufig Hunderte von Instanzen eines Dienstes über mehrere Rechenzentren weltweit bereitgestellt. Um dies effizient umzusetzen, muss der SaaS-Anbieter komplexe Funktionen entwickeln, die mit diesem verteilten Anwendungs-Gateway nun allen unseren Kunden zur Verfügung stehen.
Fortsetzung folgt…
In dieser Blogreihe beleuchten wir verschiedene Aspekte des Aufbaus und Betriebs unseres weltweit verteilten SaaS-Dienstes mit zahlreichen Anwendungsclustern in der Public Cloud, unseren privaten Netzwerk-PoPs und Edge-Standorten. Als Nächstes geht es um Plattform- und Datensicherheit…
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...