Big Data. Stündlich werden von Millionen von Sensoren und Überwachungsgeräten, die in Objekte entlang der gesamten Wertschöpfungskette eingebettet sind, Petabytes an Daten erzeugt. Von der Fertigung bis zur Auslieferung, vom Point of Sale bis zu den Verbrauchern entstehen Datenmengen in bislang ungekanntem Ausmaß.
Diese Daten sind für sich genommen bedeutungslos. Daten selbst sind eine Ansammlung von Einsen und Nullen in bestimmten Anordnungen, die durch die Interpretation einer App zu Informationen werden. Informationen werden erst dann nützlich, wenn sie analysiert werden, und erst dann zu Werten wenn auf ihrer Grundlage gehandelt wird.
Menschen können die heute erzeugten Daten nicht effektiv analysieren, geschweige denn jene, die in der nächsten Stunde, am nächsten Tag oder in der nächsten Woche anfallen werden. Gleichzeitig müssen Geschäftsentscheidungen zunehmend nahezu in Echtzeit getroffen werden. Dafür sind Rechenleistung und Systeme erforderlich, die darauf trainiert sind, in den täglich anfallenden riesigen Mengen an Störsignalen die relevanten Signale zu erkennen.
Das ist keineswegs nur eine Vermutung. In „Maschinelles Lernen: Das neue Erprobungsfeld für Wettbewerbsvorteile“ – einer von MIT Technology Review Custom und Google Cloud durchgeführten Umfrage – gaben über 60 % der Befragten an, „bereits Strategien für ML [maschinelles Lernen] umgesetzt zu haben, und fast ein Drittel betrachtete die eigenen Initiativen bereits als ausgereift“. Der Grund für ihre beträchtlichen Investitionen in diese noch junge Technologie ist der Wettbewerbsvorteil. „Den Befragten zufolge besteht ein wesentlicher Vorteil von ML darin, sich einen Wettbewerbsvorsprung verschaffen zu können, und 26 Prozent der Unternehmen, die ML derzeit einsetzen, waren der Ansicht, dieses Ziel bereits erreicht zu haben.“
Die prognostizierten Vorteile sind enorm.
“Für ein typisches Fortune-1000-Unternehmen führt bereits eine um 10 % höhere Datenverfügbarkeit zu einem zusätzlichen Nettogewinn von mehr als 65 Millionen US-Dollar.”
“Einzelhändler, die das volle Potenzial von Big Data ausschöpfen, könnten ihre operativen Margen um bis zu 60 % steigern.”
So weit, so gut. Wir nutzen Daten, um fundierte Entscheidungen zu treffen, die Unternehmen dabei helfen, eine führende Position einzunehmen und zu wachsen.
Die Gefahr liegt darin, nicht zu erkennen, dass jede Abhängigkeit mit Risiken verbunden ist. Wenn ich auf ein Auto angewiesen bin, um zum Supermarkt zu gelangen (weil es an meinem Wohnort keine öffentlichen Verkehrsmittel gibt), besteht das Risiko, dass diesem Auto etwas zustößt. Ein erhebliches Risiko. Wenn mein Unternehmen bei der Entscheidungsfindung auf Big Data angewiesen ist (und diese Entscheidungen möglicherweise sogar für mich getroffen werden, sofern man die Prognosen der Experten für bare Münze nimmt), besteht das Risiko, dass mit diesen Daten etwas geschieht.
Dabei spreche ich nicht vom offensichtlichen Verlust der Daten oder gar von deren Beschädigung. Ich spreche von einer heimtückischeren Bedrohung, die aus unserem Vertrauen in die Richtigkeit dieser Daten erwächst.
Um auf der Grundlage von Daten Entscheidungen treffen zu können – sei es im Privat- oder im Geschäftsleben –, müssen wir zunächst auf die Richtigkeit dieser Daten vertrauen können.
Schmutzige Big Data
Fehlerhafte Daten sind nichts Neues. Ich gebe zu, dass ich meine persönlichen Angaben gelegentlich etwas verfälsche, wenn sie verlangt werden, um auf einen Artikel oder eine Ressource im Internet zuzugreifen. Doch die neuen Datenströme sind nicht unbedingt durch diese Art harmloser Verfälschung gefährdet. Vielmehr droht ihnen die gezielte Manipulation durch böswillige Akteure, die entschlossen sind, Ihr Unternehmen vom Kurs abzubringen.
Da wir Entscheidungen auf der Grundlage von Daten treffen und diese meist nur dann hinterfragen, wenn offensichtliche Ausreißer auftreten, sind wir für die Gefahr einer schleichenden Verfälschung nahezu blind. Ähnlich wie bei dem inzwischen zum Klischee gewordenen Motiv, bei Banktransaktionen jeweils ein paar Cent abzuzweigen, können subtile Veränderungen der Daten unbemerkt bleiben. Ein allmählicher Anstieg der Nachfrage nach Produkt X in einem Markt könnte als Erfolg von Marketing- oder Werbemaßnahmen gewertet werden. Ein plötzlicher Rückgang der Nachfrage nach Produkt Y in anderen Märkten lässt sich häufig mit makroökonomischen Faktoren erklären. Wenn ich die Geduld und Entschlossenheit aufbringe, die Daten zu verfälschen, auf deren Grundlage Sie Entscheidungen in der Fertigung oder im Vertrieb treffen, kann ich erheblichen Einfluss auf Ihr Unternehmen nehmen.
Wie erheblich? Schlechte Datenqualität führt zu Umsatzeinbußen von rund 30 % – laut Ovum Research. Analytics Week hat eine faszinierende Liste mit Fakten zu Big Data zusammengestellt, die ähnliche Folgen schlechter Datenqualität aufzeigt, darunter:
“Mangelhafte Daten können Unternehmen 20–35 % ihres Betriebsumsatzes kosten.”
“Fehlerhafte Daten oder eine schlechte Datenqualität kosten US-Unternehmen jährlich 600 Milliarden US-Dollar.”
Klingt unwahrscheinlich? Web Scraping zur Informationsbeschaffung im Rahmen von Wirtschaftsspionage ist eine reale Bedrohung, und es gibt Teams, die sich eigens ihrer Abwehr widmen. Durch den Einsatz von APIs werden solche Aktivitäten noch einfacher und gefährlicher – mitunter sogar in Echtzeit. Wer also glaubt, dass niemand absichtlich fehlerhafte Daten in Ihren Datenstrom einschleusen wird, verschließt bewusst die Augen vor der Tatsache, dass böswillige Akteure uns oft (meistens) zwei Schritte voraus sind.
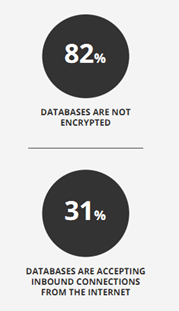
Unsere Sicherheitspraktiken – insbesondere in der Cloud, wo voraussichtlich ein Großteil der Big Data gespeichert wird – verschärfen diese Bedrohung. Ein von Information Builders gesponsertes Whitepaper von TDWI enthält viele weitere Beispiele für die Kosten fehlerhafter Daten. Die meisten beziehen sich zwar auf typische Probleme mit fehlerhaften Daten, die durch die Zusammenführung von Daten infolge von Übernahmen entstehen, oder auf die üblichen von Kunden geschönten Angaben. Die Kostenmodelle sind jedoch äußerst hilfreich, um die geschäftlichen Risiken zu verstehen, die entstehen, wenn man möglicherweise verfälschten Daten vertraut – und um zu erkennen, was man dagegen tun kann.
Allein in diesem Jahr waren Standardkonfigurationen die Ursache für mehrere Sicherheitsverletzungen. Erinnern Sie sich an das MongoDB-Debakel vom Januar? Damals ließen Standardkonfigurationen die Datenbanken für jeden im Internet, der sich dafür interessieren könnte, völlig ungeschützt zugänglich. Oder denken Sie an die RedLock-CSI-Studie, die 285 Instanzen von Kubernetes-Administrationskonsolen fand, die vollständig offen waren. Es waren keine Zugangsdaten erforderlich. Derselbe Bericht ergab, dass 31 % der unverschlüsselten Datenbanken in der Cloud eingehende Verbindungen aus dem Internet akzeptierten. Direkt. Als gäbe es nichts zwischen mir und Ihren Daten.
Wenn mehr als 27.000 Datenbanken ungeschützt bleiben und über das Internet zugänglich sind, weil keinerlei Anstrengungen zu ihrer Absicherung unternommen wurden, kann man sich leicht vorstellen, wie einfach Datenströme manipuliert werden könnten. Wenn Organisationen bewusst die standardmäßigen Sicherheitskontrollen von Cloud-Speicherdiensten entfernen und diese damit für unbefugten Zugriff und Manipulation weit offenlassen, wird die Vorstellung, dass böswillige Akteure manipulierte Daten einschleusen, von einer Möglichkeit zu einer Wahrscheinlichkeit. Organisationen, die auf Daten angewiesen sind – und das sind heute so gut wie alle –, müssen nicht nur darauf achten, wie sie diese Daten schützen, sondern auch, wie sie deren Richtigkeit überprüfen.
Sicherheit in der Zukunft datengetriebener Unternehmen bedeutet mehr als nur den Schutz vor Datenabfluss. Sie muss auch die sehr reale Gefahr einer Einschleusung von Daten berücksichtigen – und die Frage, wie sich diese bekämpfen lässt.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...