Das Herzstück der Verfügbarkeit ist die Überwachung. Jeder Load Balancer muss – bevor er eine Zielressource auswählt – wissen, ob diese Ressource tatsächlich verfügbar ist. Sonst wäre das Ganze schließlich sinnlos.
In Umgebungen, in denen die Lebensdauer von Ressourcen eher in Minuten als in Stunden oder Tagen gemessen wird, ist es umso wichtiger, den Status der Ressourcen zu kennen, bevor entschieden wird, eine Anfrage an sie zu senden.
Die Zustandsüberwachung ist ein wesentlicher Bestandteil von Load Balancern und Proxys. Das gilt (oder sollte gelten) auch in containerisierten Umgebungen. Während sich diese Umgebungen weiterhin (rasant) weiterentwickeln, entstehen neue Überwachungsmodelle, um den besonderen Herausforderungen solcher hochgradig dynamischen, verteilten Systeme zu begegnen.
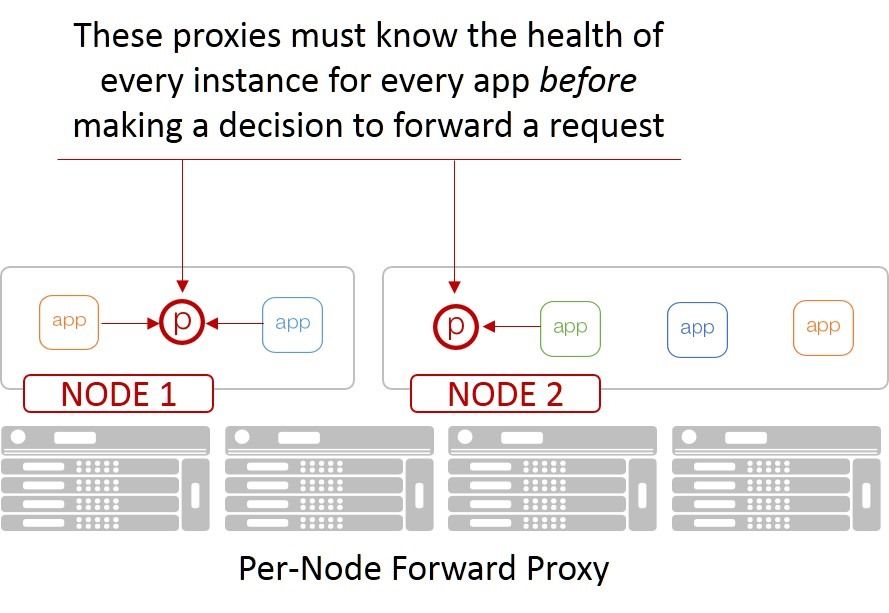
Die herkömmliche Zustandsüberwachung ist sicherlich ein Teil der Gleichung, doch einige Verfügbarkeits- und Skalierungsmodelle in Container-Umgebungen stellen die herkömmliche Zustandsüberwachung vor Herausforderungen, die bewältigt werden müssen. Beispielsweise wird von Proxys, die nach einem Forward-Proxy-Modell bereitgestellt werden, erwartet, dass sie ein fehlerfreies (verfügbares) Ziel aus allen möglichen Diensten auswählen können. Während ein Reverse-Proxy (also ein herkömmlicher Load Balancer) lediglich dafür zuständig ist, den Zustand einer ganz bestimmten Gruppe von Diensten für eine einzelne Anwendung zu überwachen, muss ein Forward-Proxy den Zustand jedes Dienstes für jede Anwendung in der Umgebung kennen. Denn eine Anfrage an einen Container zu senden, der bereits außer Betrieb ist, wäre schlecht, klar?
Traditionelle Zustandsüberwachung
Traditionell wird die Zustandsüberwachung durch einen Proxy auf zwei Arten durchgeführt:
- Aktive Überwachung: Senden von Prüf- oder Zustandsprüfungsanfragen an Container und Auswerten ihrer Antworten.
- Passive Überwachung: Beobachtung regulärer Clientanfragen und der zugehörigen Antworten.
Sie können sich vorstellen, dass die aktive Überwachung jedes Dienstes durch jeden Forward-Proxy den Datenverkehr im lokalen Netzwerk erheblich steigert und unnötig Ressourcen verbraucht. Eine aussagekräftige Überwachung erfolgt mindestens auf der TCP- und idealerweise auf der HTTP-Ebene. Schließlich ist die Netzwerkkonnektivität kein Indikator für den Zustand oder die Verfügbarkeit eines Dienstes. Das Belegen von TCP-Verbindungen und die erforderliche HTTP-Verarbeitung belasten die Container mit zunehmender Anzahl von Knoten (und damit Forward-Proxys) schnell. Sie möchten nicht hochskalieren müssen, nur weil die Container durch die Überwachung überlastet werden.
Passives Monitoring ist in diesem Fall die bessere Option, da es das überwachte System nicht belastet. In einigen Container-Umgebungen stößt es jedoch an seine Grenzen. Viele basieren auf Overlay-Netzwerkprinzipien, wodurch es schwierig ist, sicherzustellen, dass jeder Proxy jede Antwort eines Dienstes erfassen und nachverfolgen kann. Es ist nicht unmöglich, stellt aber auf der Netzwerkebene eine Herausforderung dar.
Beide Modelle belasten auch den Proxy selbst, da Ressourcen lediglich für die Überwachung der Umgebung aufgewendet werden müssen, anstatt für die eigentliche Aufgabe, für die sie vorgesehen sind: die Skalierung von Diensten.
Containerisierte Zustandsüberwachung
Auch Containerumgebungen sind von diesen Herausforderungen betroffen. Als Reaktion darauf zeichnen sich zwei neue Modelle ab, die zweifellos dazu beitragen werden, die Verfügbarkeit in Architekturen sicherzustellen, die Forward-Proxys zur Gewährleistung von Verfügbarkeit und Skalierbarkeit einsetzen.
Diese beiden Modelle sind:
- Umgebungsüberwachung: Proxys kennen den Zustand und die Verfügbarkeit der Container anhand von Informationen zur Containerintegrität aus der Container-Orchestrierungsumgebung (COE).
- Gemeinsame Überwachung: Da es in einer Umgebung wahrscheinlich viele Proxys gibt, kann die Überwachungsarbeit auf die Proxys verteilt und die Ergebnisse gemeinsam genutzt werden.
Die Überwachung der Umgebung ist häufig mit der Service-Registry verknüpft, die Container beim Eintritt in das System und beim Verlassen des Systems erfasst. Daher ist sie oft die maßgeblichste Quelle für Informationen zur Verfügbarkeit von Containern im System. Proxys können außerdem Ereignisse abonnieren, die durch das Erstellen und Löschen von Containern ausgelöst werden, um diese Ressourcen selbst nachzuverfolgen (und damit praktisch selbst als Registry zu fungieren).
Wenn beispielsweise die Zustandsüberwachung für eine Anwendung in Marathon aktiviert ist, kann ein Proxy das Feld 'healthCheckResults' verwenden. In Kubernetes können Proxys Liveness- und/oder Readiness-Prüfungen verwenden. Zustandsprüfungen der Umgebung ermöglichen es Proxys, bevorzugt fehlerfreie Endpunkte auszuwählen, noch bevor das Orchestrierungssystem einen fehlerhaften Endpunkt neu startet.
Eine gemeinsame Überwachung ist in Systemen, die Forward-Proxy-Modelle einsetzen, sehr sinnvoll, insbesondere wenn sie auf einem Service Mesh wie Istio basieren. Der dem Knoten zugeordnete Proxy kann den Zustand und die Verfügbarkeit der Container überwachen, an die er Anfragen weiterleitet (ähnlich wie er Dienste in einem Reverse-Proxy-Modell überwachen könnte). Allerdings sollte in einem solchen System nicht jeder Proxy aktiv jeden Endpunkt prüfen. Indem lokale Zustandsinformationen mit anderen Proxys (oder noch besser mit der Umgebung) geteilt werden, können alle Proxys den gesamten bekannten Zustand des Systems abrufen, ohne dass jeder Dienst übermäßig vielen Zustandsprüfungen unterzogen werden muss.
Im „Netzwerk“ vollziehen sich derzeit zahlreiche Veränderungen bei Anwendungsdiensten wie dem Load Balancing und bei der Art und Weise, wie diese zusammenspielen, um den Anforderungen neuer Modelle wie der Containerisierung gerecht zu werden. Diese Anforderungen setzen Proxys ständig unter Anpassungsdruck. Das liegt daran, dass Proxys zu den flexibelsten Technologien gehören, die in den vergangenen zwanzig Jahren entwickelt wurden, und nach wie vor eine wichtige Grundlage für die Konzeption, Entwicklung und Bereitstellung von Anwendungsdiensten bilden.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...