
Bei Volterra ist das SRE-Team für den Betrieb einer globalen SaaS-basierten Edge-Plattform zuständig. Wir müssen verschiedene Herausforderungen bei der Verwaltung einer großen Anzahl von Anwendungsclustern in unterschiedlichen Zuständen (z. B. online, offline, administrativ deaktiviert usw.) bewältigen. Dazu nutzen wir das Kubernetes-Ökosystem und die zugehörigen Tools mit einem deklarativen Pull-basierten Modell unter Verwendung von GitOps.
In diesem Blogbeitrag beschreiben wir:
GitOps zur effektiven Verwaltung und Überwachung einer großen Flotte von Infrastrukturen (physische Hosts oder Cloud-Hosts) und K8s-Clustern einsetzen
- Die Tools, die wir entwickelt haben, um Probleme im Bereich CI/CD zu lösen
- Objektorchestrierung und Konfigurationsmanagement
- Observability über die gesamte Flotte von Infrastruktur- und K8s-Clustern hinweg
Wir werden tiefer in die Materie eintauchen und die Erkenntnisse aus dem Betrieb in großem Maßstab (3.000 Edge-Standorte) beleuchten, die ich auch in meinem kürzlich gehaltenen Vortrag bei Cloud Native Rejekts in San Diego vorgestellt habe.
Kurzfassung (Zusammenfassung)
- Wir konnten keine einfache, sofort einsatzbereite Lösung finden, mit der sich Tausende (und potenziell Millionen) von Anwendungs- und Infrastrukturclustern in öffentlichen Clouds, lokalen Rechenzentren oder an wechselnden Standorten bereitstellen und betreiben lassen.
- Diese Lösung musste das Lebenszyklusmanagement für Hosts (physisch oder in der Cloud), die Kubernetes-Steuerungsebene und Anwendungs-Workloads sowie die fortlaufende Konfiguration verschiedener Dienste ermöglichen. Darüber hinaus musste die Lösung unsere SRE-Designanforderungen erfüllen: deklarative Definition, unveränderlicher Lebenszyklus, GitOps und kein direkter Zugriff auf Cluster.
- Nach der Evaluierung verschiedener Open-Source-Projekte – z. B. Kubespray+Ansible (für die Kubernetes-Bereitstellung) oder Helm/Spinnaker (für die Workload-Verwaltung) – kamen wir zu dem Schluss, dass keine dieser Lösungen unsere oben genannten Anforderungen erfüllen konnte, ohne an jedem Edge-Standort einen erheblichen Software-Overhead zu verursachen. Daher entschieden wir uns, einen eigenen Golang-basierten Software-Daemon zu entwickeln, der das Lebenszyklusmanagement des Hosts (physisch oder in der Cloud), der Kubernetes-Steuerungsebene und der Anwendungs-Workloads übernahm.
- Als wir das System auf 3.000 Cluster und mehr skalierten (innerhalb eines einzelnen Mandanten), erwiesen sich sämtliche unserer Annahmen über unsere Public-Cloud-Anbieter, die Skalierbarkeit unserer Software-Daemons, unsere Betriebswerkzeuge und unsere Observability-Infrastruktur nach und nach als unzutreffend. Um diese Herausforderungen zu bewältigen, mussten wir jeweils einige unserer Softwarekomponenten neu konzipieren.
Definition des Edge
- Customer Edge (CE) – Dabei handelt es sich um Kundenstandorte in der Cloud (z. B. AWS, Azure, GCP oder Private Cloud), lokale Standorte (z. B. Fertigungshallen, Öl-/Gasanlagen usw.) oder mobile Standorte (z. B. Fahrzeuge, Robotik usw.). CE wird vom Volterra-SRE-Team verwaltet, kann aber bei Bedarf auch von Kunden an Standorten ihrer Wahl bereitgestellt werden.
- Regional Edges (RE) — Hierbei handelt es sich um Volterra-Präsenzpunkte (PoPs) in Colocation-Einrichtungen in großen Metropolregionen, die über unser eigenes, engmaschig vermaschtes privates Backbone miteinander verbunden sind. Diese regionalen Edge-Standorte dienen außerdem dazu, Customer-Edge-Standorte (CE) sicher miteinander zu verbinden und/oder Anwendungsdienste im öffentlichen Internet bereitzustellen. Die RE-Standorte werden vollständig vom Volterra-Team für den Infrastrukturbetrieb (Infra SRE) verwaltet und befinden sich in dessen Besitz.
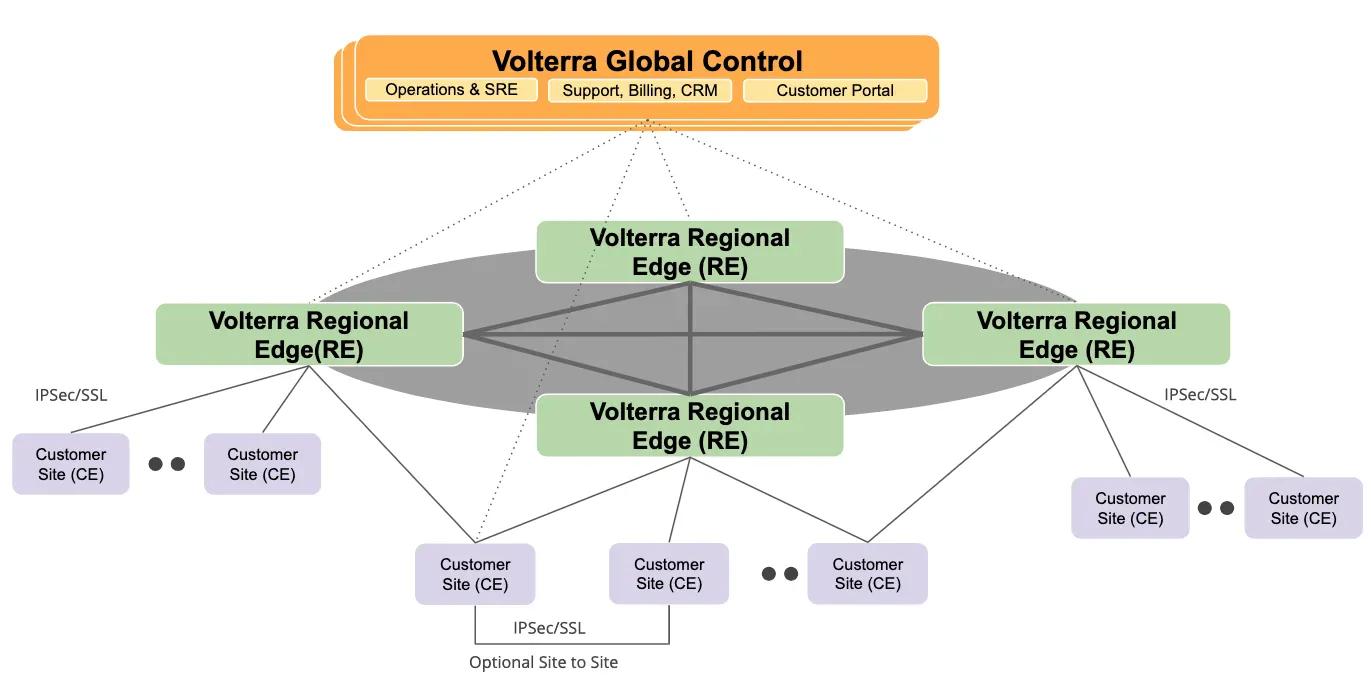
Das obige Architekturdiagramm (Abbildung 1) zeigt die logische Konnektivität zwischen unseren REs und CEs, wobei jede CE redundante Verbindungen (IPSec- oder SSL-VPN) zur nächstgelegenen RE herstellt.
Anforderungen an das Edge-Management
Als wir vor etwa zwei Jahren mit der Entwicklung unserer Plattform begannen, bat uns unser Produktteam, Lösungen für die folgenden Herausforderungen zu finden:
- Systemskalierbarkeit — unsere Kunden benötigten Unterstützung für Tausende (letztlich Millionen) von Edge-Standorten, was sich grundlegend vom Betrieb einer Handvoll Kubernetes-Cluster in Cloud-Regionen unterscheidet. Einer unserer Kunden betreibt beispielsweise rund 17.000 Convenience-Stores, ein anderer mehr als 20.000 Ladestationen. Aufgrund dieser Größenordnung mussten wir unsere Tools ganz anders konzipieren als für die Verwaltung einiger weniger Cluster.
- Bereitstellung ohne manuellen Eingriff — da jeder in der Lage sein sollte, einen neuen Standort bereitzustellen, ohne viel von der Hardware, der Software oder Kubernetes verstehen zu müssen. Der Edge-Standort sollte sich wie eine Blackbox verhalten, die sich einschaltet, Kontakt zur Zentrale aufnimmt und online geht.
- Flottenmanagement – vereinfachte Verwaltung Tausender Standorte und Workloads, ohne diese einzeln verwalten zu müssen. Jeder Standort kann zum Zeitpunkt einer angeforderten Änderung oder Aktualisierung offline oder nicht verfügbar sein. Daher müssen die Standorte Aktualisierungen abrufen, sobald sie wieder online sind.
- Fehlertoleranz — Edge-Standorte müssen auch nach dem Ausfall einer beliebigen Komponente betriebsbereit bleiben. Alles muss aus der Ferne verwaltet werden können und Funktionen wie das Zurücksetzen auf die Werkseinstellungen oder den Neuaufbau des Standorts im Fehlerfall bieten. Wir mussten davon ausgehen, dass kein physischer Zugang zum Standort möglich ist.
Designprinzipien (Kein Kubectl! Kein Ansible! Keine Pakete!)
Angesichts unserer Anforderungen und der Herausforderungen beim Betrieb eines stark verteilten Systems haben wir mehrere Grundsätze festgelegt, an die sich unser SRE-Team halten sollte, um daraus resultierende Probleme zu reduzieren:
- Deklarative Definition — das gesamte System muss deklarativ beschrieben werden, da wir so ein einfaches Abstraktionsmodell erstellen und eine Validierung anhand dieses Modells durchführen können.
- Unveränderliches Lebenszyklusmanagement — in der Vergangenheit arbeiteten wir an großen Private-Cloud-Installationen und setzten dabei veränderliche LCM-Tools wie Ansible, Salt oder Puppet ein. Dieses Mal wollten wir das Basisbetriebssystem sehr einfach halten und versuchen, alles als Container bereitzustellen – ohne Paketverwaltung und ohne Konfigurationsmanagement-Tools.
- GitOps — bietet ein standardisiertes Betriebsmodell für die Verwaltung von Kubernetes-Clustern. Zudem erhalten wir damit ohne zusätzlichen Aufbau eines Workflow-Management-Systems sofort einsatzbereite Funktionen für Genehmigungen, Audits und Änderungsworkflows. Daher haben wir beschlossen, dass alles über Git laufen muss.
- Kein kubectl — Dies war einer der wichtigsten Grundsätze, da niemand direkten Zugriff auf Anwendungscluster haben darf. Daher haben wir die Möglichkeit entfernt, kubectl innerhalb einzelner Edge-Cluster auszuführen oder Skripte zu verwenden, die von zentralen Stellen aus ausgeführt werden, einschließlich zentralisierter CD-Systeme. Zentralisierte CD-Systeme mit einer Push-Methode eignen sich gut für einige Dutzend Cluster, aber ohne eine Garantie für eine hundertprozentige Netzwerkverfügbarkeit keinesfalls für Tausende.
- Keine Hype-Technologien (oder -Tools) — unsere bisherigen Erfahrungen haben gezeigt, dass viele der beliebten Open-Source-Tools dem Hype um sie nicht gerecht werden. Obwohl wir mehrere Community-Projekte für die Bereitstellung von Infrastruktur, K8s und Anwendungs-Workloads (wie Helm, Spinnaker und Terraform) evaluiert haben, setzten wir letztlich nur Terraform für den Bereich der virtuellen Infrastruktur ein und entwickelten eigenen Code, den wir in den folgenden Teilen dieses Blogs beschreiben werden.
Lebenszyklusmanagement für Standorte
Im Rahmen des Lebenszyklusmanagements für Edge-Standorte mussten wir Lösungen für die Bereitstellung des Host-Betriebssystems, grundlegende Konfigurationen (z. B. Benutzerverwaltung, Zertifizierungsstelle, Hugepages usw.), die Inbetriebnahme von K8s, die Bereitstellung von Workloads und die Verwaltung fortlaufender Konfigurationsänderungen entwickeln.
Eine der Optionen, die wir in Betracht gezogen, letztlich aber verworfen haben, war der Einsatz von KubeSpray+Ansible (zur Verwaltung des Betriebssystems und zur Bereitstellung von K8s) sowie Helm/Spinnaker (zur Bereitstellung von Workloads). Wir haben uns dagegen entschieden, weil wir dafür zwei bis drei Open-Source-Tools hätten verwalten und anschließend umfangreiche Anpassungen vornehmen müssen, um unsere Anforderungen zu erfüllen. Diese nahmen mit der Einführung weiterer Funktionen wie der automatischen Skalierung von Edge-Clustern, der Unterstützung sicherer TPM-Module, differenzieller Upgrades usw. stetig zu.
Da unser Ziel darin bestand, die Lösung einfach zu halten und die Anzahl der Komponenten zu minimieren, die direkt im Betriebssystem (außerhalb von Kubernetes) ausgeführt werden, entschieden wir uns, einen schlanken Golang-Daemon namens Volterra Platform Manager (VPM) zu entwickeln. Er ist der einzige von systemd verwaltete Docker-Container im Betriebssystem und fungiert als Schweizer Taschenmesser, das zahlreiche Aufgaben übernimmt:
Host-Lebenszyklus
VPM ist für die Verwaltung des Lebenszyklus des Host-Betriebssystems verantwortlich, einschließlich Installation, Upgrades, Patches, Konfiguration usw. Dabei müssen zahlreiche Aspekte konfiguriert werden (z. B. die Zuweisung von Hugepages, /etc/hosts usw.).
- Verwaltung von Betriebssystem-Upgrades – leider geht es beim Edge Computing nicht nur um Kubernetes, sondern wir müssen auch die Version des Kernels und des Betriebssystems insgesamt verwalten. Unsere Edge-Plattform basiert auf CoreOS (oder je nach Kundenanforderung auf CentOS) und verfügt über eine aktive und eine passive Partition. Wenn ein Upgrade geplant ist, werden Updates stets auf die passive Partition heruntergeladen. Der letzte Schritt des Updates ist ein Neustart, bei dem die aktive und die passive Partition getauscht werden. Der einzige kritische Aspekt ist die Neustartstrategie (bei einem Cluster mit mehreren Knoten), da nicht alle Knoten gleichzeitig neu gestartet werden können. Wir haben in VPM eine eigene etcd-Neustartsperre implementiert, durch die die Knoten eines Clusters nacheinander neu gestartet werden.
- Verwaltung des Benutzerzugriffs auf das Betriebssystem — wir müssen Benutzer und deren Remotezugriff über SSH sowie auf die Konsole beschränken. VPM übernimmt all diese Vorgänge, beispielsweise die Rotation von SSH-Zertifizierungsstellen.
- Da wir unseren eigenen L3-L7-Datenpfad entwickelt haben, müssen wir je nach Hardwaretyp (oder Cloud-VM) 2M- oder 1G-Hugepages im Host-Betriebssystem konfigurieren.
Kubernetes-Lebenszyklus
Verwaltung des Lebenszyklus von Kubernetes-Manifesten. Anstelle von Helm haben wir uns für die K8s-Bibliothek client-go entschieden, die wir in VPM integriert haben und von der wir mehrere Funktionen nutzen:
- Optimistisches vs. pessimistisches Deployment — mit dieser Funktion können wir Anwendungen danach kategorisieren, ob wir warten müssen, bis sie fehlerfrei ausgeführt werden. Dazu wird lediglich im K8s-Manifest nach folgender Annotation gesucht: ves.io/deploy: optimistic.Optimistisch = Ressource erstellen und nicht auf den Status warten. Dies ist dem Befehl kubernetes apply sehr ähnlich, bei dem nicht ersichtlich ist, ob die eigentlichen Pods erfolgreich gestartet werden. Pessimistisch = auf den Status der Kubernetes-Ressource warten. Bei einem Deployment wird beispielsweise gewartet, bis alle Pods bereit sind. Dies ähnelt dem neuen Befehl kubectl wait.
- Aktionen vor dem Update wie Pre-Pull — manchmal kann man sich nicht auf rollierende K8s-Updates verlassen, insbesondere wenn die Netzwerk-Datenebene bereitgestellt wird. Der Grund dafür ist, dass der alte Pod gelöscht und anschließend der neue Pod heruntergeladen wird. Im Fall der Datenebene geht jedoch die Netzwerkverbindung verloren. Daher kann das neue Container-Image nicht heruntergeladen werden und der Pod wird nie gestartet. Die Metadaten-Annotation ves.io/prepull mit einer Liste von Images löst den Download aus, bevor das K8s-Manifest angewendet wird.
- Wiederholungsversuche und Rollbacks bei Fehlern während der Anwendung. Dies kommt sehr häufig vor, wenn ein K8s-API-Server zeitweise ausfällt.
Laufende Konfiguration
Zusätzlich zu den Konfigurationen für K8s-Manifeste müssen wir auch verschiedene Volterra-Dienste über deren APIs konfigurieren. Ein Beispiel hierfür sind IPsec-/SSL-VPN-Konfigurationen: VPM empfängt die Konfiguration von unserer globalen Steuerungsebene und spielt sie auf den einzelnen Knoten ein.
Zurücksetzen auf Werkseinstellungen
Mit dieser Funktion können wir eine Box aus der Ferne auf ihren ursprünglichen Zustand zurücksetzen und den gesamten Installations- und Registrierungsprozess erneut durchführen. Sie ist von entscheidender Bedeutung für die Wiederherstellung eines Standorts, für die andernfalls ein Zugriff über die Konsole bzw. ein physischer Zugriff erforderlich wäre.
Auch wenn das K8s-Lebenszyklusmanagement für viele ein großes Diskussionsthema zu sein scheint, macht es für unser Team wahrscheinlich nur 40–50 % des gesamten Arbeitsaufwands aus.
Zero-Touch-Bereitstellung
Die Zero-Touch-Bereitstellung des Edge-Standorts an einem beliebigen Ort (Cloud, On-Premises oder mobiler Edge) ist eine entscheidende Funktion, da wir weder davon ausgehen können, Zugriff auf die einzelnen Standorte zu haben, noch so viele Kubernetes-Experten beschäftigen möchten, um diese Standorte einzeln zu installieren und zu verwalten. Das lässt sich schlichtweg nicht auf Tausende von Standorten skalieren.
Das folgende Diagramm (Abbildung 2) zeigt, wie VPM am Prozess der Registrierung eines neuen Standorts beteiligt ist:
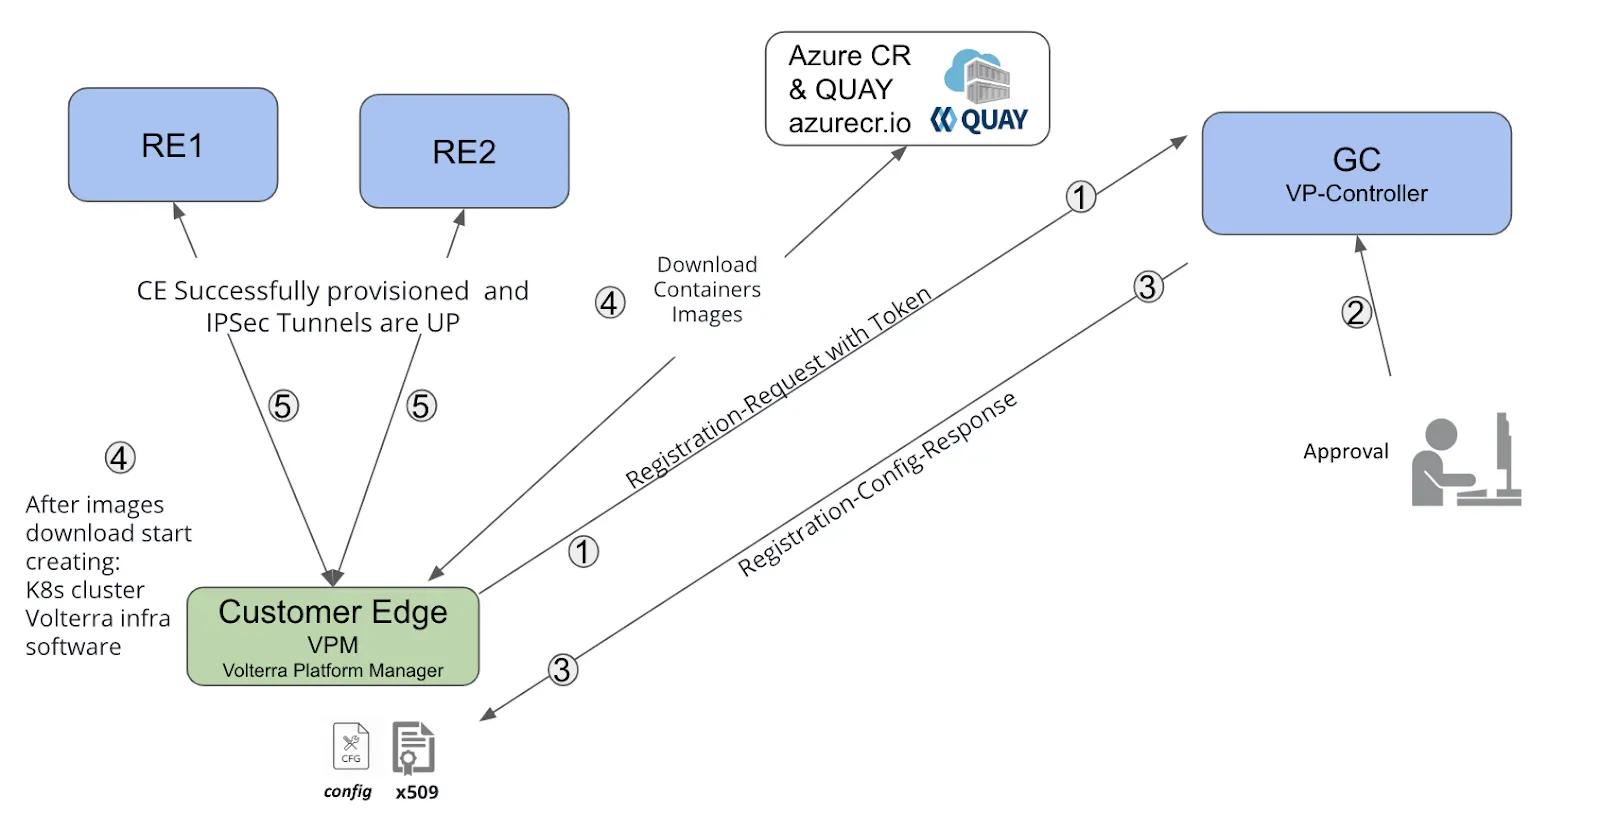
- Nach dem Einschalten übermittelt der auf dem CE ausgeführte VPM (durch das grüne Kästchen dargestellt) ein Registrierungstoken an unsere globale Steuerungsebene (GC), um eine neue Registrierung anzulegen. Das Registrierungstoken wird im Rahmen der cloud-init-Konfiguration der Cloud-VM bereitgestellt. Dabei kann es sich um einen Schlüssel handeln, der während des Startvorgangs manuell eingegeben oder bei Edge-Hardware im TPM hinterlegt wird.
- GC empfängt die Anfrage mit dem Token und kann damit eine neue Registrierung unter einem Mandanten erstellen, der im Token codiert ist. Der Kundenadministrator kann den neuen Edge-Standort sofort auf der Karte sehen, ihn genehmigen und dabei einen Namen sowie weitere Konfigurationsparameter eingeben.
- Der VP-Controller innerhalb von GC generiert die Konfiguration (z. B. legt er fest, wer K8s-Master, Minion usw. ist) sowie Zertifikate für etcd, K8s und VPM.
- VPM beginnt mit der Initialisierung des Standorts. Dazu gehören das Herunterladen von Docker-Images, die Konfiguration von Hugepages, die Installation des K8s-Clusters und das Starten der Volterra-Control-Plane-Dienste.
- VPM konfiguriert redundante Tunnel (IPSec/SSL-VPN) zu den beiden nächstgelegenen Regional-Edge-Standorten, die für den Datenverkehr und die standortübergreifende Konnektivität sowie die Anbindung an das öffentliche Netzwerk verwendet werden.
Wie Sie sehen, ist der gesamte Prozess vollständig automatisiert. Der Benutzer muss weder die Einzelheiten der Konfiguration kennen noch manuelle Schritte ausführen. Es dauert etwa fünf Minuten, bis das gesamte Gerät online und bereit ist, Kundenanwendungen und -anfragen zu verarbeiten.
Upgrades der Infrastruktursoftware
Upgrades gehören zu den komplexesten Herausforderungen, die wir lösen mussten. Sehen wir uns an, was an Edge-Standorten aktualisiert wird:
- Betriebssystem-Upgrades — dies umfasst den Kernel und alle Systempakete. Wer schon einmal eine Standard-Linux-Distribution betrieben hat, weiß, wie mühsam ein Upgrade zwischen Nebenversionen (z. B. von Ubuntu 16.04.x auf 16.04.y) und wie viel aufwendiger ein Upgrade zwischen Hauptversionen (z. B. von Ubuntu 16.04 auf 18.04) ist. Bei Tausenden von Standorten müssen Upgrades deterministisch ablaufen und dürfen sich nicht von Standort zu Standort unterschiedlich verhalten. Daher haben wir uns für CoreOS und CentOS Atomic entschieden, die A/B-Upgrades mit zwei Partitionen und schreibgeschützten Dateisystempfaden ermöglichen. Dadurch können wir ein Upgrade durch Ändern der Bootreihenfolge der Partitionen sofort rückgängig machen und das Betriebssystem konsistent halten, ohne Betriebssystempakete verwalten zu müssen. Allerdings können wir einzelne Systemkomponenten, beispielsweise den OpenSSH-Server, nicht mehr einfach durch die Installation eines neuen Pakets aktualisieren. Änderungen an einzelnen Komponenten müssen als neue, unveränderliche Betriebssystemversion veröffentlicht werden.
- Software-Upgrades — dies umfasst VPM, etcd, Kubernetes und die als K8s-Workloads ausgeführten Volterra-Steuerungsdienste. Wie bereits erwähnt, ist es unser Ziel, alles innerhalb von K8s als systemd-Container auszuführen. Glücklicherweise konnten wir alles bis auf drei Dienste in K8s-Workloads umwandeln: VPM, etcd und kubelet.
Es gibt zwei bekannte Methoden, mit denen Updates an Edge-Standorte verteilt werden können:
- Push-basiert – eine Push-Methode wird in der Regel mithilfe eines zentralisierten CD-Tools (Continuous Delivery) wie Spinnaker, Jenkins oder eines Ansible-basierten CM-Tools umgesetzt. In diesem Fall muss ein zentrales Tool Zugriff auf den Zielstandort oder -Cluster haben und für die Ausführung der Aktion verfügbar sein.
- Pull-basiert — bei einer Pull-basierten Methode werden Upgrade-Informationen unabhängig und ohne zentralen Bereitstellungsmechanismus abgerufen. Sie ist besser skalierbar und macht es zudem überflüssig, die Zugangsdaten aller Standorte an einem zentralen Ort zu speichern.
Unser Ziel für das Upgrade bestand darin, größtmögliche Einfachheit und Zuverlässigkeit zu erreichen – ähnlich wie bei herkömmlichen Smartphone-Updates. Darüber hinaus musste die Upgrade-Strategie weitere Aspekte berücksichtigen: So ist der Upgrade-Kontext möglicherweise nur dem Betreiber des Standorts bekannt, oder das Gerät ist aufgrund von Verbindungsproblemen zeitweise offline bzw. nicht verfügbar. Diese Anforderungen ließen sich mit der Pull-Methode leichter erfüllen, weshalb wir uns entschieden haben, sie für unsere Zwecke einzusetzen.
GitOps
Darüber hinaus haben wir uns für GitOps entschieden, da wir unserem SRE-Team damit leichter ein standardisiertes Betriebsmodell für die Verwaltung von Kubernetes-Clustern und Workflows sowie für die Prüfung von Änderungen bereitstellen konnten.
Um die Skalierungsprobleme bei Tausenden von Websites zu lösen, entwickelten wir die in Abbildung 3 dargestellte SRE-Architektur:
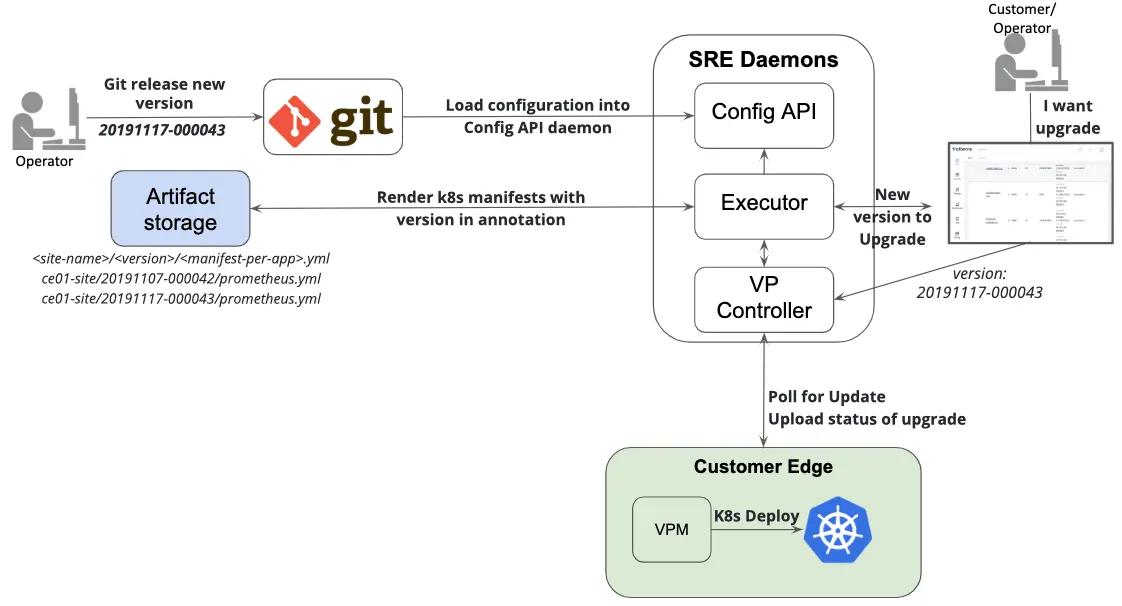
Zunächst möchte ich betonen, dass wir Git nicht nur zum Speichern von Zuständen oder Manifesten verwenden. Der Grund dafür ist, dass unsere Plattform nicht nur K8s-Manifeste, sondern auch fortlaufende API-Konfigurationen, K8s-Versionen usw. verwalten muss. In unserem Fall machen K8s-Manifeste etwa 60 % der gesamten deklarativen Konfiguration aus. Daher mussten wir darauf aufbauend unsere eigene DSL-Abstraktion entwickeln, die in Git gespeichert wird. Da Git außerdem weder eine API noch Funktionen zum Zusammenführen von Parametern bietet, mussten wir zusätzliche Golang-Daemons für SRE entwickeln: Config API, Executor und VP Controller.
Sehen wir uns den Workflow für die Bereitstellung einer neuen Softwareversion am Kundenstandort mithilfe unserer SaaS-Plattform an:
- Der Operator beschließt, eine neue Version zu veröffentlichen, und öffnet einen Merge Request (MR) für das Git-Modell
- Sobald dieser MR genehmigt und zusammengeführt wurde, löst die CI das Laden einer Git-Modellkonfiguration in unseren SRE-Config-API-Daemon aus. Dieser Daemon verfügt über mehrere APIs für die Zusammenführung von Parametern, die interne DNS-Konfiguration usw.
- Die Config-API wird vom Executor-Daemon überwacht. Unmittelbar nachdem die Git-Änderungen geladen wurden, beginnt er mit dem Rendern der endgültigen K8s-Manifeste, deren Version in einer Annotation angegeben ist. Diese Manifeste werden anschließend in den Artefaktspeicher (ähnlich wie S3) unter folgendem Pfad hochgeladen: ce01-site//.yml
- Sobald die neue Version gerendert und in den Artefaktspeicher hochgeladen wurde, übermittelt Executor der Kunden-API einen neuen Status mit einer verfügbaren Version. Dies ist vergleichbar mit der Benachrichtigung über eine neue verfügbare Version auf Mobiltelefonen.
- Der Kunde (oder Betreiber) kann ein Update seiner Site auf die neueste Version planen. Diese Information wird an den VP-Controller weitergeleitet. Der VP-Controller ist der für die Site-Verwaltung zuständige Daemon, einschließlich der Bereitstellung, Außerbetriebnahme oder Migration an einen anderen Standort. Dies wurde bereits teilweise im Zusammenhang mit der Zero-Touch-Bereitstellung erläutert. Der VP-Controller ist für die Aktualisierung von Edge-Sites über die mTLS-API verantwortlich.
- Der letzte Schritt im Diagramm erfolgt am Edge-Standort: Sobald die IPSec/SSL-VPN-Verbindung hergestellt ist, weist der VP-Controller den VPM am Edge-Standort an, Updates mit der neuen Version herunterzuladen. Ist die Verbindung jedoch unterbrochen oder zeitweise gestört, fragt der VPM alle 5 Minuten nach einem Update.
- Neue K8s-Manifeste und -Konfigurationen werden abgerufen und in K8s bereitgestellt. Mithilfe der im vorherigen Abschnitt beschriebenen Funktion für pessimistische Bereitstellungen wartet VPM, bis alle Pods bereit sind.
- Im letzten Schritt sendet VPM den Status des Upgrades an den VP Controller zurück, der ihn anschließend als Status an die Kunden-API übermittelt.
Hier können Sie sich eine Demo des gesamten Workflows ansehen:
Erkenntnisse aus Tests an 3.000 Edge-Standorten
In den vorherigen Abschnitten haben wir beschrieben, wie unsere Tools zur Bereitstellung und Verwaltung des Lebenszyklus von Edge-Standorten eingesetzt werden. Um unser Konzept zu validieren, haben wir uns entschieden, eine groß angelegte Umgebung mit dreitausend Edge-Standorten von Kunden aufzubauen (wie in Abbildung 4 dargestellt).
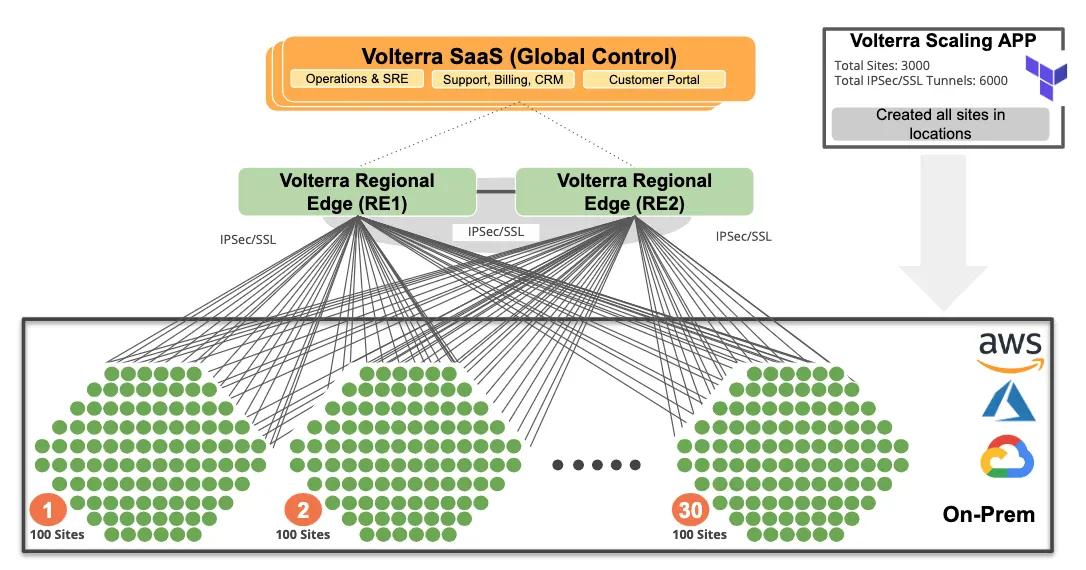
Wir haben Terraform verwendet, um 3.000 VMs in AWS, Azure, Google und unserer eigenen lokalen Bare-Metal-Cloud bereitzustellen und so eine Umgebung in entsprechendem Umfang zu simulieren. Bei all diesen VMs handelte es sich um unabhängige CEs (Customer Edge Sites), die redundante Tunnel zu unseren regionalen Edge-Standorten (auch PoPs genannt) aufbauten.
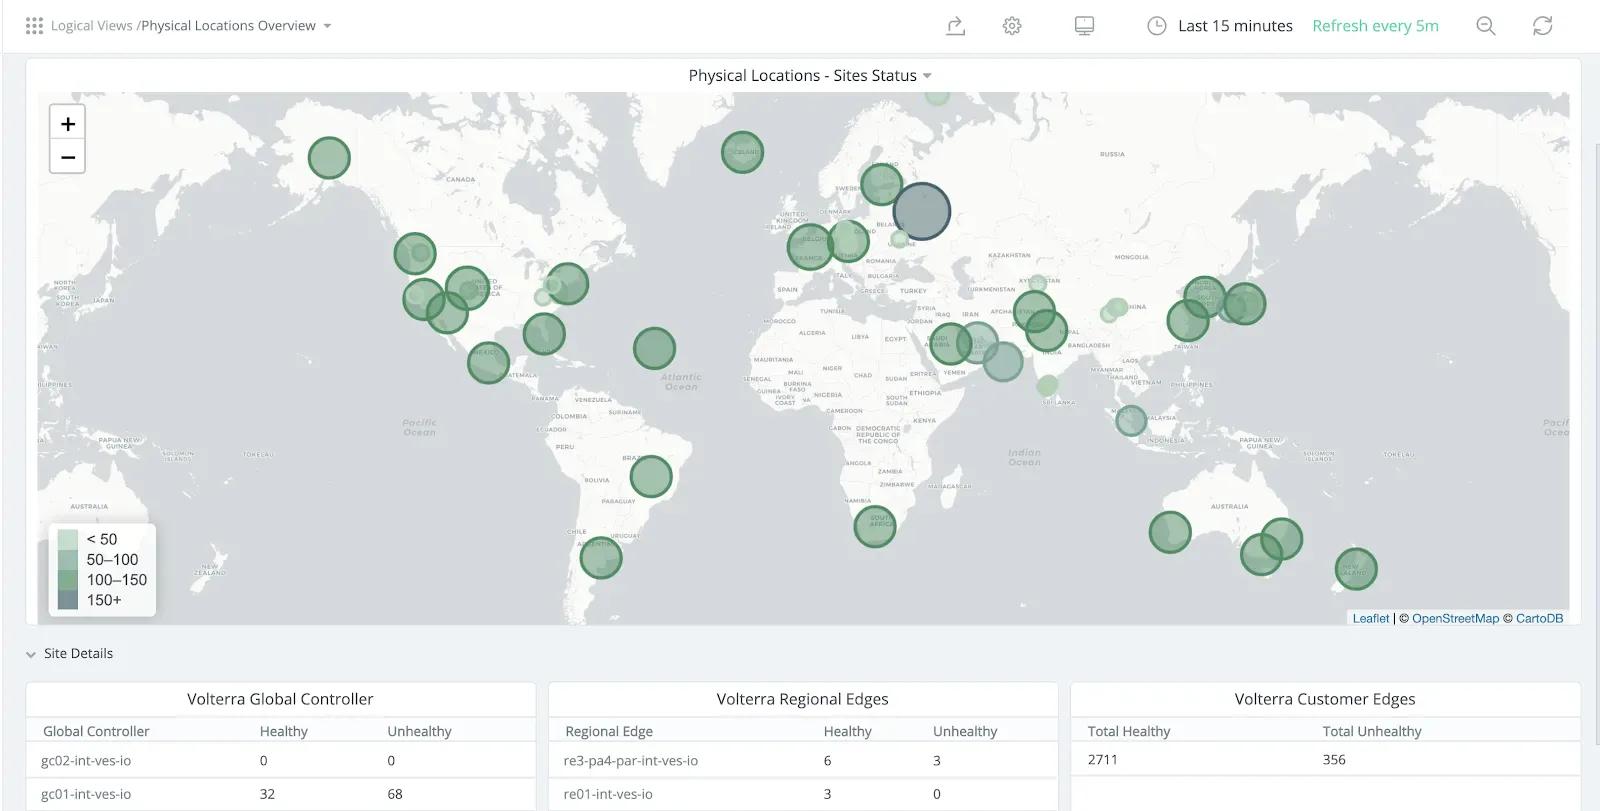
Der folgende Screenshot stammt aus unserem SRE-Dashboard und zeigt die Anzahl der Edge-Standorte an den jeweiligen Orten, dargestellt durch die Größe der Kreise. Zum Zeitpunkt der Aufnahme hatten wir etwa 2711 fehlerfrei funktionierende und 356 beeinträchtigte Edge-Standorte.
Wichtigste Erkenntnisse: Betrieb
Im Zuge der Skalierung stießen wir auf einige Probleme bei der Konfiguration und im Betrieb, die Anpassungen an unseren Software-Daemons erforderlich machten. Darüber hinaus traten bei einem Cloud-Anbieter zahlreiche Probleme auf, die zur Eröffnung mehrerer Support-Tickets führten – beispielsweise lange API-Antwortzeiten oder die Tatsache, dass in einer einzelnen Region nicht mehr als 500 VMs bereitgestellt werden konnten.
- VP-Controller optimieren — anfangs verarbeiteten wir die Registrierungen sequenziell, wobei jede etwa zwei Minuten dauerte, da wir verschiedene Zertifikate für etcd, Kubernetes und VPM ausstellen mussten. Wir verkürzten diese Zeit durch vorgenerierte Schlüssel mit höherer Entropie und durch Parallelisierung mit einer größeren Anzahl von Workern. Dadurch konnten wir die Registrierung von 100 Standorten in weniger als 20 Sekunden verarbeiten. Mit nur etwa einer vCPU und 2 GB RAM auf unserem VP-Controller konnten wir alle 3.000 Edge-Standorte bedienen.
- Bereitstellung von Docker-Images optimieren — als wir mit der Skalierung begannen, stellten wir fest, dass die an die Edge-Standorte übertragene Datenmenge enorm ist. Jeder Edge-Standort lud etwa 600 MB herunter (multipliziert mit 3.000), sodass insgesamt 1,8 TB an Daten übertragen wurden. Da wir die Edge-Standorte während unserer Tests zudem mehrmals neu aufsetzten, war diese Zahl tatsächlich noch deutlich höher. Daher mussten wir die Größe unserer Docker-Images optimieren und Cloud- sowie ISO-Images mit bereits vorab heruntergeladenen Docker-Images erstellen, um das Downloadvolumen zu reduzieren. Wir nutzen zwar weiterhin einen öffentlichen Cloud-Container-Registry-Dienst, arbeiten jedoch aktiv an einem Konzept, um unsere Container-Registry über REs (PoPs) zu verteilen und inkrementelle Upgrades (mittels Binär-Diffs) durchzuführen.
- Vorgänge in der globalen Steuerungsdatenbank optimieren — alle unsere Volterra-Steuerungsdienste basieren auf dem Golang-Service-Framework, das ETCD als Datenbank verwendet. Jeder Standort wird als Konfigurationsobjekt dargestellt. Jedes Standortkonfigurationsobjekt verfügt über einige StatusObjects wie software-upgrade, hardware-info oder ipsec-status. Diese StatusObjects werden von verschiedenen Plattformkomponenten erzeugt und in einer globalen Konfigurations-API referenziert. Als wir 3.000 Standorte erreichten, mussten wir bestimmte Optimierungen an unserem Objektschema vornehmen. Beispielsweise begrenzten wir die Anzahl der von der globalen Konfigurations-API akzeptierten StatusObject-Typen oder verschoben sie in eine dedizierte ETCD-Instanz, um das Risiko einer Überlastung der Konfigurationsobjektdatenbank zu verringern. Dadurch können wir eine höhere Verfügbarkeit und kürzere Antwortzeiten für die Konfigurationsdatenbank gewährleisten und die Statusdatenbank bei Ausfällen neu aufbauen. Eine weitere Optimierung bestand darin, unnötige Vorgänge zum Auflisten von Standortobjekten über alle Mandanten hinweg zu vermeiden oder Sekundärindizes einzuführen, um die Datenbanklast zu reduzieren.
Wichtigste Erkenntnisse: Beobachtbarkeit
Mit der Skalierung des Systems wurde die Beobachtbarkeit im gesamten verteilten System zu einer deutlich größeren Herausforderung.
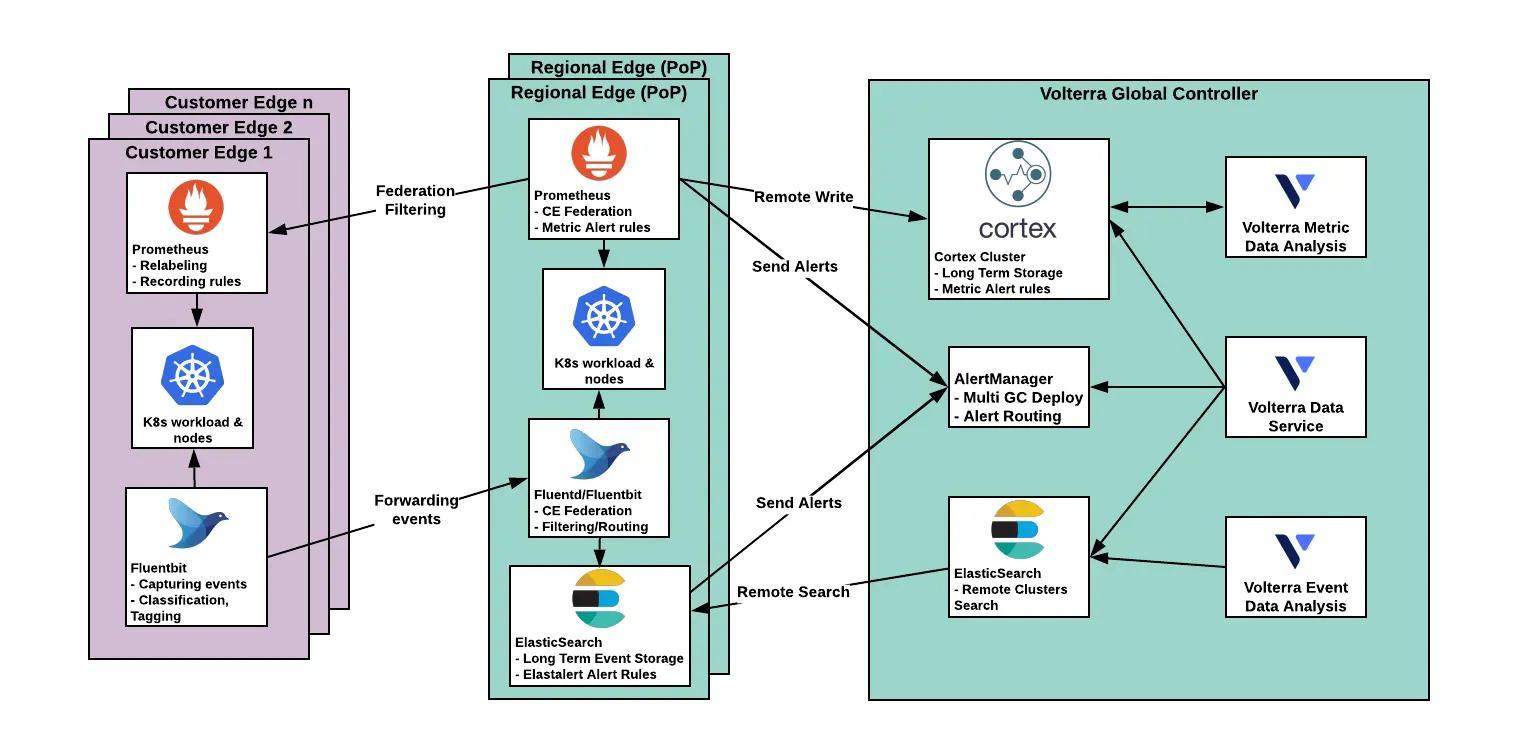
Für die Metriken setzten wir zunächst auf Prometheus-Föderation: Eine zentrale Prometheus-Instanz in der globalen Steuerung föderierte die Prometheus-Instanzen an den regionalen Edges (REs). Diese erfassten ihre eigenen Service-Metriken und föderierten die Metriken der mit ihnen verbundenen CEs. Die oberste Prometheus-Instanz wertete Warnmeldungen aus und diente als Metrikquelle für weitere Analysen. Wir stießen mit diesem Ansatz schnell an Grenzen (bei etwa 1.000 CEs) und versuchten, die Auswirkungen der wachsenden Anzahl von CEs zu minimieren. Dazu begannen wir, vorberechnete Zeitreihen für Histogramme und andere Metriken mit hoher Kardinalität zu erzeugen. Das verschaffte uns ein oder zwei Tage Zeit, danach mussten wir Positivlisten für Metriken einsetzen. Letztlich konnten wir die Anzahl der Metrik-Zeitreihen pro CE-Standort von etwa 60.000 auf 2.000 reduzieren.
Nachdem wir schließlich auf mehr als 3000 CE-Standorte skaliert und das System viele Tage lang in der Produktion betrieben hatten, wurde deutlich, dass dieser Ansatz nicht skalierbar war und wir unsere Monitoring-Infrastruktur überdenken mussten. Wir beschlossen, die übergeordnete Prometheus-Instanz (in der globalen Steuerung) abzuschaffen und Prometheus in jeder RE in zwei separate Instanzen aufzuteilen. Eine ist für das Scraping lokaler Service-Metriken zuständig, die andere für die Föderation von CE-Metriken. Beide erzeugen Warnmeldungen und übertragen Metriken an den zentralen Speicher in Cortex. Cortex dient als Datenquelle für Analysen und Visualisierungen und ist nicht Teil des zentralen Ablaufs für Monitoring und Alarmierung. Wir testeten mehrere zentralisierte Metriklösungen, darunter Thanos und M3db, und stellten fest, dass Cortex unsere Anforderungen am besten erfüllte.
Der folgende Screenshot (Abbildung 7) zeigt den Speicherverbrauch beim Scraping von prometheus-cef bei 3.000 Endpunkten. Bemerkenswert ist der RAM-Verbrauch von 29,7 GB, der angesichts der Größenordnung des Systems tatsächlich nicht besonders hoch ist. Weitere Optimierungen sind möglich, indem das Scraping auf mehrere Instanzen verteilt oder der Remote Write zu Cortex direkt auf den Edge verlagert wird.
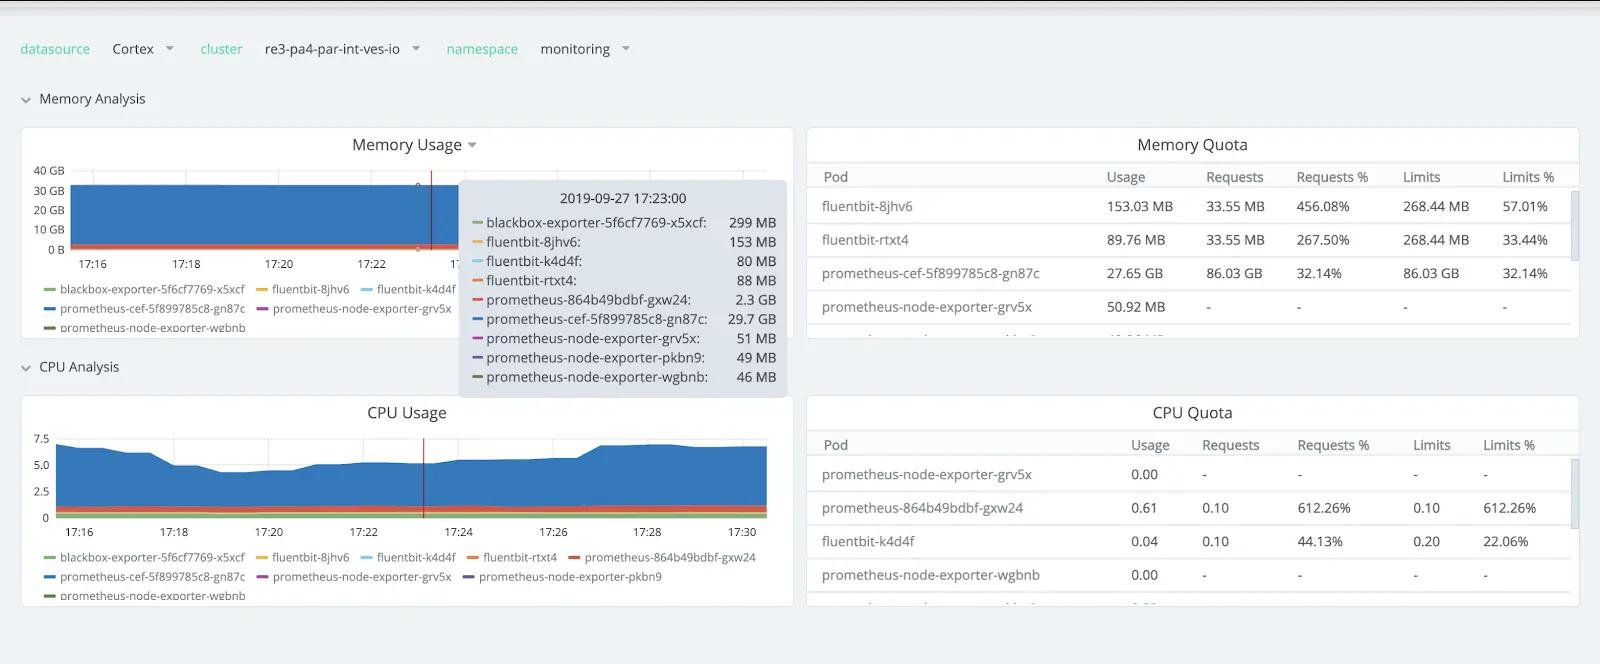
Der nächste Screenshot (Abbildung 8) zeigt, wie viel Arbeitsspeicher und CPU-Ressourcen wir bei dieser Größenordnung für Cortex-Ingestoren (max. 19 GB RAM) und -Distributoren benötigten. Der größte Vorteil von Cortex ist die horizontale Skalierung. Dadurch können wir weitere Replikate hinzufügen, während Prometheus vertikal skaliert werden muss.
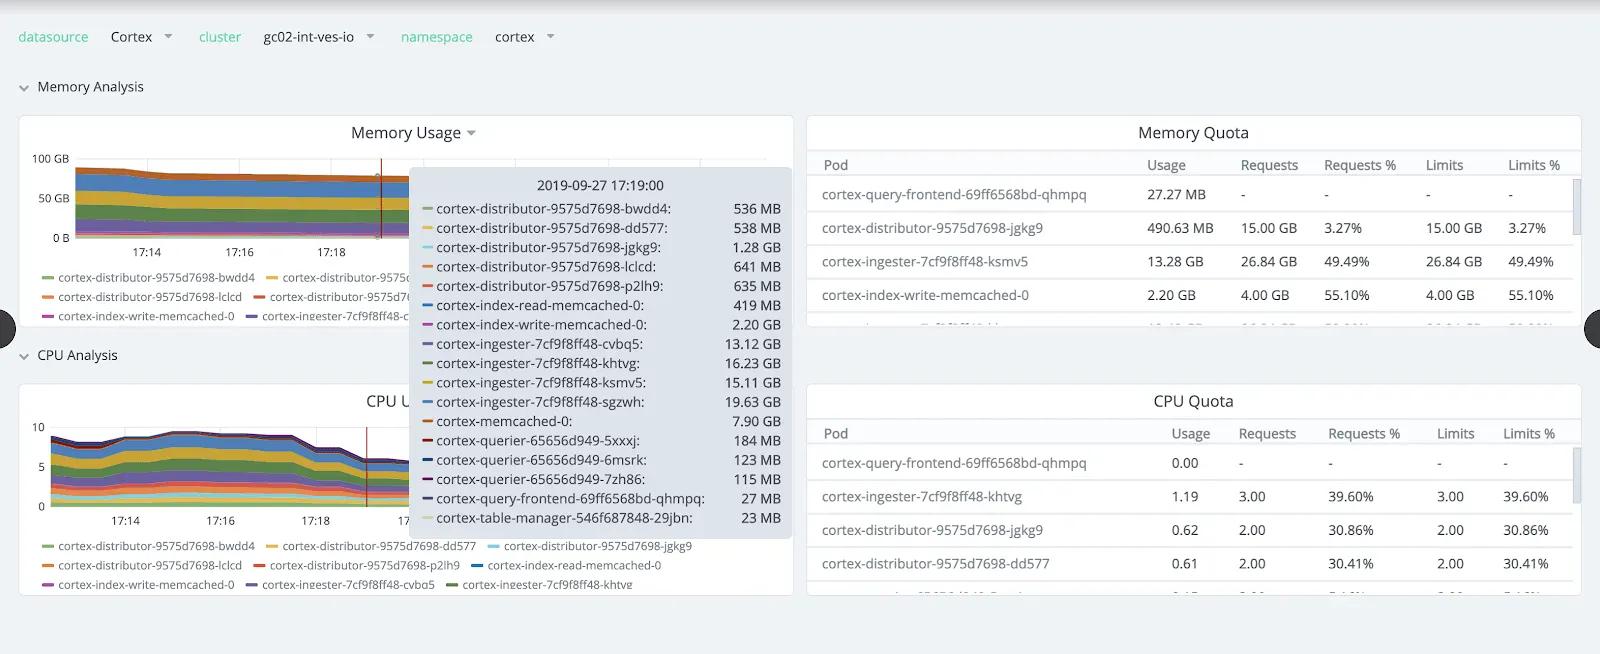
Für die Protokollierungsinfrastruktur in CEs und REs verwenden wir auf jedem Knoten Fluentbit-Dienste, die Dienst- und Systemprotokollereignisse erfassen und an Fluentd in der verbundenen RE weiterleiten. Fluentd leitet die Daten an die in der RE vorhandene ElasticSearch-Instanz weiter. Die Daten aus ElasticSearch werden von Elastalert ausgewertet, wobei Regeln zum Erstellen von Alertmanager-Warnmeldungen festgelegt sind. Wir verwenden unsere eigene Integration von Elastalert in Alertmananger, um Warnmeldungen mit denselben Labels zu erzeugen, die auch Prometheus verwendet.
Die wichtigsten Stationen auf unserem Weg im Monitoring:
- Verwendung neuer Prometheus-Föderationsfilter zum Verwerfen nicht verwendeter Metriken und Labels– Anfangs hatten wir pro CE etwa 50.000 Zeitreihen mit durchschnittlich 15 Labels. Wir haben dies auf durchschnittlich 2.000 pro CE optimiert – mithilfe einfacher Whitelists für Metriknamen und Blacklists für Labelnamen.
- Umstieg von der globalen Prometheus-Föderation auf einen Cortex-Cluster– Die zentrale Prometheus-Instanz erfasste die Daten der Prometheus-Instanzen aller REs und CEs. Bei 1.000 CEs war die Menge der Metriken nicht mehr zu bewältigen. Derzeit betreiben wir an jedem RE eine Prometheus-Instanz, die mit den Prometheus-Instanzen der verbundenen CEs föderiert ist und per RW Daten an Cortex überträgt.
- Elasticsearch-Cluster und -Protokolle- Dezentrale Protokollierungsarchitektur - Fluent Bit dient als Collector auf jedem Knoten und leitet Protokolle an Fluentd (Aggregator) in der RE weiter - Elasticsearch wird in jeder RE bereitgestellt und nutzt die clusterübergreifende Suche, um Protokolle über eine zentrale Kibana-Instanz abzufragen
Zusammenfassung
Ich hoffe, dieser Blogbeitrag vermittelt Ihnen einen Einblick darin, was alles berücksichtigt werden muss, um Tausende weltweit verteilter Edge-Standorte und Cluster zu verwalten. Obwohl wir die meisten unserer ursprünglichen Designanforderungen erfüllen und validieren konnten, liegen noch zahlreiche Verbesserungen vor uns …
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...