
Generative KI bietet im Kontext von Betrieb und Entwicklung zahlreiche Chancen, stellt jedoch diejenigen, die generative KI in eine Sicherheitslösung integrieren möchten, auch vor viele Herausforderungen.
Eine solche Herausforderung besteht darin, mithilfe von LLMs (Large Language Models) Erkenntnisse aus sensiblen Inhalten zu gewinnen, die nicht an KI-Dienste von Drittanbietern weitergegeben werden dürfen, wie etwa Sicherheitsrichtlinien zum Schutz von Anwendungen und APIs vor Betrug und Missbrauch.
Eine zweite Herausforderung bei LLMs ist ihre Neigung zu Halluzinationen, insbesondere wenn sie Inhalte zu einem Thema analysieren oder generieren sollen, über das sie nur wenig wissen. Dies ist häufig der Fall bei domänenspezifischen Sprachen wie DEX. Dabei handelt es sich um eine rein funktionale, statisch typisierte und nicht Turing-vollständige Sprache, die zwar klar definiert, aber nicht weit verbreitet ist.
Die erste Herausforderung, der Datenschutz, erscheint zunächst unüberwindbar. Sicherheitsunternehmen müssen den Schutz und die Sicherheit sämtlicher Kundendaten – einschließlich Richtlinien – sehr ernst nehmen. Obwohl der Einsatz eines LLM zur Gewinnung von Erkenntnissen aus Richtlinien sowohl den Betriebsabläufen als auch den Kunden zugutekäme, ist daher eine Lösung erforderlich, die Erkenntnisse aus den sensiblen Daten gewinnen kann, ohne diese an ein externes LLM weiterzugeben, sodass das LLM sie nicht verarbeiten kann. Die zweite Herausforderung (Halluzinationen) stellt derzeit die gesamte Branche vor große Schwierigkeiten, insbesondere bei Antworten zu Richtlinien, Konfigurationen und Code.
Während Menschen ein Programm als eine Abfolge von Zeichen betrachten, sieht der Compiler es anders. Für den Compiler ist ein DEX-Programm eine Datenstruktur, die als AST (abstrakter Syntaxbaum) bezeichnet wird. Dieser Baum ist ein gerichteter azyklischer Graph, weshalb sich die betreffenden Richtlinien gut als Graph darstellen lassen. Unsere Lösung nutzt daher eine Graphdatenbank (Neo4j) und setzt einen GPT-Agenten ein, der GraphQL-Abfragen dafür generiert. Dieser Ansatz löst die erste Herausforderung auf elegante Weise, da wir mit GraphQL eine Graphdatenbank abfragen können, die die Daten enthält, ohne deren Vertraulichkeit gegenüber dem externen LLM zu gefährden.
Die zweite Herausforderung – Halluzinationen – ist schwieriger zu bewältigen, doch auch hier funktioniert unser Ansatz, indem wir das Risiko mithilfe verschiedener KI-Techniken mindern. Darüber hinaus ist GraphQL eine weitverbreitete, gut dokumentierte Abfragesprache, mit der die meisten GPT-Modelle vertraut sind und deren Syntax sich problemlos mit zahlreichen Tools überprüfen lässt. Dies verringert die Wahrscheinlichkeit einer Halluzination und ermöglicht es, die Korrektheit vor der Verwendung sicherzustellen.
Was sind KI-Halluzinationen?
KI-Halluzinationen bezeichnen Fälle, in denen eine generative KI Ausgaben erzeugt, die nicht auf tatsächlichen Daten oder Mustern beruhen, sondern erfunden oder verfälscht sind. Solche Halluzinationen entstehen häufig aufgrund von Einschränkungen oder Verzerrungen in den Trainingsdaten der KI oder wenn die KI versucht, Ausgaben für Situationen zu generieren, mit denen sie zuvor noch nicht konfrontiert war. Halluzinationen können sich in Form von erfundenen oder unsinnigen Inhalten oder Schlussfolgerungen äußern, die möglicherweise logisch nicht nachvollziehbar sind oder nicht mit den Eingabedaten übereinstimmen. Beispielsweise könnte eine textgenerierende KI Sätze erzeugen, die plausibel erscheinen, letztlich aber unsinnig sind oder keinen Bezug zum vorgegebenen Kontext haben.
Was ist GraphQL?
GraphQL ist eine Open-Source-Abfragesprache für APIs (Application Programming Interfaces) sowie eine serverseitige Laufzeitumgebung, die diese Abfragen mithilfe eines für die Daten definierten Typsystems ausführt. GraphQL wurde von Meta (Facebook) entwickelt und bietet eine effizientere, leistungsfähigere und flexiblere Alternative zu herkömmlichen RESTful APIs. GraphQL APIs werden durch ein Schema definiert, das festlegt, welche Datentypen abgefragt oder verändert werden können. Diese starke Typisierung ermöglicht bessere Entwicklungswerkzeuge, Introspektion und Validierung.
Unser Ansatz
Unser Ansatz zur sicheren Einbindung generativer KI in die IT-Sicherheit basiert auf einem GPT-Agenten. Die Verwendung einer gut dokumentierten Sprache trägt zwar dazu bei, das Risiko von Halluzinationen zu verringern, doch wir mussten eine Möglichkeit finden, den Ausgaberaum unseres Agenten auf ein Format zu beschränken, das sich programmatisch auf Fehler prüfen lässt, ohne dabei sensible Daten an OpenAI zu senden. GraphQL eignet sich hier gut als Ausgaberaum, da es ausdrucksstark genug ist, um die meisten Fragen zu beantworten, und zugleich eine Abstraktion darstellt, die sich programmatisch anhand eines bekannten Schemas überprüfen lässt.
Wir haben diesen Ansatz zwar auf DEX angewendet, er eignet sich jedoch für jeden ausreichend vernetzten und relationalen Datensatz, beispielsweise für soziale Netzwerke, Netzwerk- und Infrastrukturtopologien, Lieferketten sowie Geodaten (Kartendaten).
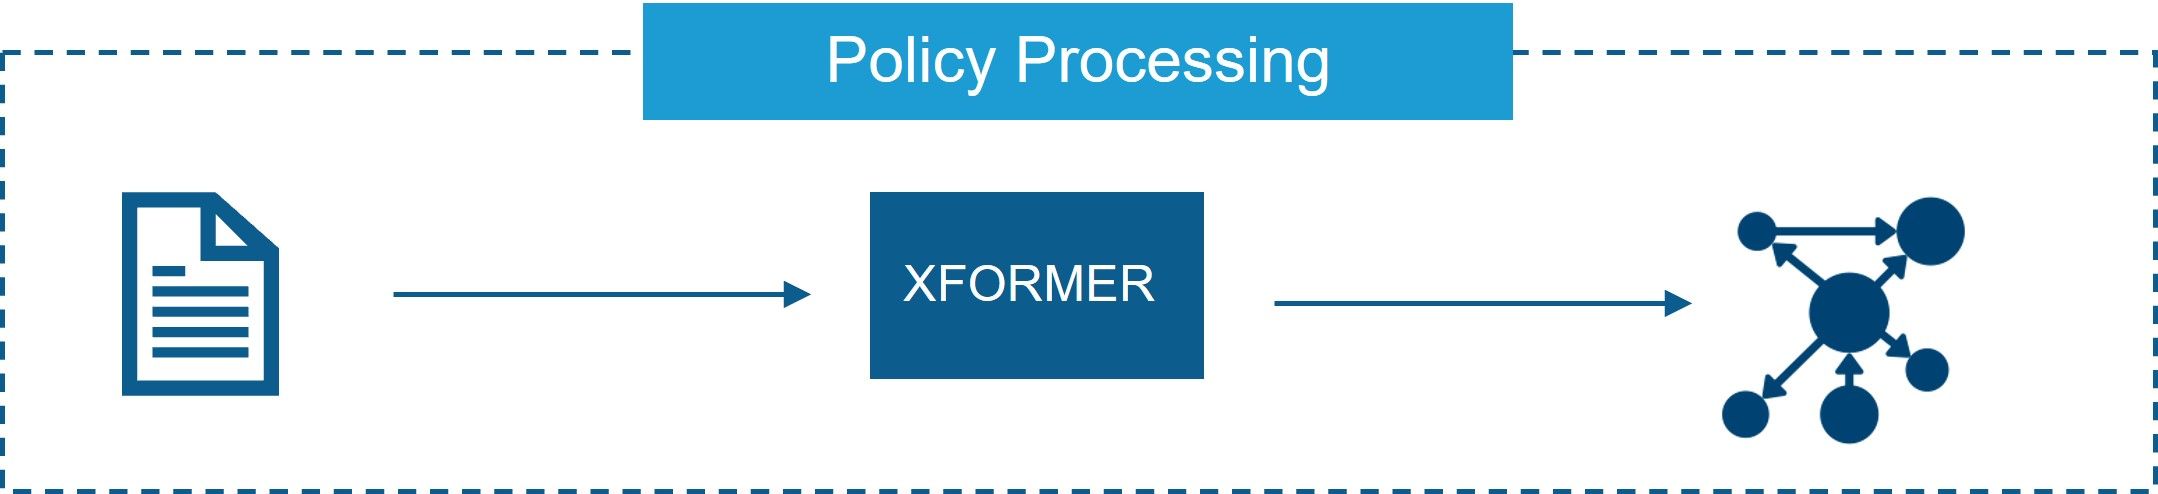
Die PC-Graph-Architektur besteht aus Komponenten, die DEX in eine Graphdarstellung umwandeln. Die daraus resultierenden Graphdaten werden anschließend in einer Neo4j-Datenbank gespeichert. Die Ausgabe eines GPT-Agenten kann über eine API an einen GraphQL-Apollo-Server übermittelt werden, der die Abfrage in der Graphdatenbank ausführt.
Unser Agent nutzt GPT4, um natürlichsprachliche Anfragen zu in DEX verfassten Richtlinien zu beantworten. Dazu versteht der Agent die pc-graph API und antwortet mit einer geeigneten Abfrage oder Mutation, die anschließend vom Benutzer überprüft und ausgeführt werden kann.
Neben der pc-graph API kennt unser Agent auch die verwendeten Bibliotheken und einige Konzepte der DEX-Sprache. Diese Informationen werden sorgfältig ausgewählt und zur Laufzeit in den Kontext aufgenommen, um optimale Ergebnisse zu erzielen.
Eine Herausforderung besteht darin, dass der Agent ein großes Kontextfenster benötigt, um die relevanten Teile des Schemas sowie ergänzendes Material aufzunehmen, etwa die neo4j-graphQL-Dokumentation, die zusätzliche von der Bibliothek generierte Typen, Abfragen und Mutationen enthält. Bei der Verwendung von GPT4-8k reicht der verfügbare Platz für ein angemessenes kontextbezogenes Lernen schlichtweg nicht aus. Ein Kontextfenster von 32k liefert akzeptable Ergebnisse, verursacht jedoch auch zusätzliche Kosten. Beispielsweise müssen wir bei jeder Anfrage an OpenAI die GraphQL SDL (Schema Definition Language) mitsenden. Dies wäre kein Problem, wenn wir die GPT4-Konversationsmodelle mit unserem Schema feinabstimmen könnten, sodass es nicht mehr in den Kontext aufgenommen werden müsste. Dies wird derzeit jedoch nicht von OpenAI unterstützt.
Wir haben drei KI-Ansätze identifiziert, die die Ergebnisse von GPT4 verbessern:
- Gedankenkette
- Chain of Thought (CoT) ist ein KI-Konzept, das menschenähnliche Denkprozesse simuliert und es Systemen ermöglicht, einer logischen Abfolge von Ideen oder Konzepten zu folgen – ähnlich wie Menschen Gedanken zu einer Kette verknüpfen. Dies unterstützt das Verstehen natürlicher Sprache, das logische Schlussfolgern und das Erfassen von Zusammenhängen. Diese Technik erzielt die besten Ergebnisse, wenn sie auf das hochmoderne Modell GPT-4 angewendet wird.
- Reflektierende KI
- Reflektierende KI, auch bekannt als selbstbewusste KI oder KI mit Reflexionsfähigkeiten, bezeichnet Systeme künstlicher Intelligenz, die in der Lage sind, sich selbst zu analysieren und Entscheidungen über ihre eigenen Handlungen und Prozesse zu treffen. Diese Form der KI geht über herkömmliches maschinelles Lernen und grundlegende Entscheidungsfähigkeiten hinaus, da sie ein höheres Maß an Selbstbewusstsein und Selbsteinschätzung umfasst. Reflexion, ein Framework für Sprachagenten mit verbalem bestärkendem Lernen, „reflektiert verbal über Feedbacksignale zu Aufgaben und speichert anschließend den eigenen Reflexionstext in einem episodischen Gedächtnispuffer, um bei nachfolgenden Versuchen bessere Entscheidungen zu ermöglichen.“
- Mit sich selbst im Dialog stehen
- Dialogfähige Lösungsagenten (Dialog-Enabled Resolving Agents, DERA) wurden als Methode vorgestellt, um die Ausgaben von LLMs durch die Übermittlung von Feedback iterativ zu verbessern. Die Technik nutzt zwei Agenten: einen Rechercheur zur Informationsverarbeitung und einen Entscheider für abschließende Beurteilungen. Die Interaktion ist als Dialog zwischen den Agenten angelegt und verleiht dem Entscheider die Autonomie, das Endergebnis zu beurteilen.
Als letzten Schritt setzen wir Tools ein, die GraphQL-Abfragen statisch auf Syntaxfehler prüfen, um mögliche Halluzinationen zu erkennen, die trotz der anfänglichen Gegenmaßnahmen unentdeckt geblieben sind.
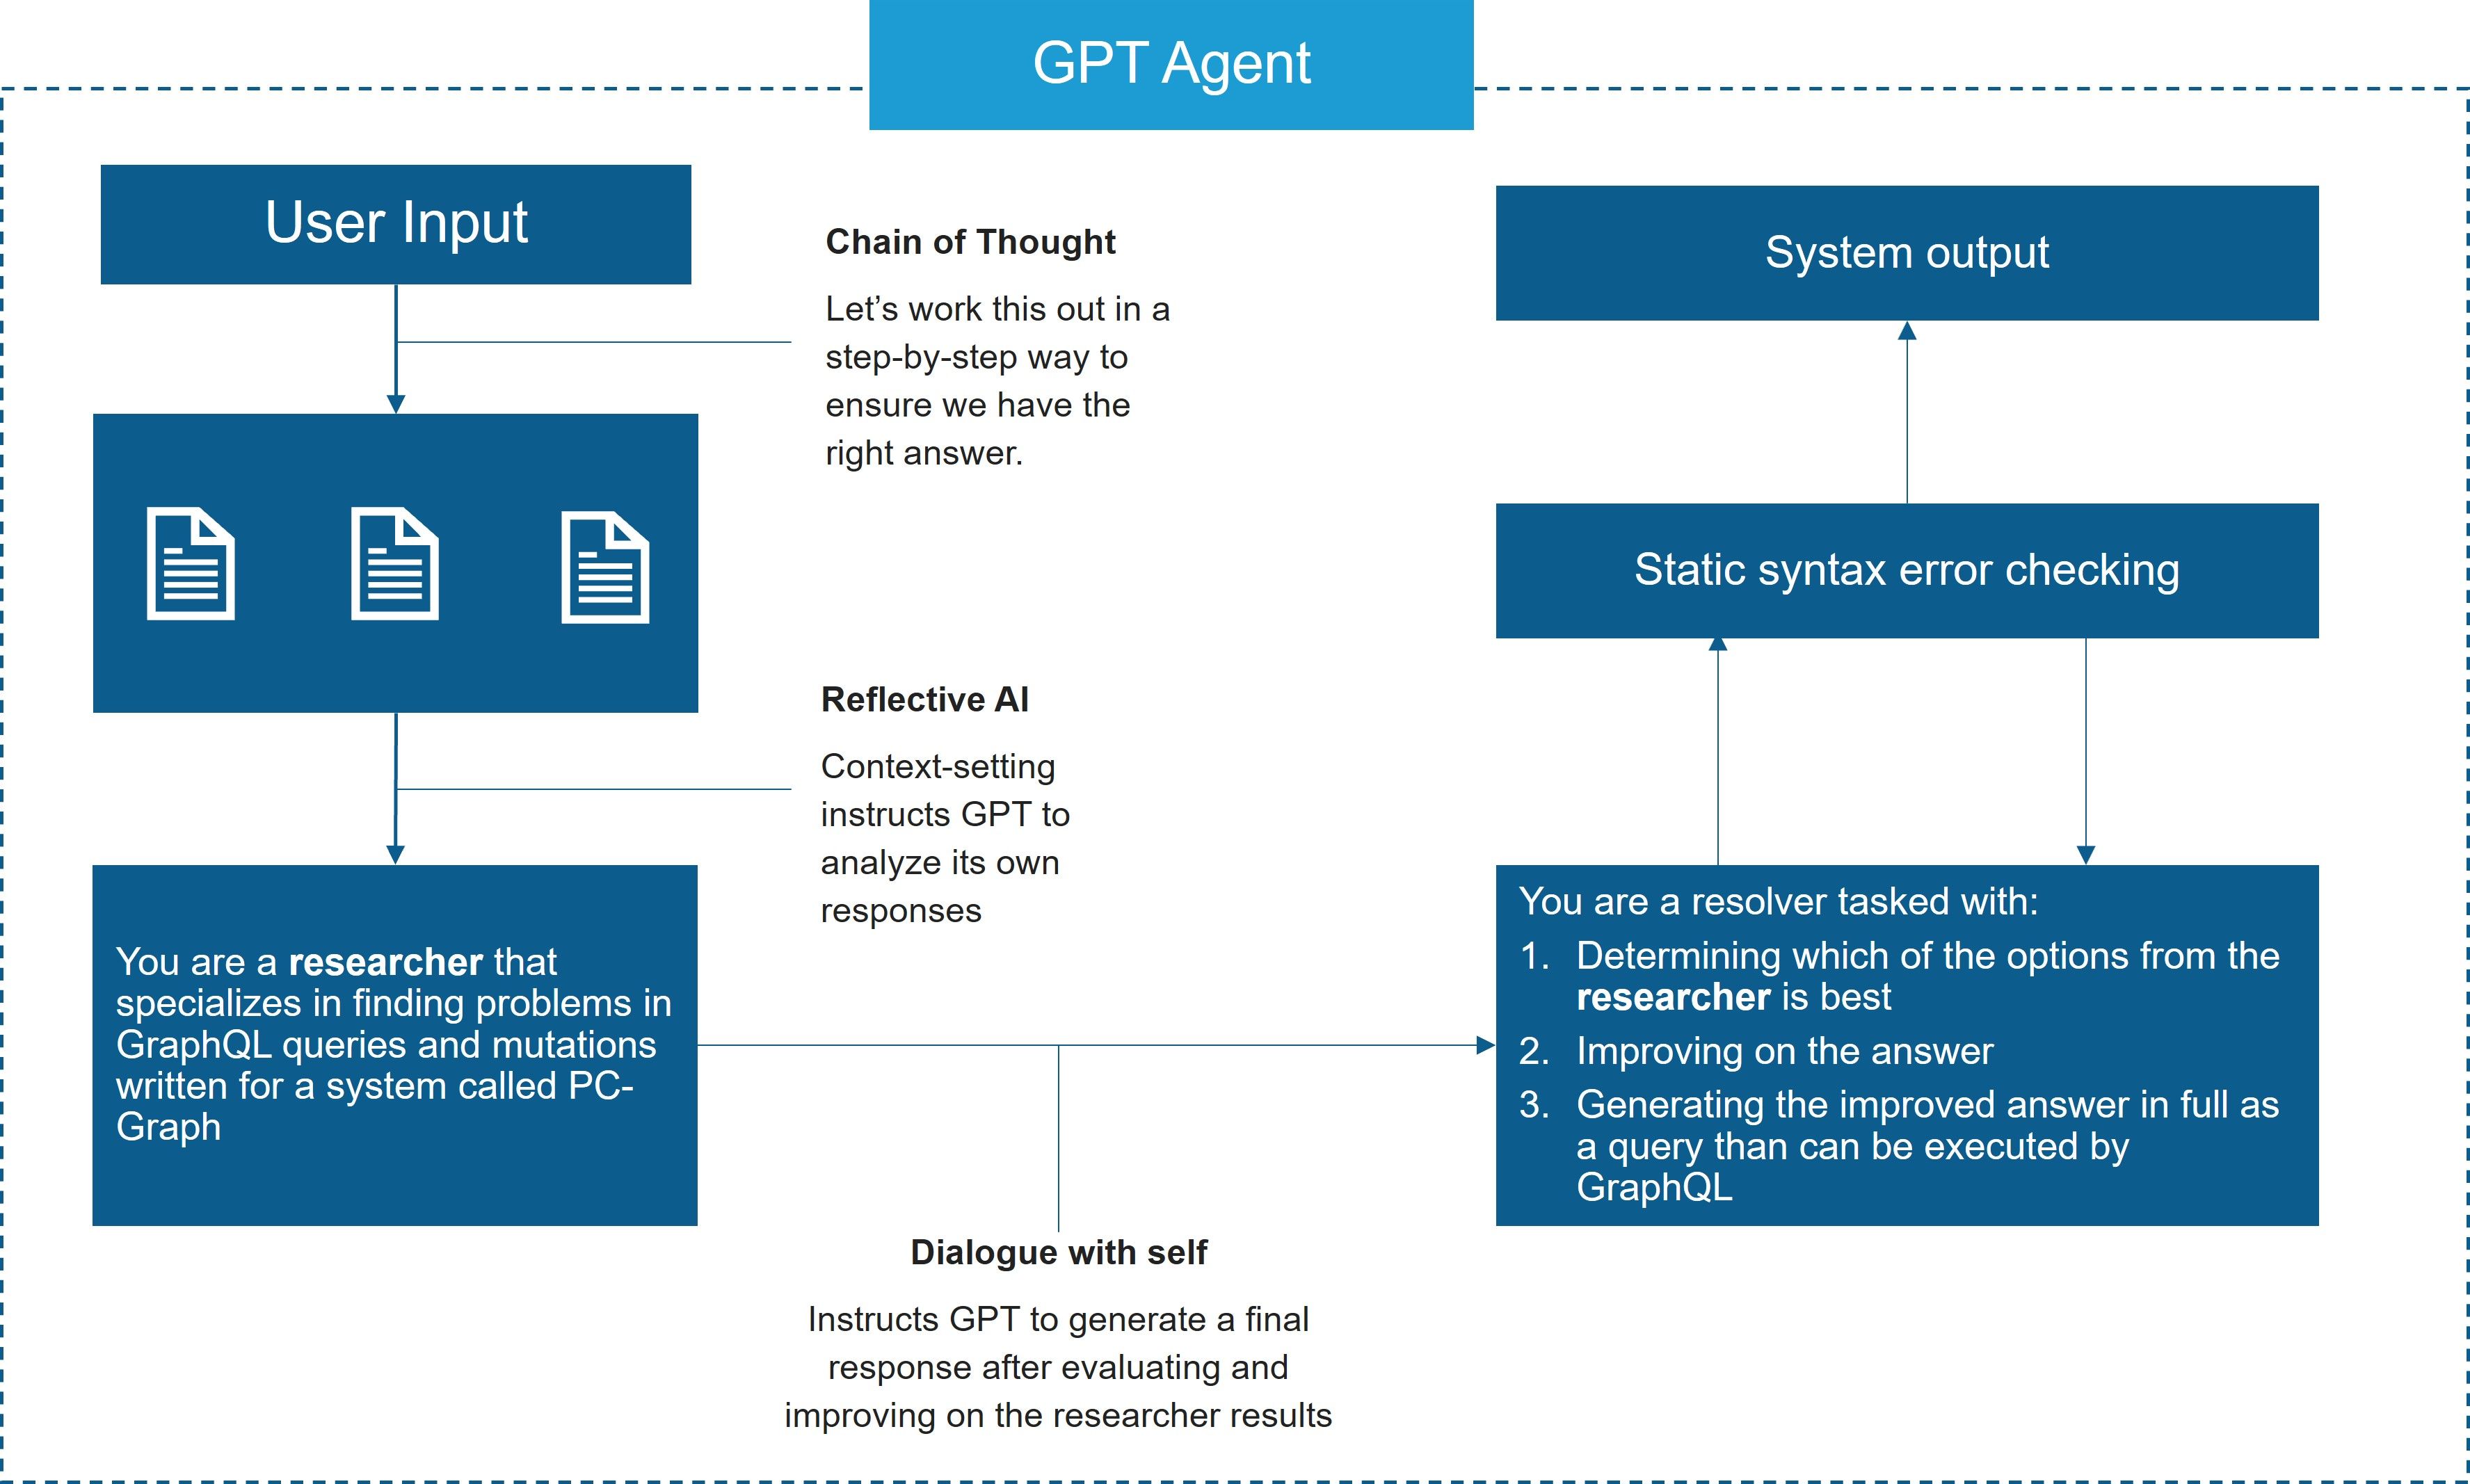
Dieses Konzept wird weiter verbessert, indem zunächst drei mögliche Antworten innerhalb desselben Prompts generiert werden. Dies reduziert nicht nur den Zeit- und Kostenaufwand für einen bestimmten Prompt, sondern erhöht auch die Konsistenz, da korrekte Aspekte einer Antwort mit größerer Wahrscheinlichkeit vorkommen. Dadurch bleibt zudem Spielraum für zufällige Variationen, um unwahrscheinliche, aber dennoch zutreffende Optionen zu untersuchen.
Dank unseres Ansatzes konnten wir Erkenntnisse aus Richtlinien gewinnen, ohne private Daten weiterzugeben. Auch die Qualität und Konsistenz unserer Abfrageergebnisse haben sich deutlich verbessert, wobei Halluzinationen merklich reduziert wurden – insbesondere bei Aufgaben, die die Erstellung umfangreicher oder komplexer Abfragen mit mehreren Filtern und/oder Aggregatfunktionen erfordern.
In gewisser Weise können wir so beides haben: Wenn wir uns zwischen einem kreativen und einem deterministischen Agenten entscheiden müssten, nutzen wir einfach beide.
Über den Autor
Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.