
Beim Militär gibt es ein Sprichwort: „Amateure diskutieren über Taktik, Profis befassen sich mit Logistik.“ Dieser Gedanke mag auf den ersten Blick überraschen, wenn man an Lees brillante Strategie bei Chancellorsville oder Hannibals Genialität während der Punischen Kriege denkt. Doch die Geschichte zeigt, dass weder Lee noch Hannibal ihren jeweiligen Krieg gewannen. Der Hauptgrund dafür war die Logistik: die Fähigkeit, eine Armee zur richtigen Zeit und am richtigen Ort mit Nahrung, Kleidung und Waffen zu versorgen. Trotz brillanter Taktiken war es letztlich die Logistik, die über den Sieg entschied. Mit anderen Worten: Taktik ermöglicht es, die auf dem Schlachtfeld verfügbaren Mittel bestmöglich einzusetzen, doch erst die Logistik sorgt dafür, dass man überhaupt dort sein und bleiben kann.
Mir gefällt die militärische Analogie, weil sie meiner Ansicht nach Parallelen dazu aufweist, wie datengetriebene Lösungen heute häufig dargestellt werden. Der Glanz der „Taktik“ – fortschrittlicher KI-Verfahren wie Deep Learning, Random-Forest-Klassifikation, Gradient Boosting und so weiter – stellt die weniger attraktive „Logistik“ der datenarchitektonischen Grundlagen, die diese fortschrittlichen Verfahren erst ermöglichen, regelmäßig in den Schatten.
Der erste Schritt bei einer Diskussion über Datenarchitektur besteht darin, zu definieren, was der Begriff „Datenarchitektur“ umfasst. Wenig überraschend fällt die Antwort differenziert aus – Datenarchitektur besteht aus mehreren Ebenen und hat viele Facetten. Um der Diskussion eine konkrete Grundlage zu geben, ist es hilfreich, zunächst den Weg der erfassten Telemetriedaten zu betrachten. Das folgende Diagramm zeigt eine übergeordnete Datenpipeline und hebt die Berührungspunkte zwischen der Pipeline und dem Fundament der Datenarchitektur hervor.
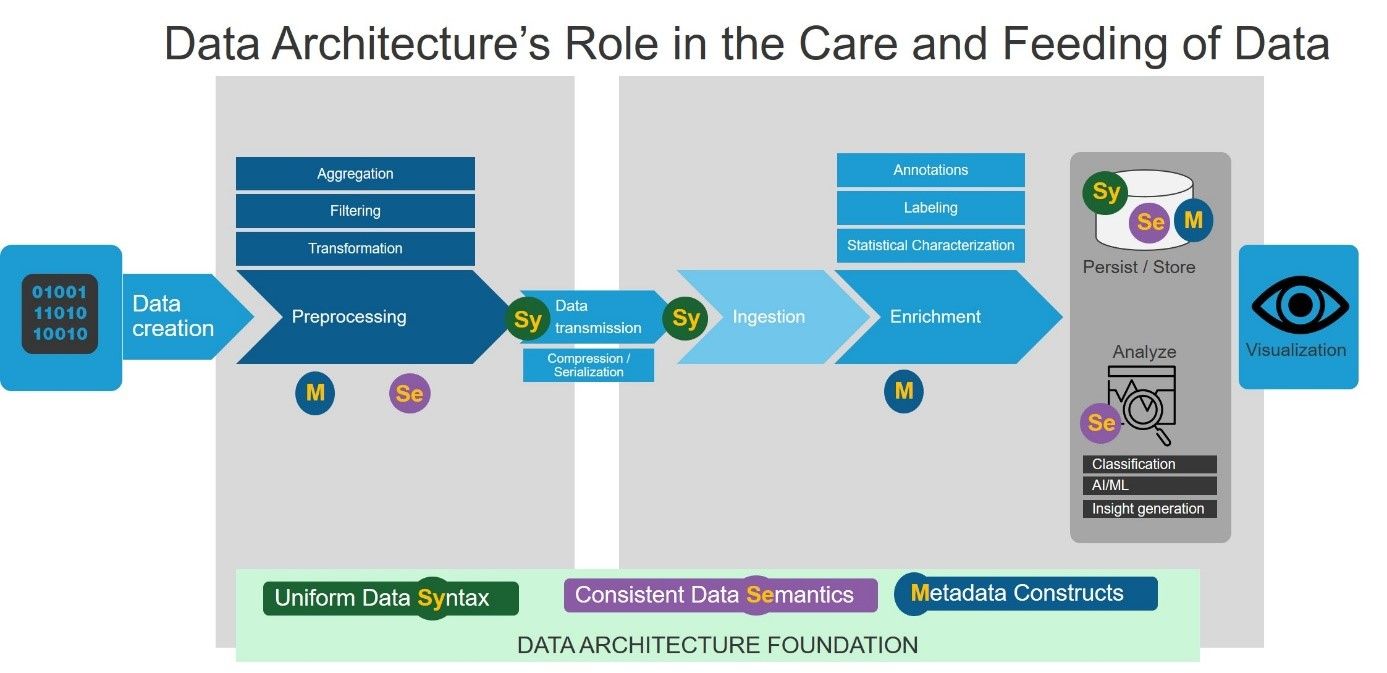
Der Weg jedes Datenelements beginnt mit seiner Erstellung. Häufig folgt eine gewisse Vorverarbeitung, bevor es serialisiert und an einen Datensammler/-aggregator übertragen wird, der sich in der Regel in der Cloud befindet. Anschließend kann der Datensammler selbst – nach der Deserialisierung und Aufnahme – weitere Verarbeitungs- und Anreicherungsschritte durchführen, bevor er die Daten in einem persistenten Datenspeicher ablegt und/oder einer Datenanalyse-Pipeline zuführt. Abschließend werden die angereicherten bzw. analysierten Ergebnisse über eine Visualisierungsplattform für Menschen zugänglich gemacht. Sie können sogar von automatisierten Systemen als Rückmeldungen für selbstoptimierende oder selbstheilende geschlossene Regelkreise genutzt werden.
Nachdem der Kontext der Datenpipeline geklärt ist, können wir uns nun wieder der Frage zuwenden, was unter „Datenarchitektur“ zu verstehen ist. Die erste Antwort konzentriert sich auf der oberflächlichsten Ebene auf die Datendarstellung und die Syntax der Serialisierung. Wenn beispielsweise ein Datenereignis ein Objektfeld mit der Bezeichnung „customer“ enthält, bestimmt die syntaktische Sichtweise, ob diese Daten als Zeichenfolge, als ganzzahlige UUID oder in einer anderen Form dargestellt werden.
Wenn wir jedoch etwas tiefer gehen, umfasst eine zweite Antwort mehr als nur die Syntax; hier geht es um die Semantik der Daten – also um eine klar definierte und konsistente Interpretation der Dateninhalte. Nehmen wir erneut das Feld „customer“ als Beispiel und gehen wir davon aus, dass die syntaktische Frage beantwortet wurde – das Datenelement also tatsächlich als Zeichenfolgenfeld definiert ist. Als Nächstes muss die Datenarchitektur die Frage nach der Bedeutung beziehungsweise Interpretation beantworten können: Bezeichnet das Feld den Namen einer Person oder einen Unternehmensnamen? Wenn es sich um den Namen einer Person handelt, ist damit <last-name>, <first-name> oder beides gemeint? In Verbindung mit einer einheitlichen Syntax ermöglicht eine konsistente Semantik der Datenpipeline, Funktionen wie Datenfilterung und -aggregation auf allgemeine und robuste Weise auszuführen, basierend auf einer kohärenten logischen Interpretation der Dateninhalte. Darüber hinaus kann der Datenspeicher problemlos föderierte Datenabfragen über verschiedene Instanzen der Datenerstellungspipeline hinweg durchführen, sofern die erzeugten Daten einer konsistenten Syntax und Semantik folgen.
Wenn wir schließlich noch tiefer gehen, ist es in vielen Fällen wichtig, dass die Datenarchitektur über eine dritte Fähigkeit verfügt: ein Vokabular, mit dem sich die Telemetriedaten in einen Kontext einordnen und die Daten selbst interpretieren lassen – das Metadatenvokabular. Dies ist insbesondere im Zusammenhang mit den Anforderungen an die Data Governance in Unternehmen von Bedeutung, sei es für Compliance, Audits oder auch für interne Arbeitsabläufe, die ein ganzheitliches Verständnis der in einem Data Warehouse verwalteten Daten erfordern. Metadaten liegen häufig in Form von Annotationen zu den Daten vor, wobei diese Annotationen dieselbe syntaktische und semantische Konsistenz aufweisen wie die Daten selbst. Beispielsweise würden Metadatenfelder wahrscheinlich dazu verwendet, die Identität der Datenquelle und den zeitlichen Ablauf der Datenverarbeitung für alle erfassten Daten festzuhalten, um die gesetzlichen Anforderungen an die Datenaufbewahrung zu erfüllen.
Eine weitere Möglichkeit, Metadatenfelder im Vokabular eines Datenbeschreibungsschemas zu verwenden, besteht darin, Eigenschaften der Datenfelder selbst zu beschreiben, etwa die Kardinalität eines Datenelements oder dessen Datenschutzrelevanz. Kehren wir noch einmal zu unserem Beispiel des Datenfelds „customer“ zurück: Metadatenannotationen im Datenschema könnten das Datenelement als eindeutig kennzeichnen, während zusätzliche Annotationen im Kontext eines Datenstroms (etwa für Transaktionen im Einzelhandel) Datenelemente als erforderlich und als Einzelwert kennzeichnen könnten. Mit anderen Worten: Mithilfe von Metadaten ließe sich festlegen, dass das Feld customerID eindeutig sein muss (und somit als Primärschlüssel einer Datenbank verwendet werden kann) und dass jedem Kaufereignis genau eine customerID zugeordnet sein muss. Der Nutzen der gesamten Metadatenfunktionen im Kontext der Datenpipeline besteht darin, dass sie eingesetzt werden können, um Annotationen zur Einhaltung von Datenvorschriften hinzuzufügen, ein Vokabular zur Datenanreicherung bereitzustellen und flexible Governance-Workflows für das Data Warehouse zu ermöglichen.
Zusammenfassend lautet die Antwort auf die Frage „Was ist Datenarchitektur?“ also, dass es dabei zumindest darum geht, einen Rahmen bereitzustellen, der die syntaktische und semantische Konsistenz der erfassten Daten gewährleistet. Darüber hinaus sollte eine robuste Datenarchitektur auch eine Metadatenstrategie umfassen, die leistungsfähig genug ist, um nicht nur Einschränkungen für die Daten festzulegen, sondern auch Schlussfolgerungen über die Daten selbst zu ermöglichen.
Wird eine Datenarchitektur als eigenständiger Schwerpunkt betrachtet und gut umgesetzt, ähnelt sie daher in vielerlei Hinsicht einer leistungsfähigen militärischen Logistikinfrastruktur. Wie im militärischen Kontext schafft sie eine Grundlage, die die Effizienz und Robustheit aller darauf aufbauenden Systemkomponenten vervielfacht und es ermöglicht, diese sichtbareren Systeme mit maximaler Wirkung einzusetzen. Im Kontext eines Datenverarbeitungssystems bildet die Datenarchitektur die Grundlage für flexiblere und leistungsfähigere Modelle der Data Governance, einen einfacheren Datenaustausch zwischen verschiedenen Datenquellen mithilfe eines robusten Data Warehouse sowie eine reaktionsschnellere Einbindung neuer Datenfeeds, die die geschäftliche Agilität erhöht.
Über den Autor
Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.