Dieser Blogbeitrag knüpft an „Was zeichnet eine gute Steuerungsebene für den Betrieb einer großen Anzahl von Kubernetes-Clustern aus?“ an. Im vorherigen Blogbeitrag wurde Volterras einzigartiger Fleet-Operations-Ansatz zur Verwaltung einer Flotte von Infrastrukturstandorten und Anwendungen beschrieben. Dieser Blogbeitrag befasst sich mit einer zentralen Herausforderung für Betriebsteams: der Konfigurationsabweichung bei Änderungen an der Konfiguration einer großen Anzahl von Clustern oder Standorten. Ich bezeichne diese Herausforderung als „Time to Effect“ – die Zeit bis zum Wirksamwerden.
Was ist die Time-to-Effect?
Vereinfacht ausgedrückt beschreibt dies, wie lange es dauert, bis die beabsichtigte Wirkung eines Vorgangs eintritt. Beispiele hierfür sind:
- Wie lange dauert es, bis die Konfiguration meiner Sicherheitsrichtlinie auf allen meinen Websites wirksam wird?
- Wie lange dauert es, bis die neueste Version meiner Anwendung auf allen Sites bereitgestellt ist?
- Wie lange dauert es, das Betriebssystem oder die Infrastruktursoftware an allen meinen weltweit verteilten Standorten zu aktualisieren?
Warum ist das wichtig?
Diese Frage lässt sich anhand einiger Beispiele aus der Praxis unserer Kunden beantworten:
- Meltdown und Spectre — Nachdem die Nachricht über Meltdown/Spectre bekannt geworden war, beschäftigte jeden CISO vor allem die Frage, wie sich das Betriebssystem in der gesamten Infrastruktur schnell patchen lässt. Das Betriebsteam wurde stündlich daran gemessen, wie lange es dauerte, bis die beabsichtigte Änderung (d. h. das Upgrade der Betriebssystemversion) wirksam wurde.
- Sie haben sicher von der Flotte aus Verkaufsautomaten gehört, die einen Denial-of-Service-Angriff auf eine Universität verursacht hat. Hier die Kurzfassung, falls Sie den Angriff nicht verfolgt haben: Hacker nutzten eine Zero-Day-Sicherheitslücke aus und installierten Schadsoftware, die sich mit anderen Verkaufsautomaten verband und so eine Flotte aus Verkaufsautomaten-Bots bildete. Diese erzeugte anschließend enorme Datenverkehrsmengen und löste damit einen Denial-of-Service-Angriff auf die Universität aus. Nachdem die Universität den Angriff erkannt hatte, musste sie auf jedem Verkaufsautomaten einzeln Netzwerkrichtlinien konfigurieren, um den Zugriff auf den Command-and-Control-Server zu unterbinden. Für sie war es äußerst wichtig, dass ihre Vorgabe (d. h. den Zugriff auf eine bestimmte Website zu sperren) sofort auf allen Verkaufsautomaten wirksam wurde, um den Angriff einzudämmen.
Die Wirksamkeitszeit ist für verschiedene Kategorien wie Infrastruktursoftware, Anwendungssoftware, Netzwerkrichtlinien und Sicherheitsrichtlinien von Bedeutung.
Worin besteht die Herausforderung?
Das Ausmaß der Herausforderung wird besonders deutlich, wenn das Betriebsteam Folgendes verwalten muss:
- Eine große Anzahl von Standorten
- Weltweit verteilte Standorte
- Heterogene Umgebungen, d. h. Standorte in privaten, öffentlichen und Telekommunikations-Clouds sowie Edge-Geräte
- Uneinheitliche Konnektivität der Standorte
Ein gutes Beispiel hierfür ist das Betriebsteam eines Automobilherstellers, das für die Aktualisierung der Software und die Verwaltung der Konnektivität seiner Fahrzeuge (im Folgenden als Kundenstandorte bezeichnet) verantwortlich ist. Eine typische Bereitstellung umfasst ein privates Rechenzentrum, von dem aus das Betriebsteam die Fahrzeuge weltweit (oder je nach Organisationsstruktur regional) steuert.
Um die Herausforderung zu verstehen, betrachten wir die Lösungen, die dem Betriebsteam zur Verfügung stehen. Die meisten Lösungen bieten eine im privaten Rechenzentrum des Kunden gehostete Verwaltungssoftware, mit der sich die große Zahl verteilter Standorte zentral verwalten lässt. Wenn der Automobilhersteller eine Richtlinie konfiguriert, die auf alle Fahrzeuge angewendet werden soll, lädt die zentrale Verwaltungssoftware im Wesentlichen nacheinander ein Konfigurationsskript auf jedes einzelne Fahrzeug herunter. Bei diesem Konfigurationsskript kann es sich um ein Ansible-Playbook oder ein Helm-Chart handeln, das an jedem Standort eine Reihe von Konfigurationsbefehlen ausführt. Dies lässt sich wie im folgenden Diagramm dargestellt veranschaulichen.
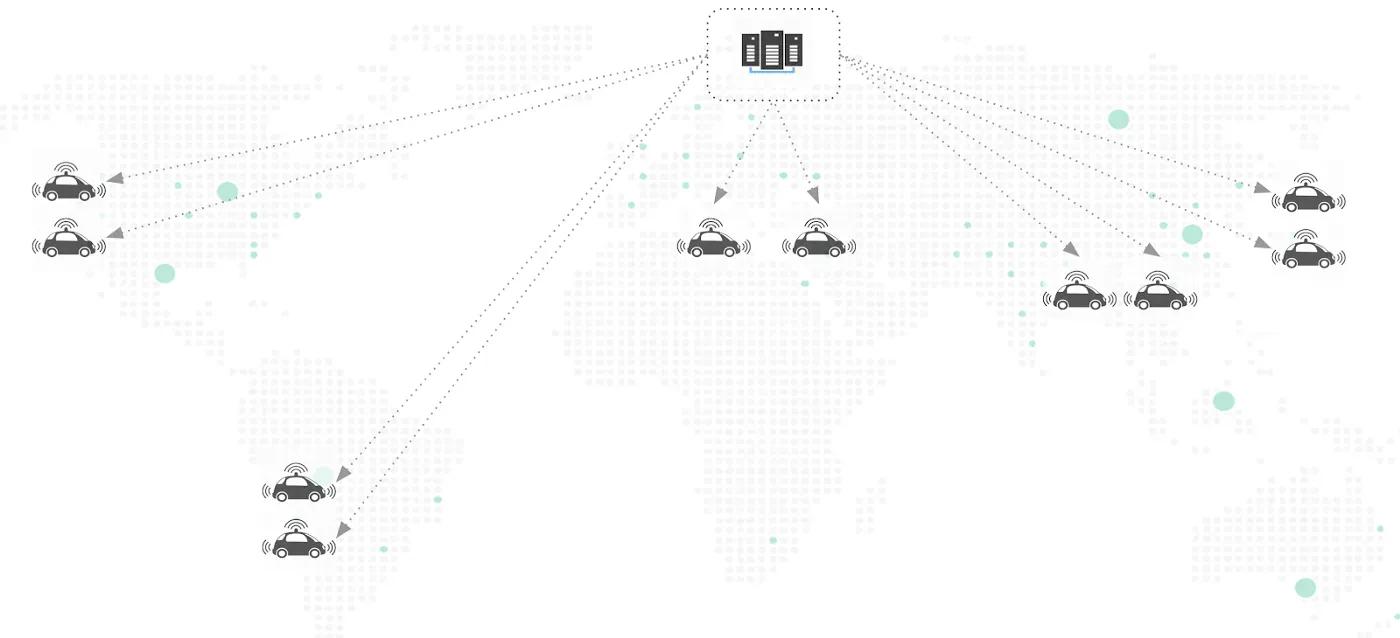
Das Problem besteht darin, dass die Zeit bis zum Wirksamwerden direkt proportional zur Anzahl der Standorte ist. Anbieter zentralisierter Verwaltungssoftware werden argumentieren, dass dies das bestmögliche Ergebnis ist, solange alle Vorgänge aus der Ferne und automatisiert durchgeführt werden können.
Volterra ist anderer Meinung, und wir können dies in diesem Blogbeitrag belegen. Wir haben eine verteilte Steuerungsebene mit einem hierarchischen, horizontal skalierbaren Architekturansatz entwickelt, der eine minimale Wirksamkeitsdauer gewährleistet.
Volterra-Architektur für eine minimale Time to Effect
Die grundlegenden Bausteine zur Minimierung der Time to Effect sind:
- Hierarchische baumbasierte Architektur
- Speziell entwickelter verteilter Kontrollplan
Im Folgenden ist ein allgemeiner Überblick über die Architektur dargestellt.
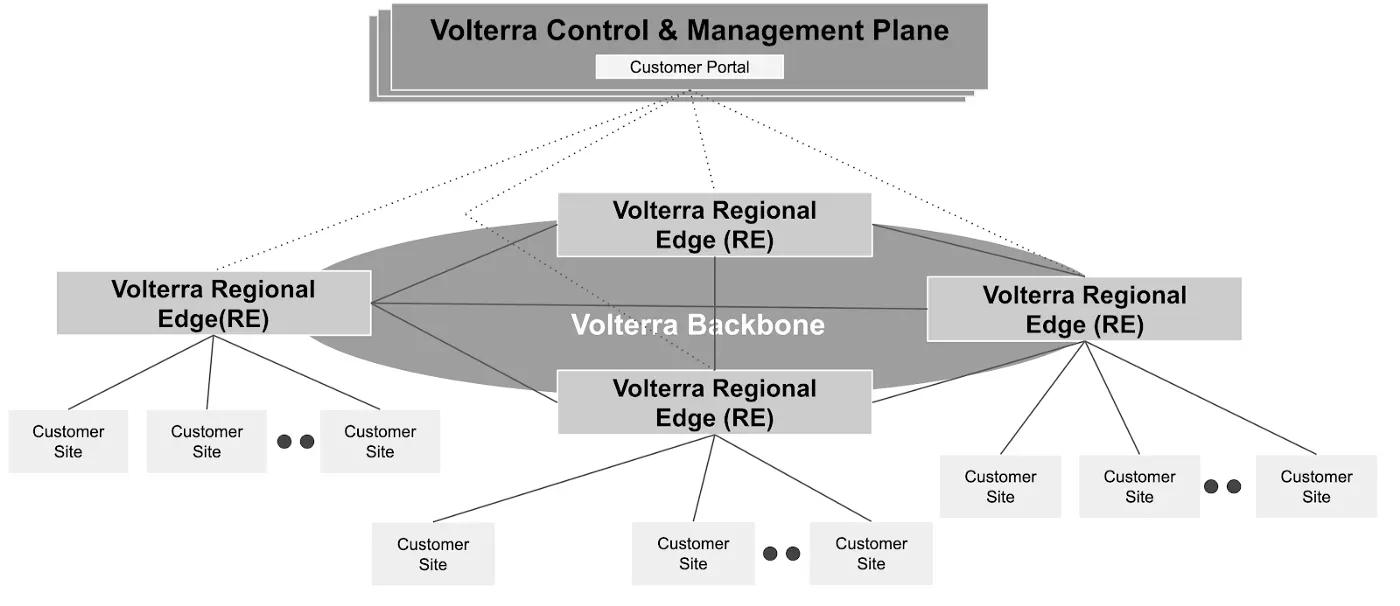
Der hierarchische Architekturansatz von Volterra besteht darin, für die Verteilung von Konfigurationen eine Baumstruktur aus Knoten zu erstellen. Jeder Knoten arbeitet nach dem Store-and-Forward-Prinzip, d. h., er speichert die Konfiguration lokal und leitet sie anschließend an seine untergeordneten Knoten weiter. Dies lässt sich am besten anhand eines Beispiels veranschaulichen. Wenn ein Benutzer in der Volterra Console ein Objekt wie etwa eine Netzwerkrichtlinie konfiguriert, verteilt die Steuerungs- und Verwaltungsebene die Konfiguration an die unmittelbar untergeordneten Knoten, die Regional Edges (RE). Jeder RE speichert die Konfiguration lokal und leitet sie an seine untergeordneten Knoten weiter. Bei den untergeordneten Knoten eines RE handelt es sich um Kundenstandorte, die mit diesem RE verbunden sind.
Eine hierarchische, baumbasierte Architektur gewährleistet eine minimale Wirksamkeitszeit. Die Wirksamkeitszeit wird durch die Anzahl der Ebenen im Baum und die Anzahl der untergeordneten Knoten pro Knoten begrenzt. Der Baum umfasst maximal drei Ebenen (Controller → RE → Kundenstandort). Die Anzahl der untergeordneten Knoten pro Knoten ist direkt proportional zur Anzahl der mit der RE verbundenen Standorte. Auf der RE wird eine Dienstinstanz gestartet, die die Konfiguration für eine Gruppe von Standorten verarbeitet. Die horizontal skalierbare Steuerungsebene von Volterra startet bei Bedarf neue Dienstinstanzen, wenn die Anzahl der mit der RE verbundenen Standorte steigt.
Testaufbau
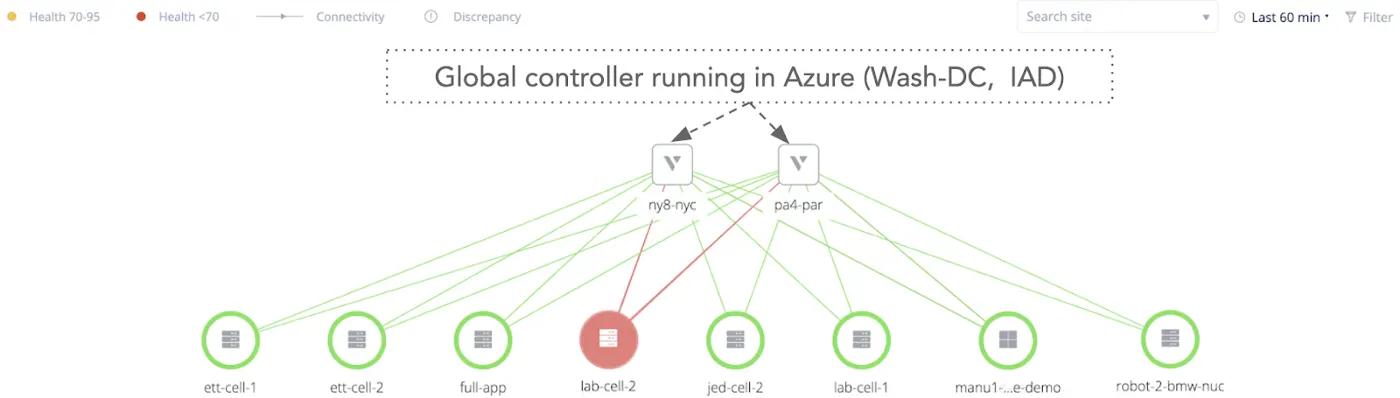
Die Messung der Wirksamkeitsdauer wurde in großem Umfang an Kundenstandorten durchgeführt, die mit zwei regionalen Edges in New York (NY8-NYC) und Paris (PA4-PAR) verbunden waren. Die Kundenstandorte waren weltweit verteilt, unter anderem auf Santa Clara (Kalifornien), Houston (Texas), Madrid (Spanien), Prag (Tschechische Republik) und London (Vereinigtes Königreich). Zudem umfassten die Kundenstandorte heterogene Umgebungen wie AWS, virtuelle Maschinen (ESXi) und Edge-Gateways, darunter Intel NUCs und Fitlet2.
Das Kundenportal und die globale Steuerungsebene von Volterra wurden in Azure (Washington-IAD) betrieben. Die Kundenstandorte waren auf mehrere Namespaces und Mandanten verteilt, um eine realistische Betriebsumgebung abzubilden.
Ausfallbedingungen wurden simuliert, indem Dienstinstanzen auf der RE beendet und Verbindungen mit schlechter Qualität zwischen der RE und den Kundenstandorten verwendet wurden. Abbildung 3 zeigt eine Momentaufnahme eines Segments der gesamten Flotte in einem einzelnen Namespace.
Testmethodik
Im Volterra-System werden mit Zeitstempeln versehene Audit-Protokolle erfasst, sobald Objekte in der Volterra-Konsole konfiguriert werden und die Konfiguration auf den einzelnen Kundenstandorten angewendet wird. Die Übertragungszeit wurde als Zeitdifferenz zwischen der Konfiguration im Portal und der Anwendung der Konfiguration am Kundenstandort gemessen. Im Folgenden wird der Prozess Schritt für Schritt ausführlich beschrieben.
- Konfigurieren Sie Objekte im Kundenportal.
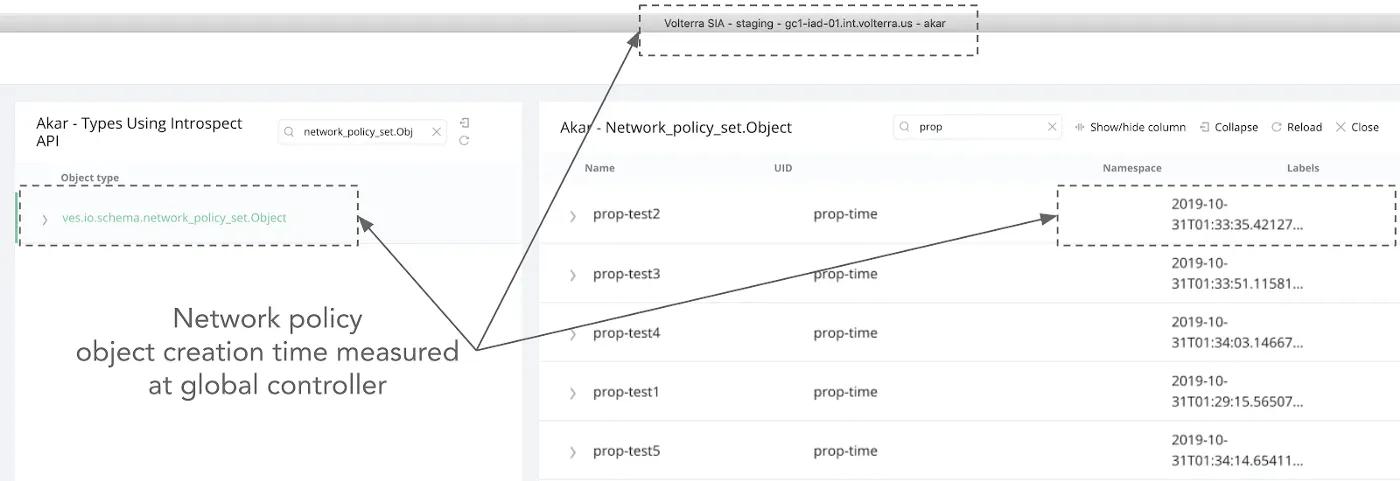
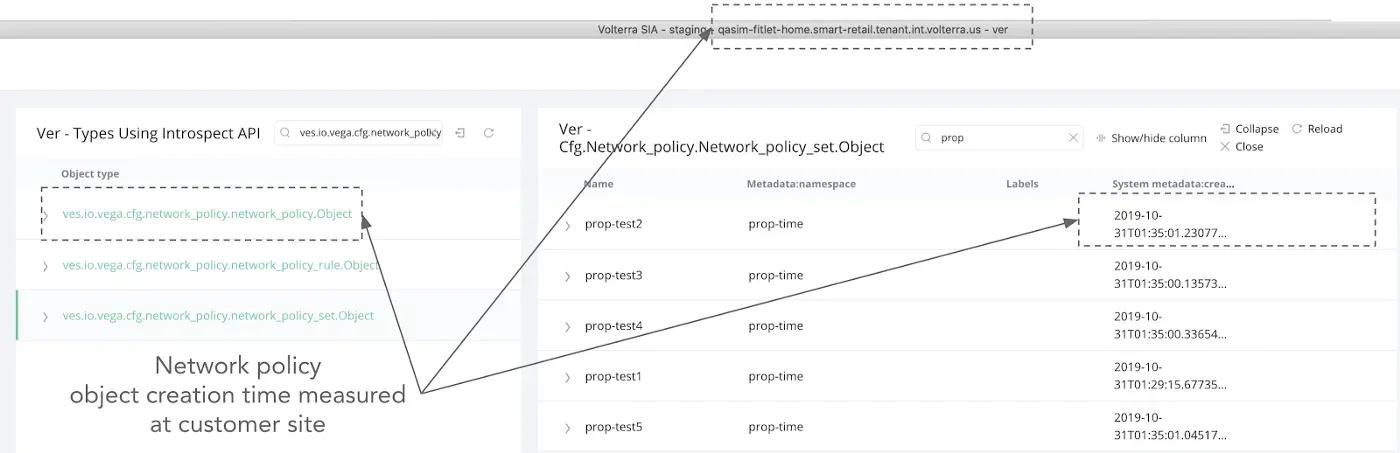
- Messen Sie die Startzeit als den Zeitpunkt der Objekterstellung im Kundenportal (im Folgenden als Volterra Global Controller bezeichnet). Ein Beispiel finden Sie in Abbildung 4.
- Messen Sie die Endzeit als den Zeitpunkt der Objekterstellung am Kundenstandort. Ein Beispiel finden Sie in Abbildung 5.
Beachten Sie, dass die gezeigten Screenshots nur Beispiele sind und sich nicht auf denselben Messdurchlauf beziehen.
Startzeit der Konfiguration
Endzeit der Konfiguration
Testergebnisse
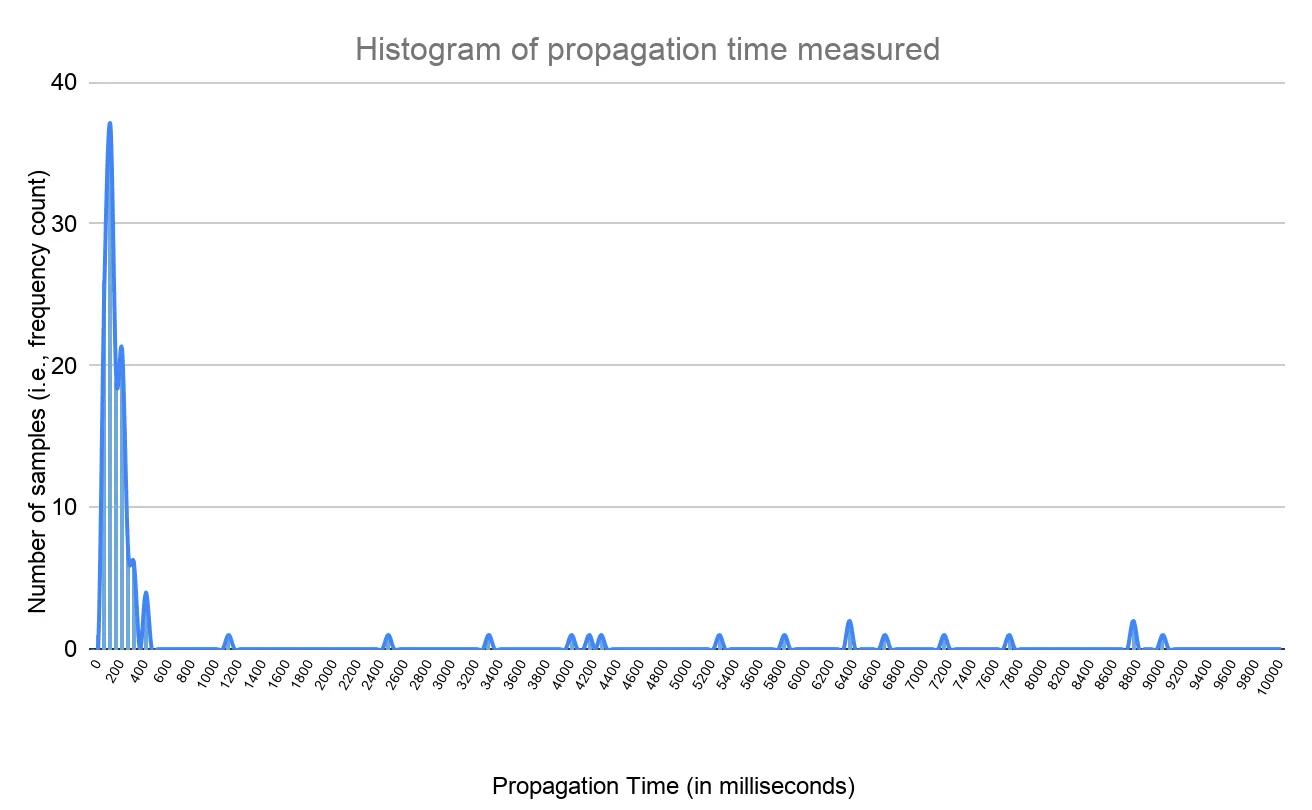
Die Testergebnisse zu den Übertragungszeiten sind in den Abbildungen 6 und 7 dargestellt. Das Diagramm in Abbildung 6 zeigt, dass die Übertragungszeit bei den meisten Messungen zwischen 0 und 400 ms lag. Das bedeutet, dass alle Kundenstandorte innerhalb von 0 bis 400 ms mit einer neuen Konfiguration aktualisiert werden. Wie bereits erwähnt, wurden Fehlerbedingungen simuliert, indem Dienste auf der RE neu gestartet und Verbindungsfehler bzw. -verzögerungen am Kundenstandort herbeigeführt wurden. Unter diesen Fehlerbedingungen ist die Übertragungszeit der Konfiguration länger und lag bei diesen spezifischen Tests je nach Fehlertyp zwischen 600 ms und 9 Sekunden. Beispielsweise verlängert ein Verbindungsfehler zwischen der RE und den Kundenstandorten die Zeit, bis die Konfiguration den Kundenstandort erreicht. Der Vorteil der verteilten Steuerungsebene von Volterra besteht jedoch darin, dass sie dem Prinzip der letztendlichen Konsistenz von Konfigurationen folgt. Das heißt, sie unternimmt wiederholt neue Versuche, um sicherzustellen, dass die Konfiguration an allen Kundenstandorten mit den vom Kunden festgelegten Vorgaben übereinstimmt.
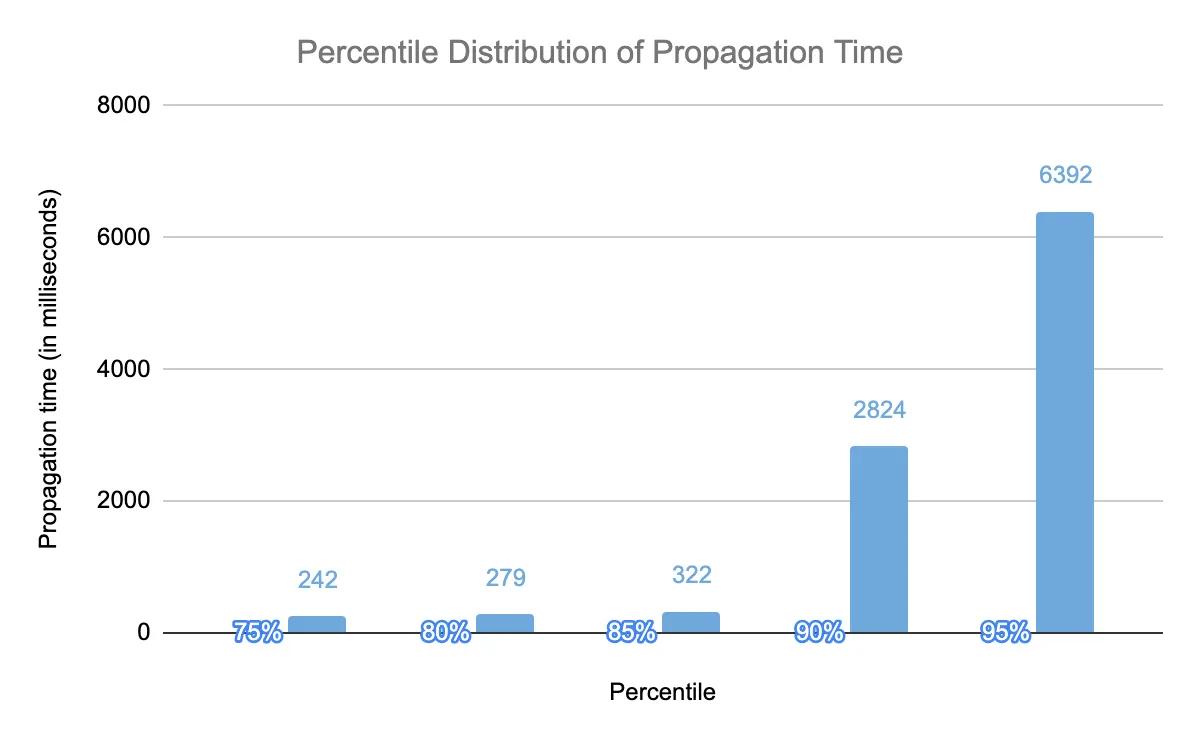
Das Diagramm in Abbildung 7 zeigt, dass in 85 % der Fälle alle Kundenstandorte innerhalb von 322 Millisekunden mit einer neuen Konfiguration aktualisiert werden. Wenn Fehlerbedingungen auftreten, kann es bei einigen wenigen Kundenstandorten zu einer Übertragungszeit von etwa 3–9 Sekunden kommen.
Haftungsausschluss: Diese Messungen hängen stark von der simulierten Topologie, Skalierung, Bereitstellungsumgebung und den simulierten Ausfallszenarien ab. Wir haben weder alle möglichen Ausfallszenarien noch andere Umgebungen untersucht. Daher können wir keine Aussagen über die Weiterleitungsverzögerung in anderen, nicht getesteten Situationen oder Umgebungen treffen. Bei einem Ausfall eines Kubernetes-Clusters müsste das System beispielsweise die Fehlererkennung, den Neustart und einen erneuten Konfigurationsversuch abwarten, was zu einer höheren Weiterleitungsverzögerung führen würde.
Ähnliche Blogbeiträge
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...