Verfügbarkeit ist in einer Wirtschaft, in der Anwendungen als Währung gelten, eine ernste Angelegenheit. Apps, die nicht reagieren, werden kurzerhand gelöscht und im Internet so schnell und sarkastisch verrissen wie in einer negativen Yelp-Bewertung.
Seit den Anfängen des Internets bemühen sich Unternehmen darum, Anwendungen (früher Websites) rund um die Uhr an 365 Tagen im Jahr verfügbar zu halten. Denn das Internet schläft nie, macht keinen Urlaub und meldet sich nie krank.
Um diesem Bedarf (eigentlich einer Anforderung) gerecht zu werden, entwickelte sich Skalierbarkeit zu einem der ersten Anwendungsdienste, die für Verfügbarkeit sorgten. Der sichtbarste – und am besten verstandene – Anwendungsdienst zur Gewährleistung der Verfügbarkeit ist der Lastenausgleich.
Es gibt jedoch viele Formen des Load Balancings und Skalierbarkeitsmuster, die sich mithilfe dieser Kerntechnologie implementieren lassen. Heute stelle ich die fünf wichtigsten Skalierbarkeitsmuster vor, die dafür sorgen, dass Anwendungen und das Internet rund um die Uhr an 365 Tagen im Jahr online und verfügbar bleiben.
Globaler Server-Lastenausgleich (GSLB)
GSLB ist eine äußerst unpassende Bezeichnung. Dabei ging es nie wirklich um den Lastenausgleich für Server, sondern um die Verfügbarkeit von Standorten. Heute umfasst dies auch die Verfügbarkeit von Anwendungen.
Mit GSLB stellen Sie sicher, dass Sie auf ein anderes Rechenzentrum ausweichen können, wenn ein Rechenzentrum (Cloud oder herkömmlich) nicht reagiert. GSLB kann auf Domain- oder Hostebene eingesetzt werden. So können Sie damit sowohl example.com zwischen verschiedenen Standorten umschalten als auch api.example.com.
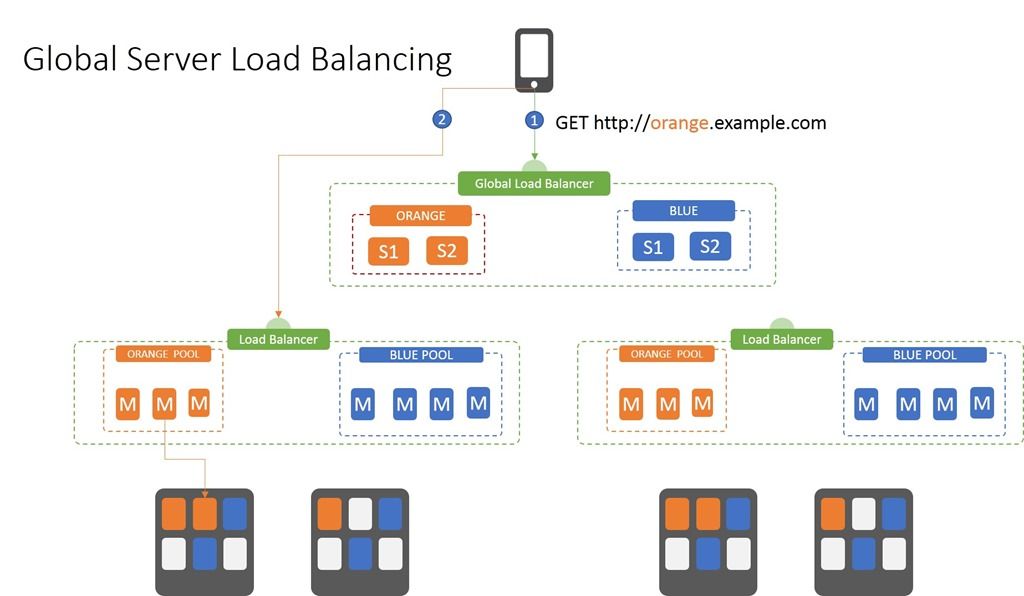
In seiner einfachsten Form verwendet GSLB einen rudimentären DNS-basierten Lastenausgleich. Das bedeutet, dass eine Liste von IP-Adressen vorhanden ist, die einer Domain oder einem Host zugeordnet sind. Ist die erste Adresse nicht verfügbar, werden Anfragen an die zweite Adresse in der Liste weitergeleitet – oder an die dritte, vierte und so weiter.
Dieser Prozess umfasst zwei Schritte:
- Fragen Sie den globalen Load Balancer nach der passenden IP-Adresse. Hier zeigt sich der Nachteil, der stets mit GSLB verbunden ist: Wenn Sie innerhalb der letzten 15 Minuten – oder innerhalb der jeweils aktuellen TTL für die IP-Adresse von cheese.com – bereits eine Anfrage gestellt haben, erhalten Sie erneut die zuletzt empfangene Antwort. Wenn also diese Website in der Zwischenzeit ausgefallen ist, kann keine Verbindung hergestellt werden.
- Senden Sie die Anfrage an die IP-Adresse der Website, die von der GSLB-Abfrage zurückgegeben wurde. Dabei handelt es sich häufig um einen lokalen Load Balancer, der die Anfrage mithilfe eigener Algorithmen und Entscheidungsprozesse an die passende Ressource weiterleitet.
Die in Schritt 1 getroffene Entscheidung basiert in der Regel nicht auf einer intelligenten Logik, sondern ausschließlich darauf, ob ein bestimmter Standort erreichbar ist. Dennoch können Sie auf diese Weise mehrere Standorte – in der Cloud, bei einem Hosting-Anbieter oder in der eigenen Infrastruktur – nutzen, um die Verfügbarkeit sicherzustellen. Durch die strategische Auswahl von Standorten in verschiedenen geografischen Regionen können Sie die Auswirkungen von Naturkatastrophen oder Internetausfällen vermeiden.
Dabei handelt es sich jedoch eher um ein DR- (Disaster Recovery) oder BC-Szenario (Business Continuity). Es gibt weitere Szenarien, die intelligentere GSLB-Anwendungsdienste wie Geolokalisierung und Anwendungsperformance nutzen. Wenn also die Anwendung an Standort A eine schlechte Performance aufweist, können Sie Besucher bis zur Behebung des Problems an Standort B weiterleiten. Oder Sie leiten Benutzer an den geografisch nächstgelegenen Standort weiter, um die Performance zu verbessern (denn die Lichtgeschwindigkeit ist nach wie vor eine physikalische Grenze, und die Entfernung wirkt sich auf die Anwendungsperformance aus).
Unabhängig davon, wie die Entscheidung getroffen wird, bleibt das Grundprinzip dasselbe: GLSB verteilt Anfragen auf mehrere räumlich getrennte Standorte, indem es die IP-Adresse eines der verfügbaren Standorte zurückgibt. Ob APIs oder Apps – GSLB ist ein übergeordnetes Muster zur Gewährleistung der Verfügbarkeit.
Herkömmlicher Lastenausgleich (POLB)
Verbindungsbasierte Verfügbarkeit
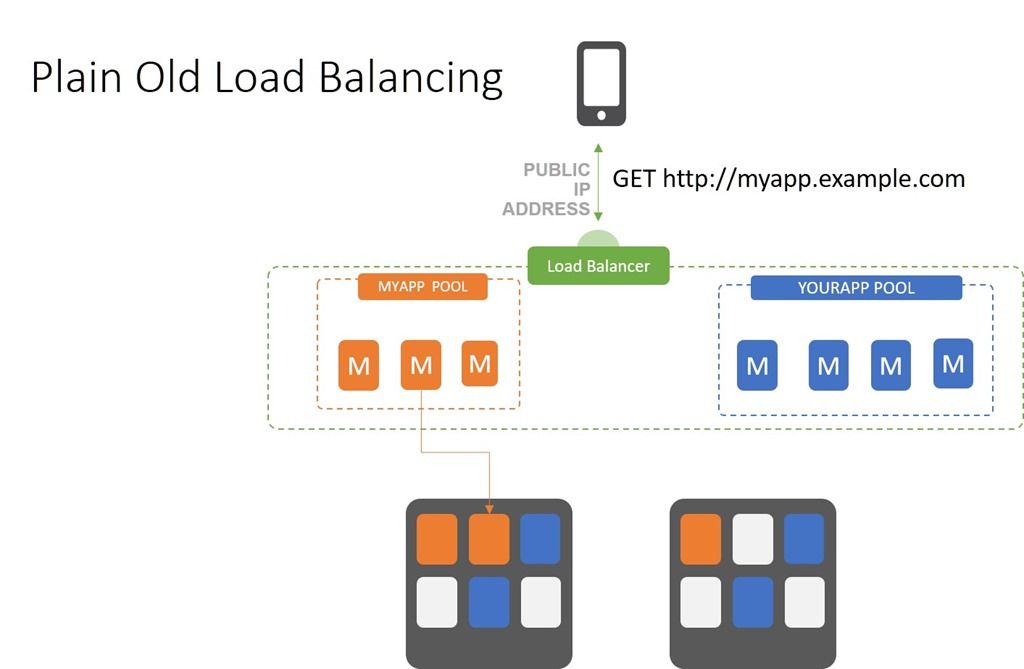
Plain Old Load Balancing (POLB) ist ein Begriff, den ich gerne für standardmäßige, TCP-basierte Lastverteilung verwende. Verfügbarkeit wird bei diesem Muster ganz einfach dadurch erreicht, dass Apps geklont werden und sichergestellt wird, dass eine Verbindung zwischen dem Client (Benutzer, Gerät) und der App hergestellt werden kann.
Der Load Balancer (oder Proxy, wenn Ihnen das lieber ist) empfängt eine Verbindungsanfrage, wählt eine verfügbare App-Instanz aus und leitet die Verbindung an sie weiter. Danach greift der Load Balancer nicht mehr aktiv ein. Das ist vergleichbar mit einer Vorstellungs-E-Mail, mit der Sie zwei Kollegen miteinander bekannt machen. Am anfänglichen Austausch sind Sie aktiv beteiligt, anschließend werden Sie jedoch in den CC-Verteiler verschoben und bringen sich in der Regel nicht weiter ein.
Ich verwende den Begriff POLB, weil bei der Entscheidung, wie Anfragen weitergeleitet werden, ausschließlich Algorithmen zum Einsatz kommen. Leider kann je nach dem zur Verteilung der Anfragen verwendeten Algorithmus vieles schiefgehen. Round Robin berücksichtigt beispielsweise weder Kapazität noch Leistung. Es wählt einfach „die nächste App“ aus und leitet die Anfrage an sie weiter. Die Wahl von „Least Connections“ kann die Leistung schnell beeinträchtigen, da eine Ressource stark ausgelastet wird, obwohl andere möglicherweise schneller wären. Die Wahl der Algorithmen wird damit zu einem entscheidenden Faktor für die Aufrechterhaltung der Verfügbarkeit.
POLB ist die Standardmethode für den Lastenausgleich in Containerumgebungen und bei vielen cloudnativen Load-Balancing-Diensten.
Persistenz
Sticky Sessions & SSL
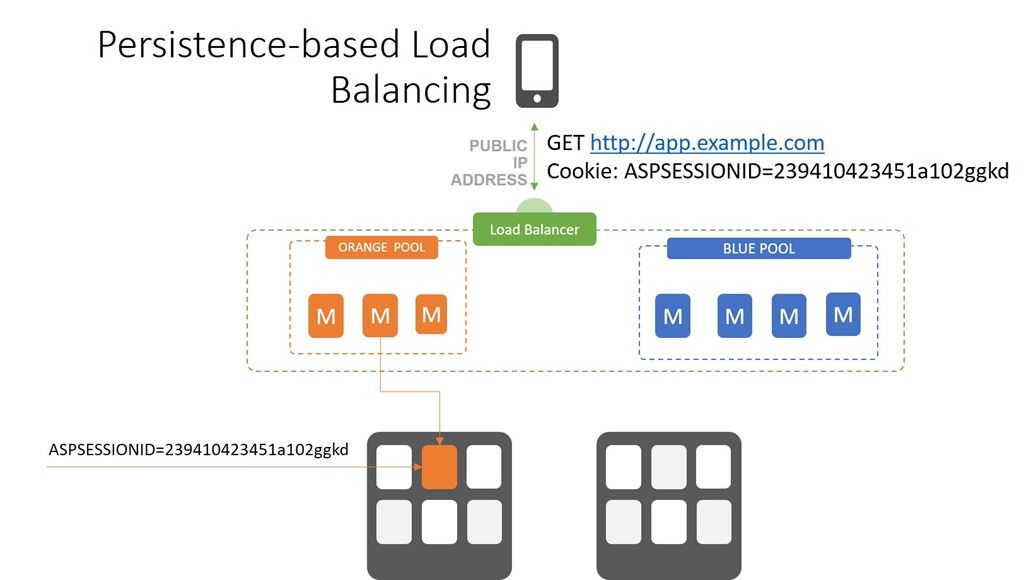
Eine der Gegebenheiten bei dreischichtigen Anwendungen ist, dass sie in der Regel zustandsbehaftet sind. Das bedeutet, dass sie zwischen Anfragen und Antworten Informationen speichern, die für den Betrieb der Anwendung entscheidend sind. Ihr Warenkorb, Ihre Anmeldedaten, Ihr Status, die zuletzt von Ihnen besuchte Seite und der aktuelle Schritt in einem Prozess sind allesamt Informationen, die häufig als Teil der „Sitzung“ gespeichert werden. Viele mit dreischichtigen Frameworks entwickelte Anwendungen speicherten diese Sitzung jedoch letztlich auf dem Anwendungs- oder Webserver und nicht in einer Datenbank. Sobald Sie also mit einem Server verbunden waren, mussten Sie immer wieder auf diesen Server zurückgreifen, um sicherzustellen, dass alle Ihre Informationen verfügbar waren.
Load Balancer implementierten Persistenz auf unterschiedliche Weise, wobei die Cookie-basierte Methode am weitesten verbreitet war. Sitzungs-IDs wurden in einem Cookie gespeichert und anschließend vom Load Balancer verwendet, um sicherzustellen, dass Anfragen an den richtigen Server weitergeleitet wurden. Dadurch wurde ein algorithmisches Auswahlverfahren faktisch umgangen.
Als die Verwendung von SSL/TLS zu einer entscheidenden Voraussetzung dafür wurde, dass sich Käufer sicher fühlen, traten dieselben Probleme auf. SSL/TLS ermöglicht eine sichere Sitzung zwischen einem Client und einem bestimmten Anwendungsserver. Damit beide Kommunikationspartner die über diese Verbindung ausgetauschten Daten entschlüsseln und verwenden konnten, musste der Load Balancer Clientanfragen an denselben Server weiterleiten können, auf dem die Sitzung begonnen hatte. Mithilfe derselben Techniken, die auch sitzungsbasierte Persistenz ermöglichen, konnten Load Balancer eine SSL/TLS-basierte Persistenz unterstützen.
Unabhängig von der jeweils verwendeten Persistenzart ist das Muster immer dasselbe. Gibt es einen Hinweis darauf, dass bereits eine Sitzung eingerichtet wurde, behält der Load Balancer die bestehende Verbindung bei und stellt sicher, dass sie für die Dauer der Benutzersitzung bestehen bleibt. Andernfalls wählt der Load Balancer anhand seiner Konfiguration und Algorithmen eine Ressource aus und stellt die Verbindung her.
Dies hat Auswirkungen auf die Kapazitätsplanung bei der Auswahl eines Lastverteilungsalgorithmus. Der Algorithmus „Least Connections“ ist für dieses Szenario eine gute Wahl, da er sicherstellt, dass keine einzelne Ressource durch laufende Sitzungen überlastet wird, während andere ungenutzt bleiben. Bei anderen Algorithmen besteht die Gefahr, dass eine einzelne Ressource letztlich viele Benutzersitzungen gleichzeitig aufrechterhalten muss, was sich negativ auf die Leistung für alle an diesen Server weitergeleiteten Benutzer auswirkt.
Hostbasierter Lastenausgleich
Virtuelle Server
Hostbasiertes Load Balancing ist eines der gängigsten und am umfassendsten unterstützten Skalierbarkeitsmuster. Man könnte meinen, dass für dessen Implementierung kein Load Balancer erforderlich ist, da alle Webserver gleichzeitig als mehrere Hosts auftreten können. Doch das ist nicht der Fall. Ein Web-/Anwendungsserver kann zwar mehrere virtuelle Server hosten, verteilt die Last aber nicht zwangsläufig auf diese. Für die Skalierung benötigen Sie daher weiterhin einen Load Balancer. Die Frage ist, ob der Load Balancer die Hosts aufteilt oder ob Sie dies dem Web-/Anwendungsserver überlassen.
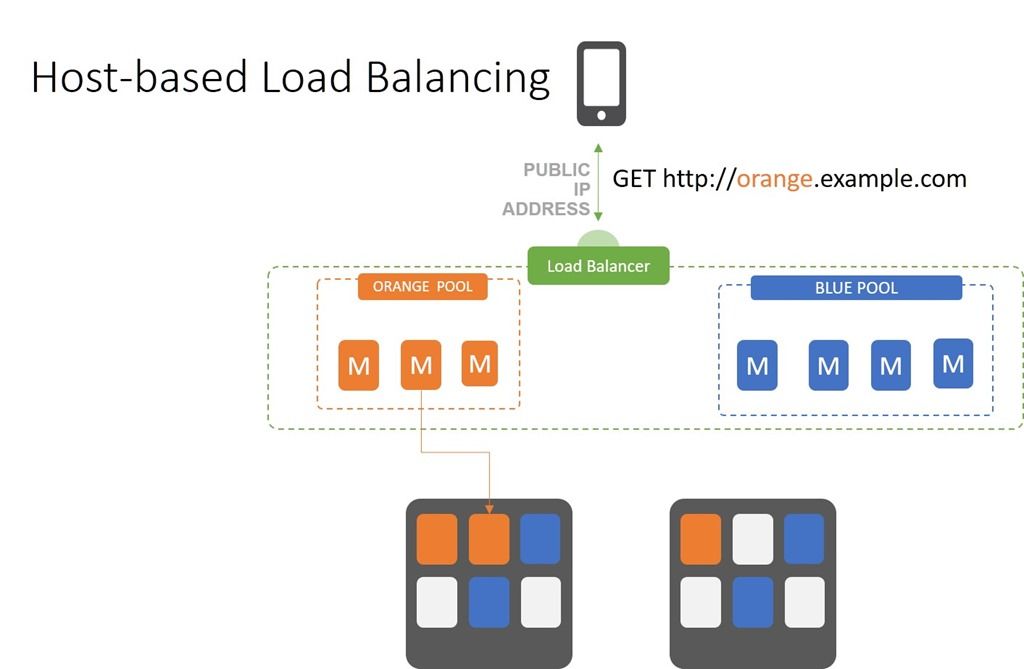
Unabhängig davon, ob Web-/App-Server-Direktiven oder ein externer Load Balancer verwendet werden, bleibt der Ablauf gleich. Eine Anfrage wird gestellt und vom Zielsystem (Load Balancer oder Web-/App-Server) empfangen. Anschließend prüft der Zielserver die HTTP-Header, ermittelt den Host-Wert und leitet die Anfrage an den entsprechenden virtuellen Server weiter.
Der Vorteil eines Load Balancers zur Aufteilung von Hosts besteht darin, dass sich Domains nach Host isolieren und unabhängig voneinander skalieren lassen. Dies ist effizienter und kann die Anzahl der Server (Hardware und Software) reduzieren, die Sie für die Skalierung einer Anwendung benötigen. Darüber hinaus erleichtert es die Kapazitätsplanung, da Sie besser vorhersagen können, welche Last jeder Hostserver zu einem bestimmten Zeitpunkt bewältigen kann.
Das liegt daran, dass die Ausführung von Geschäftslogik einen anderen Rechenaufwand erfordert als das Abrufen eines Bildes. Werden verschiedene Hosts in derselben Skalierungsdomäne zusammengefasst, führt dies zu schwankender Last und schwer vorhersehbarem Kapazitätsbedarf. Wenn Sie einen Load Balancer lediglich für die herkömmliche Lastverteilung einsetzen, ist der Web-/Anwendungsserver dafür zuständig, die Hosts aufzuteilen und Anfragen an den entsprechenden virtuellen Server weiterzuleiten. Weitere Nachteile dieses Ansatzes ergeben sich aus der gemeinsam genutzten Infrastruktur: Versionskonflikte, Patches und Anwendungsupdates können zu Problemen zwischen den virtuellen Servern führen.
Die zunehmende Verbreitung von Containern und Microservices fördert den Einsatz von hostbasiertem Load Balancing in Form von Ingress-Controllern.
Weiterleiten und Zurücksenden
Layer-7-Lastverteilung (HTTP)
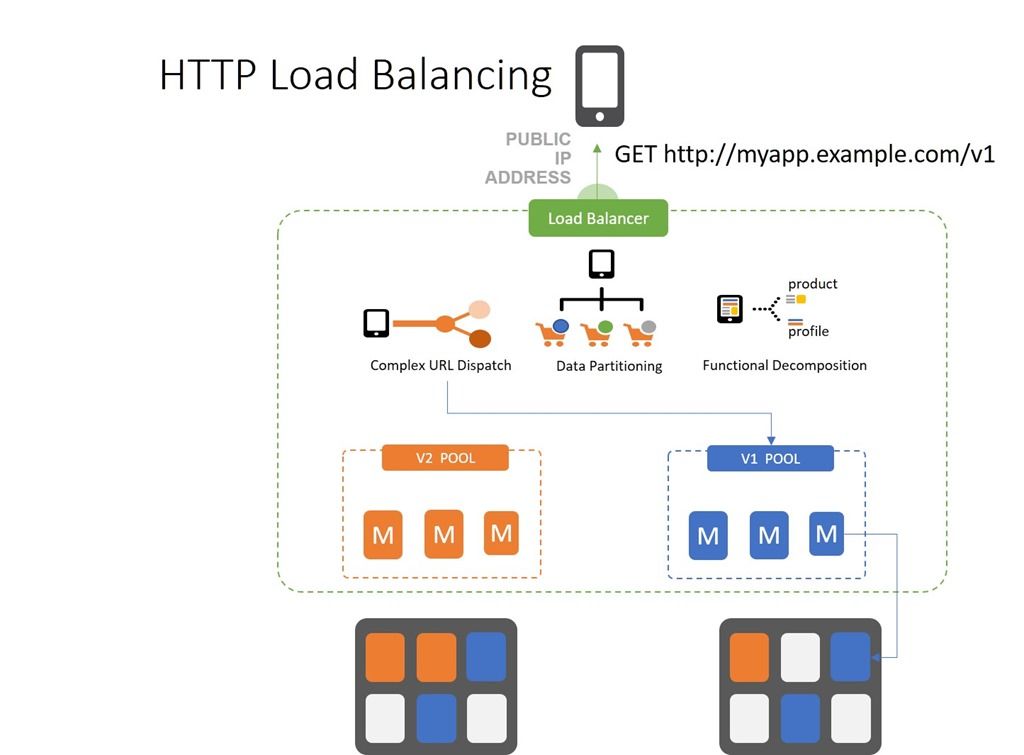
Layer-7-Load-Balancing (HTTP) ist aufgrund seiner Vielseitigkeit (Agilität?) mein Favorit. Anfragen lassen sich anhand sämtlicher HTTP-Daten verteilen – einschließlich der Nutzlast. Die meisten beschränken ihre Load-Balancing-Regeln (meiner Meinung nach klugerweise) auf die Informationen im HTTP-Header. Dazu gehören unter anderem der Host, die HTTP-Methode, der Content-Type, Cookies, benutzerdefinierte Header und der User-Agent.
Beim HTTP-Load-Balancing geht es zunächst um das Routing und anschließend um die Lastverteilung. Ein typisches Muster für HTTP-Load-Balancing folgt dem Prinzip „Weiterleiten –> Verteilen“. Das bedeutet, dass zunächst entschieden wird, an welchen virtuellen Server eine Anfrage weitergeleitet werden soll. Anschließend wählt ein Algorithmus eine Ressource aus dem Pool aus, der diesen virtuellen Server unterstützt.
HTTP-Lastverteilung ermöglicht Muster wie die API-Versionierung, bei der die API-Version in den URI (oder in einen benutzerdefinierten HTTP-Header) eingebettet wird. Der Load Balancer kann die Versionen voneinander trennen und sicherstellen, dass Clients zur Ausführung an den richtigen Backend-Dienst weitergeleitet werden. Dies ermöglicht eine reibungslose Migration von Clients in Situationen, in denen kein erzwungenes Upgrade möglich ist.
Diese Art von Skalierbarkeitsmuster unterstützt auch andere Skalierbarkeitsmuster wie die funktionale Zerlegung und Datenpartitionierung. Es ist das robusteste und flexibelste Skalierbarkeitsmuster und bietet eine Vielzahl von Möglichkeiten für die horizontale Skalierung von Anwendungen und zunehmend auch von Microservices.
Zusammenfassend gibt es also fünf wichtige Skalierbarkeitsmuster, von denen die meisten miteinander kombiniert werden können (und häufig auch werden), um Ressourcen möglichst effizient zu nutzen und die bestmögliche Leistung zu erzielen. Wenn Sie derzeit noch keines davon einsetzen, werden Sie es wahrscheinlich künftig tun. Daher ist ein grundlegendes Verständnis ihres Aufbaus eine gute Basis für die Entwicklung einer skalierbaren Architektur – unabhängig davon, welche Art von Anwendungen Sie verwenden oder wo diese bereitgestellt werden.
Weiter skalieren!
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...