
Hintergrund
In zwei früheren Artikeln haben wir uns mit Überlegungen zum datengetriebenen Design befasst, insbesondere damit, wie Geschäftsdaten einen verborgenen Unternehmenswert darstellen. Die zentrale Botschaft lautete, dass eine strukturierte Datenarchitektur die technische Grundlage dafür bildet, diesen inhärenten Wert zu erschließen. Allerdings wurden die relevanten Themen in diesen Artikeln lediglich auf konzeptioneller Ebene vorgestellt. Heute möchte ich die Konzepte anhand eines konkreteren und anschaulicheren Beispiels veranschaulichen: einer Geschichte darüber, wie man bei der Architektur einer Anwendung im Sinne eines Data-First-Ansatzes vorgehen könnte.
Aber zuerst: Warum sollte mich das interessieren?
Bevor wir jedoch direkt in die Geschichte einsteigen, wollen wir noch einmal zusammenfassen, warum Daten heute wichtiger sind als früher. In der Vergangenheit haben viele Unternehmen Daten vor allem um ihrer selbst willen sowie aus Governance-Gründen wie Audits und Compliance erfasst und gespeichert. Daher wurden die Erfassung und Speicherung von Daten traditionell als eine Art „Steuer“ auf den Geschäftsbetrieb betrachtet, der kaum ein direkter operativer Nutzen für das Unternehmen zugeschrieben wurde.
Was sich inzwischen geändert hat, ist die umfassendere Erkenntnis, dass die gesammelten Daten ausgewertet werden können, um Geschäftsprozesse zu optimieren und das Kundenerlebnis zu verbessern. Laut einer aktuellen Umfrage unter Unternehmen im digitalen Einzelhandel waren diese beiden Ziele – die Verbesserung der Geschäftsprozesse und des Kundenerlebnisses – beispielsweise für 57 % aller befragten Unternehmen die wichtigsten Treiber der digitalen Transformation. Die entscheidende Erkenntnis – der Kern der Frage, „warum das wichtig ist“ – besteht darin, dass sich datengestützte Workflows sowohl auf nach außen gerichtete Bereiche des Unternehmens (etwa das Kundenerlebnis) als auch auf interne Bereiche, also die zentralen Geschäftsprozesse, auswirken. Deshalb ist eine durchdachte und gezielte Datenstrategie von grundlegender Bedeutung, um die Qualität und Kosteneffizienz der wichtigsten Geschäftsabläufe zu gewährleisten. Werden die Workflows zudem so instrumentiert, dass sie die bei ihrer Ausführung anfallenden Daten an eine Infrastruktur zur Datenerfassung und -analyse übermitteln, können sie kontinuierlich analysiert und verbessert werden. So entstehen Geschäftsabläufe, die fortlaufend angepasst und optimiert werden.
Nebenbei bemerkt bestand die größte Sorge dieser Unternehmen im Zusammenhang mit der digitalen Transformation darin, die Cybersicherheit eben dieser digitalen Prozesse zu gewährleisten. Wie sich herausstellt, spielt auch in diesem Bereich derselbe Ansatz zur Datentelemetrie und -analyse eine entscheidende Rolle – doch dieses Thema hebe ich mir für einen anderen Artikel auf.
Die Anwendung: Restaurantbestellung und -lieferung
Kommen wir nun zu unserem Gedankenexperiment. Ich habe ein Szenario gewählt, das viele von uns angesichts des durch das Coronavirus veränderten Alltags vermutlich gut nachvollziehen können: eine Anwendung, die einen Onlinedienst für die Bestellung und Lieferung von Restaurantessen bereitstellt. Die Gerichte werden online bei einem vom Kunden ausgewählten Restaurant bestellt, und der Nutzer kann wählen, ob er die Bestellung selbst abholt oder sie vom Dienst liefern lässt.
In diesem Szenario übernehmen wir die Rolle des Anwendungsverantwortlichen. In dieser Rolle müssen wir uns mit vielen verschiedenen Aspekten befassen, die wir in zwei Kategorien unterteilen: erstens notwendige betriebliche Aufgaben und zweitens zukunftsorientierte strategische Fragestellungen.
Die erste Gruppe – erforderliche betriebliche Aktivitäten – umfasst Aspekte wie:
- Restaurants finden und anhand von Merkmalen wie Standort und Öffnungszeiten beschreiben
- Zusammentragen von Daten zu Speisen und Preisen
- Restaurants über Bestellungen informieren
- Zahlungen abwickeln
- Erfassung von Daten zur Verfügbarkeit personeller Ressourcen für die Abholung und Auslieferung von Bestellungen
- Verfolgung der Bestellbereitschaft und des Lieferstatus
Die zweite Gruppe von Fragestellungen betrifft weniger das operative Tagesgeschäft, ist aber nicht minder wichtig. Wenn diese Aspekte von Anfang an berücksichtigt werden, kann das Unternehmen agil und anpassungsfähig handeln und sich kontinuierlich verbessern. Beispiele für solche Fragestellungen sind:
- Wie lässt sich die Nachfrage prognostizieren? Dabei kann es sich einfach um die Gesamtnachfrage nach Tageszeit bzw. Wochentag handeln oder um eine detailliertere Prognose, beispielsweise für jedes einzelne Restaurant.
- Welche Arten von Tools, Prozessen oder Arbeitsabläufen liefern meinen Anbietern (Restaurants) geschäftliche Erkenntnisse?
- Wie können die Preise – sowohl für das Essen als auch für die Lieferung – dynamisch angepasst werden?
- Angenommen, meine Anwendung wird in der Public Cloud gehostet: Wie lassen sich die Betriebskosten für meine Infrastruktur optimieren?
Dies ist natürlich nur eine Teilmenge der gesamten Bandbreite an Aspekten, die wir berücksichtigen müssten. Doch selbst diese kleinere Auswahl reicht aus, um eine fundierte Diskussion zu ermöglichen, die die Bedeutung einer strukturierten Datenarchitektur für eine erweiterbare Datenverarbeitungspipeline hervorhebt.
Datenarchitektur oder Datenpipeline/Henne oder Ei
In unserer angenommenen Rolle als Anwendungsverantwortliche können wir bei der Ausarbeitung unserer übergreifenden Datenstrategie zunächst unsere Geschäftsabläufe auflisten und den jeweiligen Datenverarbeitungsbedarf ermitteln. Ein Beispiel ist der Ablauf, bei dem geöffnete Restaurants in der Nähe gesucht und anschließend deren Speisenangebot und Preise angezeigt werden. Dazu müssten die Restaurants nach Standort und Öffnungszeiten gefiltert und anschließend das Speisenangebot eines bestimmten ausgewählten Restaurants abgerufen werden – möglicherweise zusätzlich gefiltert nach der Verfügbarkeit von Lieferfahrern. Dies könnten wir für jeden Ablauf tun – etwa für die Zahlungsabwicklung, die Zuordnung von Fahrern zu Lieferaufträgen und so weiter.
Ebenso gut könnten wir unsere Überlegungen stattdessen mit den grundlegenden Daten-„Atomen“ beginnen – den benötigten Datenbausteinen. Wir würden die wichtigen Datenatome ermitteln und auflisten und dabei besonders auf eine einheitliche Darstellung und konsistente Semantik dieser Datenatome sowie auf das Metadatenvokabular achten, das zur Unterstützung unserer Geschäftsabläufe erforderlich ist. Beispiele für Datenatome in unserer Beispielanwendung wären: Standortdaten für Restaurants, Kunden und Fahrer; Lebensmittel für Speisekarten und Rechnungen; Zeitangaben, die zum Filtern und zur Überwachung der Lieferqualität verwendet werden; sowie Zahlungsinformationen, die mit den Zahlungsabläufen für Kunden und Fahrer verknüpft sind.
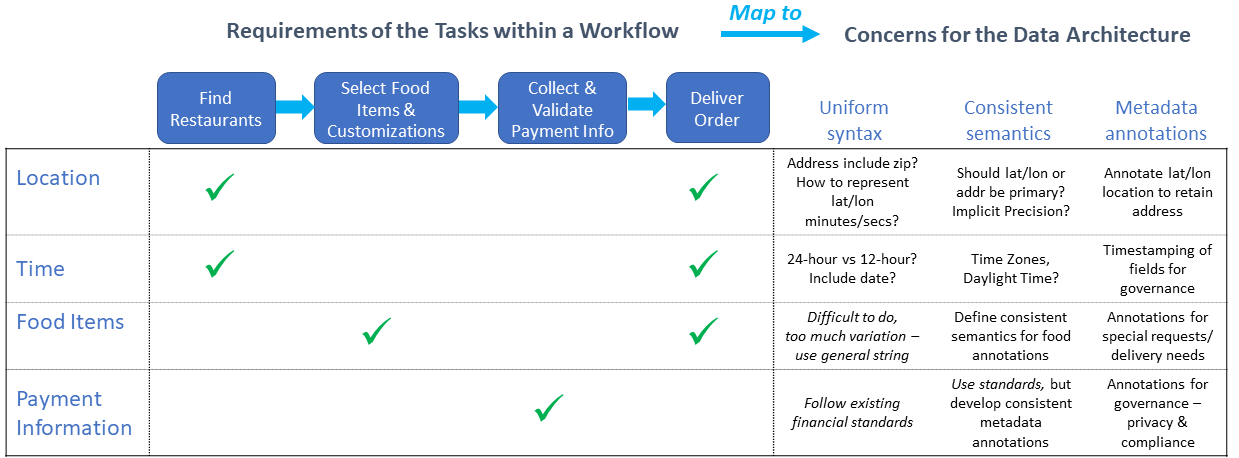
Welchen dieser beiden möglichen Ausgangspunkte – die Datenverarbeitungspipeline der Workflows oder alternativ die Daten-„Atome“ – wir für unsere Datenstrategie wählen sollten, ist eine Henne-Ei-Frage. Beide Perspektiven sind hilfreich und, was noch wichtiger ist, voneinander abhängig. Wir können die Datenverarbeitungspipeline nicht durchdenken, ohne die zugrunde liegenden Datenatome zu berücksichtigen, und ebenso wenig können wir die Datenarchitektur entwickeln, ohne die Anforderungen der Verarbeitungspipeline einzubeziehen. Dennoch würde ich im Allgemeinen einen Ansatz empfehlen, bei dem man zunächst die Workflows überblickt, um die Datenatome zu erfassen, sich anschließend jedoch der strukturierten Gestaltung der Datenarchitektur widmet, bevor man die Datenpipeline im Detail konzipiert. Der Grund dafür ist, dass Workflows dynamischer sind: Sie werden ergänzt und angepasst, wenn sich das Unternehmen weiterentwickelt, während die zugrunde liegenden Daten eine längere Historie und größere Beharrungskraft aufweisen. Daher profitiert die Datenarchitektur stärker von einer vorausschauenden Planung.
Anwendung eines ganzheitlichen Ansatzes für Datenarchitektur und Datenpipelines auf konkrete Beispiele
Kehren wir zu unserem Beispiel zurück und nehmen wir an, dass wir als Anwendungsverantwortliche bereits eine recht ausgereifte Vorstellung von den zentralen geschäftskritischen Arbeitsabläufen und den zu ihrer Unterstützung erforderlichen Datenatomen haben. Zuvor hatten wir bereits einige der grundlegenden Datenelemente identifiziert, die für unsere Arbeitsabläufe benötigt werden: Ort, Zeit, Lebensmittel und Zahlungsinformationen. Zur Erinnerung an die vorangegangenen Artikel: Die Datenarchitektur sollte drei zentrale Ziele ermöglichen – eine einheitliche Syntax, eine konsistente Semantik und ein Metadatenvokabular, mit dem sich die Daten analysieren und verwalten lassen. Nun können wir diese Grundsätze anwenden, um die Aspekte der Datenarchitektur für die im heutigen Beispiel aufgeführten spezifischen Datenatome zu erörtern.
Betrachten wir das Datenatom „Standort“ genauer und gehen wir dabei auf jedes der drei Hauptziele der Datenarchitektur ein.
- Erstens: Wie lautet die einheitliche Syntax für die Datendarstellung?
Zunächst könnte man daran denken, einen Standort durch eine Straßenadresse darzustellen, da Restaurants und Kunden ihren Standort üblicherweise so angeben. Berücksichtigen Sie jedoch die Anforderungen an Standortdaten bei der Verfolgung von Fahrern, die Lieferungen ausführen: Sie sind häufig unterwegs, möglicherweise auf einer Autobahn oder an einem Ort, der sich nicht gut durch eine Straßenadresse beschreiben lässt. Stattdessen eignen sich Breiten- und Längengrad möglicherweise besser, um den Standort für diesen Arbeitsablauf darzustellen; dieses Format würde auch für die Standorte von Restaurants und Kunden funktionieren. Da Fahrer jedoch in der Regel zu einem Restaurant oder zum Standort eines Kunden navigieren müssen, muss es weiterhin eine Möglichkeit geben, den Standort eines Fahrers (Breiten-/Längengrad) dem Standort eines Kunden (Straßenadresse) zuzuordnen. Daher könnte eine wohlüberlegtere Entscheidung darin bestehen, alle Standortdaten auf Breiten- und Längengrad zu normalisieren (die erforderliche „kanonische“ Darstellung), zugleich aber die Möglichkeit vorzusehen, Straßenadressen bei ihrer erstmaligen Angabe in Breiten- und Längengrad umzuwandeln (ein „Ingestion“-Arbeitsablauf). - Der zweite Aspekt betrifft die konsistente Semantik.
Unter der Annahme, dass Standortdaten als Breiten- und Längengrad normalisiert werden, ist dies relativ unkompliziert, da es sich dabei um einen etablierten Standard mit eindeutiger Auslegung handelt. Ein weiterer Aspekt konsistenter Semantik ist jedoch die Präzision – also die implizierte Genauigkeit der Daten. Da GPS- und Kartendaten naturgemäß nur eine begrenzte Genauigkeit aufweisen, können wir den Standort entweder mit einer konstanten Präzision angeben (z. B. auf die nächste Bogensekunde genau, was ungefähr 30 Metern entspricht) oder je nach Qualität der Datenquelle mit variabler Präzision. Entscheiden wir uns zugunsten der Flexibilität für Letzteres, müssen wir die Präzision jeder einzelnen Standortangabe mithilfe von Metadaten – die im Folgenden beschrieben werden – kennzeichnen. - Das dritte Ziel der Datenarchitektur besteht darin, die Möglichkeit zu bieten, die erfassten Datenelemente mit Anmerkungen und zusätzlichen Informationen anzureichern.
Bei Standortdaten kann dies, wie bereits erwähnt, die Genauigkeit der Daten umfassen. Darüber hinaus kann es sinnvoll sein, den Standort zur besseren Lesbarkeit mit einer Straßenadresse zu versehen und insbesondere dafür zu sorgen, dass eingelesene Adressdaten erhalten bleiben. Dies ist besonders wichtig, wenn mehrere Straßenadressen denselben Breiten- und Längengraden zugeordnet sein können, etwa bei einer Wohnanlage. Eine weitere Ergänzung kann ein Zeitstempel sein, der angibt, wann das Standortdatenfeld erfasst wurde. Dies kann bei einem Fahrer in Bewegung relevant sein, da Standortdaten schnell veralten.
Bisher haben wir nur über die Anforderungen an Standortdaten gesprochen und könnten nun für jedes der anderen Datenfelder eine ähnliche Betrachtung durchführen. Statt jedoch alle relevanten Aspekte für jedes einzelne Datenelement aufzuzählen, möchte ich einige bemerkenswerte Beobachtungen hervorheben:
- Zum Datenatom Zeit: Die Darstellung eines Zeitwerts ist bekanntermaßen schwierig. Sie kann sowohl syntaktisch (z. B. 24-Stunden-Format gegenüber 12-Stunden-Format mit AM/PM) als auch semantisch (z. B. das Konzept der Zeitzonen und Unterschiede bei der Berücksichtigung der Sommerzeit) variieren. Daher muss die Zeitdarstellung wahrscheinlich kanonisiert werden (etwa durch Normalisierung auf GMT oder, für Unix-/Linux-Benutzer, auf Sekunden „seit der Epoche“).
- Speise-Dateninstanzen können sehr unterschiedlich sein und individuelle Anforderungen haben. Da diese Datenatome häufig frei formuliert sind, ist ein kanonisches Metadatenvokabular sinnvoller als der Versuch, eine einheitliche Syntax zu schaffen. Einige Metadatenfelder wären für statische Eigenschaften einzelner Speisen vorgesehen, etwa „muss gekühlt bleiben“ oder „enthält Nüsse“, während andere Metadatenfelder für Informationen zu einer konkreten Speiseinstanz (einer einzelnen Bestellung) erforderlich wären, beispielsweise „Schärfegrad“ oder „bevorzugte Beilagen“. In beiden Fällen erfordert das Entwurfsziel eine einheitliche Syntax und eine konsistente Semantik der Metadatenfelder, damit sie für das gesamte Angebot an Speisen verwendet werden können.
- Weitere wichtige Aspekte sind Datenkonformität und Data Governance. Ein Aspekt ist die Richtlinie zur Datenaufbewahrung, nach der einige Felder – etwa die IP-Adresse eines Kunden oder der Standortsverlauf eines Fahrers – nur für kurze Zeit gespeichert werden dürfen. Ein weiterer häufiger Aspekt ist, dass für manche Felder Sicherheits- oder Datenschutzbeschränkungen gelten können; ein Beispiel hierfür sind Zahlungsinformationen. Die Anreicherung mit Metadaten bietet für beide Fälle eine Lösung. Mithilfe von Metadaten sollte eine IP-Adresse oder ein Standortwert mit einem Ablaufzeitpunkt für die Datenaufbewahrung versehen werden. Bei Zahlungsinformationen können Metadaten dazu verwendet werden, Sicherheitsanforderungen zu übermitteln – etwa die Notwendigkeit, ruhende Daten zu verschlüsseln, oder geografische Beschränkungen für den persistenten Datenspeicher festzulegen.
Auch wenn dieses Beispiel bisher nur an der Oberfläche gekratzt hat, verdeutlicht es doch viele der Aspekte, die bei realen Szenarien zu berücksichtigen sind. In der Praxis wäre die Ausarbeitung der Datenstrategie an diesem Punkt jedoch nicht abgeschlossen, sondern würde iterativ und kontinuierlich fortgeführt. Während die Datenelemente in die Datenverarbeitungspipelines einfließen, die die Geschäftsabläufe abbilden, würde die Datenarchitektur fortlaufend angepasst und erweitert. Bei der Optimierung bestehender und der Einführung neuer Abläufe würden sich zusätzliche Anforderungen an die Datenarchitektur für vorhandene Datenatome ergeben und zugleich neue Datenatome hinzukommen.
Abschließende Gedanken
Obwohl dieses Beispiel der Kürze halber vereinfacht wurde, veranschaulicht es dennoch die wichtigsten Prinzipien für die Zuordnung von Workflows zu den daraus resultierenden Anforderungen an die Datenarchitektur. Der Prozess beginnt stets mit der Betrachtung der geschäftlichen Anforderungen – des Kundenerlebnisses und der Geschäftsprozesse, die erforderlich sind, um diese Anforderungen zu erfüllen. Die Geschäftsprozesse wiederum definieren die Elemente eines Geschäftsvokabulars. Auf der nächsten Detailebene werden die Prozesse einer Datenpipeline zugeordnet, die ein Datenvokabular nutzt.
Das zentrale Prinzip besteht darin, dass eine robuste Datenarchitektur – eine Architektur, die Syntax, Semantik und Annotationen definiert – die Grundlage dafür schafft, dass die Datenpipeline effizient erweitert und neue Workflows problemlos hinzugefügt werden können. Auf der Abstraktionsebene der Geschäftsschicht bedeutet dies, dass sich bestehende Geschäftsprozesse leicht anpassen und neue oder im Entstehen begriffene Geschäftsprozesse schnell in Betrieb nehmen lassen. Werden hingegen in einem dieser Bereiche – Datenvokabular, Datenarchitektur-Framework oder Rückbindung dieser Aspekte an die geschäftlichen Anforderungen – keine wohlüberlegten Entscheidungen getroffen, führt dies letztlich zu einem instabilen und anfälligen System, das sich nicht flexibel an neue geschäftliche Anforderungen anpassen lässt.
Über den Autor
Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.