
Was ist Hochverfügbarkeit?
Hochverfügbarkeit (High Availability, HA) bezeichnet die Fähigkeit eines Systems, kontinuierlich – ohne Ausfallzeiten oder Störungen – zu arbeiten, in der Regel mithilfe integrierter Failover-Mechanismen. Hochverfügbare Systeme sind so konzipiert, dass sie selbst bei unerwarteten Ereignissen störungsfrei weiterarbeiten.
Warum Hochverfügbarkeit wichtig ist
Das Hauptziel von HA besteht darin, Ausfallzeiten zu vermeiden, also Zeiträume, in denen ein System, ein Dienst, eine Anwendung, ein Cloud-Dienst oder eine Funktion entweder nicht verfügbar ist oder nicht ordnungsgemäß funktioniert. Ausfallzeiten führen zu Umsatzeinbußen, geringerer Produktivität und einer Schädigung des Unternehmensrufs. Daher ist HA wichtig für:
- Geschäftskontinuität – HA stellt sicher, dass kritische Systeme, Features und Funktionen jederzeit wie erwartet verfügbar sind. HA-Systeme erholen sich schnell von Ausfällen, sodass Unternehmen ihre Kunden weiterhin wie gewohnt bedienen können (vorzugsweise ohne merkliche Unterbrechung).
- Verbesserte Benutzererfahrung – Schnelle und zuverlässige Systeme tragen dazu bei, die Kundenzufriedenheit aufrechtzuerhalten und die negativen Auswirkungen von Umsatzeinbußen, kompromittierten Daten und Produktivitätsverlusten zu vermeiden.
- Wettbewerbsvorteil – Eine hohe Verfügbarkeit hilft Unternehmen, sich durch schnellere und zuverlässigere Dienstleistungen vom Wettbewerb abzuheben. Dies zeugt von einem hohen Anspruch an die Gesamtqualität und die Kundenzufriedenheit.
Arten von Hochverfügbarkeit
Es gibt verschiedene Arten von Hochverfügbarkeit (HA), die sich nach dem erforderlichen Redundanzgrad, der benötigten Ausfalltoleranz und der Art des zu schützenden Systems einteilen lassen. Zu den gängigsten Arten von HA gehören:
- Aktiv-passiv – Ein Backup-System wird in einem passiven Modus oder Bereitschaftsmodus gehalten und nur dann aktiviert, wenn das primäre System ausfällt. Bei dieser Methode der Ausfallsicherung ist für die Umschaltung auf das Backup-System mitunter ein manueller Eingriff erforderlich.
- Aktiv-Aktiv – Mehrere Systeme sind gleichzeitig aktiv und teilen sich die Arbeitslast. Fällt ein System aus, übernehmen die anderen Systeme automatisch dessen Arbeitslast. Diese Art der Hochverfügbarkeit erfordert eine komplexere Konfiguration und Koordination zwischen den Systemen, bietet jedoch eine bessere Leistung und Skalierbarkeit als eine manuelle Lösung.
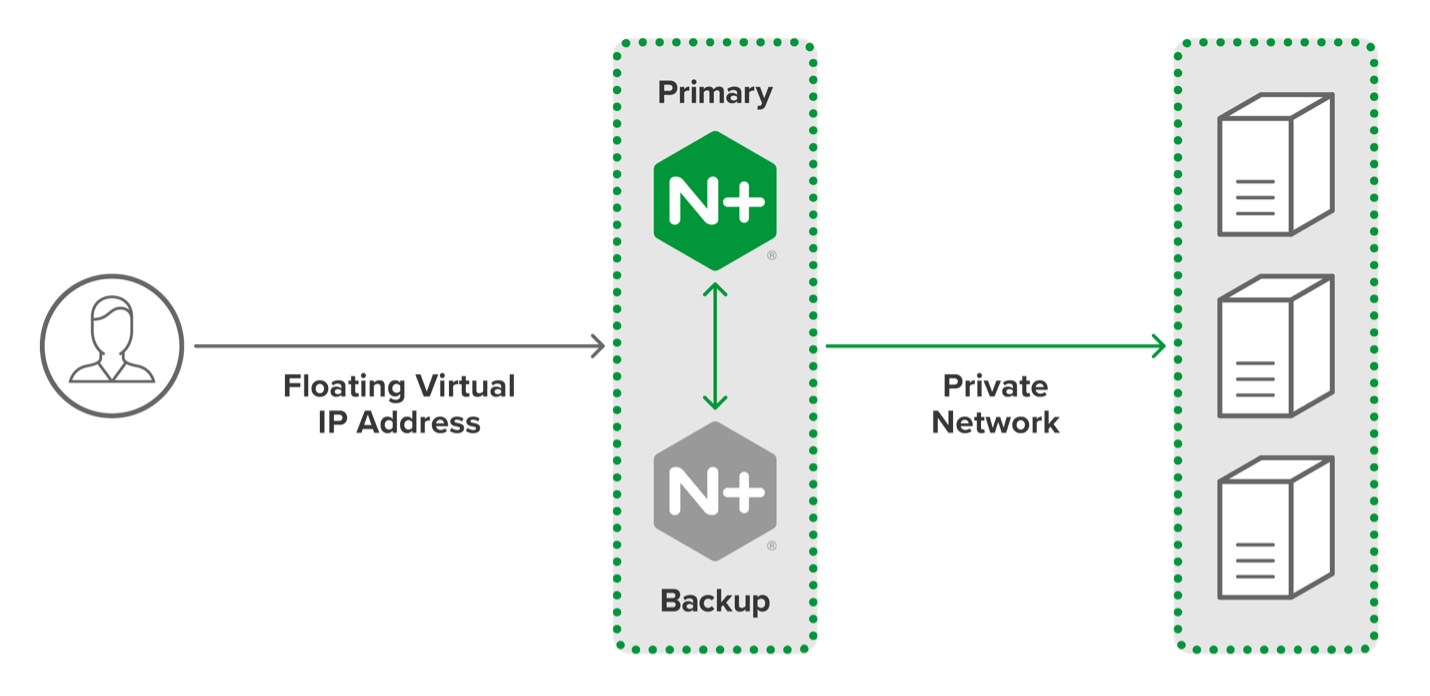
Dieses Diagramm zeigt einen Aktiv-Passiv-HA-Cluster aus zwei NGINX Plus-Servern. NGINX unterstützt außerdem Aktiv-Aktiv- und andere HA-Konfigurationen.
Wie wird Hochverfügbarkeit implementiert?
Redundanz- und Failover-Mechanismen verhindern einzelne Ausfallpunkte, sodass der Ausfall einer Komponente den Betrieb des Gesamtsystems, der Anwendung oder der Funktion nicht beeinträchtigt. Zu den gängigen Mechanismen gehören:
- Redundante Komponenten – Setzen Sie innerhalb des Systems mehrere Server, Netzwerkverbindungen, Speichersysteme und Stromversorgungen ein. Fällt eine Komponente aus, übernimmt eine andere unterbrechungsfrei.
- Überwachung und Warnmeldungen – Kontinuierliche Überwachung von Leistung und Verfügbarkeit. Wird ein Ausfall oder ein anderes Problem erkannt, wird eine Warnmeldung ausgegeben. Systemadministratoren können Probleme schnell erkennen und beheben und so das Risiko von Ausfallzeiten reduzieren.
- Lastverteilung – Ein oder mehrere spezialisierte Server fangen Anfragen ab, die für eine Gruppe von (Backend-)Systemen bestimmt sind, und verteilen den Datenverkehr für eine optimale Leistung auf diese Systeme. Fällt ein Backend-System aus, leiten die Load Balancer eingehende Anfragen automatisch an die anderen Systeme weiter.
- Failover-Mechanismen – Implementieren Sie Aktiv-Passiv- oder Aktiv-Aktiv-Konfigurationen beziehungsweise Failover-Cluster, damit bei Ausfall eines Systems ein anderes mit minimaler Unterbrechung übernehmen kann.
- Sicherungs- und Wiederherstellungssysteme – Stellen Sie sicher, dass Daten und Anwendungen im Falle eines Ausfalls schnell wiederhergestellt werden können. Die Systeme können hybrid, an verschiedenen Standorten, cloudbasiert oder nach einem Ausfall schnell wieder in Betrieb genommen werden.
So unterstützen Sie Hochverfügbarkeit
Welche Dienste und Ressourcen Sie zur Gewährleistung von Hochverfügbarkeit (HA) bereitstellen müssen, hängt von der Art des Systems, der Art der Hochverfügbarkeit und den spezifischen Anforderungen Ihres Unternehmens ab. Zu den unterstützenden Komponenten gehören:
- Technischer Support – Die erste Anlaufstelle für Unternehmen, die Unterstützung bei ihren HA-Systemen benötigen. Speziell geschulte Supportmitarbeiter können bei der Fehlersuche, Diagnose und Behebung von Problemen helfen. Darüber hinaus können sie Empfehlungen zu bewährten Verfahren geben, um eine hohe Verfügbarkeit aufrechtzuerhalten.
- Wartung und Upgrades – Damit HA-Systeme betriebsbereit und sicher bleiben, müssen sie regelmäßig gewartet und mit den neuesten verfügbaren Softwareversionen betrieben werden.
- Notfallwiederherstellungsplanung – Entscheidend für Organisationen, die Systeme schnell wiederherstellen müssen. Vorab festgelegte und dokumentierte Verfahren sorgen dafür, dass sich Systemadministratoren in Notfällen nicht an Lösungen erinnern oder spontan welche entwickeln müssen.
- Dokumentation und Schulung – Unterstützt Systemadministratoren dabei, ihre Hochverfügbarkeitssysteme zu verwalten. Die Dokumentation kann Best Practices, Anleitungen und Schulungen umfassen.
Bewährte Verfahren: Hochverfügbarkeit
Die Einhaltung bewährter Verfahren verbessert die betriebliche Leistung und minimiert kostspielige Ausfallzeiten. Diese allgemeinen Best Practices können an die Systeme, Standorte und gewünschten Ergebnisse eines Unternehmens angepasst werden.
- Redundanz integrieren – Jede Ebene des Systems, von den Hardwarekomponenten bis hin zu den Netzwerkverbindungen, ist redundant ausgelegt, sodass das System auch beim Ausfall einer Komponente weiterhin wie vorgesehen funktioniert.
- Datenverkehr per Lastenausgleich verteilen – Indem Sie eingehende Anfragen auf mehrere Systeme verteilen, ermöglichen Sie es den weiterhin betriebsbereiten Systemen, die Aufgaben zu übernehmen, wenn ein System ausfällt.
- Leistung und Verfügbarkeit überwachen – Durch kontinuierliche Überwachung und Warnmeldungen lassen sich Probleme schneller erkennen und beheben.
- Failover-Mechanismen regelmäßig testen und validieren – Durch routinemäßige Tests lässt sich feststellen, ob Failover-Mechanismen bei einer Störung weiterhin zuverlässig eine Funktion übernehmen können.
- Sicherungs- und Wiederherstellungsverfahren – Stellen Sie sicher, dass Daten und Anwendungen im Falle eines Ausfalls schnell wiederhergestellt werden können.
- Systeme regelmäßig aktualisieren und warten – So bleiben Anwendungen und Systeme betriebsbereit und sicher.
- Mitarbeitende schulen – Regelmäßige Tests und die Festigung von Abläufen müssen zum Standardverfahren gehören, insbesondere für Personen und Teams, die für Hochverfügbarkeit (HA) verantwortlich sind.
- Cloud-Lösungen in Betracht ziehen – Cloud-Speicher und Notfallwiederherstellung sorgen dafür, dass Systeme unabhängig vom Ort des Ausfalls weiterbetrieben werden können.
- Sicherheit überwachen – Implementieren Sie Maßnahmen, die Datenschutzverletzungen oder den Zugriff böswilliger Akteure bzw. unbefugter Benutzer auf Systeme verhindern.