Bewertung von Methoden und Technologien für die Einführung von Zero Trust
Von Mudit Tyagi und Ken Arora
Ausgehend vom „Warum“ – den Leitprinzipien1 – von Zero Trust stellt sich als Nächstes die Frage nach dem „Wie“ – den Methoden und Technologien zur Umsetzung dieser Prinzipien.
Im weitesten Sinne können Zero-Trust-Prinzipien auf den gesamten Lebenszyklus der Anwendungsentwicklung angewendet werden, einschließlich des Systemdesigns, der verwendeten Hardwareplattformen und der Beschaffungsverfahren.2 Dieses Dokument befasst sich jedoch mit den operativen Aspekten der Implementierung von Zero Trust zum Schutz von Anwendungen und Daten während der Laufzeit.
Techniken und Technologien
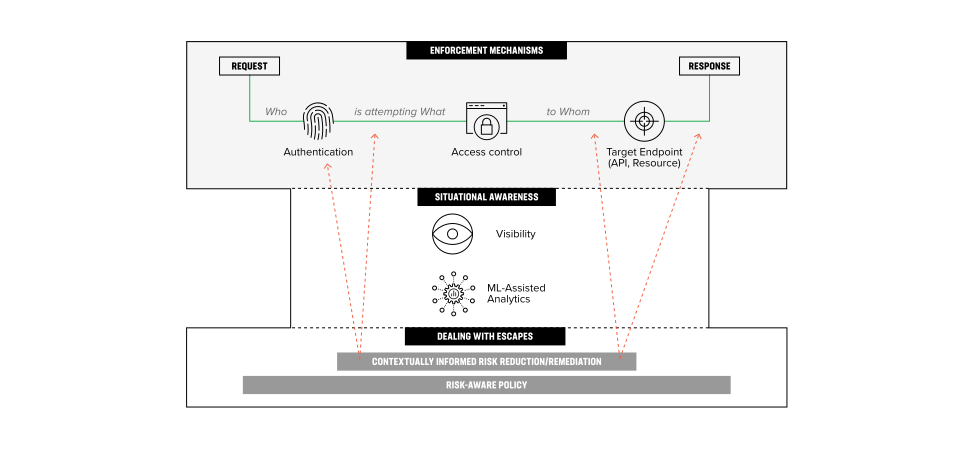
Im Großen und Ganzen setzt Zero-Trust-Sicherheit Technologien ein, um eines von drei klar definierten Zielen zu erreichen:
- Transaktionsbezogene Einschränkungen durchsetzen: Wer darf Was mit Wem tun.
- Vermitteln Sie dem menschlichen Systembediener ein Lagebild.
- Führen Sie weitergehende Maßnahmen zur Risikominderung bzw. -behebung durch, die auf den durch maschinelles Lernen (ML) unterstützten Verdachtsindikatoren und dem Risiko-Ertrags-Profil der betreffenden Transaktion(en) basieren.
Die folgende Grafik veranschaulicht dieses übergreifende transaktionsbasierte Zero-Trust-Sicherheitsmodell. In den folgenden Abschnitten werden die einzelnen Technologieklassen näher erläutert.
Durchsetzung: Authentifizierung und Zugriffskontrolle
Motivationen
Die ersten beiden Technologien – Authentifizierung und Zugriffskontrolle – sind eng miteinander verknüpft und leiten sich unmittelbar aus den Prinzipien „explizit verifizieren“ und „geringstmögliche Berechtigungen“ ab, da diese Technologien entscheidend dafür sind, durchzusetzen, „wer was tun darf“. Ausgereiftere Implementierungen der Authentifizierung überwachen fortlaufend das Verhalten eines Akteurs und folgen damit dem Grundsatz der „kontinuierlichen Bewertung“.
Authentifizierung
Bei Authentifizierungstechnologien geht es darum, Vertrauen in eine bestätigte Identität zu schaffen: Wer führt eine Transaktion durch? Der Authentifizierungsprozess besteht aus drei Komponenten:
- Der Akteur gibt eine Erklärung bzw. Behauptung zu seiner Identität ab.
- Es liegen Daten vor, die in der Regel vom Akteur bereitgestellt werden und die Richtigkeit der Erklärung belegen.
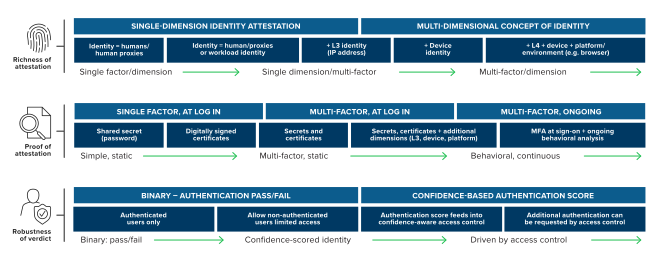
- Das System trifft eine Einschätzung oder Entscheidung darüber, wie wahrscheinlich es ist, dass die Bestätigung zutrifft – dass der Akteur tatsächlich die Person ist, für die er sich ausgibt. Die folgende Grafik veranschaulicht die verschiedenen Aspekte der Authentifizierung und die jeweiligen Reifegradmodelle. Anschließend werden die einzelnen Aspekte ausführlicher erläutert.
Attestierung
Die grundlegendste Form der Attestierung wird häufig als „Benutzer“ bezeichnet – ein Mensch oder ein im Auftrag eines Menschen handelnder Agent, der eine Transaktion durchführen möchte. Wird Zero Trust jedoch innerhalb einer Anwendung eingesetzt, kann ein Akteur auch eine Workload sein (etwa ein Prozess, Dienst oder Container), weshalb das allgemeine Identitätskonzept solche Akteure einschließen sollte. In anderen Fällen umfasst der Begriff Wer nicht nur den Menschen oder die Workload, sondern auch zusätzliche Aspekte oder Dimensionen der Identität. Aus dieser Perspektive können weitere Identitätsdimensionen das Gerät oder die Plattform des Benutzers bzw. der Workload, das für die Interaktion verwendete Ökosystem oder den Standort des Agenten umfassen. Beispielsweise kann eine Benutzerin namens „Alice“ einen mit „ABC- 0001“ gekennzeichneten PC verwenden und dabei eine bestimmte, per Fingerprinting identifizierte Browserinstanz nutzen, wobei die Verbindung von der IPv4-Adresse 10.11.12.13 stammt.
Identitätsnachweis
Einige Systeme erlauben nicht authentifizierten Benutzern, die mitunter als „Gäste“ oder „anonyme“ Benutzer bezeichnet werden, eine begrenzte Anzahl von Transaktionen durchzuführen. Bei solchen Systemen sind die zusätzlichen Schritte des Identitätsnachweises und der anschließenden Entscheidung durch das System nicht relevant. Für jede konkret bestätigte Identität werden jedoch üblicherweise die folgenden Methoden verwendet, um diese Bestätigung zu untermauern:
- Kenntnis eines gemeinsamen Geheimnisses, beispielsweise eines Passworts.
- Eine Art Berechtigungsnachweis von einem vertrauenswürdigen Dritten, beispielsweise ein signiertes Zertifikat.
- Überprüfung des Benutzers, der Workload oder der Plattform – entweder automatisiert (z. B. durch Geräte-Fingerprinting) oder aktiv (z. B. durch eine CAPTCHA-Abfrage).
- Metadaten zum Akteur, wie etwa Geolokalisierung, IP-Reputation oder Zugriffszeitpunkt.
- Verhaltensanalyse, beispielsweise passive biometrische Analysen oder Workflow-Muster bei der Interaktion mit Anwendungen.
Wenn ein hohes Maß an Vertrauenswürdigkeit erforderlich ist, werden häufig mehrere Methoden eingesetzt. Dies zeigt sich am Google-BeyondCorp-Modell,3 das eine Multi-Faktor-Authentifizierung (MFA) voraussetzt, bevor Transaktionen mit höherem Wert zugelassen werden. Ausgereiftere Authentifizierungslösungen weisen jeder Identität einen „Vertrauenswert“ zu und legen für jede Transaktionsart ein Mindestvertrauensniveau fest, das sich nach dem Wert und dem Risiko der Transaktion richtet.
Statische vs. dynamische Authentifizierung
Abschließend ist zu beachten, dass einige dieser Methoden keine statischen, einmaligen Maßnahmen sind, sondern gemäß dem Prinzip der „kontinuierlichen Bewertung“ fortlaufend eingesetzt werden können und sollten. In solchen Fällen kann sich der der Identitätsbestätigung zugewiesene Vertrauenswert im Laufe der Zeit erhöhen oder verringern. Beispielsweise können sich der Browser-Fingerabdruck oder die IP-Adresse innerhalb einer einzelnen Benutzersitzung ändern, was als verdächtig eingestuft werden und das Vertrauen mindern könnte. Werden hingegen im Verlauf einer Sitzung weitere Daten über das Verhalten des Akteurs erfasst, kann der Vertrauenswert steigen oder sinken – je nachdem, wie das aktuelle Verhalten im Vergleich zu früheren Beobachtungen ausfällt.
In fortschrittlicheren Systemen können dynamische Authentifizierung und Zugriffskontrolle Hand in Hand arbeiten. Auf der ersten Ebene dieses Zusammenspiels kann die Zugriffskontrollrichtlinie, wie bereits erwähnt, für verschiedene Transaktionsklassen einen Mindestwert für den Vertrauensgrad festlegen. Auf der nächsten Ebene kann das Zugriffskontroll-Subsystem dem Authentifizierungs-Subsystem Rückmeldung geben und in der Regel eine zusätzliche Authentifizierung anfordern, um den Vertrauensgrad auf den erforderlichen Mindestwert anzuheben.
Zugriffskontrolle
Nachdem mithilfe von Authentifizierungsverfahren festgestellt wurde, wer an einer Transaktion beteiligt ist, stellen sich als Nächstes die Fragen: Was darf dieser Akteur tun? Und bei wem? Dies fällt in den Zuständigkeitsbereich von Technologien zur Zugriffskontrolle.
Um eine Analogie zur physischen Sicherheit zu ziehen, stellen Sie sich vor, Sie wollten einen Militärstützpunkt besuchen. Nachdem die Wachen zweifelsfrei festgestellt haben, ob Sie Zivilist, Politiker oder Soldat sind, würden sie anhand dieser Feststellung entscheiden, welche Gebäude Sie betreten dürfen und ob Sie in die jeweiligen Gebäude, zu denen Sie Zutritt haben, eine Kamera mitnehmen dürfen. Die Richtlinie, die diese Entscheidungen regelt, könnte sehr allgemein gehalten sein und für alle Gebäude gelten (zum Beispiel: „Politiker dürfen jedes Gebäude betreten“) oder detaillierter ausfallen (etwa: „Politiker dürfen nur die Gebäude <A> und <B> betreten, aber nur in <A> Kameras mitnehmen“).
Auf den Cybersicherheitskontext übertragen sollten Zugriffskontrollverfahren dem Zero-Trust-Prinzip der „geringsten Privilegien“ entsprechen. Mit anderen Worten: Eine optimale Zugriffskontrollrichtlinie würde ausschließlich genau die Berechtigungen gewähren, die der Akteur benötigt, und alle anderen verweigern. Darüber hinaus würde eine ideale, robuste Richtlinie ein bestimmtes Mindestmaß an Vertrauen in die Authentizität der Identität des Akteurs voraussetzen, wobei der Vertrauensschwellenwert für jede gewährte Berechtigung einzeln festgelegt würde.
Daher lässt sich der Wert einer Zugriffskontrolllösung daran messen, wie gut sie diesen Idealen entspricht. Insbesondere muss eine Zero-Trust-Sicherheitslösung eine Zugriffskontrolle umfassen und die dafür eingesetzte Technologie anhand der nachfolgend dargestellten und anschließend beschriebenen Dimensionen bewerten.
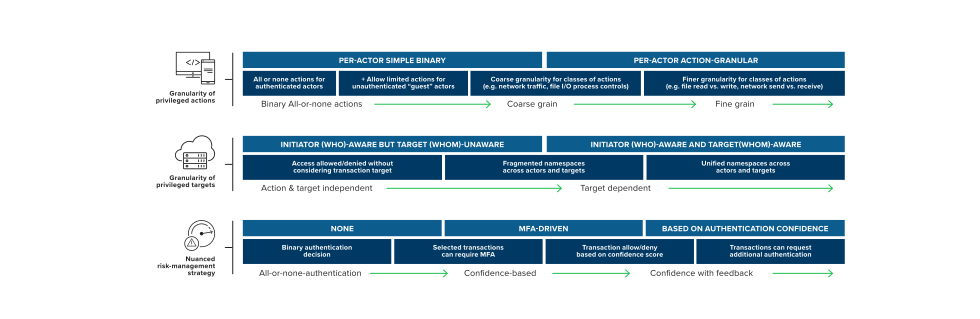
- Wie granular sind die Zugriffsberechtigungen?
- Wie detailliert ist die Aktion – also das „Was“ der Transaktion? Handelt es sich um:
- Binär: „Alle“ Transaktionen zulassen oder „keine“. Übertragen auf das Beispiel des Militärstützpunkts würde dies bedeuten: „Alle Soldaten dürfen jedes Gebäude betreten und dort tun, was sie wollen“ und „Zivilisten dürfen kein Gebäude betreten“.
- Grobgranular: Granularität auf Ebene des API-Endpunkts oder der „Art“ der Transaktion (z. B. Datei-E/A, Netzwerkkommunikation und Prozesssteuerung). In unserem Beispiel ließe sich damit die zulässige Aktion differenzierter festlegen, etwa: „Politiker dürfen Gebäude betreten, aber keine Fotos machen.“
- Fein: Auf der Ebene der Sub-API (d. h. abhängig von den Parametern oder der Version der API) oder des „Untertyps“ einer Transaktion (z. B. schreibgeschützter Datei-E/A oder ausschließlichem TCP-Empfang). Um noch einmal auf unsere Analogie zurückzukommen: Dies würde feiner abgestufte Kontrollen ermöglichen, etwa „Zivilisten dürfen Gebäude nur in Begleitung eines Soldaten betreten“.
- Gibt es eine Granularität hinsichtlich des Ziels der Aktion – also des Wem in der Transaktion? Handelt es sich um:
- Nicht zielobjektspezifisch: Die Zugriffssteuerungsrichtlinie berücksichtigt das Zielobjekt der Aktion nicht. In unserem Beispiel entspräche dieser Ansatz einer Granularität, bei der der Zutritt zu einigen Gebäuden gestattet wird, zu anderen jedoch nicht – wobei die Gebäude das Zielobjekt der Aktion „Betreten“ sind.
- Zielgranular, Infrastrukturebene: Die Zugriffssteuerungsrichtlinie kann das Ziel der Aktion berücksichtigen, verwendet dafür jedoch ein infrastrukturspezifisches Tag bzw. Label, beispielsweise die IP-Adresse, den DNS-Namen oder den Namen des Kubernetes-Containers (K8S) des Ziels. Dadurch könnte die Richtlinie einzelne Gebäude unterscheiden, allerdings könnte jeder Militärstützpunkt eine andere Namenskonvention für Gebäude verwenden.
- Zielgranular, identitätsbasiert: Die Zugriffssteuerungsrichtlinie kann das Ziel der Aktion einbeziehen und es anhand desselben Identitätsnamensraums (z. B. SPIFFE) identifizieren, der auch für den Akteur (das Wer) verwendet wird. Der Vorteil gegenüber dem vorherigen Ansatz besteht darin, dass alle Militärstützpunkte ein einheitliches Schema zur Identifizierung von Gebäuden verwenden würden, wodurch die Richtlinie leichter übertragbar wäre.
- Wie detailliert ist die Aktion – also das „Was“ der Transaktion? Handelt es sich um:
- Wie geht die Zugriffskontrolllösung mit dem Konzept unterschiedlich riskanter Aktionen um?
- Nicht risikobewusst: Die Zugriffskontrolllösung behandelt bei der Entscheidung, ob eine Aktion zugelassen oder verweigert wird, alle Zugriffsberechtigungen gleich.
- Risikomanagement mittels MFA: Die Zugriffskontrolllösung steuert das Risiko, indem sie es ermöglicht, in der Richtlinie festzulegen, dass für bestimmte zulässige Transaktionen dennoch eine Multi-Faktor-Authentifizierung erforderlich ist, abhängig von dem an der Transaktion beteiligten Akteur (Wer), der Aktion (Was) oder dem Ziel (Wem).
- Risikomanagement durch Vertrauensniveau: Die Zugriffskontrolllösung steuert Risiken, indem sie es ermöglicht, in der Richtlinie festzulegen, dass für jede Transaktion weiterhin ein Mindestmaß an Vertrauen in die Authentizität des Akteurs erforderlich sein kann, abhängig von der Aktion (Was) und dem Ziel (Wem) der Transaktion. MFA kann das Vertrauensniveau erhöhen, wobei auch andere Mittel eingesetzt werden können. In anderen Fällen kann die Transaktion vollständig abgelehnt werden, wenn sie von hohem Wert ist und die Authentizität des Akteurs nicht mit ausreichender Sicherheit festgestellt werden kann.
Unter Berücksichtigung des Grundsatzes der „kontinuierlichen Bewertung (und Neubewertung)“ sollte sich jede Einschätzung der Authentizität des Akteurs im Laufe der Zeit anpassen. Bei einer einfachen Lösung kann dies lediglich durch ein Zeitlimit erfolgen; in komplexeren Systemen könnte sich das Vertrauensniveau anhand von Beobachtungen des Verhaltens des Akteurs im Laufe der Zeit verändern.
Situationsbewusstsein: Beweggründe für Transparenz und ML-gestützte kontextbezogene Analysen
Wenn Authentifizierung und Zugriffskontrolle Umsetzungen der Grundsätze „stets überprüfen“ und „geringstmögliche Berechtigungen“ sind, dann bilden Transparenz und Kontextanalyse die Grundlage für die Prinzipien „kontinuierlich bewerten“ und „von einer Kompromittierung ausgehen“.
Transparenz ist die notwendige Voraussetzung für Analysen – ein System kann nicht abwehren, was es nicht erkennen kann. Daher ist die Wirksamkeit einer Zero-Trust-Sicherheitslösung direkt proportional zur Tiefe und Breite der Telemetriedaten, die aus dem Systembetrieb und externen Kontexten erfasst werden können. Eine moderne Transparenzinfrastruktur kann jedoch weitaus mehr potenziell nützliche Daten, Metadaten und Kontextinformationen bereitstellen, als ein Mensch ohne technische Unterstützung innerhalb eines angemessenen Zeitraums verarbeiten könnte. Da sowohl mehr Daten als auch die Fähigkeit gewünscht sind, diese Daten schneller zu Erkenntnissen zu verdichten, ist die maschinelle Unterstützung der menschlichen Bediener eine zentrale Anforderung.
Diese Unterstützung wird in der Regel mithilfe automatisierter Algorithmen umgesetzt, deren Spektrum von regelbasierten Analysen über statistische Methoden bis hin zu fortschrittlichen Algorithmen für maschinelles Lernen reicht. Diese Algorithmen haben die Aufgabe, die Flut an Rohdaten in verwertbare und praktisch nutzbare Lageinformationen zu überführen, anhand derer menschliche Bediener die Situation beurteilen und bei Bedarf Abhilfemaßnahmen ergreifen können. Aus diesem Grund gehen ML-gestützte Analysen und Transparenz Hand in Hand.
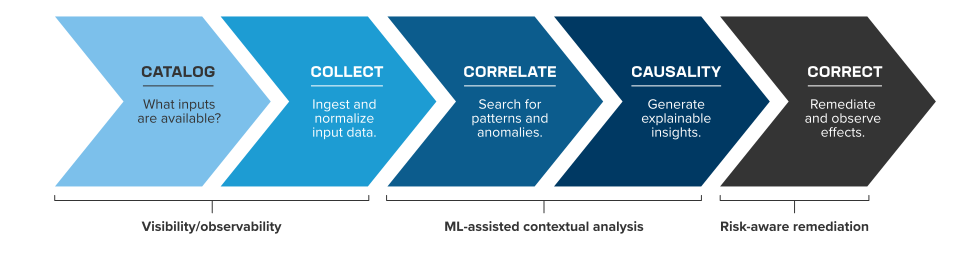
Die allgemeine Verarbeitungskette von Rohdaten (Transparenz) bis hin zu Maßnahmen (Behebung) ist nachfolgend dargestellt:
Transparenz
Sichtbarkeit ist die Umsetzung – also das „Wie“ – des Zero-Trust-Prinzips der „kontinuierlichen Bewertung“. Dazu gehören die Pflege eines Bestandsverzeichnisses der verfügbaren Dateneingaben (Katalogisieren) sowie Echtzeit-Telemetrie und die Aufbewahrung historischer Daten (Erfassen).
Bei der Bewertung des Reifegrads einer Zero-Trust-Implementierung im Bereich Sichtbarkeit sollten vier Faktoren berücksichtigt werden:
- Latenz: Wie echtzeitnah sind die Daten?
Die Latenz bestimmt die Mindestzeit, innerhalb derer auf eine potenzielle Bedrohung reagiert werden kann. Die Latenz einer Zero-Trust-Lösung sollte in Sekunden oder weniger gemessen werden. Andernfalls kommt jede Analyse – unabhängig von ihrer Genauigkeit – höchstwahrscheinlich zu spät, um die Auswirkungen des Angriffs zu verhindern, etwa die Exfiltration oder Verschlüsselung von Daten oder die Nichtverfügbarkeit aufgrund einer Ressourcenüberlastung. Ausgereiftere Systeme können sowohl synchrone als auch asynchrone Gegenmaßnahmen ermöglichen. Bei einer synchronen Gegenmaßnahme wird der Abschluss der Transaktion verhindert, bis vollständige Transparenz hergestellt und die Analyse abgeschlossen ist. Da synchrone Gegenmaßnahmen die Transaktion wahrscheinlich verzögern, bleibt dieser Betriebsmodus besonders ungewöhnlichen oder riskanten Transaktionen vorbehalten. Bei allen anderen Transaktionen können hingegen Telemetriedaten gesendet und asynchron analysiert werden. - Nutzbarkeit: Wie einfach können die Daten verarbeitet werden?
Dieser Aspekt ist relevant, wenn Daten aus mehreren Quellen oder von unterschiedlichen Arten von Datensensoren stammen, was häufig der Fall ist. Dieser Faktor lässt sich in der Regel in zwei Teilaspekte untergliedern.
Auf syntaktischer Ebene geht es darum, wie die Daten extrahiert und dargestellt werden können. Wenn beispielsweise die Reputation einer Quell-IP aus einer Quelle als Textfeld (etwa „bösartig“, „verdächtig“, „unbekannt“ usw.) in einer Syslog-Nachricht und aus einer anderen Quelle als numerisches, binär codiertes Feld in einer Datendatei eingeht, sollte eine kanonische Darstellung festgelegt werden. Die eingehenden Daten müssen serialisiert werden, um sie zu extrahieren und in diese Darstellung umzuwandeln.
Auf semantischer Ebene können sich verschiedene Quellen nicht nur hinsichtlich ihrer Syntax und Übertragung, sondern auch hinsichtlich ihrer Semantik unterscheiden. Um erneut das Beispiel der IP-Reputation aufzugreifen: Ein Anbieter kann einen Bedrohungswert als Zahl angeben, während ein anderer Anbieter die IP einer Kategorie wie „TOR-Knoten“, „DNS-Steuerung“ oder „Phishing“ zuordnet. Die Sichtbarkeitslösung muss außerdem einen Mechanismus bereitstellen, mit dem die eingehenden Daten in eine einheitliche Syntax überführt werden können. - Vollständigkeit: Wie breit und detailliert sind die verfügbaren Daten?
Ein wesentlicher Vorteil einer hochwertigen Transparenzlösung besteht darin, verdächtige Aktivitäten als Anzeichen für einen möglichen Sicherheitsverstoß erkennen zu können. Damit dies effektiv gelingt, muss die Lösung Telemetriedaten aus allen relevanten „Ebenen“ der Anwendungsbereitstellung empfangen: natürlich aus der Anwendung selbst, aber auch aus der Anwendungsinfrastruktur, der Netzwerkinfrastruktur, sämtlichen Diensten, die auf die Anwendung angewendet oder von ihr genutzt werden, und sogar aus Ereignissen auf dem Clientgerät. Wird beispielsweise festgestellt, dass sich ein Benutzer über ein neues, bislang unbekanntes Gerät anmeldet, kann dies für sich genommen bereits leicht verdächtig sein. In Verbindung mit Netzwerkinformationen, etwa einer GeoIP-Zuordnung zu einem anderen Land, steigt der Verdachtsgrad jedoch weiter an. Dieser Verdachtsgrad äußert sich in einem niedrigeren Vertrauenswert für die Identität des Benutzers. Versucht dieser Akteur im Rahmen einer Zero-Trust-Sicherheitsrichtlinie, eine Transaktion mit hohem Wert durchzuführen, beispielsweise Geld auf ein ausländisches Konto zu überweisen, kann die Zugriffskontrolllösung die Transaktion aufgrund des niedrigen Vertrauenswerts blockieren.
Im Hinblick auf den Zero-Trust-Ansatz gilt: Je detaillierter und umfassender die Transparenzlösung ist, desto effektiver kann das System Transaktionen angemessen einschränken und Sicherheitsverstöße erkennen. - Governance: Wie gut werden gesetzliche und lizenzrechtliche Anforderungen an die Datennutzung unterstützt?
Jede Datenerhebung muss den gesetzlichen und lizenzrechtlichen Anforderungen an die Sicherheit, Aufbewahrung und Nutzung von Daten entsprechen. Daher muss eine robuste Sichtbarkeitslösung all diese Anforderungen erfüllen. Die sich aus der Governance ergebenden Einschränkungen für die Datennutzung müssen bei einer Zero-Trust-Sichtbarkeitslösung berücksichtigt werden. Wenn beispielsweise eine IP-Adresse als personenbezogene Information (Personally Identifiable Information, PII) gilt, müssen bei der Nutzung und langfristigen Speicherung von IP-Adressen zu Analysezwecken die zulässigen Verwendungszwecke der IP-Adressen berücksichtigt werden.
Kontextbezogene Analyse mit maschineller Unterstützung
Neben der Transparenz sind für die Umsetzung einer „kontinuierlichen Bewertung“ auch Analysewerkzeuge erforderlich, die eine aussagekräftige Bewertung ermöglichen – also eine Bewertung, die sich durch eine Zero-Trust-Lösung operationalisieren lässt.
Ein wichtiger Aspekt bei der Analyse sind Umfang und Bandbreite der Eingabedaten. Die Eingaben für die Analysealgorithmen können auf einen einzelnen Datenstrom aus einer einzigen Quelle beschränkt sein oder mehrere Datenströme aus verschiedenen Datenquellen und sämtlichen Ebenen der Infrastruktur und Anwendung umfassen.
- Die grundlegendste Kontextualisierung beschränkt sich auf einen einzelnen „Typ“ oder „Datenstrom“ (beispielsweise einen Strom von Ereignissen mit „Informationen zur Benutzeranmeldung einschließlich Uhrzeit und Quell-IP-Adresse“), üblicherweise unter Einbeziehung historischer Zusammenhänge und/oder von Daten mehrerer Benutzer. Diese Analyse kann grundlegende Erkenntnisse liefern, etwa: „Dieser Benutzer <X> hat sich zu dieser Tageszeit noch nie angemeldet“ oder „Dieser Benutzer <X> scheint sich immer unmittelbar nach dem Benutzer <Y> anzumelden.“ Ersteres kann Zweifel an der Identität aufkommen lassen; Letzteres könnte auf ein übergeordnetes, möglicherweise bösartiges Muster hindeuten.
- Eine weiterführende Kontextualisierung berücksichtigt den zeitlichen und instanzübergreifenden Rahmen nicht nur für einen einzelnen „Typ“ von Daten, sondern stellt auch zeitliche Zusammenhänge zwischen verschiedenen „Typen“ oder „Datenströmen“ her. Ein Beispiel hierfür wäre die Korrelation der Benutzeranmeldedaten mit bestimmten Aktionen auf der Anwendungsebene (etwa Geldüberweisungen oder Aktualisierungen von E-Mail-Kontaktdaten) oder auf der Netzwerkebene (etwa einer IP-basierten Geolokalisierungsabfrage).
Ein zweiter, im Zero-Trust-Framework besonders relevanter Aspekt der Analyse ist der Umgang mit der Menge und Geschwindigkeit der aufgenommenen Daten, deren Verarbeitung die Fähigkeiten jedes Menschen übersteigen wird. Daher ist eine Form maschineller Unterstützung erforderlich, um für Menschen verständliche Erkenntnisse zu gewinnen. Auch hier lässt sich der Entwicklungsgrad dieser Unterstützung als stufenweise Weiterentwicklung beschreiben.
- Nur Visualisierung: Der erste Schritt besteht in der reinen Darstellung von Statistiken und Ereignissen, üblicherweise über Dashboards in einem Verwaltungsportal. Die dargestellten Informationen basieren auf erfassten Datenströmen (in der Regel entweder einer Zeitreihe oder einem Längsschnitt über Benutzer bzw. Transaktionen innerhalb eines festen Zeitfensters). Fortschrittlichere Dashboards ermöglichen das Sortieren und Gruppieren der Daten sowie Detailanalysen durch Filterung. In diesem Modell übernimmt der Mensch die gesamte Datenexploration, Priorisierung von Ereignissen, Analyse und Problembehebung, während die Automatisierung hauptsächlich bei der Datenexploration unterstützt.
- Visualisierung plus konfigurierbare statische Regeln: Die häufigste Erweiterung der Visualisierung besteht darin, Menschen die Möglichkeit zu geben, statisch festgelegte Regeln für Warnmeldungen oder Abhilfemaßnahmen zu definieren. Beispiele für solche Regeln wären „Benachrichtige <John>, wenn <die CPU-Auslastung über einen Zeitraum von 5 Minuten 80 % überschreitet>“ oder „Verlange <MFA per E-Mail>, wenn <API [Y] aufgerufen wird und das Land nicht [Vereinigte Staaten] ist>“. Diese Regeln können auf vordefinierte, vom Lösungsanbieter festgelegte Regeln beschränkt sein. Fortschrittlichere regelbasierte Subsysteme können jedoch auch benutzerdefinierte Regeln zulassen, die von einem SecOps-Techniker erstellt werden. In beiden Fällen werden die angewendeten Regeln in der Regel über die Konfiguration gesteuert (und bei Bedarf definiert).
- Visualisierung mit ML-Unterstützung: Auf der nächsten Stufe kommen fortschrittlichere Verfahren zum Einsatz, die Verhaltensanomalien und/oder Transaktionen erkennen, deren Muster mit denen zuvor identifizierter bösartiger Transaktionen übereinstimmen. Obwohl zahlreiche Verfahren eingesetzt werden (und eine ausführliche Erörterung der technischen und geschäftlichen Abwägungen den Rahmen dieses Dokuments sprengen würde), sind einige wichtige Punkte zu beachten:
- Erforderlicher menschlicher Aufwand: Einige ML-Techniken erfordern ein „Training“ (auch überwachtes Lernen genannt). Das bedeutet, dass ein ausreichend großer Datenbestand mithilfe eines vertrauenswürdigen, zuverlässigen „Klassifikators“ vorab kategorisiert werden muss. Um eine vertrauenswürdige Kategorisierung zu gewährleisten, handelt es sich bei diesem „Klassifikator“ häufig um eine Person oder eine Gruppe von Personen. In solchen Fällen sollte der erforderliche menschliche Aufwand berücksichtigt werden. Andere Techniken (auch unüberwachtes Lernen genannt) erkennen selbstständig und ohne menschliches Zutun Anomalien und/oder Muster.
- Erklärbarkeit: Die Ausgabe(n) eines maschinellen Lernsystems ergeben sich aus der Auswertung der Eingabedaten anhand eines Modells. Dieses Modell kann auf einer Reihe einfacher, leicht zu beantwortender Fragen basieren, etwa: „Wurde dieser Benutzer im vergangenen Monat auf diesem Gerät erkannt?“ Es könnte auch auf einer leicht nachvollziehbaren Ähnlichkeit beruhen, beispielsweise: „Dieser Benutzer entspricht dem allgemeinen Muster, das ich bei Benutzern beobachtet habe, die sich nie während der Arbeitszeit anmelden.“ In anderen Fällen kann das Modell darauf basieren, eine komplexe Reihe vektoralgebraischer Operationen auf die Eingabedaten anzuwenden, ohne dass eine übergeordnete Logik leicht erkennbar ist. Dieser letzte Fall ist eindeutig weniger erklärbar – eher eine „Blackbox“ – als die beiden vorherigen Beispiele. In manchen Fällen ist die Erklärbarkeit ein wichtiger Faktor für das menschliche Verständnis oder die Überprüfbarkeit. In solchen Fällen wird ein erklärbares Modell einem undurchschaubaren Modell deutlich vorgezogen.
- Verfügbarkeit eines Konfidenzwerts: Wie bereits erwähnt, ist eine Kennzahl, die angibt, wie sicher sich das Modell bei einer Entscheidung ist – also einen Eindruck von der relativen Wahrscheinlichkeit eines falsch positiven oder falsch negativen Ergebnisses vermittelt –, häufig sehr nützlich. Bei manchen Algorithmen ergibt sich ein Konfidenzwert ganz natürlich als Ausgabe; bei anderen, etwa regelbasierten Algorithmen, müsste ein Konfidenzniveau ausdrücklich als eine der Ausgaben festgelegt werden. In beiden Fällen sind Algorithmen, die einen Konfidenzwert liefern können, robuster als solche, die dies nicht können.
Wie beim regelbasierten Ansatz kann die Unterstützung durch maschinelles Lernen ausschließlich zur Erkennung dienen oder mit einer automatischen Behebung verknüpft werden. Darüber hinaus kann sie in Verbindung mit einem regelbasierten System eingesetzt werden, wobei das „Urteil“ (bzw. die Einschätzung oder Konfidenz) des ML-Modells als Eingabe für eine Regel dienen kann, beispielsweise: „Aktion <X> ausführen, wenn <ML-Auswertung [bot_detector_A] einen Bot mit einer Konfidenz von über 90 % meldet>.“
Umgang mit durchgerutschten Bots: Automatisierte risikobasierte Abhilfemaßnahmen
Der letzte Grundsatz des Zero-Trust-Ansatzes lautet: „Von einer Sicherheitsverletzung ausgehen.“ Um dies einzuordnen und klarzustellen: Ordnungsgemäß implementierte Authentifizierungs- und Zugriffskontrollverfahren verhindern die überwältigende Mehrheit böswilliger Transaktionen wirksam. Dennoch sollte man aus übertriebener Vorsicht davon ausgehen, dass die Durchsetzungsmechanismen für Authentifizierung und Zugriffskontrolle irgendwann von einem hinreichend motivierten oder glücklichen Angreifer überwunden werden. Die Erkennung von Sicherheitsverletzungen, die erforderlich ist, um zeitnah auf solche Durchbrüche zu reagieren, setzt Transparenz und maschinengestützte Analysen voraus. Da die anderen Durchsetzungsmechanismen gelegentlich überwunden werden, sind Technologien zur Schaffung von Transparenz, die ML-gestützte Kontextanalysen mit Daten versorgen, unverzichtbar für die risikobasierte Behebung als letzte Sicherheitsinstanz des Zero-Trust-Konzepts.
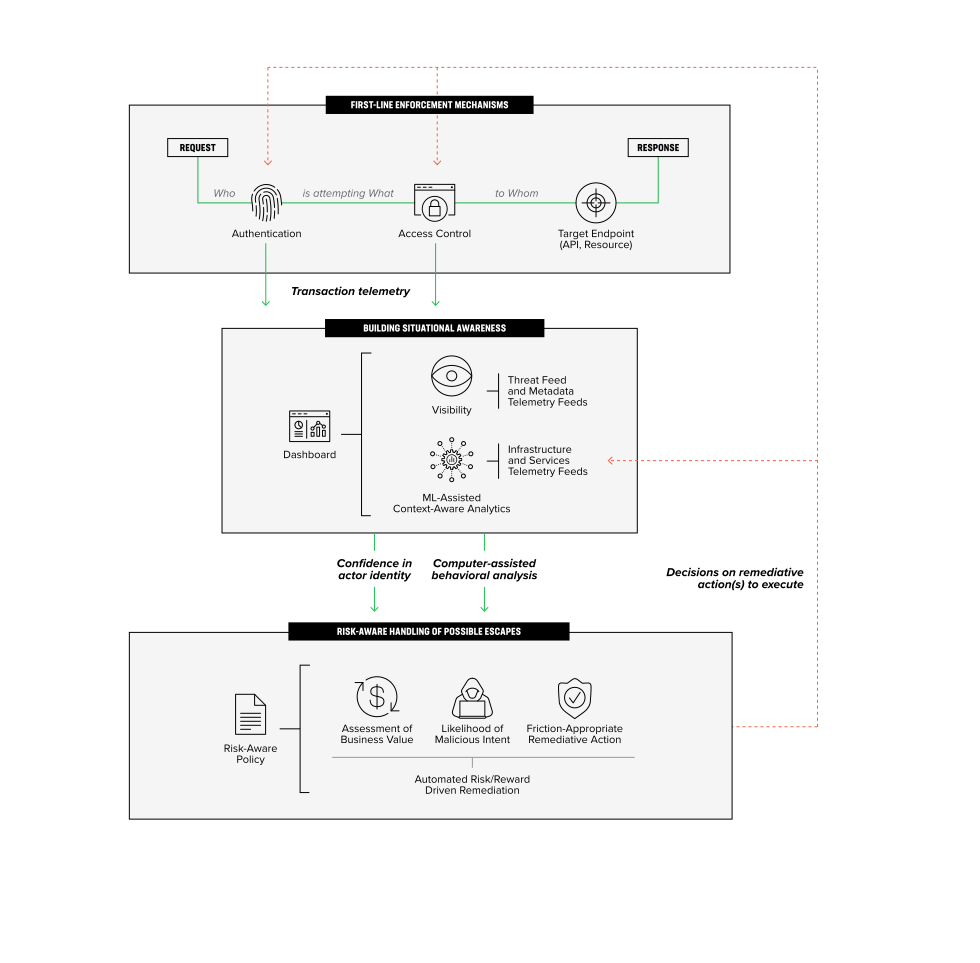
Für Fälle von „falsch-negativen“ Ergebnissen, in denen eine tatsächlich bösartige Transaktion die Authentifizierung und Zugriffskontrolle überwunden hat, sollte als zusätzliche Absicherung ein Mechanismus zur automatisierten risikobasierten Behebung eingesetzt werden. Da diese Technologie jedoch als zusätzliche Absicherung für Transaktionen dient, die die vorherigen Kontrollen erfolgreich durchlaufen haben, besteht ein erhöhtes Risiko, dass ein tatsächlich „richtig-negatives“ Ergebnis (eine gültige, erwünschte Transaktion) fälschlicherweise als „falsch-positives“ Ergebnis (irrtümlich als bösartige Transaktion eingestuft) gekennzeichnet wird. Um dieses Risiko zu mindern, sollten alle Behebungsmaßnahmen, die aufgrund eines Verdachts auf bösartiges Verhalten ausgelöst werden, das weder durch die Authentifizierung noch durch die Zugriffskontrolle erkannt wurde, auf den folgenden drei Faktoren basieren:4
- Geschäftswert der Transaktion: Verschiedene Transaktionen weisen ein unterschiedliches Risiko- und Ertragspotenzial auf. Beispielsweise ist eine Transaktion zur Anzeige eines Bankkontos weniger riskant als eine Transaktion, bei der Geld auf ein ausländisches Konto überwiesen wird. Ebenso dürfte für eine Fluggesellschaft der Kauf eines Tickets einen höheren geschäftlichen Nutzen haben als eine Transaktion, bei der aktuelle Flugverspätungen angezeigt werden. Der Geschäftswert ergibt sich aus dem potenziellen geschäftlichen Nutzen, abgewogen gegen das Risikoprofil der Transaktion. Bei Transaktionen mit geringem Ertrag und hohem Risiko ist es eher vertretbar, etwaige „falsch positive“ Auswirkungen spekulativer Abhilfemaßnahmen in Kauf zu nehmen, als bei Transaktionen mit hohem Ertrag und geringem Risiko, die einen hohen Geschäftswert haben.
- Vertrauen in die Annahme der „Böswilligkeit“: Natürlich sind nicht alle Vorschläge für spekulative Abhilfemaßnahmen gleichwertig. Neben dem oben erwähnten Verhältnis von Risiko und Nutzen ist insbesondere das Vertrauen in die Annahmen bezüglich dieser Transaktion ein weiterer entscheidender Faktor, etwa das Vertrauen in die bestätigte Identität des Akteurs. Vereinfacht gesagt ist die Wahrscheinlichkeit eines „falsch negativen“ Ergebnisses – also die Wahrscheinlichkeit, dass Durchsetzungsmechanismen nicht ausgelöst wurden, obwohl dies hätte geschehen sollen – umgekehrt proportional zum Vertrauen in den Akteur. Da die Verringerung „falsch negativer“ Ergebnisse das Ziel risikobasierter Abhilfemaßnahmen ist, sollte das System umso stärker zur Anwendung solcher Maßnahmen tendieren, je geringer das Vertrauen ist.
- Auswirkungen der Abhilfemaßnahme: Schließlich sind nicht alle Abhilfemaßnahmen binäre Entscheidungen – zulassen oder blockieren. Tatsächlich gibt es eine Vielzahl möglicher Techniken zur Risikominderung. Diese reichen von für den Benutzer sichtbaren Maßnahmen (z. B. der Anforderung zusätzlicher Anmeldedaten bzw. einer MFA oder einer Aufgabe wie einem Captcha) bis hin zu Maßnahmen, die für den Benutzer weitgehend unsichtbar sind (z. B. einer eingehenderen Überprüfung des Datenverkehrs mittels DLP oder einer komplexeren bzw. rechenintensiveren Analyse). Daher sind die Auswirkungen dieser zusätzlichen Formen der Risikominderung – gemessen an den Beeinträchtigungen für den Benutzer und den Betriebskosten für die Anwendung (etwa für DLP oder rechenintensive Analysen) – der dritte zu berücksichtigende Faktor. Abhilfemaßnahmen mit geringen Auswirkungen, die für den Kunden unbemerkt bleiben, sind Maßnahmen mit größeren Auswirkungen und für den Kunden sichtbaren Aufgaben vorzuziehen. Eine vollständige Blockierung der Transaktion ist die am wenigsten attraktive Option. Eine Blockierung kann jedoch angebracht sein, wenn die Gewissheit hoch ist oder wenn bei riskanten Transaktionen die Gewissheit durch die anderen Mechanismen zur Risikominderung nicht ausreichend erhöht werden kann.
Fazit
Zero-Trust-Sicherheit ist eine modernere Weiterentwicklung früherer Sicherheitsansätze wie Defense in Depth. Sie erweitert den bisherigen Stand der Technik durch eine transaktionszentrierte Sicht auf Sicherheit: Wer versucht, was mit wem zu tun? Dieser Ansatz ermöglicht es, nicht nur den externen Zugriff auf eine Anwendung abzusichern, sondern auch das Innere der Anwendung zu schützen.5 Ausgehend von dieser grundlegenden transaktionsbezogenen Sichtweise basiert Zero-Trust-Sicherheit auf einer Reihe von Kernprinzipien, die zum Schutz von Anwendungen in der heutigen komplexeren und anspruchsvolleren Umgebung dienen. Diese Prinzipien werden wiederum einer Reihe von Lösungen oder Methoden auf Subsystemebene zugeordnet, die sie konkret umsetzen. Die Kernprinzipien und ihre Zuordnung zu den Lösungsmethoden werden im Folgenden zusammengefasst.
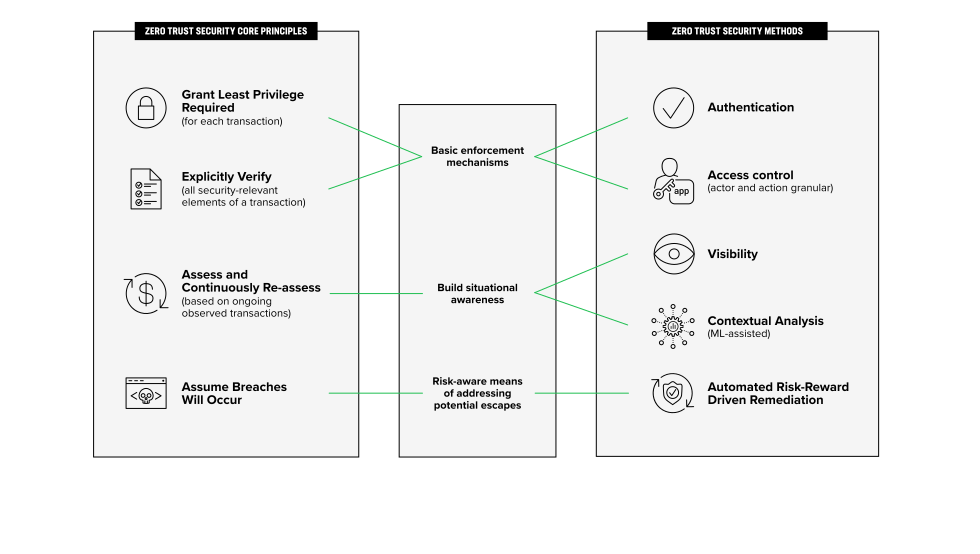
Diese Tools – die Methoden zur Authentifizierung, Zugriffskontrolle, Sichtbarkeit, kontextbezogenen Analyse und risikobewussten Behebung – sind notwendig und ausreichend, um eine Vielzahl von Angriffsarten zu verhindern.
Ressourcen
1 https://www.f5.com/services/resources/white-papers/why-zero-trust-matters-for-more-than-just-access
2 Zero Trust kann und sollte sogar bereits vor der CI/CD-Pipeline angewendet werden. Tools wie Schwachstellenbewertungstools, statische Analysen, CVE-Datenbanken, Reputationsdatenbanken für Open-Source-Code und Systeme zur Überwachung der Integrität der Lieferkette entsprechen dem Zero-Trust-Ansatz.
3 https://cloud.google.com/beyondcorp-enterprise/docs/quickstart
4 Beachten Sie, dass die Grenze zwischen kontextbezogener, risikobewusster Zugriffskontrolle und dem allgemeinen Thema der risikobewussten Behebung fließend ist und es gewisse Überschneidungen gibt.
5 Wird häufig als „Ost-West“-Schutz innerhalb der Anwendung bezeichnet, im Gegensatz zum „Nord-Süd“-Schutz der Anwendung.