F5 und AWS: Fortschrittliche Dienste zur Anwendungsbereitstellung in der Cloud
Einleitung
Amazon Web Services (AWS) ist zum größten und am weitesten verbreiteten Anbieter von Infrastructure-as-a-Service (IaaS) in der Public Cloud geworden. Unternehmen können jetzt komplette Anwendungs-Stacks erstellen, testen und bereitstellen, ohne dafür eine lokale Infrastruktur erwerben oder neu konfigurieren zu müssen. Produktivanwendungen profitieren von fortschrittlichen Diensten zur Anwendungsbereitstellung, darunter Web Application Firewalls (WAF), SSL-Beschleunigung, inhaltsbasiertes Routing, Lastverteilung, DDoS-Abwehr, Identitäts- und Zugriffsverwaltung sowie Protokollflexibilität. Dadurch werden diese geschäftskritischen Anwendungen schneller, intelligenter und sicherer. Bei cloudnativen AWS-Bereitstellungen ermöglichen F5-Lösungen eine unkomplizierte und einfache Bereitstellung dieser Anwendungsdienste in AWS-Cloud-Umgebungen.
Was ist Amazon Web Services?
Als IaaS-Anbieter stellt Amazon Web Services (AWS) eine gemietete Computing-Infrastruktur bereit, die für die Entwicklung von Anwendungen ausreicht. Ohne Investitions- oder Wartungskosten kann eine vollständige Anwendungssuite entwickelt und bereitgestellt werden. Neben einer Computing-Infrastruktur, wie sie auch in lokalen Rechenzentren zu finden ist, bietet AWS Anwendungsservices, skaliert die Infrastruktur automatisch und hostet Anwendungen an zahlreichen Standorten. Aufgrund dieser zusätzlichen Funktionen unterscheiden sich die Best Practices für AWS von denen eines herkömmlichen Rechenzentrums. Um die Unterschiede zwischen AWS und einem traditionellen Rechenzentrum besser zu verstehen, ist es wichtig zu wissen, wie AWS seine Services bereitstellt.
Infrastrukturdienste
Um AWS optimal zu nutzen, betrachten wir einige wichtige Merkmale des IaaS-Angebots, darunter die geografische Verteilung, Computing-Instanzen sowie Netzwerk- und Speicherkonzepte.
Geografie
Um AWS zu verstehen, muss man zunächst die physische Verteilung der Ressourcen betrachten. Auf der obersten Ebene verfügt AWS über mehrere Regionen, die jeweils ein großes geografisches Gebiet abdecken, beispielsweise den Osten der USA. Jede geografische Region umfasst mehrere Availability Zones. Diese sind so konzipiert, dass sie hinsichtlich möglicher Ausfälle voneinander isoliert sind. Ein Ausfall in einer Availability Zone (AZ) greift daher nicht auf eine andere AZ innerhalb derselben Region über. Obwohl die einzelnen AZs voneinander isoliert sind, sind sie innerhalb einer Region über Netzwerkverbindungen mit geringer Latenz miteinander verbunden. Um eine hohe Verfügbarkeit zu gewährleisten, gibt es Architekturmuster für redundante Kapazitäten über mehrere AZs innerhalb einer Region hinweg.
Datenverarbeitung
Compute-Instanzen basieren zunächst auf einem Software-Datenträgerabbild, das als Amazon Machine Image (AMI) bezeichnet wird. Jedes AMI ist unveränderlich, das heißt, der Computer, der es verwendet, kann nur lesend darauf zugreifen. Beim Starten einer Compute-Instanz mit einem AMI wird eine virtuelle Maschine in der Cloud ausgeführt. Die virtuellen Hardwaremerkmale der Compute-Instanz können variieren, beispielsweise die Anzahl der CPUs und die Menge des für die Instanz verfügbaren Arbeitsspeichers.
Netzwerk
Jede Compute-Instanz befindet sich in einer Virtual Private Cloud (VPC), die in etwa einem LAN in der physischen Welt entspricht. Jede VPC ist logisch von anderen VPCs getrennt. Eine VPC kann aus mehreren Subnetzen bestehen, zwischen denen implizites Routing erfolgt. Öffentliche Subnetze sind aus dem Internet erreichbar, während private Subnetze nur intern verfügbar sind. Zur Bereitstellung einer vollständigen Anwendung werden eine oder mehrere Compute-Instanzen innerhalb einer VPC bereitgestellt. Die Kommunikation zwischen VPCs ist möglich, wenn einer Compute-Instanz oder einem Load Balancer ein DNS-Eintrag zugewiesen ist.
Speicher
Wie oben erwähnt, kann ein AMI von der Instanz, die es verwendet, nicht verändert werden. Für die persistente Speicherung bietet AWS zahlreiche Lösungen an, insbesondere Simple Storage Service (S3) und Elastic Block Storage (EBS). S3 ist ein Objektspeicherdienst, bei dem ein Objekt unter einem Namen gespeichert und abgerufen werden kann. Die Größe eines Objekts kann zwischen null Byte und 5 TB liegen. Tatsächlich ist jedes AMI implizit ein S3-Objekt. Objekte können nicht geändert, sondern nur erstellt und gelöscht werden. Daher eignen sie sich ideal für relativ statische Inhalte wie Fotos oder Images virtueller Maschinen.
EBS stellt Speicher bereit, der eher herkömmlichen Speicherlösungen entspricht. Eine mit EBS verbundene Compute-Instanz erkennt EBS als herkömmliche Festplatte. An ein EBS-Volume kann jeweils nur eine laufende Instanz angebunden werden, sodass EBS nicht als gemeinsam genutzter Speicher verwendet werden kann.
Skalierungsdienste
Neben der Bereitstellung wichtiger Infrastrukturkomponenten bietet AWS zusätzliche Services, die die Skalierung von Anwendungen ermöglichen. Da AWS Infrastrukturressourcen schnell bereitstellen kann, hat Amazon Lösungen entwickelt, mit denen sich diese Ressourcen automatisch skalieren und ihre Lasten verteilen lassen.
Lastverteilung
AWS bietet einen Elastic Load Balancing (ELB)-Service an. Ursprünglich bezeichnete ELB einen einfachen, auf Schicht 4 arbeitenden Load Balancer, der den Datenverkehr auf mehrere fehlerfrei funktionierende Knoten in einem Pool verteilte. Der Pool konnte sich über mehrere Availability Zones erstrecken und so bei einem Ausfall in einer Availability Zone automatisch Redundanz gewährleisten. Dieser Load Balancer bietet zwar einige grundlegende Funktionen der Netzwerkschicht 7, arbeitet jedoch hauptsächlich auf Schicht 4 und leitet TCP-Datenverkehr einfach nach dem Round-Robin-Verfahren an die Knoten im Pool weiter. Zustandsprüfungen ermitteln, welche Knoten verfügbar sind und somit für die Verarbeitung des Datenverkehrs infrage kommen. AWS bezeichnet diesen ursprünglichen Load Balancer inzwischen als Classic Load Balancer, um ihn vom neuen Application Load Balancer (ALB) abzugrenzen.
Automatische Skalierung
Da AWS über verfügbare Reservekapazitäten verfügt, bietet es die Möglichkeit, die Anzahl der Knoten innerhalb eines Pools zu skalieren. Der AWS-CloudWatch-Service überwacht die Leistungsmetriken jedes Knotens in einem Pool. Werden vordefinierte Schwellenwerte überschritten – beispielsweise eine CPU-Auslastung von mehr als 60 % über einen Zeitraum von fünf Minuten –, wird ein weiterer Knoten bereitgestellt. Wird umgekehrt ein unterer Schwellenwert unterschritten, wird ein Knoten entfernt. Der Entwickler kann die maximale und minimale Anzahl von Knoten in einem Pool sowie die Schwellenwerte festlegen, die das Erstellen oder Entfernen von Knoten auslösen. Durch den Einsatz der automatischen Skalierung hinter einem Load Balancer kann der Knotenpool je nach Auslastung nach Bedarf erweitert oder verkleinert werden.
F5-Anwendungsbereitstellungsdienste
Anwendungen bilden zwar Geschäftsregeln und -logik ab, verfügen jedoch häufig nicht über die erforderliche Absicherung für die Bereitstellung, Verwaltung und den Betrieb in großem Maßstab. F5-Lösungen ermöglichen einen schnelleren, intelligenteren und sichereren Anwendungsbetrieb, indem sie die in der folgenden Tabelle aufgeführten fortschrittlichen Application-Delivery-Services bereitstellen.
Erweiterte Anwendungsbereitstellungsdienste von F5
Überwachung auf Anwendungsebene
- Erweiterte Zustandsprüfungen für Anwendungen (mithilfe eines mehrstufigen Monitors)
- Mehrstufige Integritätsprüfungen (z. B. um zu prüfen, ob sowohl die Datenbank als auch die Anwendung verfügbar sind)
- Nicht-HTTP-Systemdiagnosen (z. B. für SIP, Microsoft Windows SQL Server und FTP)
- Fortschrittliche Algorithmen zur besseren Verteilung des Datenverkehrs auf die leistungsfähigsten Server
Globale Verfügbarkeit
- Anwendungsverfügbarkeit über eine heterogene Kombination verschiedener Cloud-Anbieter oder Rechenzentren hinweg
- Integration mit erweiterten BIG-IP-Monitoren
- DNSSEC-Unterstützung
Schneller
Netzwerk- und Transportoptimierung
- Ein konfigurierbarer TCP-Stack, der für die Übertragung über WAN- und Mobilfunknetze optimiert werden kann
- Ein HTTP/2-Gateway, das die Vorteile zusätzlicher Komprimierung und des Request-Multiplexings bietet, ohne die Back-End-Infrastruktur zu verändern
Anwendungs- und Datenoptimierung
- Selektive spontane Bildoptimierung abhängig von den erkannten Netzwerk- oder Client-Eigenschaften
- WAN-Beschleunigung über SSL-verschlüsselte Tunnel mit adaptiver Komprimierung und TCP-Optimierung
Intelligenter
Programmierbarkeit des Datenpfads
- Vollständige programmatische Kontrolle über den Anwendungsdatenverkehr, einschließlich der Möglichkeit, sämtliche Aspekte der Anwendungsdaten zu lesen, zu schreiben und zu überprüfen
- Ereignisgesteuerte und umfassende Sprache
Programmierbarkeit der Steuerungsebene
- Die Möglichkeit, die Konfiguration als Reaktion auf Ereignisse wie Änderungen der Serverauslastung, des Anwendungsverhaltens oder der Infrastruktur anzupassen
- Vollständig autonome oder durch externe APIs ausgelöste Trigger
Sicherer
Erweiterte Netzwerk-Firewall-Dienste
- Entscheidungen zur Datenverkehrssteuerung anhand von Kriterien, die über IP:Port:Protokoll hinausgehen, wie etwa der geografische Standort oder die Reputation des Endpunkts
- Validierung des HTTP-Protokolls
- Zeitpläne nach Tag und Uhrzeit
Web-Application-Firewall-Dienste
- Umfassende Tools zur Erkennung von Bedrohungen für Webanwendungen und zur Blockierung schädlichen Datenverkehrs
- Dienste zur Verhinderung ausgehender Datenverluste (DLP)
Zugriffs- und Identitätsdienste
- Erweiterte Authentifizierungsdienste wie Zwei-Faktor-Token, CAPTCHA oder geografische Beschränkungen
- Überprüfung von Clientzertifikaten und Endgeräten
- Dienste für SAML-Dienstanbieter (SP) und Identitätsanbieter (IdP)
Abwehr von Denial-of-Service-Angriffen (DoS)
- Proaktiver Bot-Schutz
- Erkennung und Abwehr von DoS-Angriffen auf Layer 7
SSL und Verschlüsselung
- SSL-Entschlüsselung, Überprüfung des Datenverkehrs und erneute Verschlüsselung
- Auslagerung von SSL-Workloads aus den Ressourcen des Compute-Knotens
Fortschrittliche Application-Delivery-Services ermöglichen eine höhere Anwendungsleistung und sorgen zugleich für bessere Verfügbarkeit und Sicherheit. Diese Services können an einem strategischen Kontrollpunkt unabhängig von den einzelnen Anwendungen bereitgestellt werden. Durch die Entkopplung der Services von der Geschäftslogik der Anwendungen können diese die geschäftlichen Anforderungen erfüllen, ohne die Entwicklungsteams mit Fragen zu Infrastruktur, Verwaltung und Leistung zu belasten. Ein strategischer Kontrollpunkt ermöglicht zudem, Governance-Anforderungen einheitlich und unabhängig von den einzelnen Anwendungen zu handhaben.
Alles zusammenführen: F5 und AWS
Durch die cloudnative Integration in die AWS-Infrastruktur ermöglicht F5 Unternehmen, das Potenzial ihrer AWS-Bereitstellungen voll auszuschöpfen und die Leistung, Verfügbarkeit und Sicherheit ihrer Anwendungen zu verbessern. Im folgenden Abschnitt untersuchen wir, wie AWS und F5 zusammenarbeiten.
Bootstrapping
Wenn eine Serverinstanz von einem generischen Image startet, ist es häufig sinnvoll, Parameter zu ändern oder Konfigurationen wie den Hostnamen und die IP-Adresse festzulegen. Auf Clientcomputern werden diese Parameter über DHCP festgelegt, bei Servern kann dies jedoch häufig zu Problemen führen. Neben den Netzwerkeinstellungen benötigt eine bestimmte Instanz mitunter auch spezielle Softwarepakete oder bestimmte Softwarekonfigurationen.
Bei einer BIG-IP-Bereitstellung möchte ein Administrator möglicherweise die Konfiguration der einzelnen Module automatisieren, beispielsweise die Konfiguration virtueller Server und Pools für BIG-IP Local Traffic Manager (LTM), spezifische WAF-Konfigurationen für BIG-IP Application Security Manager oder Firewall-Einstellungen für BIG-IP Advanced Firewall Manager. Vor denselben Herausforderungen steht jeder, der eine Serverinstanz installiert: Das Basis-Image muss zusätzlich konfiguriert werden, damit es ordnungsgemäß funktioniert.
AWS bietet zwei primäre Ansätze für die Konfiguration einer Instanz: das Erstellen eines neuen AMI oder die Verwendung von cloud-init, um einen Server während des Startvorgangs anzupassen. Das Erstellen eines neuen AMI eignet sich besser für Änderungen, die mehrere Instanzen betreffen und voraussichtlich nicht häufig aktualisiert werden. Im Gegensatz dazu eignet sich cloud-init besser für Änderungen, die weniger Instanzen betreffen und eine kürzere Lebensdauer haben.
AMI
Für Änderungen, die voraussichtlich über einen längeren Zeitraum bestehen bleiben, sowie für Änderungen, die mehrere Instanzen betreffen, empfiehlt es sich, eine neue AMI zu erstellen. Dazu wird eine Maschine von einer AMI gestartet, die der gewünschten Konfiguration ähnelt. Nachdem der Administrator die erforderlichen Änderungen an der laufenden Instanz vorgenommen hat, wird die Instanz angehalten und eine neue AMI erstellt und bei AWS registriert. Bei allen künftig von dieser AMI gestarteten Instanzen sind die Änderungen bereits übernommen. Da die Änderungen bei diesem Ansatz praktisch dauerhaft sind und die Erstellung der neuen AMI einige Zeit in Anspruch nehmen kann, werden in der Regel nur solche Änderungen in die AMI integriert, die langfristig bestehen bleiben und für mehrere Instanzen verwendet werden können. Ein weiterer Grund für die Verwendung einer AMI sind kürzere Startzeiten, da einige cloud-init-Prozesse zeitaufwendig sein können.
Cloud-init
Notwendige Änderungen, die sich nicht gut in ein neues AMI integrieren lassen, eignen sich gut für cloud-init. Damit kann im Wesentlichen bei jedem Start der Instanz ein Startskript ausgeführt werden. Mithilfe von cloud-init lassen sich einfache und instanzspezifische Änderungen in die Instanz einbetten.
Zu den Nachteilen von cloud-init gehört, dass Konfigurationsänderungen wie Paketinstallationen beim Systemstart ausgeführt werden müssen, wodurch der Startvorgang länger dauert. Eine lange Startzeit hat erhebliche Auswirkungen auf Auto-Scaling-Szenarien, da sie die automatische Skalierung unwirksam machen kann. Aus diesen Gründen sollten zeitaufwendige Änderungen in eine neue AMI aufgenommen werden, anstatt sie über cloud-init vorzunehmen.
Auch die Konfigurationsverwaltung kann umständlich sein, wenn eine Änderung für mehrere, aber nicht für alle Instanzen verwendet werden kann. Angenommen, eine bestimmte BIG-IP-Bereitstellung wird beispielsweise in einer Auto-Scaling-Gruppe mit einer bestimmten Konfiguration des virtuellen Servers verwendet. Für diese Maschinen könnte ein einziges AMI verwendet werden, während für andere BIG-IP-Maschinen in einer anderen Auto-Scaling-Gruppe ein anderes AMI zum Einsatz kommen könnte. Durch die Verwendung eines einzigen AMI pro Auto-Scaling-Gruppe wird sichergestellt, dass im cloud-init-Prozess nur hostspezifische Änderungen erforderlich sind. Alle gruppenweit geltenden Änderungen können in das AMI integriert werden. Der Nachteil dieses Ansatzes besteht darin, dass das AMI bei jeder Änderung, die für alle Maschinen gilt, aktualisiert werden muss.
Automatische Skalierung
Anwendungen stellen Funktionen bereit, die in der Regel von mehreren Benutzern gleichzeitig genutzt werden. Mit zunehmendem Erfolg kann eine Anwendung die Kapazität des Computers überschreiten, auf dem sie ausgeführt wird. Sobald die Anforderungen der Anwendung die Kapazität des Computers übersteigen, müssen Möglichkeiten zur Kapazitätserweiterung geprüft werden. Es gibt drei grundlegende Skalierungsansätze: vertikale Skalierung, Pipelining und horizontale Skalierung.
Vertikale Skalierung
Die vertikale Skalierung ist der einfachste Ansatz zur Kapazitätssteigerung, da dabei lediglich der vorhandene Computer durch einen leistungsfähigeren ersetzt wird. Durch die Installation eines leistungsfähigeren Computers werden alle Bereiche der Anwendung sowie alle anderen auf dem Computer ausgeführten Dienste schneller, ohne dass Änderungen an der Anwendung oder Infrastruktur erforderlich sind. Der Nachteil der vertikalen Skalierung besteht darin, dass die Kosten mit zunehmender Leistung tendenziell exponentiell steigen, sodass ab einem gewissen Punkt der zusätzliche Nutzen immer geringer wird. Sobald ein bestimmter Schwellenwert überschritten ist, wird die vertikale Skalierung zu kostspielig.
Pipelining
Pipelining entsteht durch die Zerlegung der Arbeitslast in aufeinanderfolgende Schritte, ähnlich wie bei einem Fließband. Wenn verschiedene Computer jeden Schritt unabhängig voneinander bearbeiten können, lässt sich der Gesamtdurchsatz erhöhen. Pipelining erhöht jedoch nur den Durchsatz, und das geht häufig zulasten der Latenz. Anders ausgedrückt: Pipelining kann die Gesamtleistung steigern, zugleich aber die Leistung für einen einzelnen Benutzer oder eine einzelne Anfrage verringern. Ein weiterer Nachteil des Pipelinings besteht darin, dass es ein tiefgreifendes Verständnis des zerlegbaren Arbeitsablaufs erfordert und die Infrastruktur auf dieses Verständnis abgestimmt sein muss. Dadurch werden Infrastrukturentscheidungen eng an die Geschäftslogik gekoppelt – genau das Gegenteil dessen, was viele Organisationen anstreben.
Horizontale Skalierung
Bei der horizontalen Skalierung bleiben die Anwendung und der Computer unverändert. Stattdessen werden die Anfragen gleichmäßig auf einen Serverpool verteilt. Da Anwendungen in der Regel mehrere voneinander unabhängige Anfragen gleichzeitig verarbeiten, können diese problemlos auf einen Pool identischer Anwendungsserver verteilt werden. Die horizontale Skalierung bietet zudem den Vorteil der Redundanz, da der Ausfall eines einzelnen Poolmitglieds nicht zum Ausfall der gesamten Anwendung führt. Ihr Nachteil besteht darin, dass eine komplexe, anwendungsexterne Orchestrierung erforderlich ist, um eine ausgewogene Verteilung der Anfragen auf die Knoten im Pool sicherzustellen.
Automatische Skalierung mit AWS
AWS Auto Scaling verfolgt einen Scale-out-Ansatz, um die Kapazität für Anwendungen zu erhöhen, die zusätzliche Ressourcen benötigen. Der CloudWatch-Service überwacht die Knoten in einem Pool. Wenn Knoten vordefinierte Schwellenwerte überschreiten, startet CloudWatch je nach Bedarf automatisch neue Knoten oder fährt Knoten im Pool herunter. Bei der BIG-IP Plattform kann dieser Prozess auf zwei Arten erfolgen: durch Ändern der Anzahl der BIG-IP Instanzen oder durch Ändern der Anzahl der Knoten in einem Pool hinter einer einzelnen BIG-IP Instanz. Der Unterschied zwischen den beiden Ansätzen hängt davon ab, was skaliert wird: entweder die BIG-IP Instanz oder ein Pool.
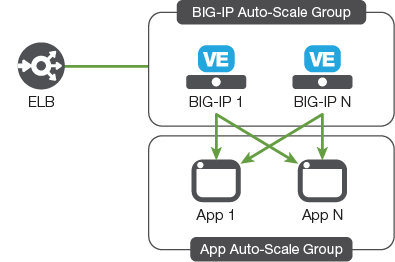
Im ersten Szenario befindet sich ein BIG-IP-Pool zwischen zwei ELB-Geräten. Das erste ELB-Gerät steuert das Erstellen und Beenden von BIG-IP-Mitgliedern, während das zweite ELB-Gerät den einzigen Eintrag in einem Serverpool für jede der BIG-IP-Instanzen darstellt. Dieser Ansatz ist sinnvoll, wenn die BIG-IP-Instanz erweiterte Dienste zur Anwendungsbereitstellung bereitstellt, beispielsweise SSL-Terminierung oder eine Web Application Firewall. Das erste ELB-Gerät übernimmt den Lastenausgleich und vergrößert oder verkleinert den Pool je nach Bedarf.
Im zweiten Szenario wird die Anzahl der Mitglieder des Backend-Pools über CloudWatch erhöht oder verringert, während die BIG-IP-Instanz den Lastenausgleich übernimmt. Die BIG-IP-Instanz kommuniziert mit AWS, um zu erkennen, welche Knoten dem Pool hinzugefügt oder daraus entfernt werden. Dieser Ansatz ist sinnvoll, wenn erweiterte Lastenausgleichsfunktionen verwendet werden, beispielsweise die Skriptsprache iRules, oder wenn Anfragen anhand der URL oder des Inhalts weitergeleitet werden. In diesen Fällen reicht eine einzelne BIG-IP-Instanz aus, um die Last der Server im Backend-Pool zu verwalten.
Sicherheit und IAM
Die BIG-IP-Instanz muss in mindestens zwei Szenarien mit der AWS-Infrastruktur interagieren. Erstens muss bei einer AWS-Bereitstellung über mehrere Zonen hinweg die IP-Adresse geändert werden, die einer elastischen AWS-IP-Adresse zugeordnet ist. Zweitens benötigt eine BIG-IP-Instanz Informationen darüber, welche Pool-Mitglieder vom AWS-CloudWatch-Dienst hinzugefügt oder entfernt werden, der die Anzahl der Server innerhalb eines Pools nach oben oder unten skaliert. Jede Interaktion mit der Infrastruktur erfolgt über API-Aufrufe. Wie jede andere Software, die API-Aufrufe durchführt, muss sich auch die BIG-IP-Instanz bei AWS authentifizieren. Im Allgemeinen gibt es zwei Möglichkeiten zur Authentifizierung bei AWS: über Anmeldeinformationen oder über IAM-Rollen.
Anmeldedaten
Der einfachste Ansatz für die Authentifizierung besteht darin, beim API-Aufruf die entsprechenden Anmeldedaten anzugeben. AWS-Anmeldedaten bestehen aus einem Zugriffsschlüssel und einem geheimen Schlüssel, die in etwa einem Benutzernamen und einem Passwort entsprechen. Der Administrator erstellt die Anmeldedaten, die der Entwickler anschließend in die Anwendung einbettet. Dadurch erhält die Anwendung Zugriff auf die entsprechenden API-Aufrufe.
Das Einbetten von Anmeldeinformationen in eine Anwendung ist zwar einfach, birgt jedoch Sicherheitsrisiken. Wenn der Entwickler die Anmeldeinformationen in der Anwendung nicht ausreichend schützt, könnten andere Personen oder Programme sie auslesen und für böswillige Zwecke verwenden. Dieser Ansatz erschwert es außerdem, die Anmeldeinformationen zu ändern, ohne zugleich die Software anzupassen. Für schnelle Tests ist die Verwendung von Anmeldeinformationen zwar sinnvoll, in einer Produktionsumgebung sollte jedoch eine andere Authentifizierungsmethode eingesetzt werden. Aus diesem Grund raten die AWS Best Practices davon ab, in einer Anwendung gespeicherte Anmeldeinformationen zu verwenden.
Identitäts- und Zugriffsmanagement
Ein sichererer Ansatz für die Authentifizierung bei API-Aufrufen ist die Verwendung von IAM-Rollen. Mit AWS Identity and Access Management (IAM) können Benutzer den Zugriff auf die AWS-Infrastruktur verwalten. Jeder Computing-Instanz, beispielsweise einer BIG-IP-Instanz, kann eine IAM-Rolle zugewiesen werden, die bestimmte Funktionen autorisiert. Beim Start der Instanz generiert IAM einen temporären Satz von Anmeldedaten für die Instanz. Diese Anmeldedaten sind gültig, solange die Instanz ausgeführt wird, und ermöglichen ausschließlich die angegebenen API-Funktionen. Bei Konfiguration mit einer IAM-Rolle speichert die BIG-IP-Instanz keine Anmeldedaten, sondern hat nur Zugriff auf die erforderlichen Infrastruktur-APIs. Dies bietet mehr Sicherheit als eine auf Anmeldedaten basierende Authentifizierung.
Verfügbarkeit über mehrere Zonen hinweg
Wie bereits erwähnt, befinden sich AWS-Rechenzentren in geografischen Regionen, die jeweils über mehrere Availability Zones (AZs) verfügen können. Die AZs innerhalb einer Region nutzen keine gemeinsamen Ressourcen: weder Stromversorgung noch Netzwerke oder Gebäude. Tatsächlich ist jede AZ geografisch von den anderen AZs innerhalb einer Region getrennt. Aufgrund dieser Trennung können AWS-Kunden darauf vertrauen, dass ein Ereignis, das sich auf eine AZ auswirkt, keine andere AZ beeinträchtigt. In der Regel sollte also zu jedem Zeitpunkt höchstens eine AZ innerhalb einer Region nicht verfügbar sein. Das bedeutet, dass jeder Dienst, der über zwei oder mehr Availability Zones hinweg bereitgestellt wird, durchgehend verfügbar sein sollte.
Die BIG-IP-Plattform unterstützt Hochverfügbarkeit über mehrere AWS-AZs hinweg mithilfe einer elastischen AWS-IP-Adresse. Dabei handelt es sich um eine IP-Adresse, die nicht fest mit einer Compute-Instanz verknüpft ist. Stattdessen kann die IP-Adresse dynamisch an eine private IP-Adresse einer laufenden Compute-Instanz weitergeleitet werden. Um Hochverfügbarkeit über mehrere Zonen hinweg zu ermöglichen, werden identische Gruppen von BIG-IP-Instanzen und Anwendungsservern jeweils in einer eigenen AZ bereitgestellt. Zunächst wird die elastische IP-Adresse einer der BIG-IP-Instanzen zugewiesen. Jeder Client stellt eine Verbindung zur elastischen IP-Adresse her, die diese wiederum an die private IP-Adresse einer der BIG-IP-Instanzen weiterleitet. Sollte ein Ausfall auftreten, übernimmt die andere BIG-IP-Instanz die Aufgaben, indem sie über einen API-Aufruf an AWS anfordert, dass die elastische IP-Adresse an sie weitergeleitet wird.
Elastic Load Balancer
Durch die Integration mit dem ELB kann die BIG-IP-Plattform Anwendungsdienste bereitstellen, die sich nahtlos in AWS-Funktionen wie mehrere AZs und die automatische Skalierung von BIG-IP-Knoten integrieren.
Die Platzierung des ELB vor einer BIG-IP-Instanz vereinfacht die Bereitstellung über mehrere AZs hinweg, da der ELB den Datenverkehr nahtlos auf die einzelnen Anwendungsstacks in jeder AZ verteilen kann, in der eine BIG-IP-Instanz Anwendungsdienste bereitstellt. Dieser Ansatz vereinfacht die Lastverteilung über mehrere AZs hinweg.
Wenn eine elastische Skalierung von BIG-IP-Instanzen erforderlich ist, kann ein ELB mit automatischer Skalierung einen Pool virtueller BIG-IP-Appliances automatisch vergrößern und verkleinern und dabei Anwendungsdienste wie eine Web Application Firewall, Identitätsverwaltung oder SSL-Terminierung bereitstellen. Bei Verwendung eines ELB-Sandwichs wird der Datenverkehr an den ersten ELB weitergeleitet, der ihn auf einen Pool von BIG-IP-Instanzen verteilt und diesen automatisch skaliert. Um die Konfiguration im gesamten BIG-IP-Pool zu vereinfachen, verwendet jede BIG-IP-Instanz im Serverpool eine einzige ELB-Adresse. Der zweite ELB leitet den Datenverkehr anschließend an den nachgelagerten Serverpool weiter.
Verschiedene Kombinationen von ELB- und BIG-IP-Topologien bieten automatische Skalierung, Verfügbarkeit und Anwendungsdienste, die mit keiner der beiden Lösungen allein möglich sind. Durch die Nutzung der Vorteile sowohl von ELB als auch der BIG-IP-Plattform kann der Architekt den für eine bestimmte Bereitstellung erforderlichen Leistungsumfang bereitstellen.
CloudFormation-Vorlagen
Um wiederholbare und skriptgesteuerte Bereitstellungen zu ermöglichen, stellt AWS Cloud Formation Templates (CFTs) bereit, die sowohl die Bereitstellung als auch die laufende Verwaltung vereinfachen. Nachdem ein CFT für die gewünschte Service- oder Anwendungsarchitektur erstellt wurde, kann AWS damit eine Anwendung schnell und zuverlässig bereitstellen. CFTs sind besonders in DevOps-Umgebungen nützlich, da Teams damit auf einfache Weise wiederholbare Prozesse für Tests und die Bereitstellung in Produktionsumgebungen erstellen können.
F5 unterstützt nicht nur die Verwendung von CFTs zur Bereitstellung von BIG-IP-Instanzen, sondern stellt auch mehrere CFT-Referenzdateien für typische BIG-IP-Bereitstellungen bereit.
Durch das Anpassen der Parameter in den CFT-Referenzdateien lassen sich skriptgesteuerte Bereitstellungen von BIG-IP-Lösungen für verschiedene Szenarien realisieren. Dazu gehören die automatische Skalierung von BIG-IP-Instanzen oder von Back-End-Servern hinter BIG-IP-Instanzen sowie komplexere Szenarien. Durch die Automatisierung wiederholbarer Bereitstellungen in AWS mithilfe von CFTs und F5-Lösungen können komplexe Anwendungsumgebungen schnell und mit geringem Aufwand bereitgestellt werden.
Dokumentation
Natürlich ist Technologie nur von geringem Nutzen, wenn ihr Potenzial nicht voll ausgeschöpft werden kann. Zu diesem Zweck stellt F5 eine umfangreiche Dokumentation bereit. Diese ist sowohl für die BIG-IP Plattform im Allgemeinen als auch für die Besonderheiten einer BIG-IP Instanz in AWS verfügbar. Ein guter Ausgangspunkt für alle Fragen ist Ask F5.
Die Registerkarte „Dokumentation“ enthält Informationen zu bestimmten BIG-IP-Modulen sowie einen vollständigen Abschnitt zur AWS-Integration. Das AWS-Portal bietet eine durchsuchbare Oberfläche für Dokumentationen, Artikel, Community-Inhalte und Ressourcen – von den ersten Schritten bis hin zu komplexen Bereitstellungsszenarien.
Bei Fragen, die in der Dokumentation nicht beantwortet werden, steht die F5 DevCentral-Community mit Antworten und Unterstützung zur Verfügung.
Fazit
Der Trend zur Einführung der Public Cloud ist längst keine Modeerscheinung mehr, sondern eine dauerhafte Entwicklung in der IT. Amazon Web Services, der weltweit größte und umfassendste Anbieter öffentlicher Cloud-Dienste, ermöglicht es Unternehmen, Anwendungen ohne jegliche lokale Infrastruktur zu entwickeln, zu testen und bereitzustellen. F5 hat seine fortschrittlichen Dienste zur Anwendungsbereitstellung in das AWS-Ökosystem integriert und so konfiguriert, dass Anwendungen in AWS-Cloud-Umgebungen schneller, intelligenter und sicherer ausgeführt werden.
VERÖFFENTLICHT AM 14. MÄRZ 2017