健康を維持するうえで医師による定期健診が重要であるのと同じように、アプリの安定したパフォーマンスを維持するには、定期的なヘルスチェックが欠かせません。NGINXは、リバースプロキシとしてトラフィックを処理し、負荷分散を行う際に、パッシブヘルスチェックを使用して、リクエストに応答しないサーバーからトラフィックを自動的に迂回させ、アプリケーションユーザーを障害の影響から保護します。NGINX Plusにはさらに、アクティブヘルスチェックが備わっています。専用のプローブを送信することで、サーバーがリクエストを処理できなくなる前でも、その異常を検出できます。アプリケーションには、どちらのヘルスチェックが適しているのでしょうか。この記事では、その判断に必要な情報をご紹介します。
ヘルスチェックとは
ヘルスチェックとは、基本的には、サーバーがトラフィックを処理できるかどうかを判断する方法です。NGINXはヘルスチェックを使用して、リバースプロキシや負荷分散の転送先となるサーバー、いわゆるアップストリームサーバーを監視します。
パッシブヘルスチェック
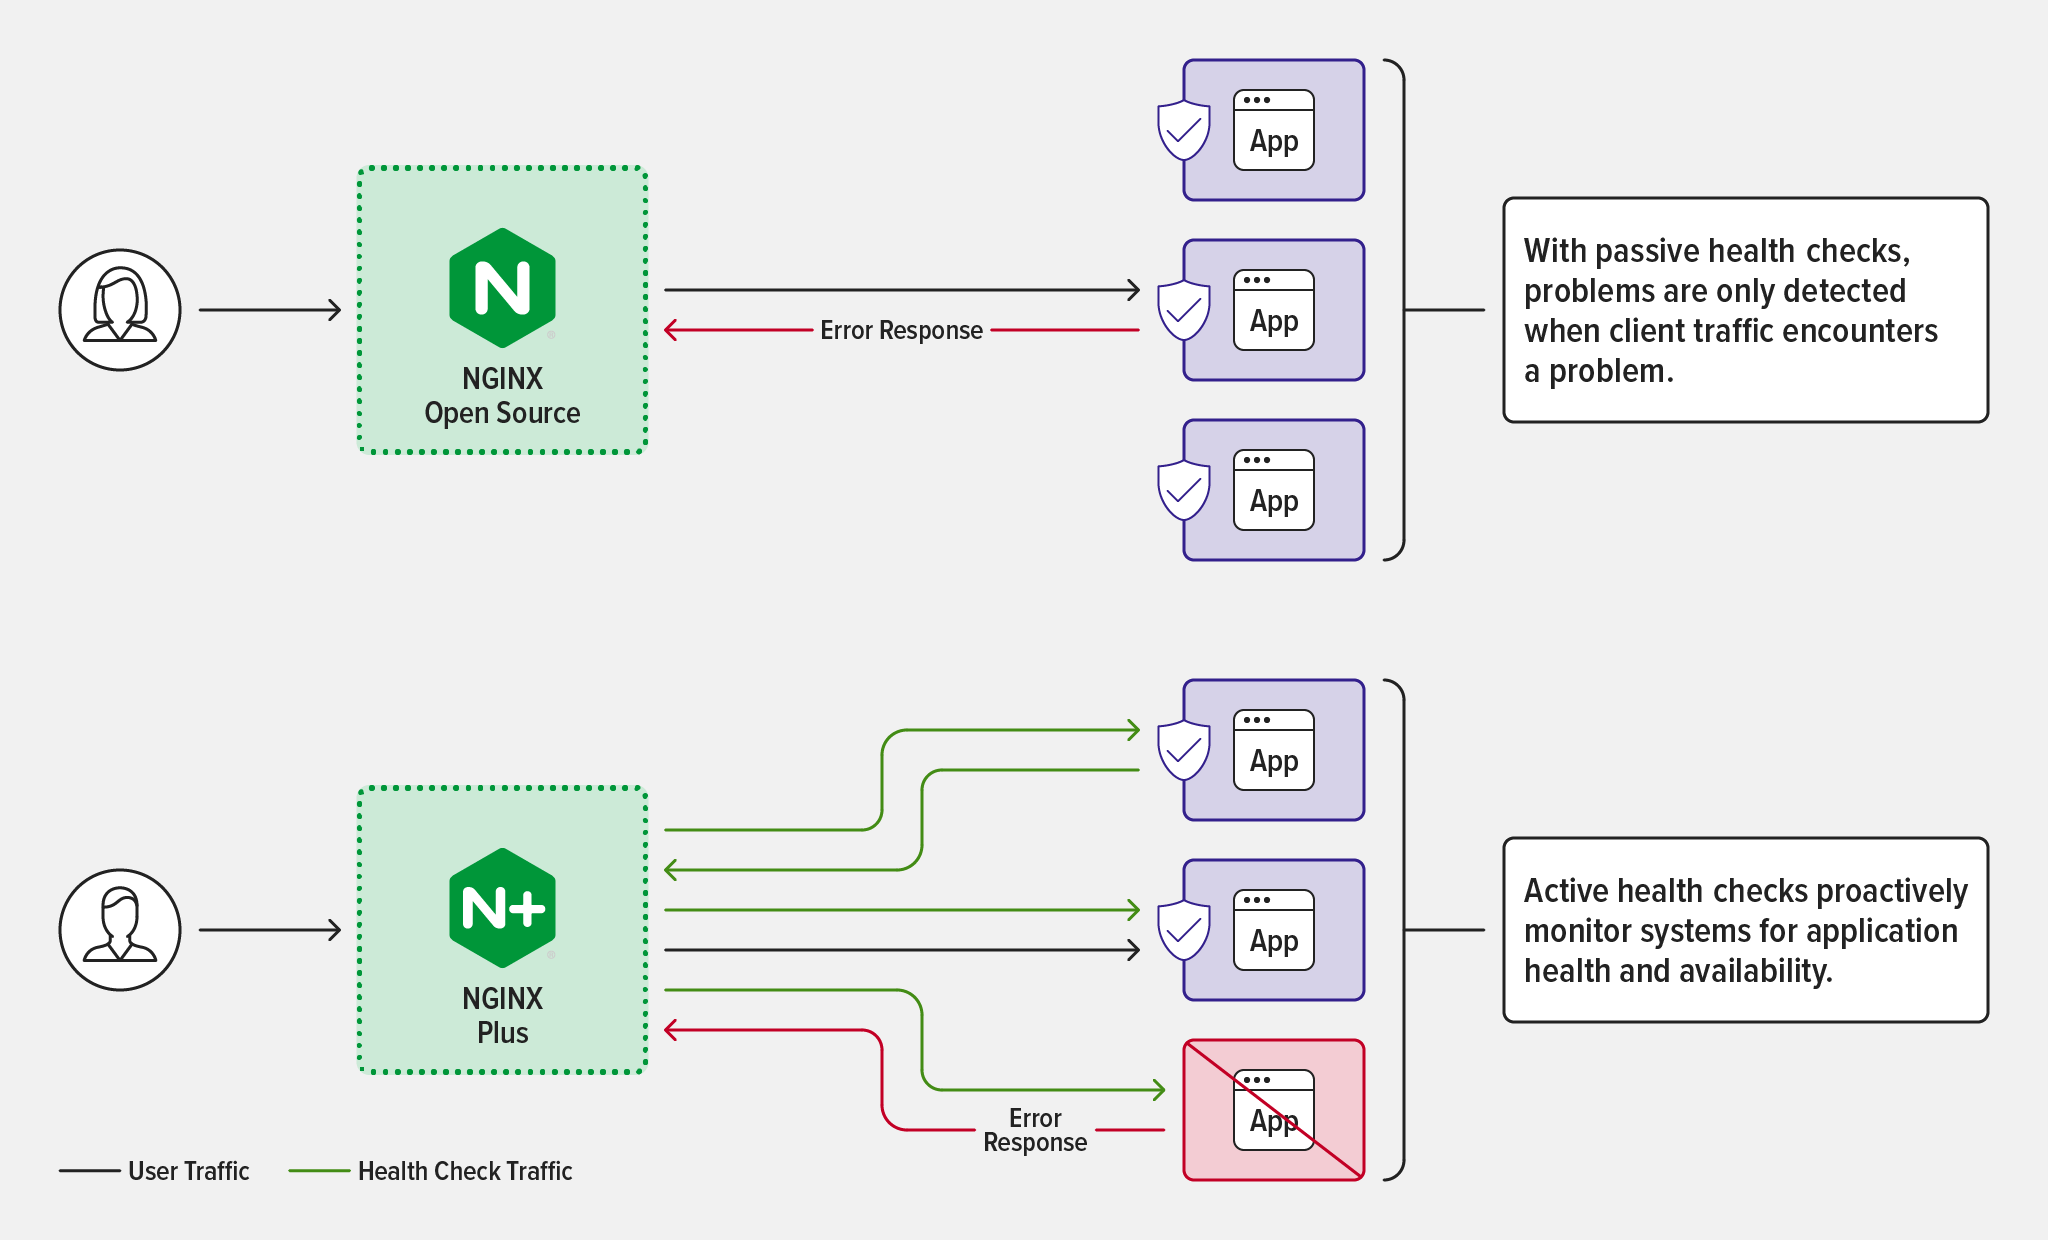
NGINX Open SourceとNGINX Plusの両方で利用できるパッシブヘルスチェックは、接続やトラフィックを処理する際のサーバーの動作を監視する仕組みです。NGINXは、サーバーが異常な状態にあることを検出すると、直ちにリクエストを別のサーバーに転送し、異常のあるサーバーへのリクエスト送信を停止します。その後のリクエストは、アップストリームグループ内の残りの正常なサーバーに分散します。これにより、サーバーのタイムアウトによってユーザーがサービスを利用できなくなる事態の防止に役立ちます。
パッシブヘルスチェックは、アップストリームグループに複数のメンバーが定義されている場合にのみ有効です。アップストリームサーバーが1台しか定義されていない場合、そのサーバーが利用不可と判定されることはなく、異常が発生するとユーザーはサービスを利用できなくなります。
パッシブヘルスチェックの仕組み
ここでは、パッシブヘルスチェックの仕組みを詳しく説明します。詳細が不要な場合は、アクティブヘルスチェックに進んでください。
デフォルトでは、NGINXはTCP/UDP(stream)サーバーを異常と判断します。これは、そのサーバーとの接続確立中にエラーまたはタイムアウトが1回でも発生した場合です。
NGINXがHTTPサーバーを異常と判断するのは、サーバーへの接続の確立、リクエストの送信、またはレスポンスヘッダーの読み取りで、エラーまたはタイムアウトが1回でも発生した場合です(レスポンスをまったく受信しない場合も、この種のエラーに該当します)。proxy_next_upstreamディレクティブを使用すると、HTTPプロキシでこれらの条件をカスタマイズできます。また、FastCGI、gRPC、memcached、SCGI、TCP/UDP、uwsgiプロトコルにも同様のディレクティブがあります。
HTTPとTCP/UDPのいずれの場合も、NGINXは異常と判定したサーバーへの接続とリクエストの送信を再試行するまで、デフォルトで10秒間待機します。この待機時間は、fail_timeoutパラメーター(server[HTTP][Stream]ディレクティブ)を使用して変更できます。
NGINXがサーバーを異常と判断するまでのエラーまたはタイムアウトの発生回数は、max_failsパラメーターをserverディレクティブに指定することで増やせます。この場合、fail_timeoutパラメーターは、指定した回数のエラーまたはタイムアウトが発生する必要がある期間と、NGINXがサーバーを異常と判断してからそのサーバーへの接続を再試行するまでの待機時間を設定します。
アクティブヘルスチェック
アクティブヘルスチェックは、NGINX Plus専用の機能で、アプリケーションのエンドポイントが正しく応答していることを確認するために定期的に送信される特別なリクエストです。パッシブヘルスチェックとは別に、追加で実行されます。たとえば、NGINX PlusはアプリケーションのWebサーバーに定期的にHTTPリクエストを送信し、有効な応答コードと正しいコンテンツが返されることを確認する場合があります。アクティブヘルスチェックにより、特定のアプリケーションコンポーネントやプロセスの健全性を継続的に監視できます。これはアプリケーションの可用性を直接測定するものですが、その測定がどの程度実態を反映するかは、指定したヘルスチェックがアプリケーション全体の健全性をどの程度代表しているかによって異なります。
アクティブヘルスチェックのさまざまな設定をカスタマイズできます。詳しくは、「アクティブヘルスチェックのユースケース」を参照してください。
パッシブヘルスチェックのユースケース
パッシブヘルスチェックは、基本的な必須要件です。アプリケーション開発、DevOps、DevSecOps、Platform Opsのすべてのチームにとって、本番インフラストラクチャの監視の一環としてパッシブヘルスチェックを実施することがベストプラクティスです。NGINXは、HTTP、TCP、UDPの構成を含め、負荷分散されたトラフィックに対してデフォルトでパッシブヘルスチェックを実行します。
パッシブヘルスチェックには、次のような利点があります。
- NGINX Open Sourceで利用可能
- Enabled by default for the servers included in an
upstream{}設定ブロックに含まれるサーバーではデフォルトで有効 - アップストリームサーバーへの追加の負荷なし
- 次の説明に従って、一定期間内の最小失敗回数を設定可能:パッシブヘルスチェックの仕組み
- 設定可能なスロースタート(NGINX Plus限定)– サーバーが正常な状態に戻ると、NGINX Plusはそのサーバーに転送するトラフィック量を徐々に増やし、「ウォームアップ」の時間を確保します。
NGINX Open Sourceの利点は、コスト(もちろん無料)、構成の柔軟性、そして豊富なサードパーティ製モジュールです。ソースコードが公開されているため、開発者は個々のニーズに合わせて機能を変更・拡張できます。
多くのアプリケーション(およびその開発者)にとって、パッシブヘルスチェックで十分です。たとえば、顧客に直接サービスを提供せず、小規模なタスクを実行するマイクロサービスには、アクティブヘルスチェックは過剰かもしれません。同様に、キャッシュによって遅延の問題が生じる可能性を低減できるアプリケーションや、コンテンツ配信ネットワーク(CDN)がタスクの一部を担えるアプリケーションでも、アクティブヘルスチェックは不要な場合があります。まとめると、パッシブヘルスチェックのみの構成が最適なのは、次の場合です。
- HTTPトラフィックの監視
- アプリケーションとは別にインフラを監視
- レイテンシを許容できるアプリケーションの監視
- 高いパフォーマンスが重要ではない内部アプリケーションの監視
アクティブヘルスチェックのユースケース
ミッションクリティカルなアプリケーションでは、問題が顧客や主要なプロセスに直接影響するため、アクティブヘルスチェックが極めて重要になることがよくあります。こうしたアプリケーションでは、顧客や利用者と基本的に同じ方法でアプリケーションをテストすることが不可欠であり、そのためにはアクティブヘルスチェックが必要です。アクティブヘルスチェックは、帯域外のチェックを使用してアプリケーションのレイテンシーや応答を測定するNew RelicやAppDynamicsなどのアプリケーションパフォーマンス監視ツールに似ています。NGINX Plusには、アクティブヘルスチェック向けに、NGINX Open Sourceにはない数多くの機能が備わっています。
- アプリケーションの可用性を確認する帯域外ヘルスチェック
- 設定済みのエンドポイントをテストし、特定の応答を確認
- 実際のアプリケーショントラフィックを処理するポートとは異なるポートをテスト
- ヘルスチェック用のHTTP接続を維持し、チェックのたびに新しい接続を確立する必要をなくします
- 失敗条件と成功条件をより細かく制御
- 必要に応じて、新しく追加したサーバーを実際のアプリケーショントラフィックの受信前にテスト
アクティブヘルスチェックを使用すると、開発者はNGINX Plusを設定して、バックエンドサーバーのダウンや問題の発生を自動的に検出し、問題が解決するまで正常なサーバーにトラフィックを振り分けることができます。アクティブヘルスチェックは設定の柔軟性が高いため、より高度なヘルスチェックを実行でき、実際のアプリケーションユーザーに影響が及ぶ前に、アプリケーションの問題を検出できる可能性があります。これにより、ダウンタイムを最小限に抑え、ユーザーによるアプリケーションへのアクセスの中断を防ぐことができます。
ヘルスチェックの設定方法
パッシブヘルスチェックはデフォルトで有効になっていますが、実行頻度や、サービスが異常と判定されるまでの失敗回数は、「パッシブヘルスチェックの仕組み」の説明に従ってカスタマイズできます。パッシブヘルスチェックとアクティブヘルスチェックの詳しい設定手順については、次のドキュメントをご覧ください。
まとめ:アプリケーションの要件に合ったヘルスチェックの選択
ヘルスチェックは、本番環境のあらゆるアプリケーションを円滑に稼働させ、良好な応答性を維持するうえで重要な役割を果たします。エンドユーザーに影響が及ぶ前に問題を検出し、レイテンシー増大の原因を特定するための最良の方法です。多くのアプリケーションでは、パッシブヘルスチェックで十分です。
ユーザーレベルでのアプリケーションの動作を直接把握する必要がある、より重要度の高いアプリケーションには、アクティブヘルスチェックが適しています。NGINX Open Sourceは無料で利用でき、設定可能なパッシブヘルスチェックを提供します。NGINX Plusは、高度なアクティブヘルスチェック機能に加え、商用サポートも提供します。
NGINX Plusのアクティブヘルスチェックを試してみませんか?30日間無料トライアルを今すぐ開始するか、ユースケースについてお問い合わせください。
著者について
関連するブログ記事

チュートリアル:NGINXを使用してアプリケーション向けにOpenTelemetryを構成する
OpenTelemetryを使用してNGINXサーバーの状態と健全性をより明確に把握することで、問題のトラブルシューティングを行い、Webアプリケーションのパフォーマンスを向上できます。
AkitaのNGINX Plus認定モジュールでAPIエンドポイントの問題を特定・修正
Akita SoftwareのAPIオブザーバビリティ向け新しいNGINX Plus Certified Moduleを活用して、APIエンドポイントの問題をより迅速に特定し、修正できます。
JavaプロジェクトをスキャフォールディングしてKubernetesネイティブアプリを構築する方法
Red HatのシニアプリンシパルデベロッパーアドボケイトであるDaniel Oh氏が、Javaプロジェクトをゼロから構築するためのひな形を作成し、Kubernetesネイティブアプリケーションとしてビルドする方法を解説します。
F5 NGINXaaS for Azureのご紹介:Microsoft Azureでネイティブに利用できるSaaS型ロードバランシング
NGINXaaS for Azureは、NGINX PlusをAzureネイティブのSaaSとして利用できるサービスです。NGINXの設定を容易にリフト&シフトできるため、クラウド導入とモダンアプリの展開を加速できます。
SELinuxでNGINXおよびNGINX Plusを使用する
Red Hat Enterprise Linux(RHEL)および関連ディストリビューションでSecurity-Enhanced Linux(SELinux)を有効にすると、デフォルト設定によりNGINXとNGINX Plusの一部の操作が制限されます。この記事では、すべての機能を利用できるようにSELinuxの設定を変更する方法について説明します。
NGINX PlusによるAWS Auto Scalingグループの負荷分散
新しいnginx-asg-sync統合ソフトウェアにより、NGINX PlusはAWS Auto Scalingグループの負荷を直接分散できるため、クラウドでの負荷分散がさらに柔軟になります